H07 · Recurrent neural networks with explicit representation of dynamic latent variables can mimic behavioral patterns in a physical inference task
Rishi Rajalingham, Aída Piccato & Mehrdad Jazayeri (2022) Nature Communications, 13, 5865. doi:10.1038/s41467-022-33581-6
把"mental simulation"这个认知科学的百年口号,压缩成一条可以工程化操作的损失函数:给 RNN 加上"必须在线输出球的位置",它就自动变得更像灵长类。这是"行为一致性筛模型"路线在物理推断领域的标志性一役,也是 H10 神经版续集的预注册剧本。
核对版本:Zotero motor_control_interception_64 集合本地全文(PDF 全文提取,图注与正文互相校订,2026-09-18;图注所标页码均为 PDF 文件页序,非期刊印刷页码);Zotero 条目。
背景
人瞥一眼陌生场景,就能推断物体的潜在状态、预测合理与不合理的未来、规划干预动作。主流理论——mental simulation——认为大脑为物理世界建立了心智模型,并靠在心里"跑"这个模型来做推断。支持证据的黄金标准来自 Battaglia、Ullman 等人的工作:用高层计算机程序(物理引擎式)做带噪声的随机模拟,能精确复现人类在塔块、台球等任务里的判断模式。但这类证据有一个结构性缺陷:它们是行为层面的过程模型,不模拟神经计算。
麻烦在于,很多据称依赖 dynamic inference 的行为,原则上也能被"自动化"的非线性函数直接搞定——前馈网络看一眼初始状态,一步算出终点,全程不需要逐时刻追踪。深度学习的经验反复证明,只要函数足够非线性、任务分布固定,model-free 的输入输出映射几乎无所不能(在 Atari 这类丰富环境里甚至常常胜过 model-based 智能体)。所以"人脑真的在逐时刻模拟吗"这个问题,靠行为拟合无法裁决。
本文的破局点是三件套:一个既可被模拟求解、也可被直接映射求解的任务;人类与猴子的系统行为数据;以及一大批被施以不同"归纳偏置"的 RNN。关键手法在于利用 RNN 解的非唯一性——同样的任务,网络结构、训练协议、尤其是优化约束不同,学到的解就不同。如果"额外要求网络动态追踪潜变量"这一约束系统性地把网络行为推向灵长类,那么mental simulation 假说就获得了一种新的、可证伪的支持。这与 B02、B04 的内模型理论传统一脉相承,与 G09 的"遮挡运动拦截:模型 vs 在线控制"之问遥相呼应,只是把检验工具从心理物理换成了人工神经网络。
研究思路
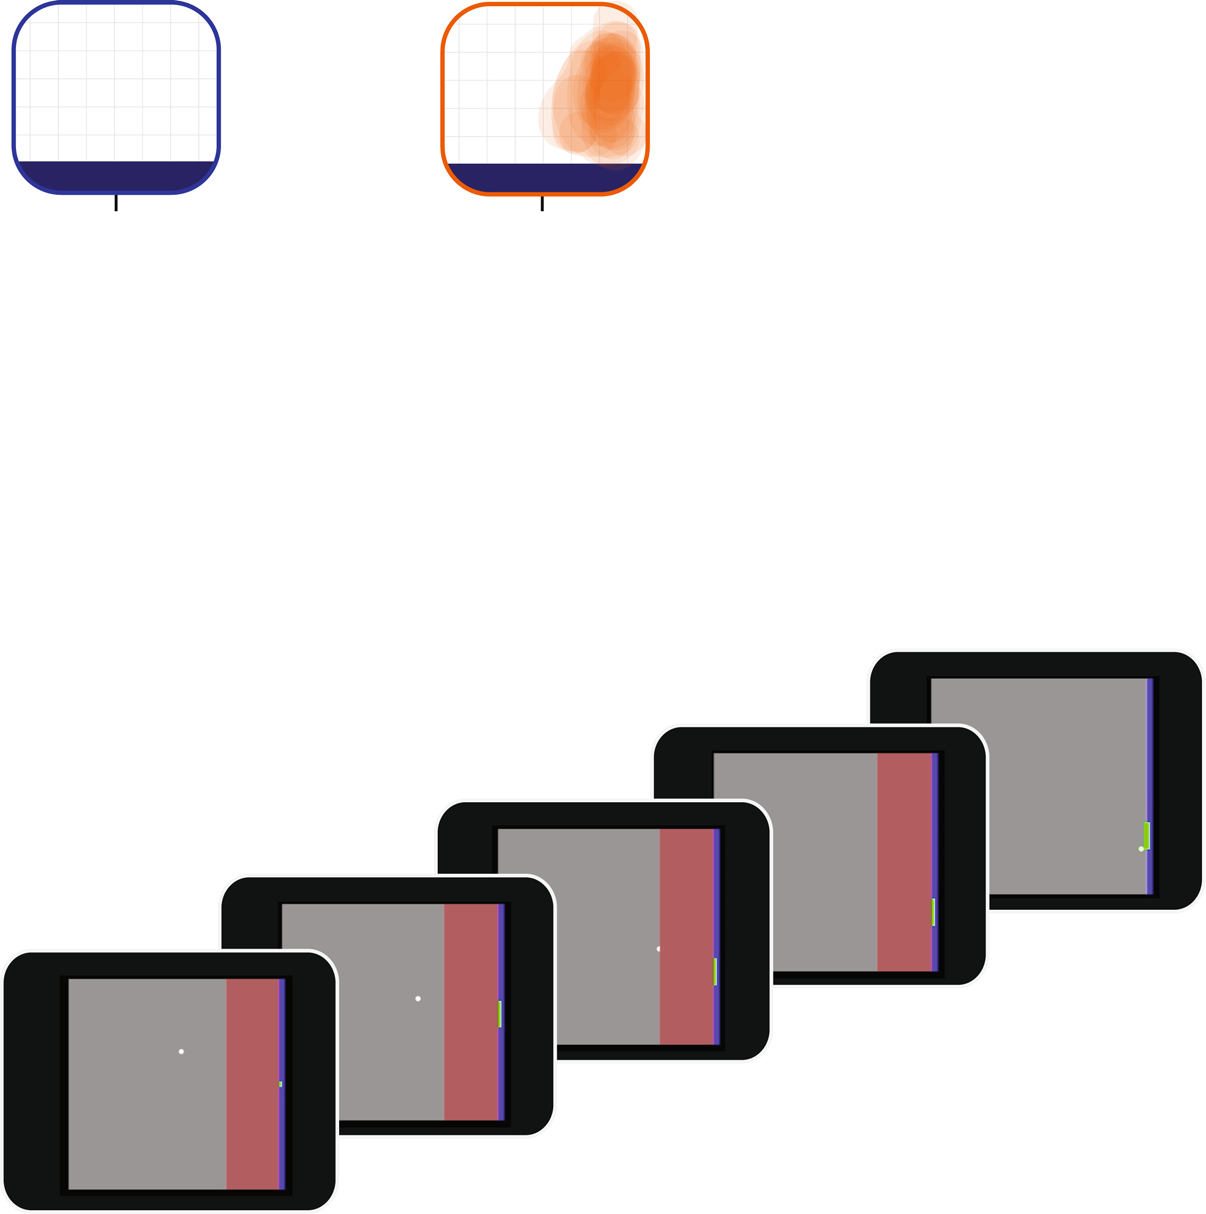
任务叫 M-Pong(mental Pong):被试用键盘(人)或一维摇杆(猴)控制屏幕右侧挡板的竖直位置,拦截一颗在二维框内匀速运动、可上下壁反弹的球。球的初始位置与速度每 trial 随机采样,且在拦截点之前横着一块大遮挡板——球先可见约 1240±350 ms,随后隐匿约 895±200 ms。任务的妙处在于"可两解":既可以逐时刻追踪球的潜位置(dynamic inference),也可以从初始状态一步非线性算出终点(automatized mapping)——模拟不是任务设计的必然产物,而是一种被试可能采纳、也可能不采纳的策略。这恰好排除了"任务逼出模拟"的循环论证。
行为刻画不用总分,而用结构。对 200 个固定条件,计算每个条件下终点误差(挡板与球最终位置的有符号差)的均值,得到一个 200 维 error-vector——它是每个被试/模型的"行为指纹"。相似性度量用 human-consistency score:噪声校正的相关(对半分可靠性校正),误差先回归掉真值再做残差相关(等价于偏相关),杜绝共享真值带来的虚假相关。分数 1 为完美复刻,0 为随机。
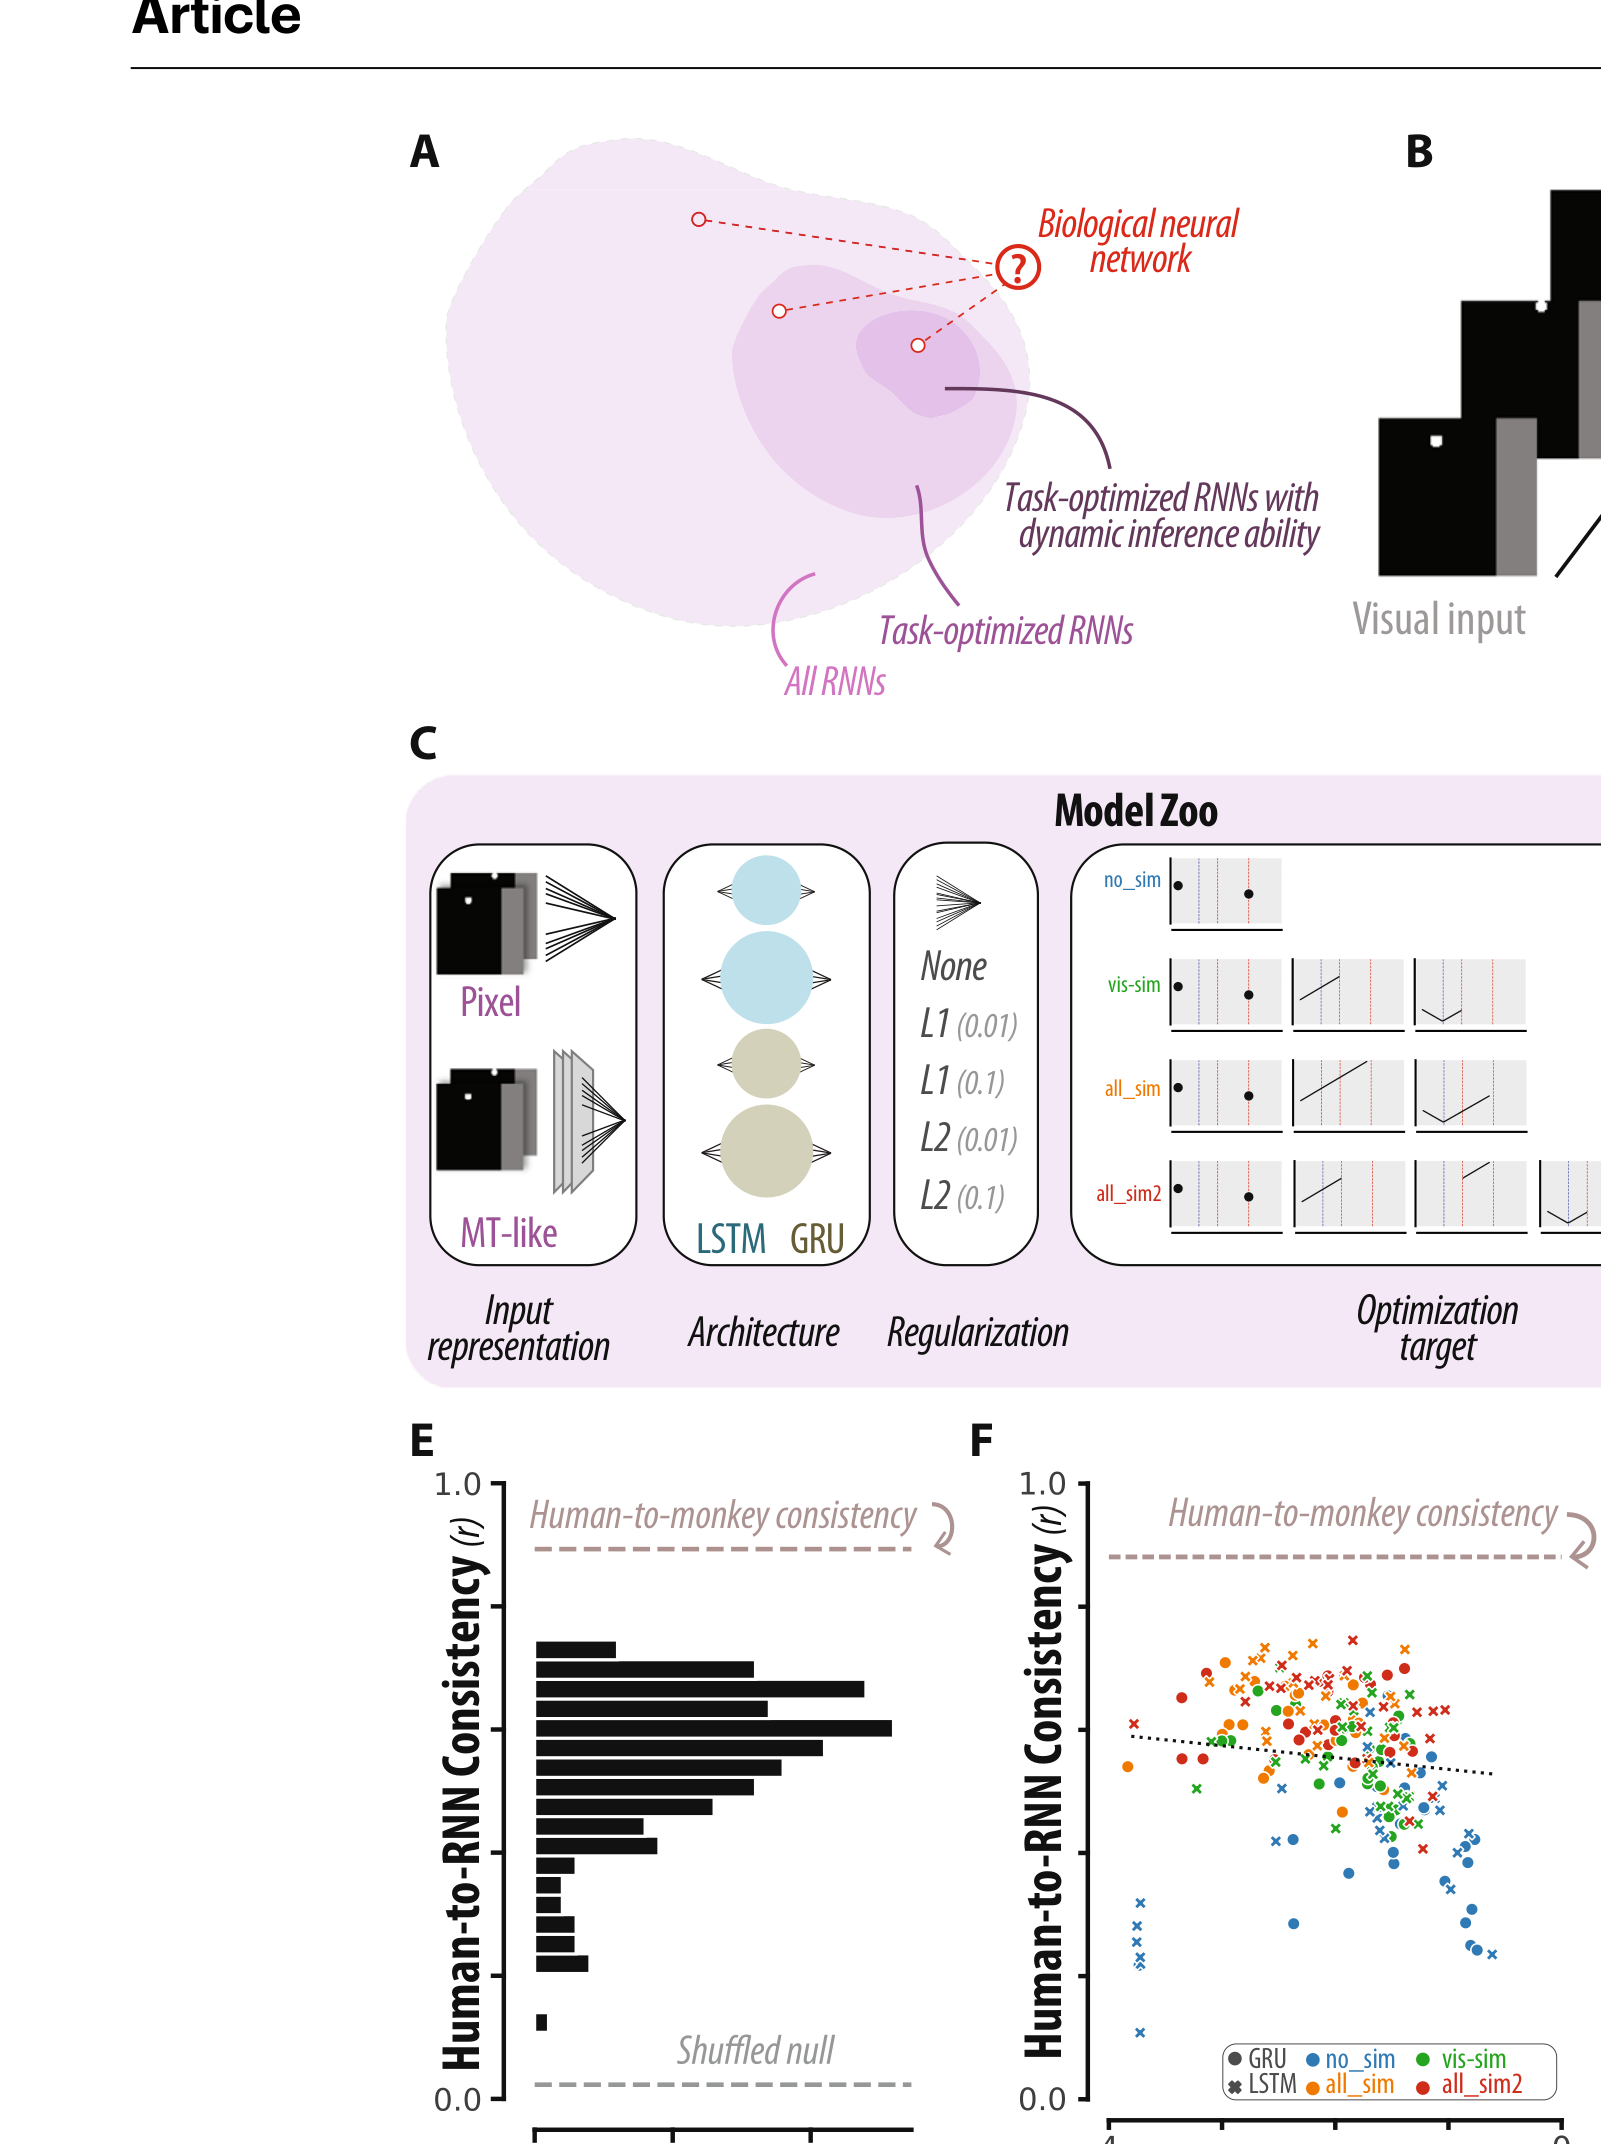
模型端是一个 RNN 动物园:LSTM 或 GRU、10 或 20 个单元、像素 PCA 或 MT 样 3D Gabor 输入表征、五种正则化(L1/L2 各两档或无)。优化类型四种:no_sim(只练任务)、vis_sim(可见期额外追踪球位置)、all_sim(全程追踪)、all_sim2(可见期与遮挡期用独立读出通道追踪)。全部网络只被要求解任务,从不被要求模仿灵长类行为。训练集多达 212,480 个条件,测试集与人猴共用同一批 200 个留存条件。
判决逻辑分两层:第一层问"什么样的 RNN 更像灵长类"——用 ISDP(intermediate state decode performance,交叉验证线性解码器读出遮挡期时变球位置的误差)度量每个网络显式携带潜变量信息的程度,看它与 human-consistency 的关系;第二层反向工程——打开更像人的网络,看它的内部动力学(维度、速度、曲率)和隐变量表征(位置、速度)长什么样,为未来的神经生理实验立下可检验的预言。
方法
人类被试 12 名(每人 1 小时,共 8985 trial,其中遮挡 6701、可见 2284),另有 2 名留存被试(2711 trial,挡板稍小)用于估计人-人一致性天花板(0.95±0.012)。屏幕 23 英寸、60 Hz,帧跨 20° 视角,挡板速度恒为 0.01 deg/ms;25% 的 trial 以 95% 半透明"可见"形式插入作对照。 trial 由中央注视 200 ms 启动,随后自由观看。两名雌性猕猴(P、C)头固定,摇杆电压三态(上/中/下)控制挡板,成功拦截给果汁;课程式训练——先无遮挡拦截、再引入遮挡,并以 50 个条件起步、150 个条件留作泛化测试;共 32 个 session、52837 trial(遮挡 39472、可见 13365)。
RNN 以 TensorFlow 1.14 训练,反传加自适应超参优化,单个网络在 Tesla K20 GPU 上训练一至两天、100–500 个 epoch。每 trial 至多 90 帧,每帧渲染为 100×100 灰度图(不含挡板),经迭代 PCA 或 3D Gabor+PCA 压到 100 维输入。所有 RNN 有 7 个线性读出通道:1 个运动通道(只在初始位置与拦截时刻两点算损失)加若干模拟通道(与球位置 (x,y) 的时间均方误差)。ISDP 用两个折交叉验证的线性读出估计。内部动力学刻画三个量:participation ratio 度量的维度、归一化一阶导度量的速度、归一化二阶导度量的曲率。另有 simple_dynamics 批次:只练任务但对隐状态加慢、光滑正则。行为机制探查用 Monte Carlo 过程模型:遮挡期球速度采样自带偏差的高斯过程(y 方向乘以 w_bias,等价于向最后可见竖直位置收缩的先验),加反弹噪声,三参数拟合人/猴终点。
主要结果
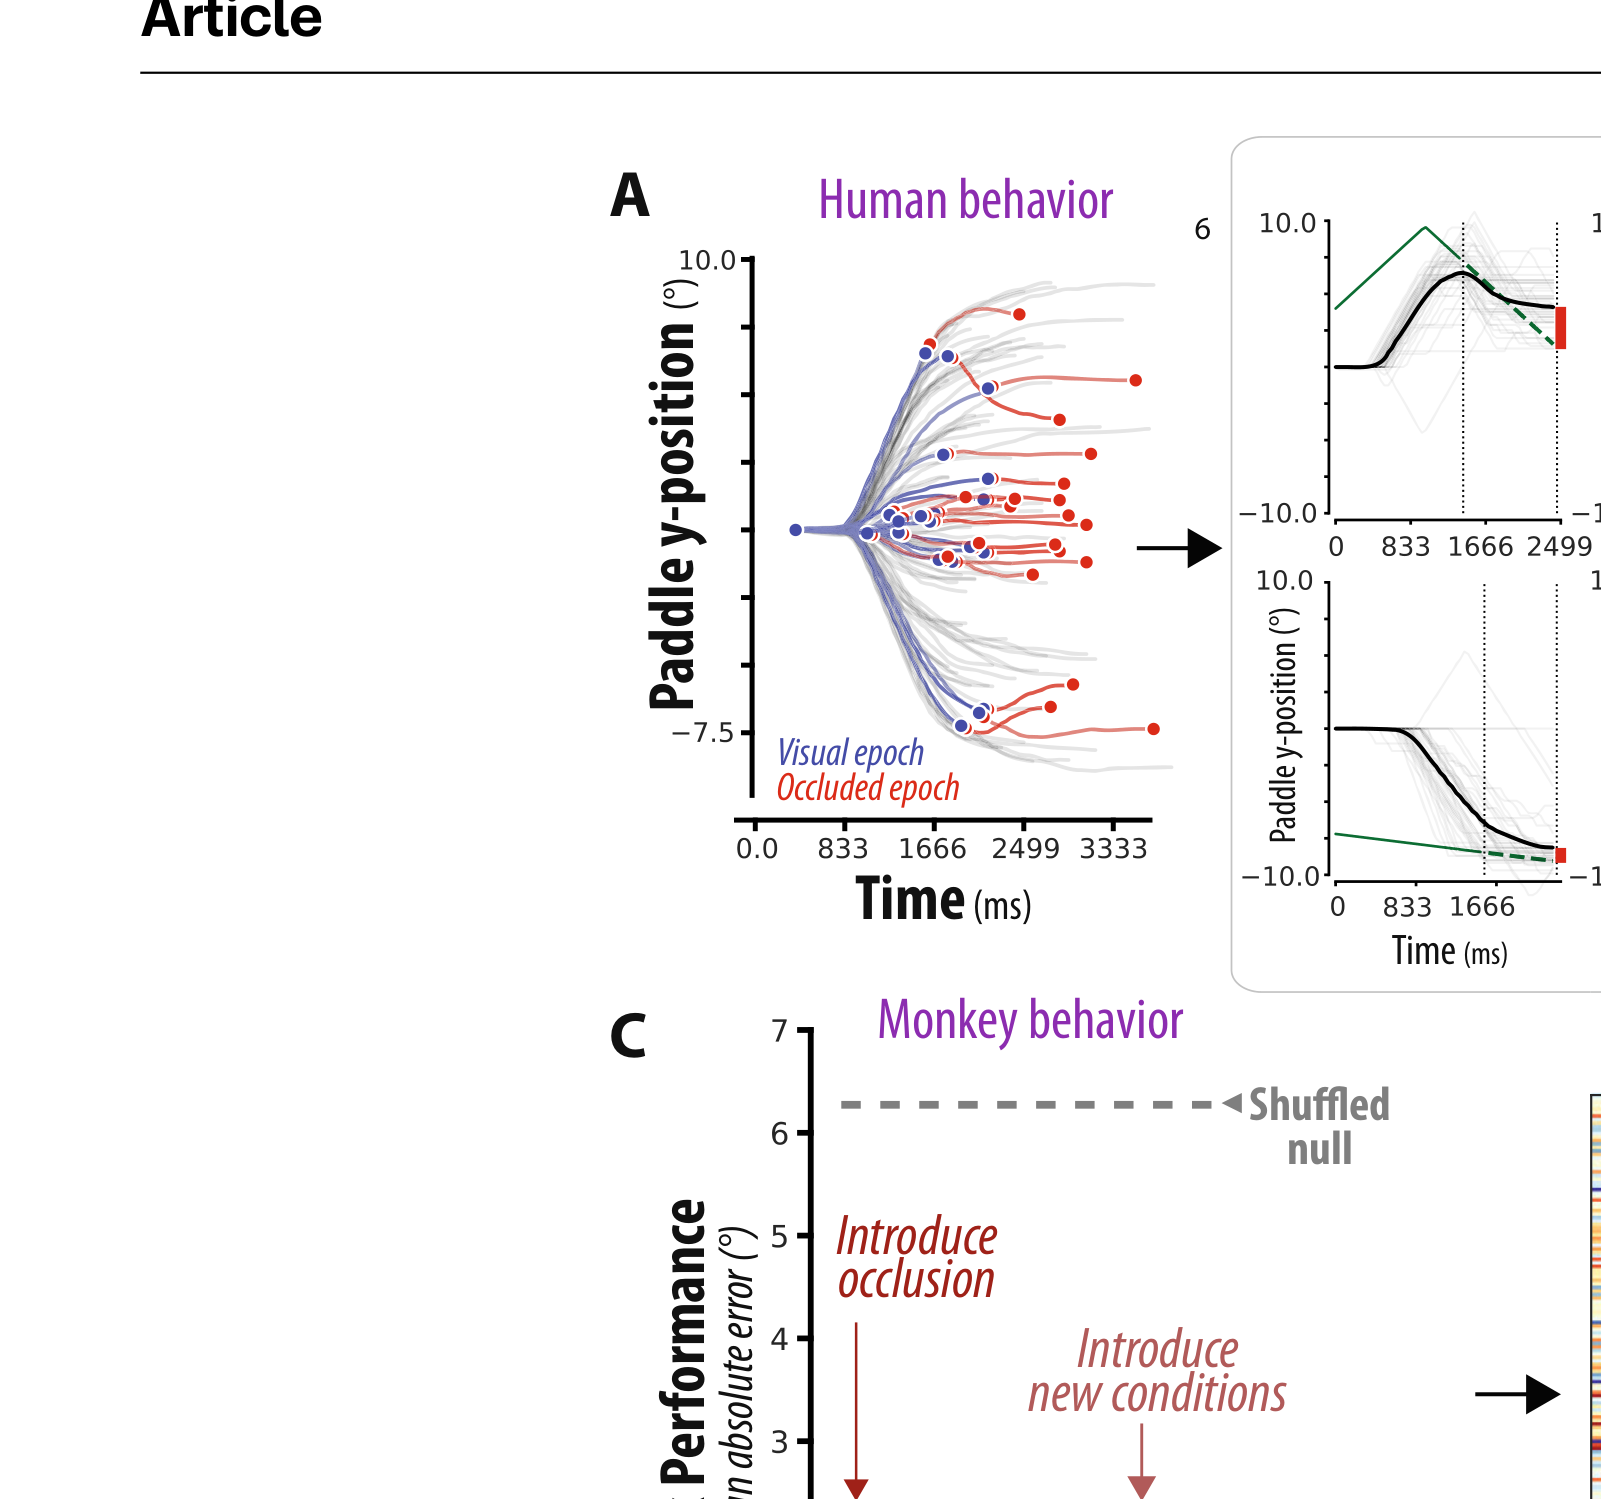
猴子的行为首先立住了。引入遮挡的第一个 session,成绩就远好于 shuffle 零假设并接近人类与猴子的最终水平;对 150 个从未见过的新条件,第一次相遇的 trial 成绩就与旧条件持平——而且剔除那些以"可见 trial"形式暴露过的条件后依然如此。这不是背题,是泛化。人与猴的 error-vector 高度相似:猴-人一致性 0.89±0.003,逼近人-人天花板 0.95。两套 error-vector 都无法被初始球状态的线性函数解释(R²<0.05),说明共同的误差结构来自共同的推断策略,而非任务物理的镜像。
RNN 动物园的总成绩分布广泛,部分网络达到人猴水平。第一个判决结果是否定的:成绩与 human-consistency 几乎无关(对人与对猴 R²=0.01 与 0.00002,p=0.104 与 0.475)。这直接顶撞了感觉系统"越强越像脑"的惯例(Yamins 的视觉、Kell 的听觉模型)——在推断任务里,总分不是脑相似度的货币。第二个判决结果是肯定的:ISDP 与 human-consistency 强烈相关(对人、对猴 R²=0.36 与 0.39;扣除成绩协变后偏 R²=0.44 与 0.43,均显著高于成绩的对应值)。隐变量追踪得越显式,行为越像灵长类——且这一结论在改用眼动或挡板轨迹度量行为、改换网络规模(100/200 单元)与训练分布后全部存活。
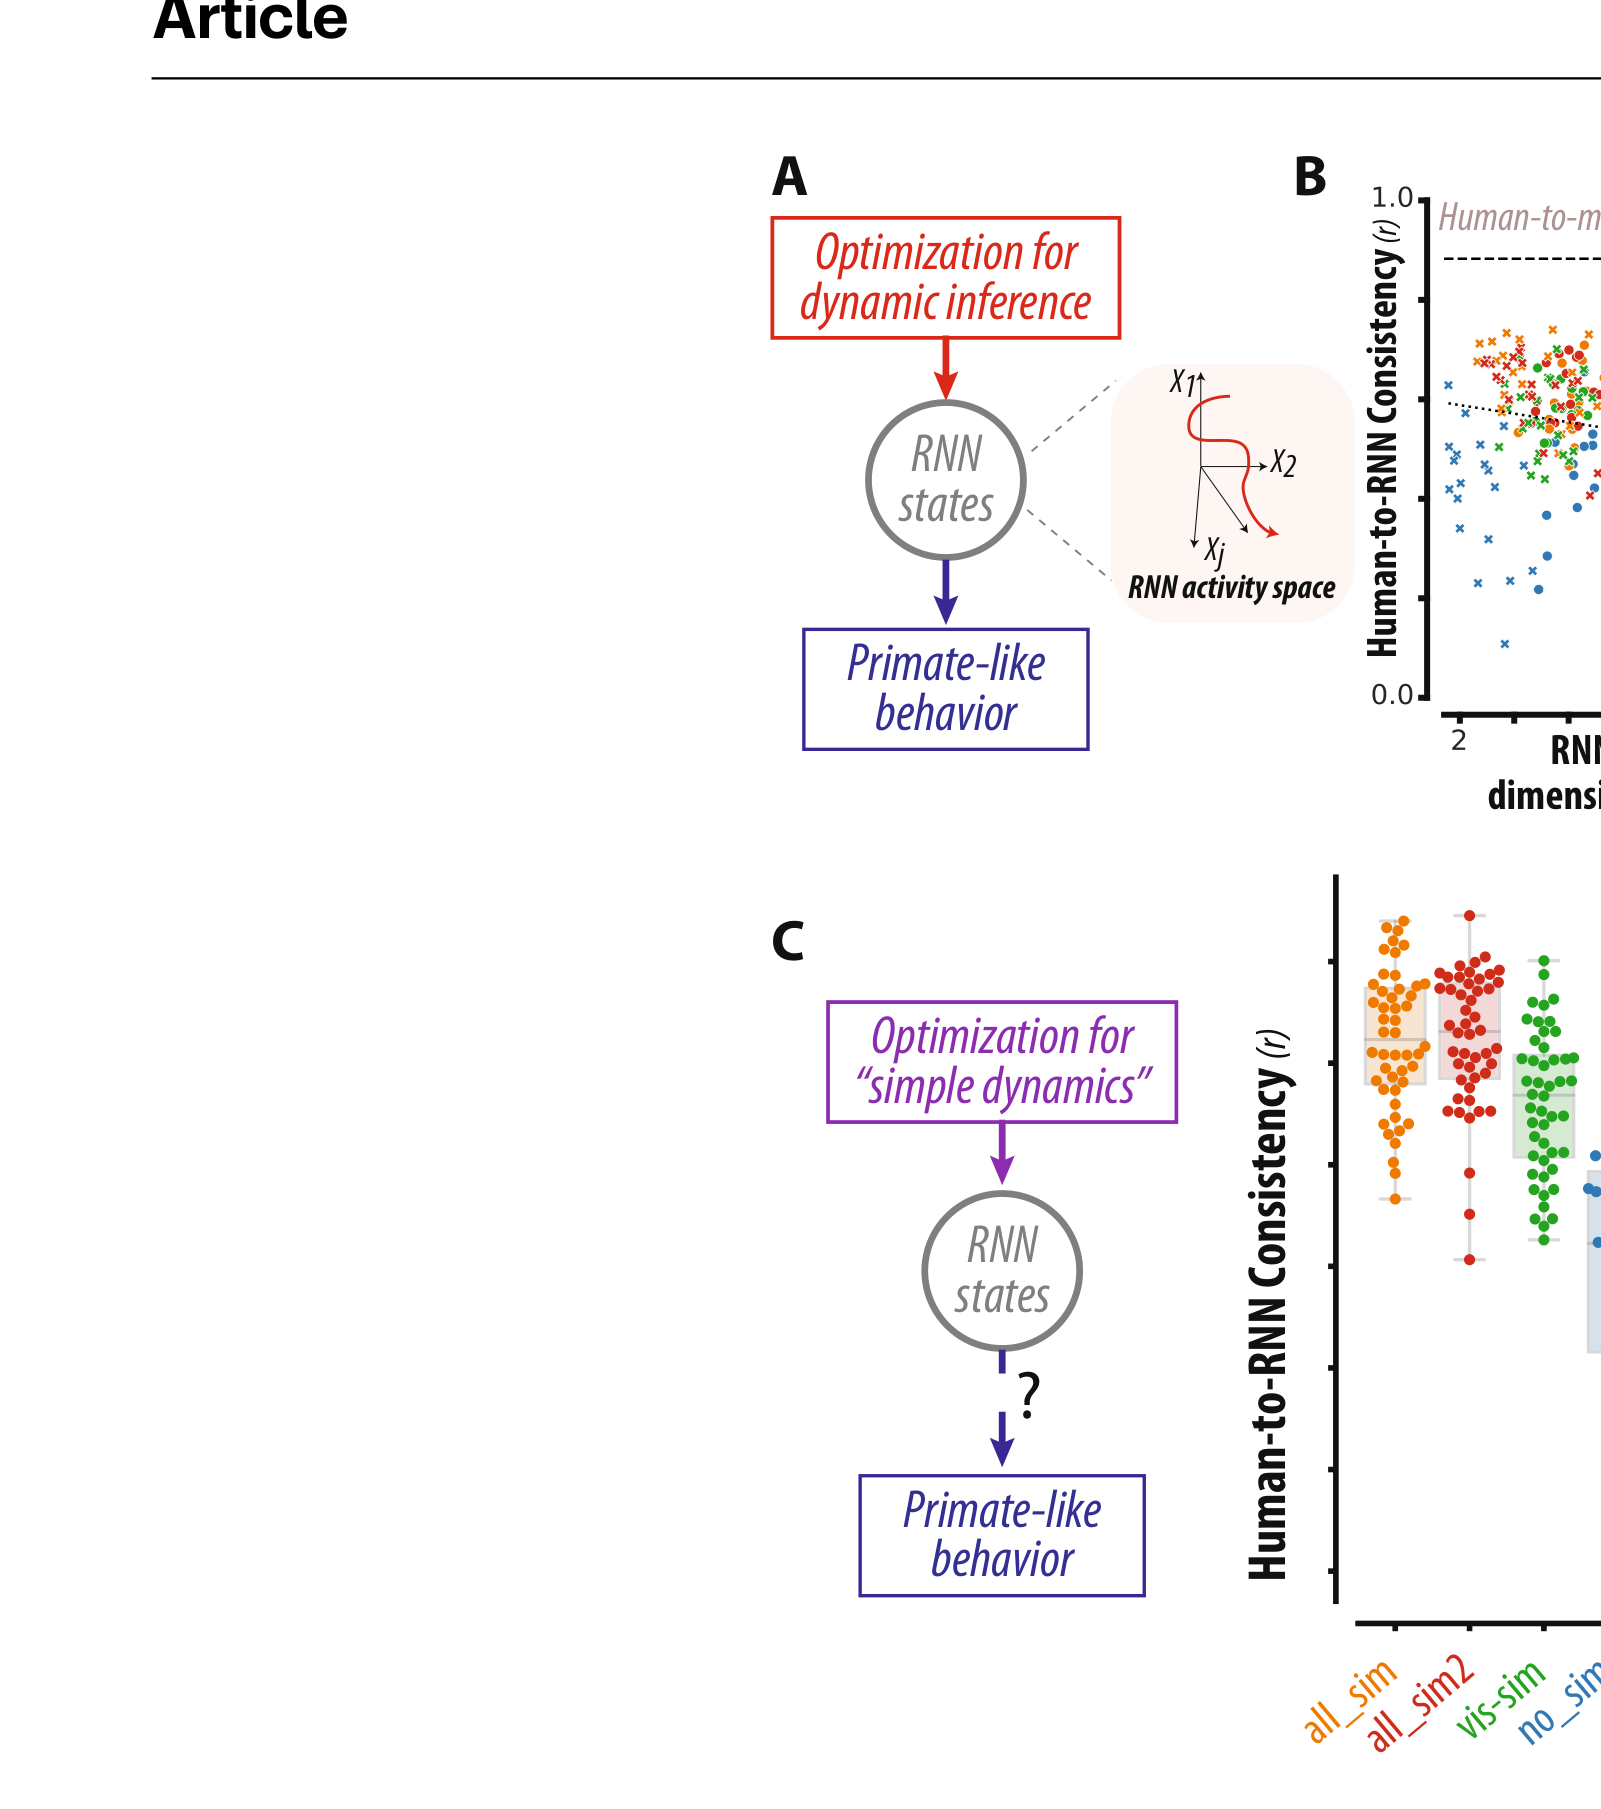
机制上有两重发现。其一,"simple dynamics":更灵长类的网络,其隐状态动力学更慢、更光滑、更低维(三属性合计解释一致性方差的 0.18/0.16)。单纯为慢而慢的正则化(simple_dynamics 批次)确实能提升一致性、显著优于 no_sim(p<0.001),却始终追不上 all_sim2(p<0.001);在包含全部属性的偏 R² 比较中,动态推断能力(R²=0.35/0.38,偏 R²=0.28/0.31)压倒全部三个动力学属性。慢动力学是模拟的副产品,不是模拟本身。其二,反向工程给出了一个漂亮的二部结构:遮挡期 RNN 是自治动力系统,要更新位置就必须知道速度,因此隐状态里除了位置子空间还应藏着速度子空间。解码证实——可见期速度信息涌现,遮挡期速度编码持续存在甚至增强(比输入驱动的可见期更线性可读),且在 all_sim/all_sim2 网络中最强;遮挡期速度编码强度与成绩(r=0.57)和 ISDP(r=0.41)都相关。注意:这些网络只被要求输出位置,从未被要求输出速度——速度表征是模拟计算的自发需求。
最后,行为机制也对上了:人与猴在"遮挡期竖直位移大"的条件下误差更大,与"带偏差的噪声模拟、先验偏向最后可见竖直位置"的 Monte Carlo 模型吻合;具备同样性质(可由训练数据统计学得)的 RNN 一致性最高。人、猴、RNN 三方的误差不止相似,而且相似得有道理。
逐图解读
 原文 Fig. 1 · PDF 第 2 页
图 1 · 假说与实验策略 A 图把竞争假说画成两条流水线:dynamic inference engine(逐时刻追踪潜状态再输出)对阵 automatized 非线性函数逼近(直接输出)。B 图给出三方对局的格局:人、猴行为已知,问号悬在 RNN 头上——优化时是否附带动态推断约束。C 图是 M-Pong 任务:球穿越带遮挡的二维框,挡板上下拦截。任务设计"可两解"的用心,在这张图上一览无余。
 原文 Fig. 2 · PDF 第 4 页
图 2 · 人与猴的行为会师 A 图人类:单条件平均挡板轨迹(可见期蓝、遮挡期红)与逐 trial 轨迹叠加,终点误差清晰可读。B 图把行为压缩成 200 维 error-vector 色条。C 图猴子:遮挡首日即高分,150 个新条件首 trial 即泛化(实心圆为剔除可见暴露者),灰虚线为 shuffle 零假设。D 图人-猴终点误差逐条件散点,r=0.89。猴子不是被过训练出的解题机器,而是与人共享推断策略的伙伴——这是后续一切比较的合法性基础。
 原文 Fig. 3 · PDF 第 5 页
图 3 · RNN 动物园的三重审判 C 图列出全部超参(结构、单元数、输入、正则、优化目标),D 图显示成绩分布与灵长类重叠,E 图显示一致性分布广泛且普遍低于猴。F 图:成绩对一致性毫无预测力。G 图:ISDP(横轴翻转,越右模拟越强)与一致性强烈相关。H 图:偏 R² 定谳——动态推断能力解释的方差显著高于成绩。这张图完成了全文的核心论证:像不像脑,不看考多少分,看心里有没有那颗球。
 原文 Fig. 4 · PDF 第 6 页
图 4 · 灵长类式行为背后的动力学 B 图三个散点分别展示维度、速度、曲率与一致性的关系:低维、慢、光滑的网络更有人味(R²=0.03、0.18、0.11)。C 图的对照实验是点睛之笔:专门正则出 simple dynamics 的新网络优于纯任务网络、却仍逊于动态推断网络。D 图的全属性偏 R² 汇总:ISDP 独占鳌头。慢动力学是模拟的影子,不是模拟的实体——这一区分对神经生理预言至关重要。
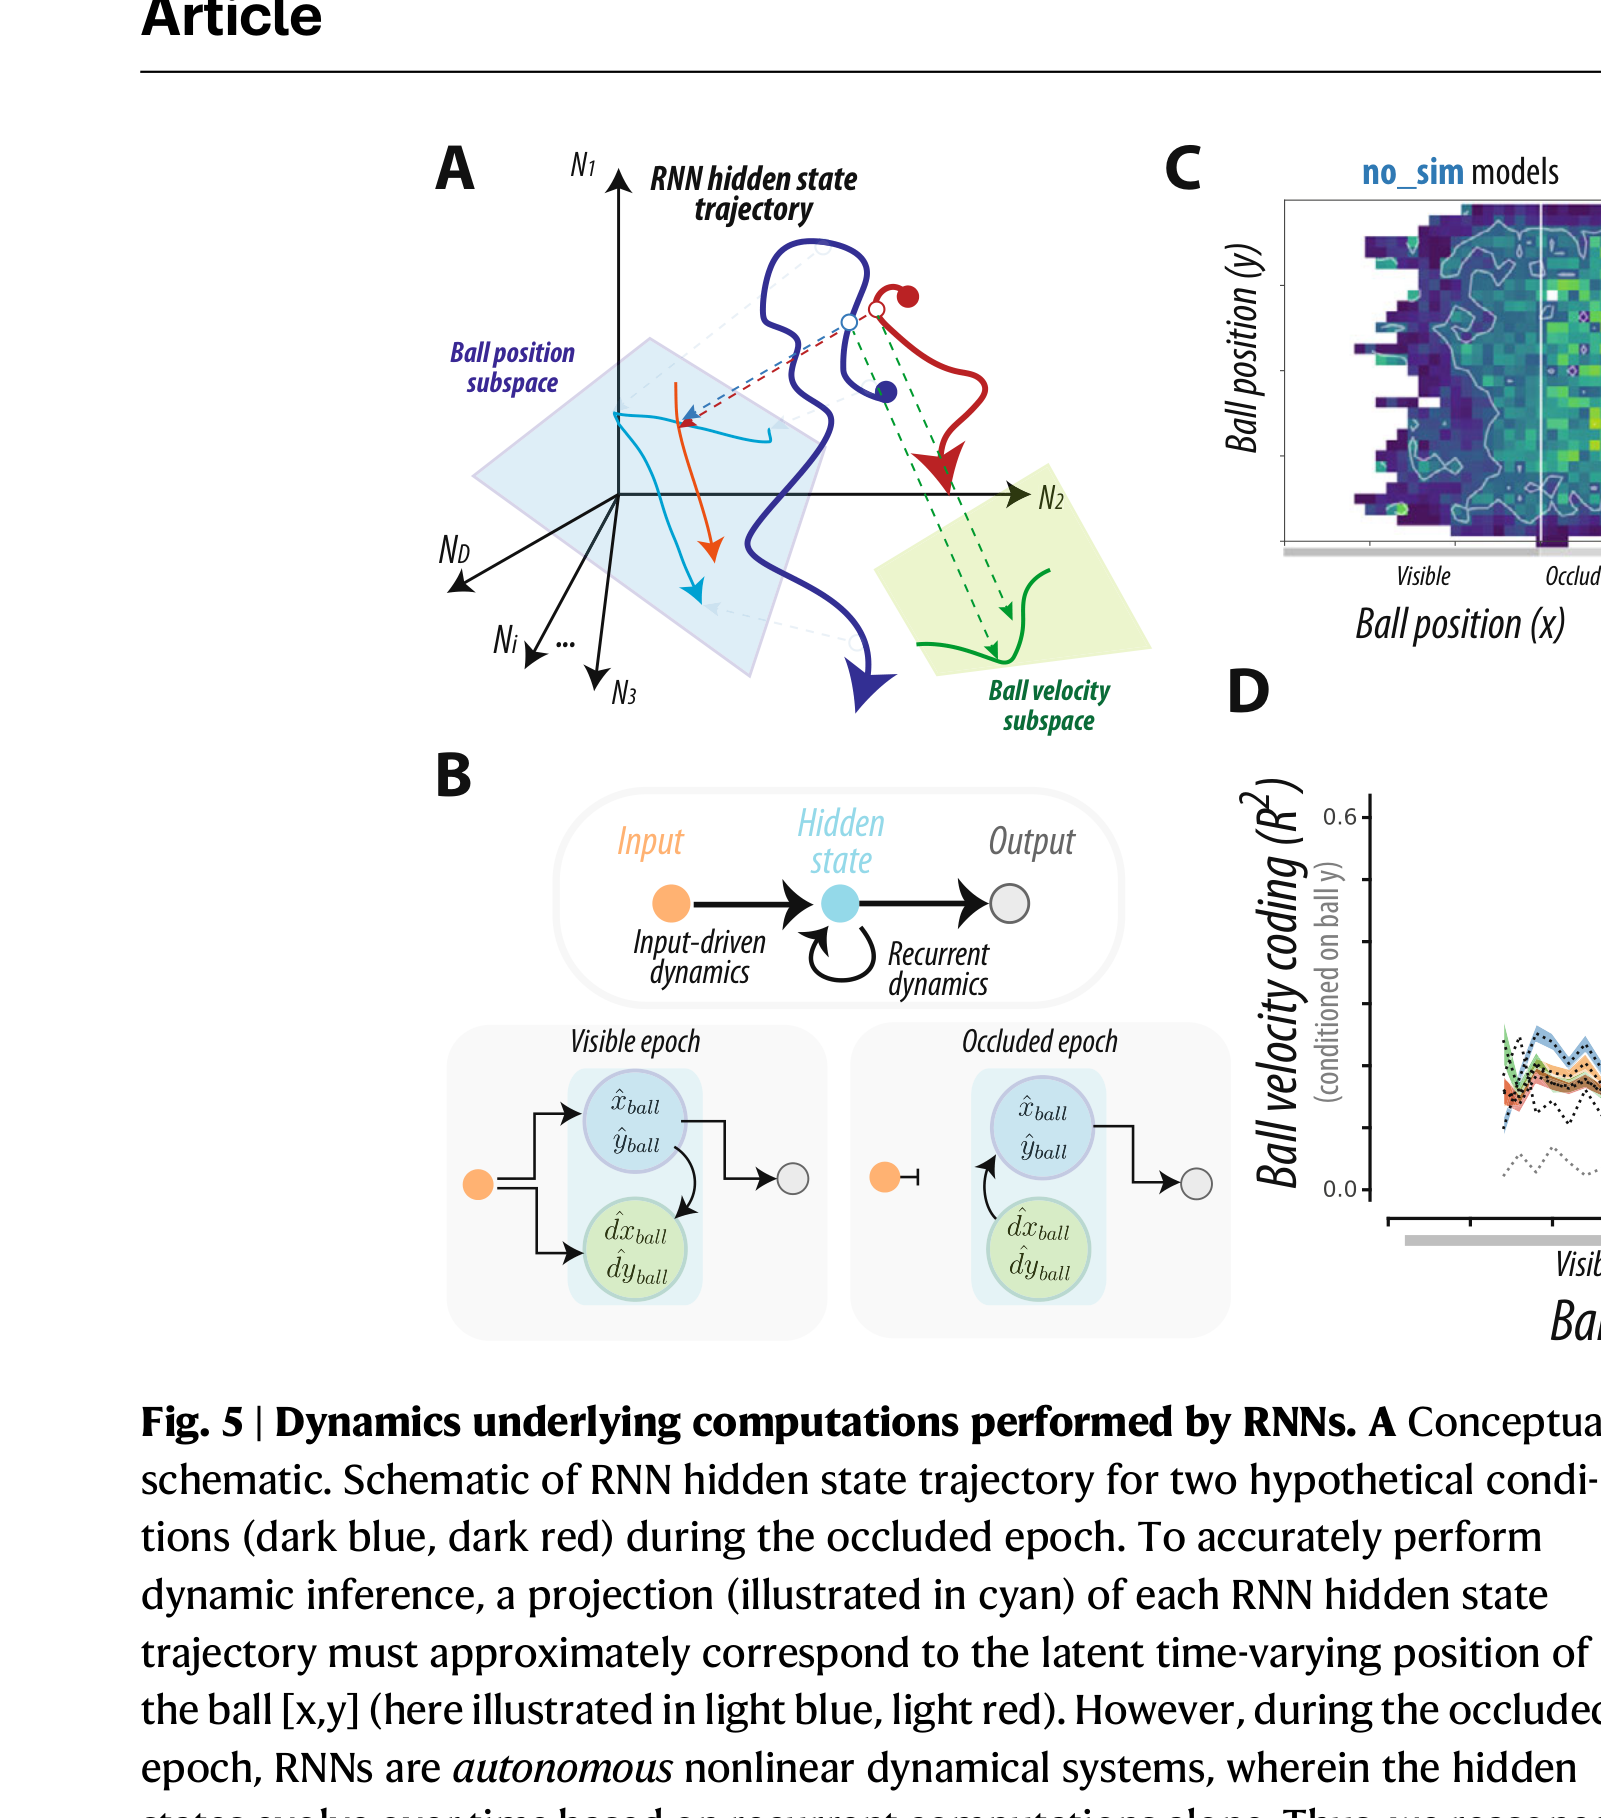 原文 Fig. 5 · PDF 第 7 页
图 5 · 打开黑箱:速度子空间 A/B 图是机制推理:遮挡期网络自治,要更新位置必须携带速度;初始条件由可见期设定。C/D 图用热图与条件平均证实:可见期速度编码涌现,遮挡期几乎全场景持续且增强,且不存在于像素输入(pixels 控制)、不与位置混淆(null 控制),在 all_sim/all_sim2 网络中最强。E 图三维散点把成绩、ISDP 与速度编码强度织在一起。网络只被要求报位置,速度却自己长了出来——这是"模拟需要速度"这一理论预言的实证,也是留给 H10 神经数据的考题。
讨论
这篇文章的方法论贡献可能比结论更持久。它示范了一条"以行为筛计算假说"的通用路线:任务必须"可两解",模型只被施加假说性的约束而从不拟合行为,比较的是误差结构而非总分。与感觉系统"性能即脑相似度"的旧约不同,这里性能被明确证伪为筛子,取而代之的是 ISDP 这样的功能属性。这条路子可直接平移到分层信息加工、反事实推理等其他认知构件的检验上。
对"拦截的神经生理学"主线而言,H07 补上了此前缺失的一环:G04、G07、G09 用心理物理论证了内模型与遮挡外推,H05、H06 用行为与单神经元证明了延迟补偿和 PPC 预测信号的存在,但"逐时刻模拟"作为一种计算形式始终停留在行为模型的层面。H07 把它翻译成网络的可检验性质——遮挡期线性可读的位置与速度子空间、慢而低维的轨迹——从而把一个哲学味浓的假说变成了可以被电极审问的对象。H10 正是接下这道考题的答卷:同一批预注册 RNN,与猕猴 DMFC 的群体动力学正面对局。
还有一层容易被忽略的功绩:M-Pong 建立了一个"无需过训练"的动物物理推断模型。猴子不靠上万次重复的刺激-反应绑定就能达标并即刻泛化,说明任务调用的是猕猴现成的归纳偏置——物体恒存性与简单动力学。这回应了 G09 一类的担忧:在遮挡拦截里,过度训练完全可能造出与"心中模拟"无关的自动化策略,使模型检验与在线控制之争(G08、G09)失去着力点。M-Pong 通过设计把记忆解法排除在外,猴子不得不推断;而推断的误差结构又与带先验偏差的噪声模拟吻合,为后续神经记录(H10)提供了一个既自然、又有理论预期的行为平台。
局限也是明摆着的:RNN 无脉冲、无细胞类型、无结构约束,只能与脑作放电率层面的比较;网络没有挡板的感觉反馈(虽有内部递归反馈可用);"像"仍是结构相似而非因果证明——所以作者反复强调这些模型是预注册的假说载体,而非大脑本身。但作为研究纲领,它已经改变了游戏规则:从此检验 mental simulation 不必再问"行为像不像物理引擎",可以直接问"神经动力学的几何里有没有那颗看不见的球"。
一句话总结:在可两解的 M-Pong 任务中,人猴行为高度一致(一致性 0.89),而数百个任务优化 RNN 里,唯有被约束为显式追踪球位置的动态推断网络(ISDP 解释一致性方差 R²≈0.36–0.44)系统性地复现灵长类误差模式——总成绩毫无预测力,mental simulation 假说获得了行为层面的强支持与神经层面的可检验预言。
思考问题
- “结构相似而非因果证明”——模型侧可以再进一步:给 SI 网络做扰动移植,把球位置子空间的活动 clamp 到错误位置,生成行为预言(误差应向被 clamp 的位置系统性偏移),拿去与人类的注意操纵或表征动量错觉对质:对得上,ISDP 从拟合指标变成可操作的因果变量;对不上,“显式表征”要降级为相关性结构。
- 模型库里缺一个“反应式+滤波”的强基线:不带潜变量、纯反应式但带最优平滑估计的网络,给它同样的训练预算,看 ISDP 是否仍只有显式追踪网络能复现:仍只有,“mental simulation”的必要成分是模拟;滤波式基线也能复现误差结构,必要成分其实只是平滑估计——这是这份纲领最该自己补的对照。