B03 · Multiple paired forward and inverse models for motor control
Wolpert, D.M., & Kawato, M. (1998). Neural Networks, 11, 1317–1329. doi:10.1016/S0893-6080(98)00066-5
作者提出成对的前向与逆向模块,用感觉预测误差和情境线索共同决定各模块的控制贡献与学习权重。文章提供理论架构和可检验预测,并未以新实验确认脑中存在这套模块。
核对依据:Zotero 条目 · 本地全文。本轮核对原文方法、关键结果、解释边界及所引主图;更新于2026-09-20。图注页码采用本地PDF文件页序,版本与未解决问题见正文及审查记录。
背景
人在面对不同物体、工具和环境时,需要迅速调整运动控制。拿起轻杯与重壶时,动作目标看似相似,所需的运动输出却不同;而在新环境中刚学到的动力学特征,又可能覆盖旧技能,导致重新面对原环境时产生干扰。单一内模型能够学习某种映射,却难以同时解释多套经验的保存、情境驱动的快速切换以及新旧知识的组合。Wolpert 与 Kawato 在 1998 年提出 MOSAIC,正是为了解释控制系统如何维护多套候选模型,并依据当前情境分配各自在动作生成与学习中的贡献。
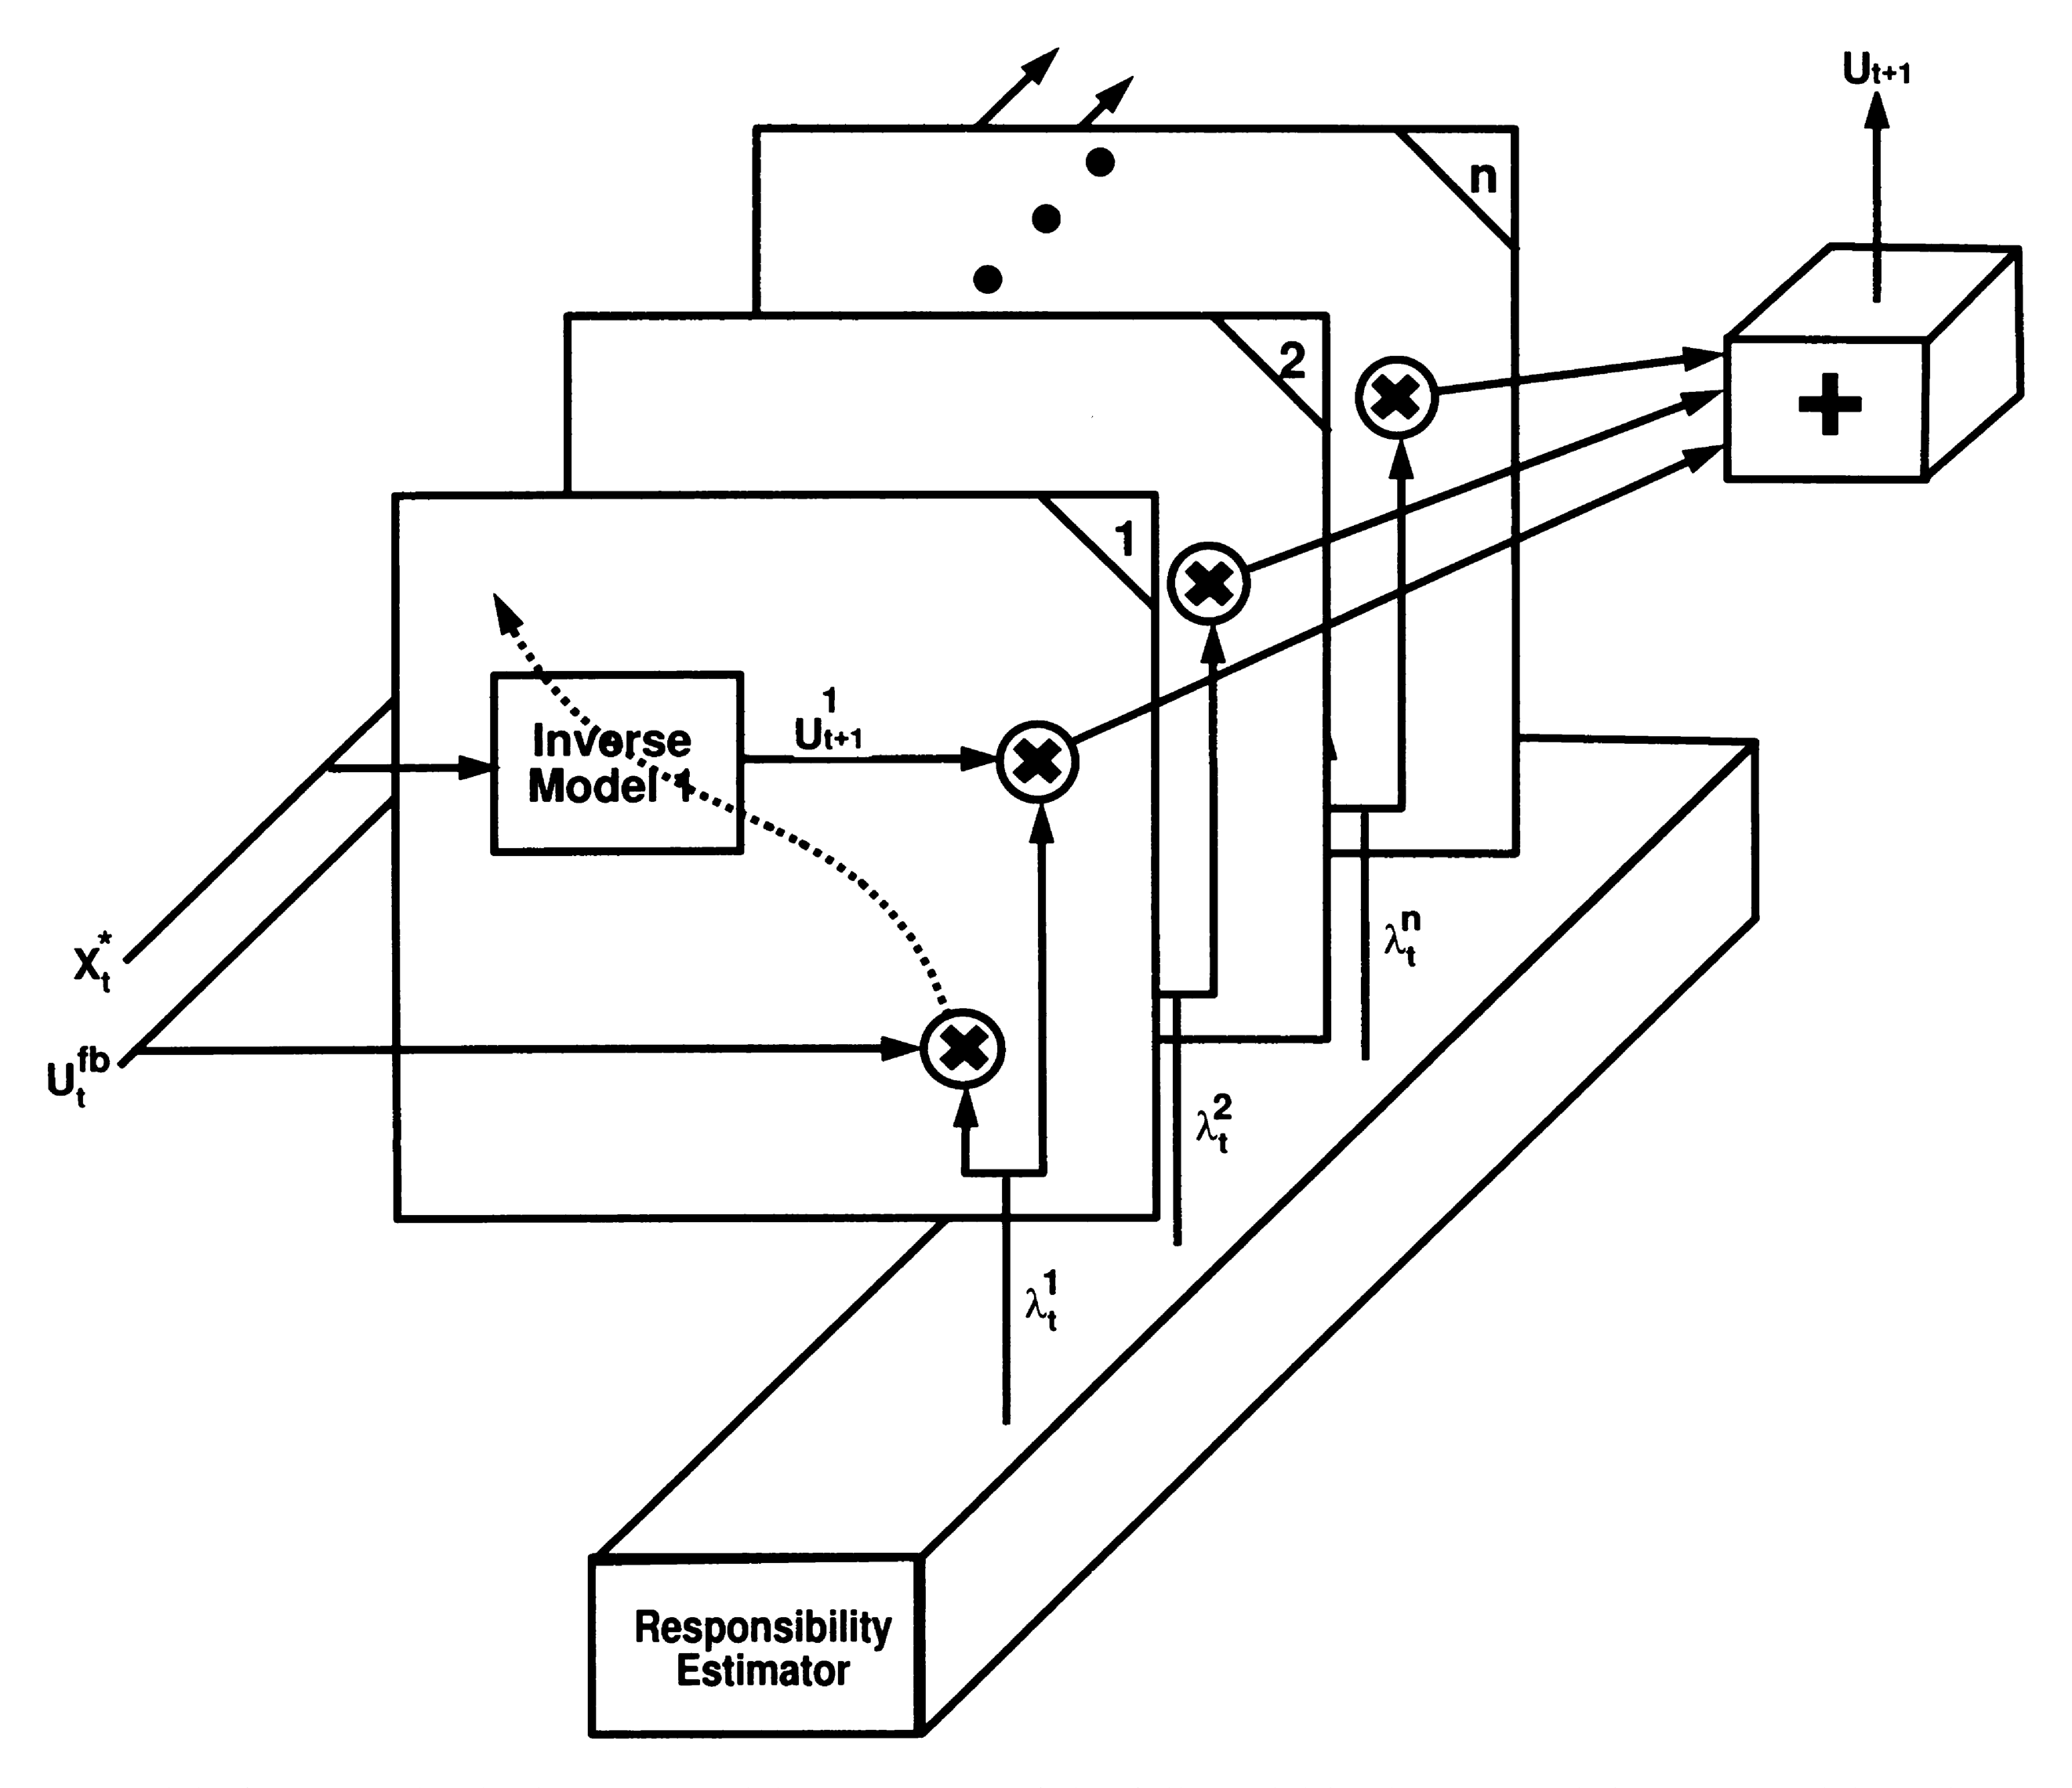
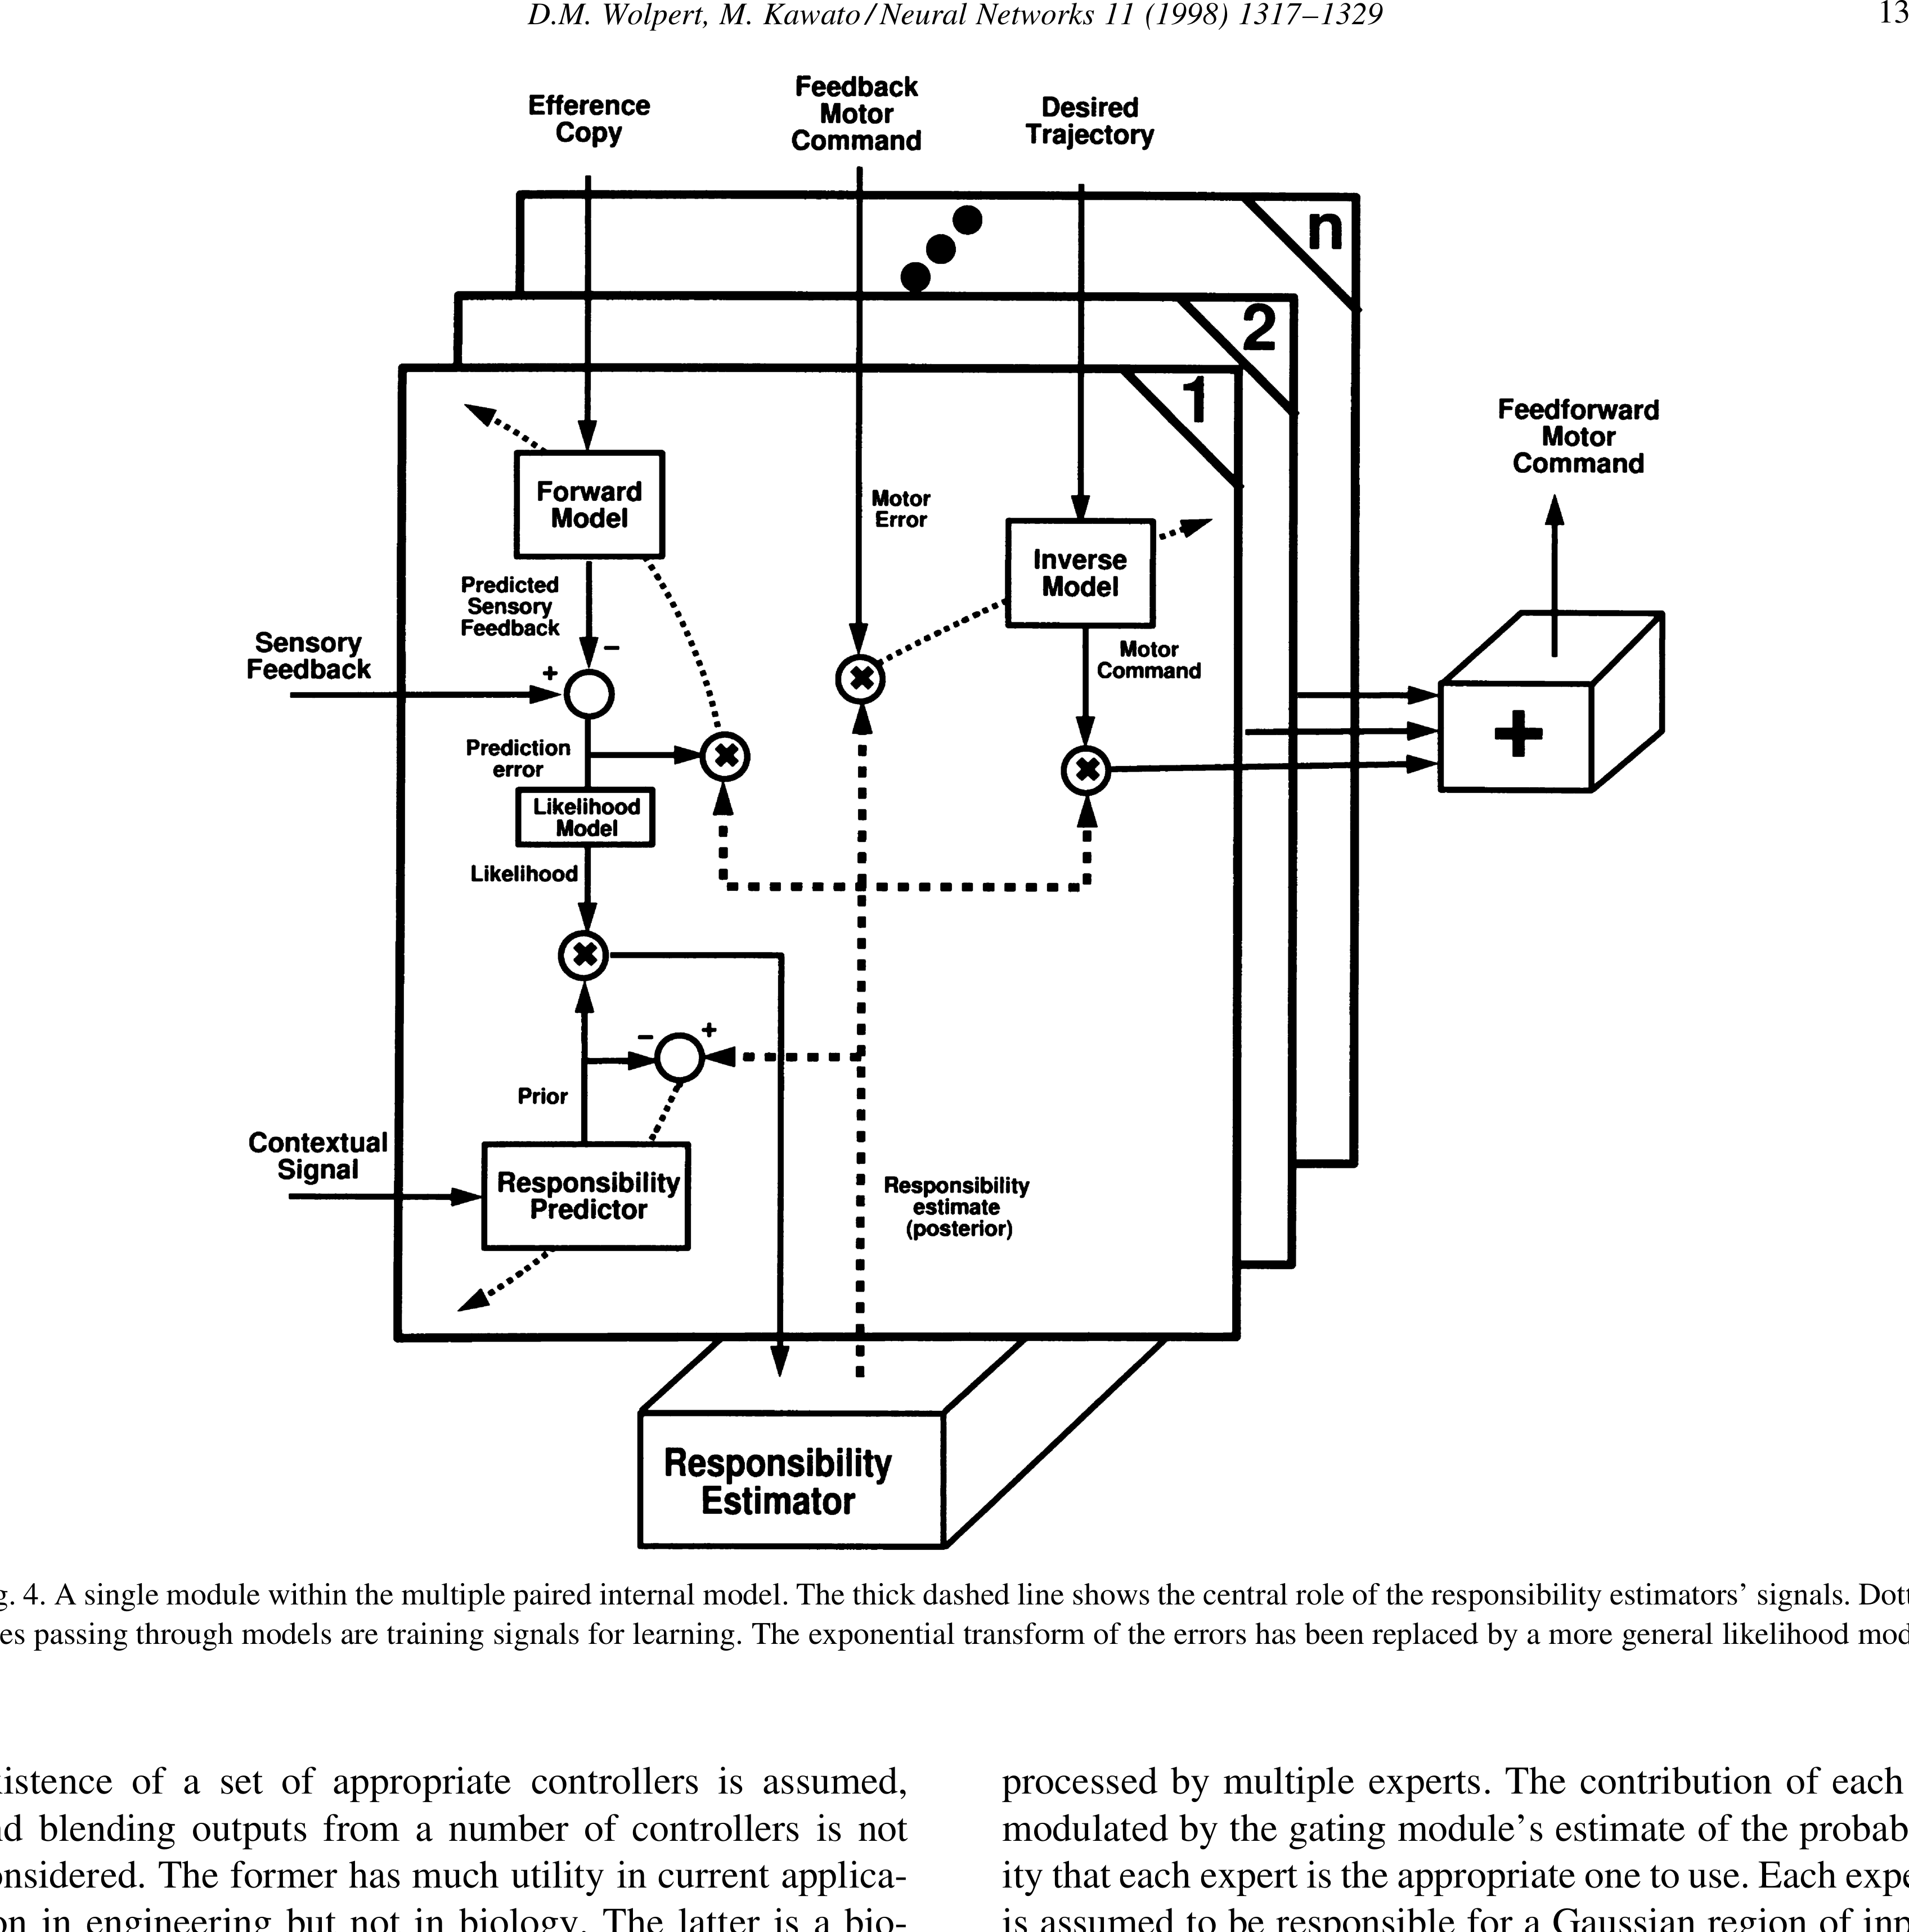
这一架构将逆向模型与前向模型成对组合。逆模型给出候选运动命令,前向模型依据实际发出的总命令预测感觉后果;哪个模型的预测更符合当前反馈,它就获得更大的责任权重。该权重不仅用于混合各个逆模型的输出,也调节各模块的学习强度,确保“当前由谁控制”与“误差应更新谁”保持一致。情境预测器在动作开始前提供先验,使系统不必等到明显误差出现才切换。这样,感觉预测误差提供事后证据,视觉等情境线索提供提前信息,两者共同决定模块责任。
文章主要提供理论方案与实验预测,并未开展新的人体或神经实验。这一框架能够解释前向预测可能先于控制改善、清晰情境线索促进分离学习、切换更依赖预测符合程度等现象,并提出以反馈误差学习作为逆模型的更新机制。不过,归一化责任权重产生的是加权混合输出,并不保证任意动力学特征都能通过代数叠加达到零误差;模块数量、初始化方式和动态稳定性仍取决于具体实现。文中的行为支持主要引自既有研究,概念框图也无法直接对应到已确认的小脑解剖分区或特定神经教学信号。其核心价值在于将多环境学习中的选择、预测与更新整理成了可供检验的计算关系。
研究思路
先梳理行为学习、情境依赖与迁移现象,再提出配对模块:逆模型产生候选命令,前向模型预测感觉后果,预测更准确的模块获得更大权重;情境预测器则在运动开始前提供先验。
方法
这是理论与叙述性综述文章,没有新招募的受试者或新的神经记录。作者给出了模块计算流程、责任权重与学习规则,并与集中式门控等经典架构进行了概念对比。
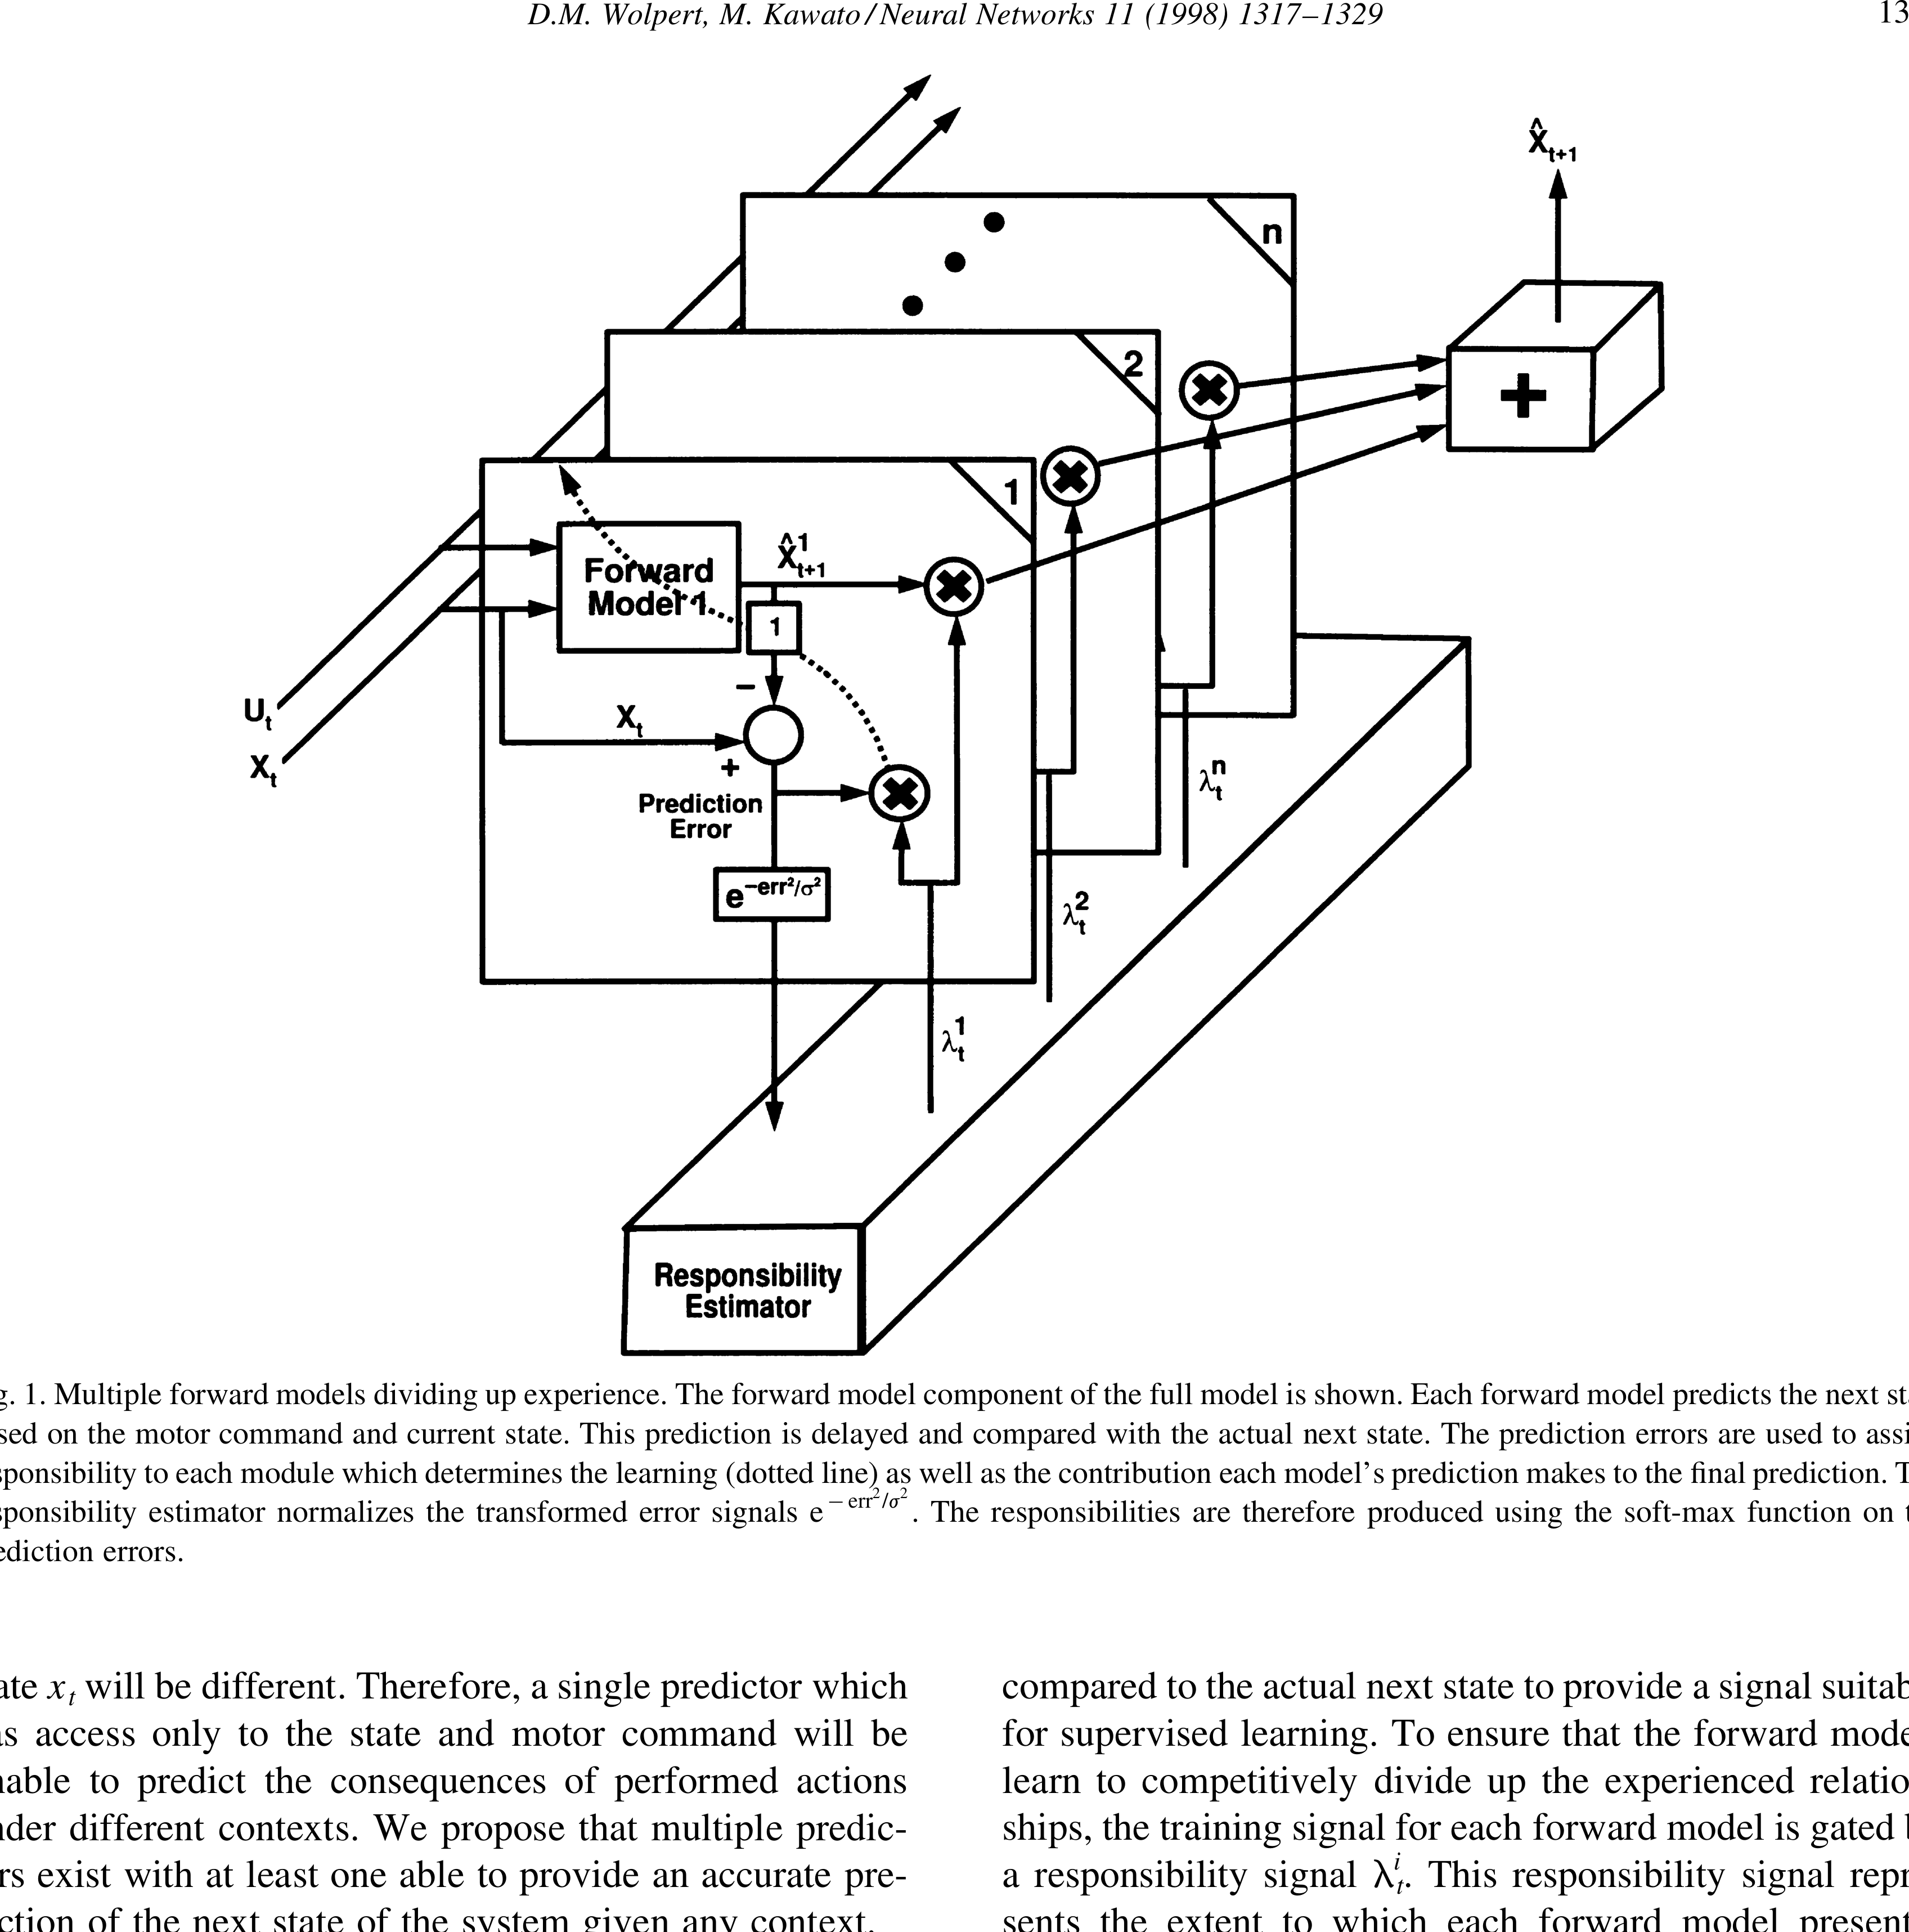
每个前向模型接收系统的当前状态及实际发出的总运动命令,而非仅接收与其配对的逆模型输出。预测误差经指数变换和归一化后生成责任权重;多个逆模型的输出再按权重混合。情境预测器输出先验,感觉预测的相对符合程度提供似然,两者共同决定后验责任。
反馈误差学习利用反馈控制命令近似指导逆模型更新。这是模型设定的学习假设,本文并未直接测量与该变量逐一对应的神经教学信号。
主要结果
本文的核心成果是一套多模块运动控制计算方案。责任权重同时调节逆模型的输出贡献,以及前向、逆向模块的学习强度,从而把“哪个控制器适合当前环境”与“哪个模块应更新”联系起来。
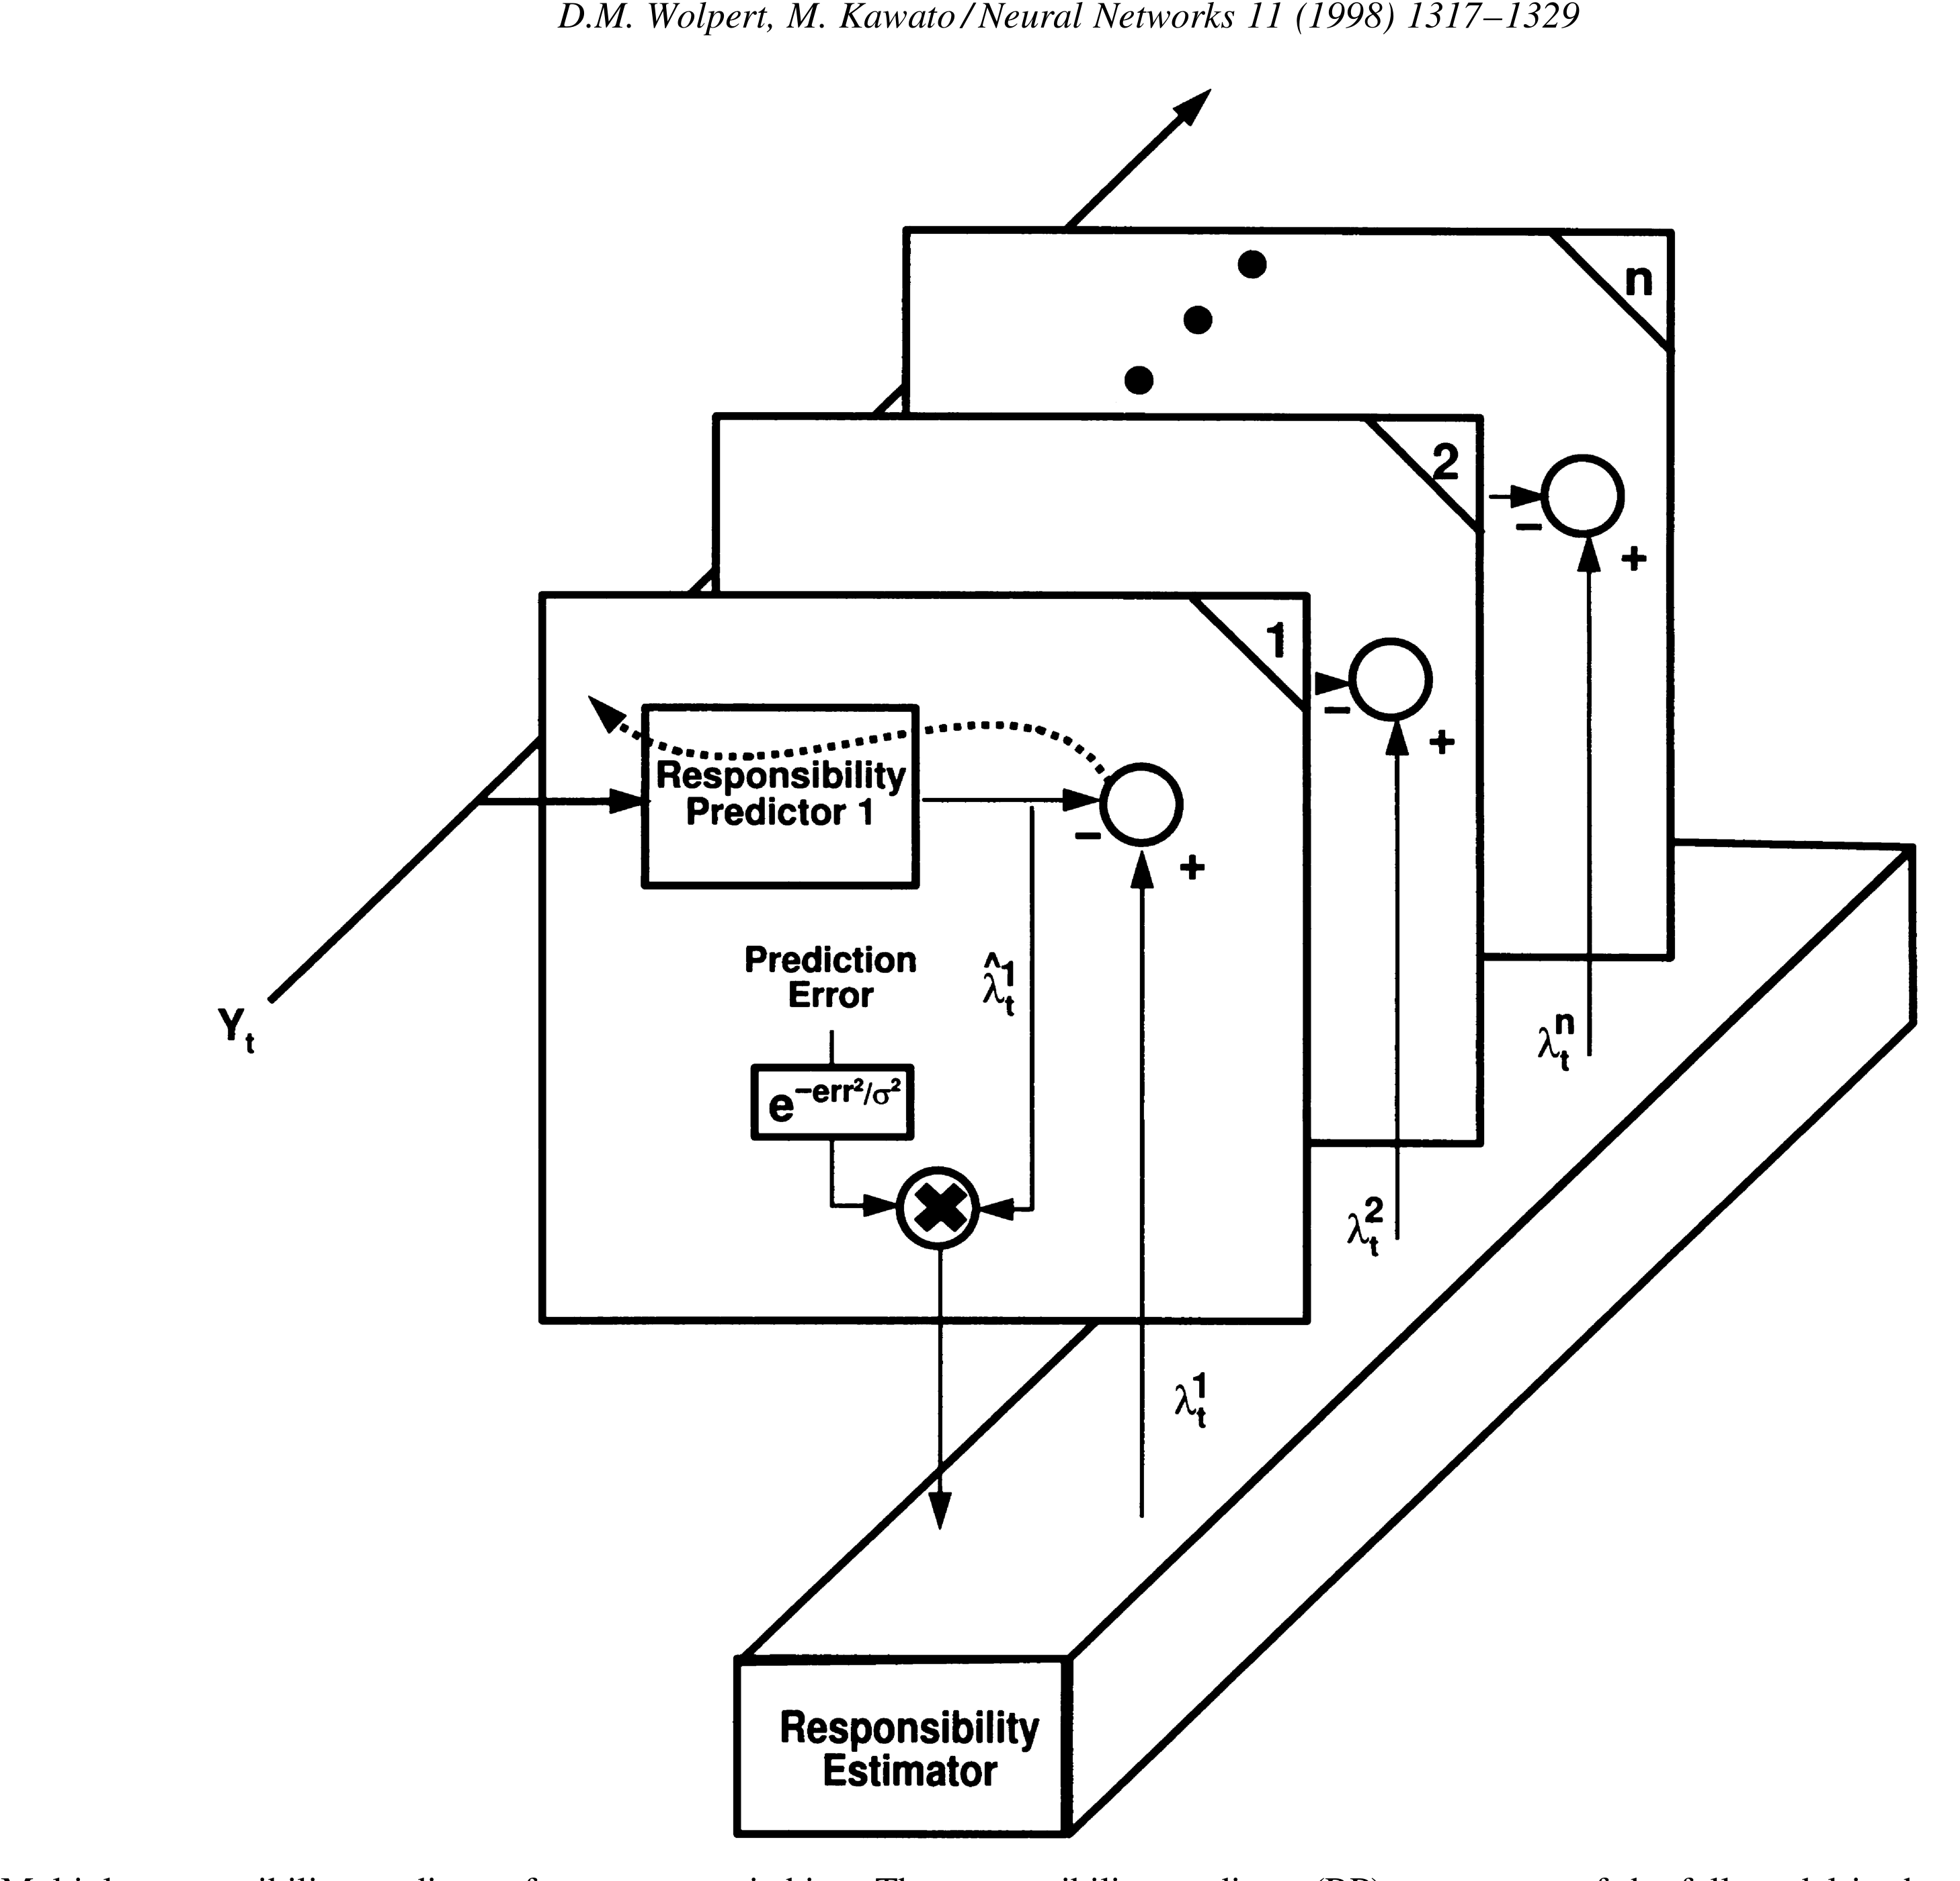
情境预测器通过学习拟合事后得到的责任估计,因而能在新动作开始前预先选择模块;运动后的感觉证据则进一步修正先验。这一过程并非仅凭自身预测进行闭环自我确认。
作者提出了一组可检验的实验预测,包括前向预测能力可能先于控制能力改善、切换应更依赖预测误差而非任务成绩误差、清晰情境线索有助于分离学习,以及已学成分有助于相关组合。文中列举的行为支持主要来自既有研究,不能视作本文直接完成的逐项验证。
逐图解读
 原文 Fig. 1 · PDF 第 5 页 · 原文图像 · 查看来源
图1 · 配对前向与逆向模块。 逆模型给出候选控制,前向模型依据实际总命令预测后果。责任估计连接预测比较、输出混合和学习分配;各框是计算角色,不是本文记录到的独立神经群。
 原文 Fig. 2 · PDF 第 6 页 · 原文图像 · 查看来源
图2 · 多前向模型的竞争。 比较各模型对实际感觉状态的预测误差,并归一化为责任权重。权重反映相对符合程度,不等于模型已无误差,也不是直接测得的生物概率。
 原文 Fig. 3 · PDF 第 8 页 · 原文图像 · 查看来源
图3 · 情境参与的责任预测。 情境预测器在运动前提供模块先验,事后责任估计为其学习提供教师。预测误差产生的似然与先验结合,使选择既能提前进行,也能被新证据修正。
 原文 Fig. 4 · PDF 第 9 页 · 原文图像 · 查看来源
图4 · 控制与反馈误差学习。 前馈命令和反馈纠正共同作用于被控对象,反馈命令还用于指导逆模型更新。图说明算法如何工作,不能当作已证实的攀缘纤维或小脑回路连接图。
讨论与解读边界
这套方案的价值在于明确了误差信号、情境信息、学习和控制之间的关系。行为迁移与多模块架构相容,但也需要与具备情境输入的单一模型、层级推断或其他记忆模型展开深入比较。
归一化权重产生的是加权混合,并不自动保证任意两个动力学环境的代数叠加都能实现零误差控制。模块数量、初始化、探索和稳定性仍是工程实现中的实际问题。作者提出的小脑定位属于候选解释,不能仅凭概念图或学习后的功能激活把各个计算框直接认定为已确证的脑区。
思考问题
- 让视觉情境指向一种动力学、实际感觉反馈指向另一种动力学,模型对切换速度与权重变化作出什么定量预测?
- 怎样用未训练的组合环境区分配对模块模型与参数量相当、包含情境输入的单一模型?