E05 · Automated markerless pose estimation in freely moving macaques with OpenMonkeyStudio
Bala, P.C., Eisenreich, B.R., Yoo, S.B.M., Hayden, B.Y., Park, H.S., & Zimmermann, J. (2020). Nature Communications, 11, 4560. doi:10.1038/s41467-020-18441-5
OpenMonkeyStudio利用62台同步相机、多视角标注增广和几何重建,估计自由活动猕猴的三维身体姿态。论文验证了整体动作和双猴互动追踪的可行性,同时显示末端肢体对视角数量更敏感。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
自由活动的猕猴在三维空间中攀爬、跳跃并频繁发生自遮挡与互相遮挡,单视角视频难以持续重建可靠的三维骨架姿态。传统光学标记动作捕捉在大空间自由行为中常遭遇标记混淆、红外反光干扰以及头部植入物的遮挡破坏;无标记方案则面临毛发体表特征模糊、视角剧烈变换及多肢体严重遮挡的技术瓶颈。环形多相机阵列可从不同方向同时观测个体,但如何在降低海量人工标注成本的前提下确保跨视角几何一致性,是解决多视角动作捕捉的核心方法学问题,而非单纯叠加相机硬件数量。
多视角几何约束在系统中提供了两重互补作用。在训练阶段,极少数优质视角下的人工标注可先通过三维重建解算空间坐标,再反向投影至其余未标注视角,形成多视角的自监督训练样本,使单视角关节点检测器能够充分学习不同视向与光照下的外观表征;在推理阶段,数十台相机的二维热图预测通过 RANSAC 三角化与骨骼动力学、时空平滑先验联合优化,可大幅缓解单相机的遮挡失效。分析相机配置影响时,需分别检验训练增广视角不足与推理阶段冗余视角不足对精度的差异化影响;全系统多视角重建仅作为内部伪真值,不能简单等同于独立的绝对物理真值。手部、膝部及足部等高自由度末端关节更容易受遮挡,其重构精度无法直接套用头部或躯干等刚性结构的评定标准。
Bala 等构建的 OpenMonkeyStudio 基于该思路,集成 62 台硬件同步相机、多视角几何标注增广及基于解剖约束的三维重建算法,系统评估了自由活动猕猴的三维连续姿态、动作分类与双猴社会互动。研究评估该系统在大型封闭笼舍内持续追踪的可行性、支持躯干与高自由度肢体所需的最小相机规模,以及三维姿态表征在行为学分类中的有效性。结果验证了大场景三维无标记追踪的可行性,并揭示了末端肢体对视角密度的强依赖。需注意 13 个身体特征点主要反映身体大关节运动,不包含手指精细抓握;双猴追踪演示尚不能保证在任意个体数量、外观相似或长时间严重遮挡下的身份一致性,亦不直接满足虚拟现实伸手抓握所需的毫米级精度与毫秒级闭环延迟。
研究思路
少数良好视角下的人工标注经三维几何重建反向投影至其余视角,高效构建大样本训练集。推理阶段融合多相机二维检测、三维三角化重投影及人体解剖与平滑约束,通过头部光学标记对比、相机数量消融、动作语义分类及双猴互动分析综合评估系统性能。
方法
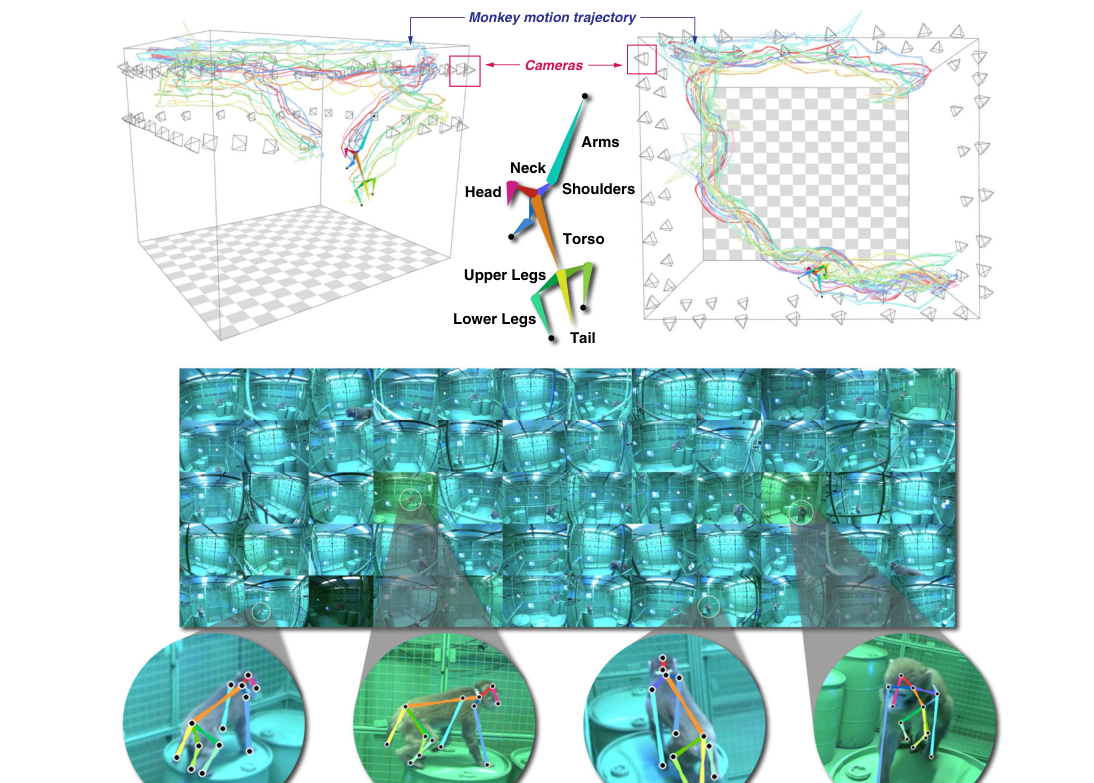
硬件配置:62 台 FLIR BlackFly S 工业相机(分辨率 1280×1024,支持 80 fps,实验实际采用 30 fps,全局快门,搭配 3–4 mm 鱼眼镜头),环绕 2.45×2.45×2.75 m 笼舍分双层刚性安装在外支架上;相邻相机基线长约 35 cm,视角差小于 6.7°,确保空间内任意位置至少有 10 台相机以 550×550 像素以上的有效分辨率捕捉目标;外部硬件 TTL 脉冲(70 ns 上升沿)同步触发全部快门,4 小时连续录制中多路快门同步精度达亚毫秒级;空间标定采用贴附多样特征图案的 1×3 m 刚性标定物进行运动恢复结构(SfM)解算,平均重投影误差约为 0.65 像素。数据流吞吐速率达 3.7 GB/s,通过分布式网络由 6 台本地采集服务器(PoE 交换机、10 Gb 光纤及 NVMe RAID)汇集至全局服务器。
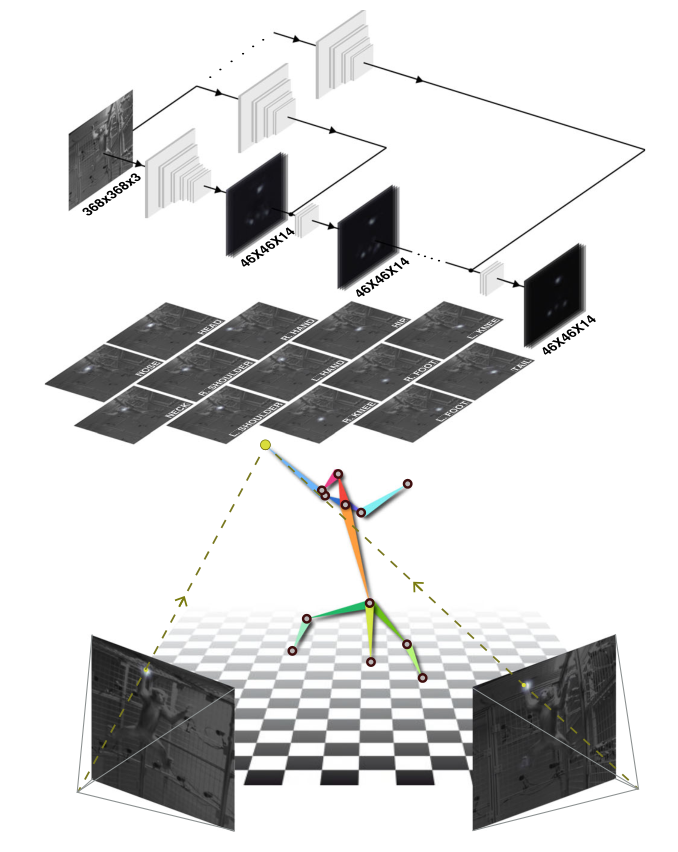
标注与增广:通过基于背景减除与粗三角化的三维质心平移量筛选关键帧,将人工标注帧数需求缩减 100–400 倍(从预估的 20 万帧压缩至 500–2,000 帧);算法从每个关键帧候选视角中推荐 3–4 个基线宽且遮挡少的视角交由人工标注(截至 2020 年 1 月累计标注 33,192 张图),重投影误差大于 10 像素的标记通过自研 GUI 联合修正;多视角增广算法将标注数据扩增 15–20 倍,辅以旋转(±30°)、平移(20%)、尺度变换(±10%)及水平翻转等几何变换。检测模型采用六阶段卷积姿态机(Convolutional Pose Machine,输入 368×368×3,输出 46×46×14 热图:13 个解剖关节点加背景通道),采用 L2 损失与 ADAM 优化器在单张 RTX 2080 Ti 上训练 110 万步;推理阶段使用 RANSAC 进行稳健三角化,并以颈部为根节点构建运动链,采用拟牛顿法最小化投影误差、肢体刚性长度及时间平滑项的联合代价函数。实验动物包括 4 只雄性恒河猴(5.5–12 kg),笼内设置配重栖木与果汁喂食站,经约 5 周笼舍适应。
主要结果
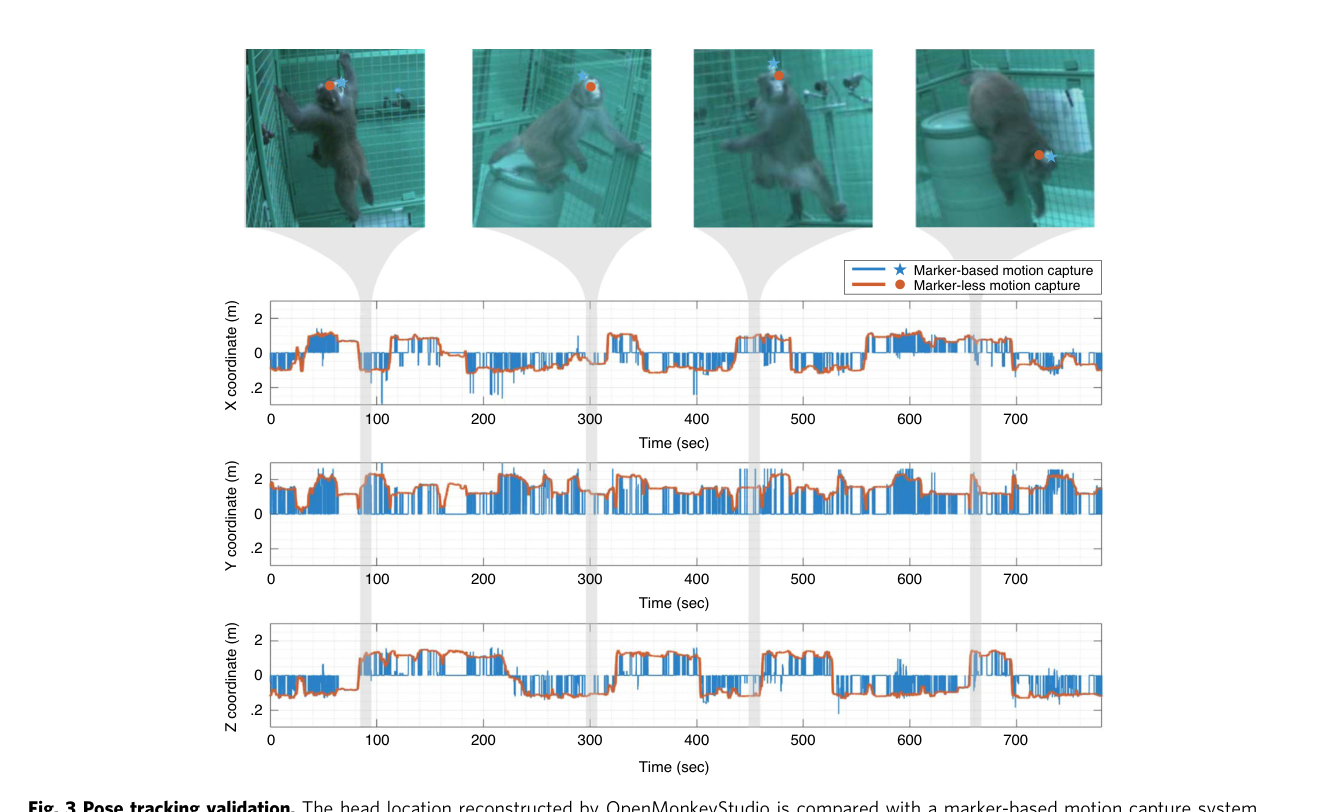
与 OptiTrack 光学标记系统的平行对比为系统精度提供了基准参考:在涵盖跳跃、攀爬等剧烈动作的 13 分钟连续序列中(30 Hz),头部三维位置中位误差为 6.76 cm(平均误差 7.14 cm,标准差 2.34 cm);该误差包含标记物高出头顶约 5 cm 的固定几何偏差,且训练集未纳入佩戴植入物的个体。相比之下,OptiTrack 在大笼复杂环境下因反光标记遮挡和混淆产生了较多伪影与坏点。
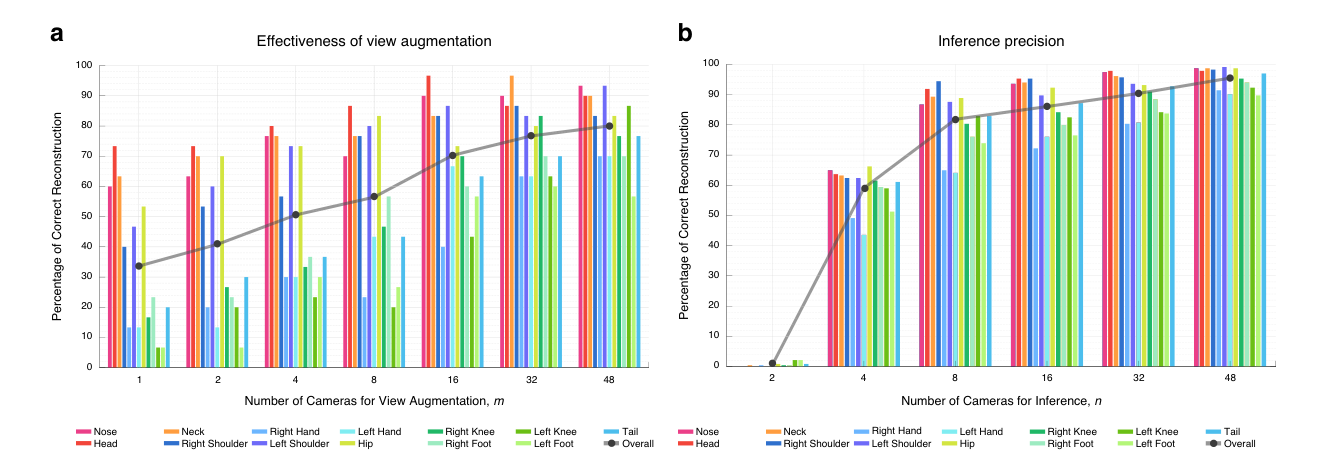
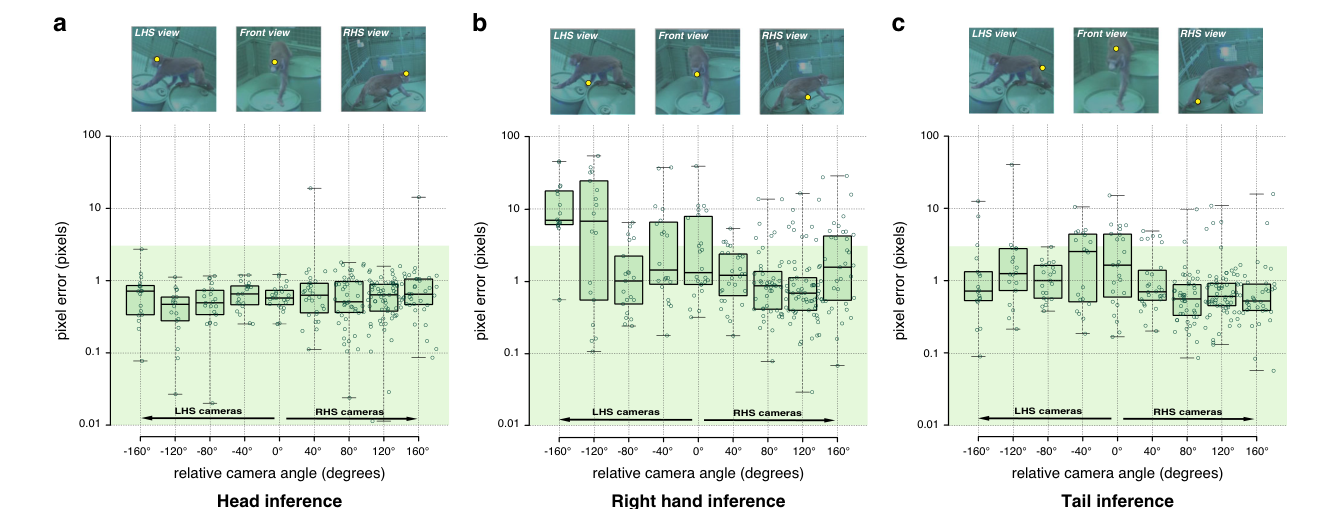
多视角增广消融实验证实了几何扩增对高自由度末梢的核心价值:若仅使用单一视角训练,相对全系统伪真值的重建一致率(10 cm 空间容差)仅为 34%,手部重建一致率低至 12%;引入 48 视角投影增广后,整体一致率升至 76%。在推理配置方面,训练完成的模型仅需 8 台相机即可达成全系统 80% 的整体姿态估计精度;但对于手、膝、足等易遮挡且自由度高的肢体末端,则需要至少 32 台相机才能达到相当水准。视角相关性分析表明,头部等几乎全视角可见的刚性点,其检测误差受拍摄角度影响极小(平均误差低于 2 像素,n=344 帧);而右手在动物朝向对侧的相机画面中频繁被躯干遮挡,检测误差呈现明显的方位依赖性,印证了全环绕相机冗余配置的必要性。
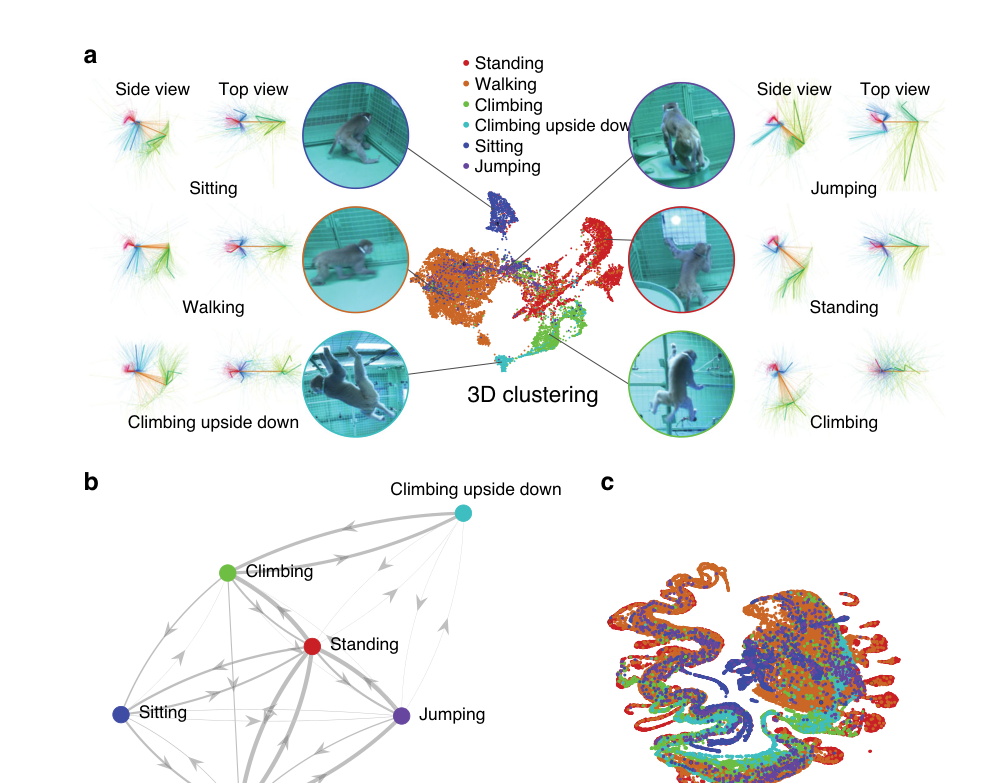
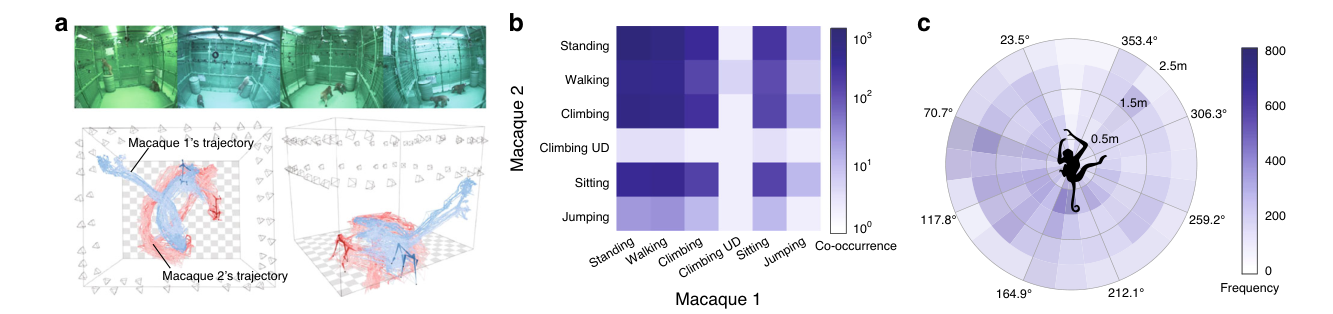
在行为表征能力(expressibility)检验中,研究将三维连续姿态转换至以颈部为原点、重力方向对齐 y 轴、脊柱对齐 z 轴且长度归一化的规范坐标系中;一段 30 分钟连续序列(54,000 帧)的三维姿态经 UMAP 降维后,聚类簇高度对应站立、行走、攀爬、倒挂、坐立及跳跃等离散语义动作类别;基于 k 近邻(kNN)的动作识别表现出物理上连贯的转换路径(如由行走进入倒挂需经过站立与攀爬过渡)。相对地,直接对二维姿态进行聚类则受到视角变换的显著干扰,同类动作被离散为多个碎片化小簇。在双猴自由互动任务中,两只恒河猴路径交叉时系统能够维持各自的三维骨架追踪与身份连续性,并支持由三维姿态数据直接计算动作共现矩阵以及基于相对身体坐标系的社会距离与朝向空间分布(proxemics)。
逐图解读
来源:原文 Fig. 1,PDF 第 3 页。
图 1 · 检测架构。 六阶段卷积姿态机(CPM):输入 368×368 图像,输出 46×46×14 维空间响应图(13 个解剖关节点及背景通道),空间响应极值点对应预测关节点位置;多视角预测结果结合相机内外参校准进行几何三角化,输出三维骨骼姿态。追踪关节点覆盖鼻尖、头顶、双耳、肩、手、髋、膝、脚及尾根等 13 处标记点,展示基于多视角几何实现视向不变性检测的模型框架。
来源:原文 Fig. 2,PDF 第 4 页。
图 2 · 系统总览。 62 台同步相机全方位环绕大型笼舍空间,彩色轨迹线展示重建出的连续关节点运动曲线,侧边附局部视角的投影校验图。该图展示了连续环形视角配置在提供训练增广样本及推理阶段容纳遮挡互补中的工程设计。
来源:原文 Fig. 3,PDF 第 5 页。
图 3 · 与 OptiTrack 的对比验证。 头部三维坐标沿 x、y、z 轴随时间的动态演进对比:光学标记系统易受标记混淆干扰出现跳变毛刺,OpenMonkeyStudio 的无标记三维重建保持平滑连贯,在中位误差 6.76 cm 的测量条件下完成跳跃与攀爬追踪,表明无标记视觉语义关联在大空间抗混淆方面的有效性。
来源:原文 Fig. 4,PDF 第 5 页。
图 4 · 训练增广与推理相机数的消融。 (a) 训练视角增广相机数量从 1 增加至 48 台时各关节相对全系统基准的一致率(10 cm 阈值):刚性躯干部位单视角即可达到约 65%,四肢末端在多视角增广下从 12% 显著上升,系统整体由 34% 提升至 76%。(b) 推理相机数量消融:8 台相机可恢复约 80% 的总体性能,而手脚末端需配置至 32 台方可充分收敛。
来源:原文 Fig. 5,PDF 第 6 页。
图 5 · 检测精度的视角依赖。 以头部朝向为参考基准建立 -160° 至 160° 的相机方位坐标:(a) 头部在几乎所有观测角度均维持在 2 像素以内的平均误差(n=344 帧);(b) 右手在逆侧视角下受躯干遮挡影响,定位误差出现系统性峰值;(c) 尾部误差呈中等程度波动。该方位特性解释了环形冗余布置相机对互补遮挡盲区的物理必要性。
来源:原文 Fig. 6,PDF 第 6 页。
图 6 · 3D 姿态聚类对应语义动作。 (a) 30 分钟连续三维姿态经 UMAP 降维形成分立簇,各簇骨架三维重构对应站立、攀爬及倒挂等标准动作。(b) 结合 kNN 在独立序列上实现动作连续分类与物理合理的转换流。(c) 对照组二维姿态降维分布受拍摄视向干扰,未能形成语义分明的连续动作簇。
来源:原文 Fig. 7,PDF 第 7 页。
图 7 · 双猴社会互动追踪。 (a) 两只猕猴在笼中自由活动交叉穿行时,系统维持两个个体的三维姿态解算与身份分离。(b) 双猴行为状态的共现矩阵(对数刻度)。(c) 社会近近距离空间直方图(proxemics):基于同伴在自身参照系内的极坐标分布,解析个体间空间占位的相对概率。
来源:原文 Fig. 8,PDF 第 7 页。
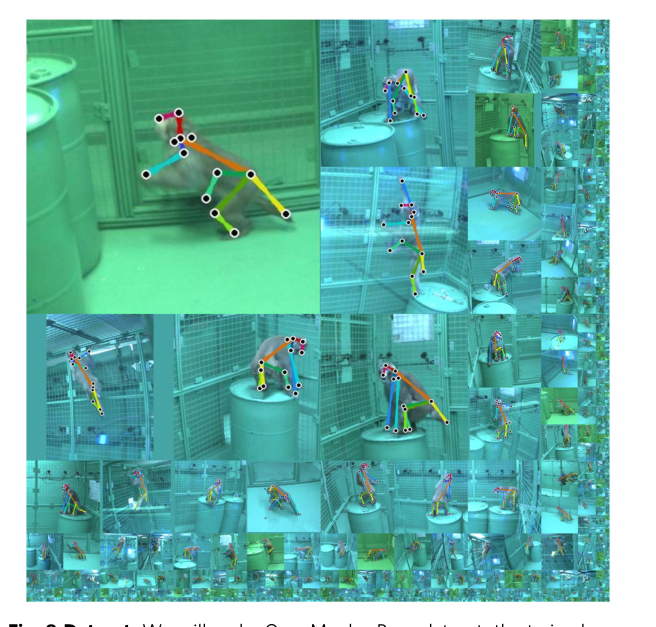
图 8 · OpenMonkeyPose 数据集。 涵盖 195,228 组标注姿态样本,包含 62 个视角下大范围空间位置与身体构型变化,覆盖桶装栖木、绳索、喂食装置等交互环境、双重背景色(米色与色度键控绿)以及 4 只体型年龄差异显著的个体(5.5–12 kg),对应开源的数据、姿态检测网络与训练测试基准。
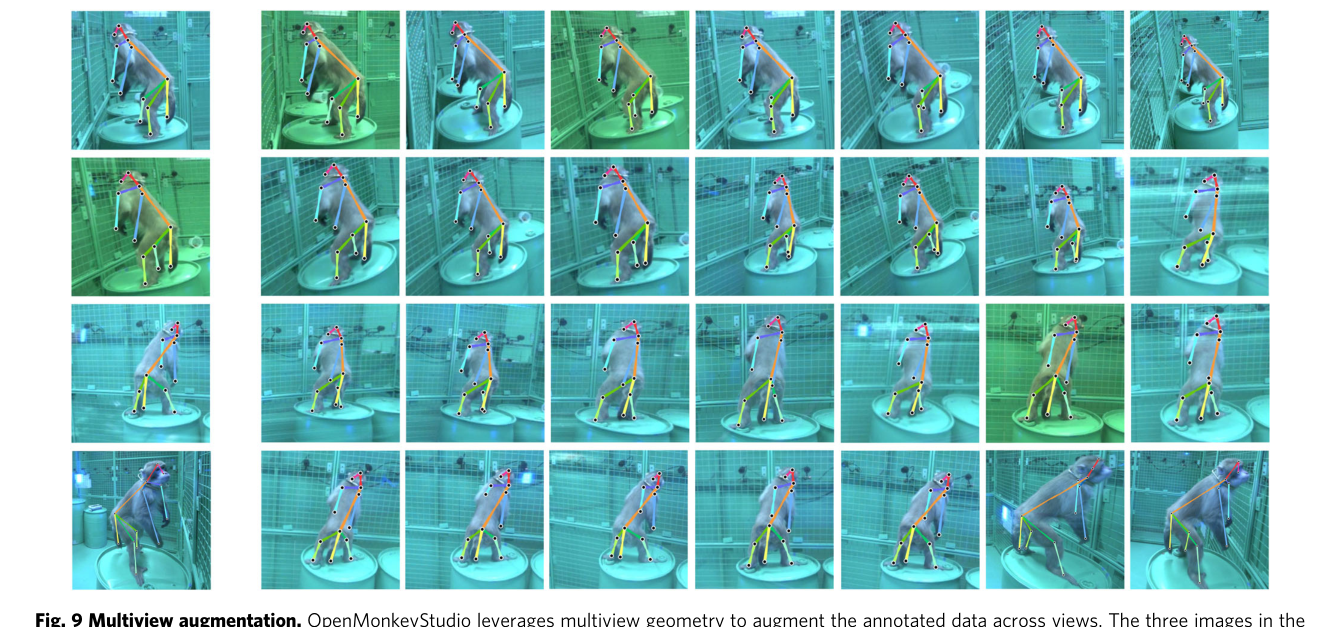
来源:原文 Fig. 9,PDF 第 9 页。
图 9 · 多视角增广的机制。 左列展示人工标注的关键视角,右侧各视角的二维标注均由三维几何重建经投影矩阵自动映射生成。该流程直观展示了一次人工多点标注被几何投影扩增至数十个视角画面的数据增广杠杆,大幅降低了大规模三维训练数据的采集成本。
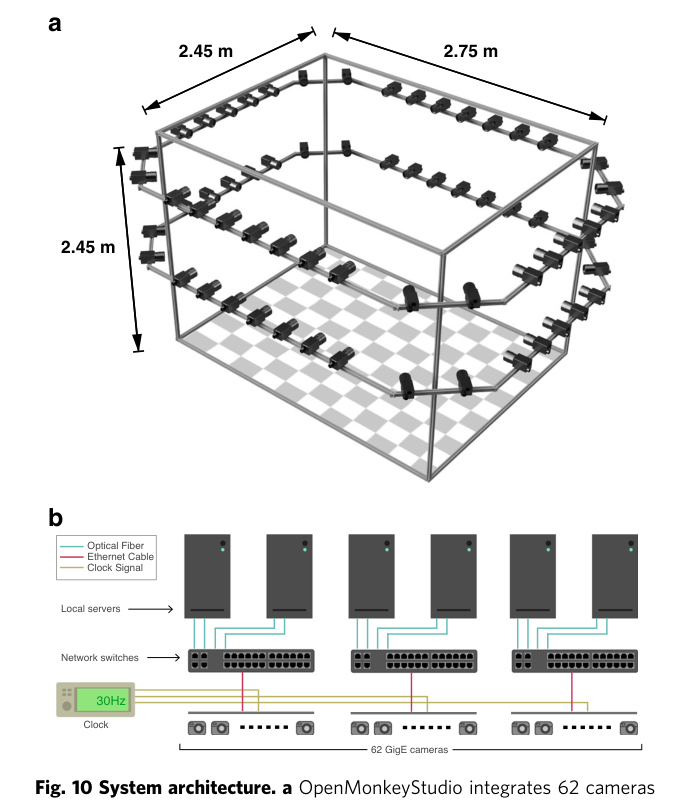
来源:原文 Fig. 10,PDF 第 10 页。
图 10 · 系统架构。 (a) 62 台相机嵌入式安装在 2.45×2.45×2.75 m 笼舍四周面向活动中心。(b) 分布式采集硬件链路:相机经 PoE 交换机和 10 Gb 光纤网络分流至 6 台本地采集节点,由主控服务器统一调度,依托外置同步时钟确保亚毫秒级快门协同。
讨论与解读边界
多视角系统既提供训练样本,也在推理时缓解遮挡。图4的相机数量消融使用全系统重建作为伪真值,10 cm容差下的相对一致率不能当成独立真值测得的绝对准确率。图3与OptiTrack的头部比较则同时受到标记偏移和参照系统误差影响。
13个身体landmark足以支持大范围姿态和动作分析,但不是精细手指运动捕捉。双猴示例说明可行性,尚不能保证任意个体数量、长期遮挡或相似外观下的身份稳定。UMAP与语义动作对应提供可解释的行为表示,不意味着只有三维数据才包含动作信息。本文不能直接给出VR抓握系统所需的毫米级误差与实时延迟保证。
思考问题
- 用独立测量的三维真值和毫米级阈值评估手部时,系统的误差与失踪率是多少?
- 减少相机后,训练增广不足与推理遮挡各自损失多少性能,怎样设计对照把两者分开?