E04 · DeepLabCut: markerless pose estimation of user-defined body parts with deep learning
Mathis, A., Mamidanna, P., Cury, K.M., Abe, T., Murthy, V.N., Mathis, M.W., & Bethge, M. (2018). Nature Neuroscience, 21, 1281–1289. doi:10.1038/s41593-018-0209-y
DeepLabCut将预训练视觉网络用于用户自定义身体部位的二维定位。小鼠和果蝇实验表明,在所测成像条件下,较少标注即可取得接近人工标注变异的误差;跨物种仍需相应训练和验证。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
运动控制研究日益依赖视频记录的高精度姿态轨迹,但人工逐帧标记鼻尖、尾根或手指关节位置耗费大量人力,且不同实验关注的关节点各不相同。预设的骨架模型往往不包含特定研究关注的解剖标记,重新训练深度模型通常又需要大量任务内人工标注。由此产生的方法学核心问题是:能否利用在 ImageNet 上预训练的深层卷积网络所提取的通用视觉表征,仅补充少量任务特定标注,即可训练出适用于任意自定义身体部位的高精度检测器?这一技术路径直接决定了行为学测量的通量、可重复性以及下游神经数据分析的质量。
评估这类姿态估计工具不能仅依赖定性演示图。像素级定位误差必须结合图像绝对分辨率、被测身体部位尺寸以及人工重复标注的自身变异来综合衡量;训练集大小曲线用于量化“低标注量”的具体边界,随机抽帧划分与按动物个体、记录日期或相机视角留出的测试方案对应着不同的泛化标准。测试个体轨迹平滑是直观的定性检查手段,但无法替代基于基准真值的定量误差评定。在多动物场景下检出多个部位,不代表能稳定保持个体身份的长期一致性。遮挡导致的输出概率下降可用于置信度筛选,但并不等同于经过良好统计校准的不确定性。
Mathis 等提出的 DeepLabCut,将预训练 ResNet 特征提取骨干与解卷积热图(score-map)预测架构相结合,分别在小鼠气味追踪、果蝇自由活动及小鼠前肢操纵杆任务中完成了训练与验证。研究系统比较了训练帧数、网络深度、多部位联合监督与迁移测试表现,评估少量标注达到人类标记者一致性水平的可行性,以及该流程迁移至不同物种和实验场景的能力。该工作为二维无标记姿态估计提供了实用工具,但“约100帧”或“人类水平”并非在所有复杂成像条件下均可自动保证,研究中也未直接验证猕猴三维抓握、严重遮挡下的关节解算或实时虚拟现实闭环所要求的延迟特性。
研究思路
研究通过微调基于深度特征的部位检测网络,以人工重复标注的变异度作为误差参照基准,系统比较不同标注规模下的定位精度,并在新个体、果蝇以及小鼠手指精细动作任务中进行测试。每种任务均设有独立训练与测试流程,跨物种的方法复用依赖于特定场景下的针对性标注与再训练。
方法
网络架构采用预训练 ResNet-50 移除分类输出层,连接反卷积层(deconvolutional layers),为每个目标身体部位输出预测分数的空间概率热图(score-map);训练时在真实标注位置周围设定 $\epsilon=17$ 像素半径的高斯目标分布,以交叉熵为损失函数,采用随机梯度下降(SGD)优化约 50 万步收敛。单张 GTX 1080 Ti 显卡训练耗时通常在 24 小时以内,batch size 设为 1(支持变尺寸图像输入),数据增强采用 50%–150% 的尺度缩放。验证覆盖三个逐步深入的数据集:小鼠气味轨迹追踪(双相机,7 只小鼠,共抽取 1,080 帧标注鼻尖、双耳及尾根四点;同一标注者间隔一月以上重复标注,人工变异度为 2.69±0.1 像素,而低分辨率画面中鼠鼻宽度约 5 像素);果蝇产卵盒自由活动(6 只果蝇,589 帧,标注 12 个可见身体点);头部固定小鼠操纵杆拉动任务(5 只小鼠,2048×1088 高分辨率,100–320 Hz 记录,标注 13 个关节点,包括每根可见手指的远端、近端关节与根部加腕部,共 159 帧)。全套流程封装为开源工具箱,提供抽帧、标注校验、数据生成及批量推理功能。
主要结果
核心测试结果表明标注样本需求显著降低。使用 80% 的标注帧(约 860 帧)训练时,鼻尖和尾根的测试集均方根误差(RMSE)即达到人工重复标注的变异水平;当训练规模从 80% 系统缩减至 20%、10%、5% 及 1% 时(评估了 30 个独立网络),测试误差仅平缓上升,在 10% 训练量(约 100 帧)下仍保持在平均 5 像素以内,相当于低分辨率画面中一个鼻尖的大小,远小于高分辨率相机下约 30 像素的鼻宽。选用更深的网络骨干(如 ResNet-101)或引入中间监督仅带来小幅精度微调(50% 训练集下测试 RMSE:ResNet-50 为 3.09±0.04 像素,ResNet-101 为 2.90±0.09 像素,带中间监督的 ResNet-101 为 2.88±0.06 像素)。旋转平移等常规几何增强对精度的提升较为有限,表明降低标注负担的核心在于筛选涵盖代表性姿态的多样化关键帧。
第二项发现是模型展现出良好的跨个体泛化能力。仅在单只小鼠数据上完成训练的网络,直接应用于未参与训练的新个体时,2,331 帧连续轨迹平滑无突变,逐帧位置差集中在数个像素之内;在未增加多动物专属标注的情况下,面对三只小鼠相互活动且照明不均的开阔场环境,网络能够同时检出多个个体的身体部位,仅在相互重叠遮挡时发生预测丢失。第三项发现体现在多部位联合训练的增益:同时标注四个部位训练的全模型,其在鼻尖上的 RMSE 显著低于仅针对鼻尖标注训练的专用网络(约减少一半误差),表明共享卷积主干能够借助不同身体部位的监督信号学习解剖结构约束。
在极端形态与精细动作测试中,模型同样维持了稳定表现。果蝇数据集在 95% 训练集规模下的测试 RMSE 为 4.17±0.32 像素(复眼直径为 36 像素,腿节宽度约 8.5 像素),对不同朝向、盒壁/顶面位置以及产卵背景杂波均保持鲁棒,并能跟踪口器伸展等微小形变。在小鼠手部测试中,仅用 141 帧训练,关节点测试 RMSE 为 5.21±0.28 像素(单根手指宽度约 15 像素)。热图峰值概率可反映检测置信度:当手指抓握操纵杆出现局部遮挡时,对应部位的预测概率显著下降,这种不确定性特征可用于主动学习中难例帧的筛选与补充标注。在推理吞吐量方面,GTX 1080 Ti 处理 682×540 视频约为 30 fps,在 204×162 分辨率下可达约 85 Hz,不过文章并未测量端到端的实时闭环控制延迟。
逐图解读
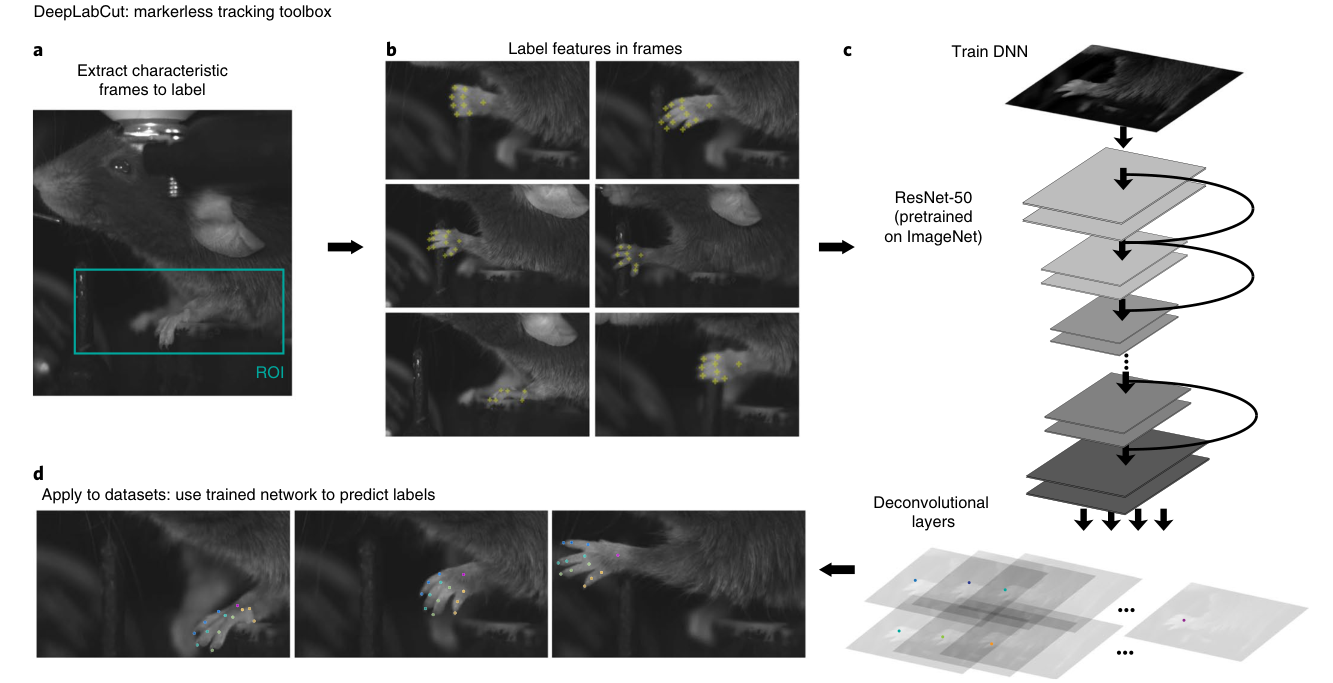
来源:原文 Fig. 1,PDF 第 2 页。
图 1 · 工具箱工作流程。 整体包含四个阶段:选取代表性姿态帧(在覆盖行为特征的前提下尽量缩减感兴趣区域 ROI)、人工标注自定义关节点(图示为小鼠前肢 13 个点:每指三处关节及腕部)、训练深度网络(预训练 ResNet-50 骨干接反卷积读出层,每个关节点输出独立 score-map 热图),以及使用训练完成的模型对新视频进行批量推断。该图阐明了工具箱面向任意用户自定义解剖结构的通用设计思路。
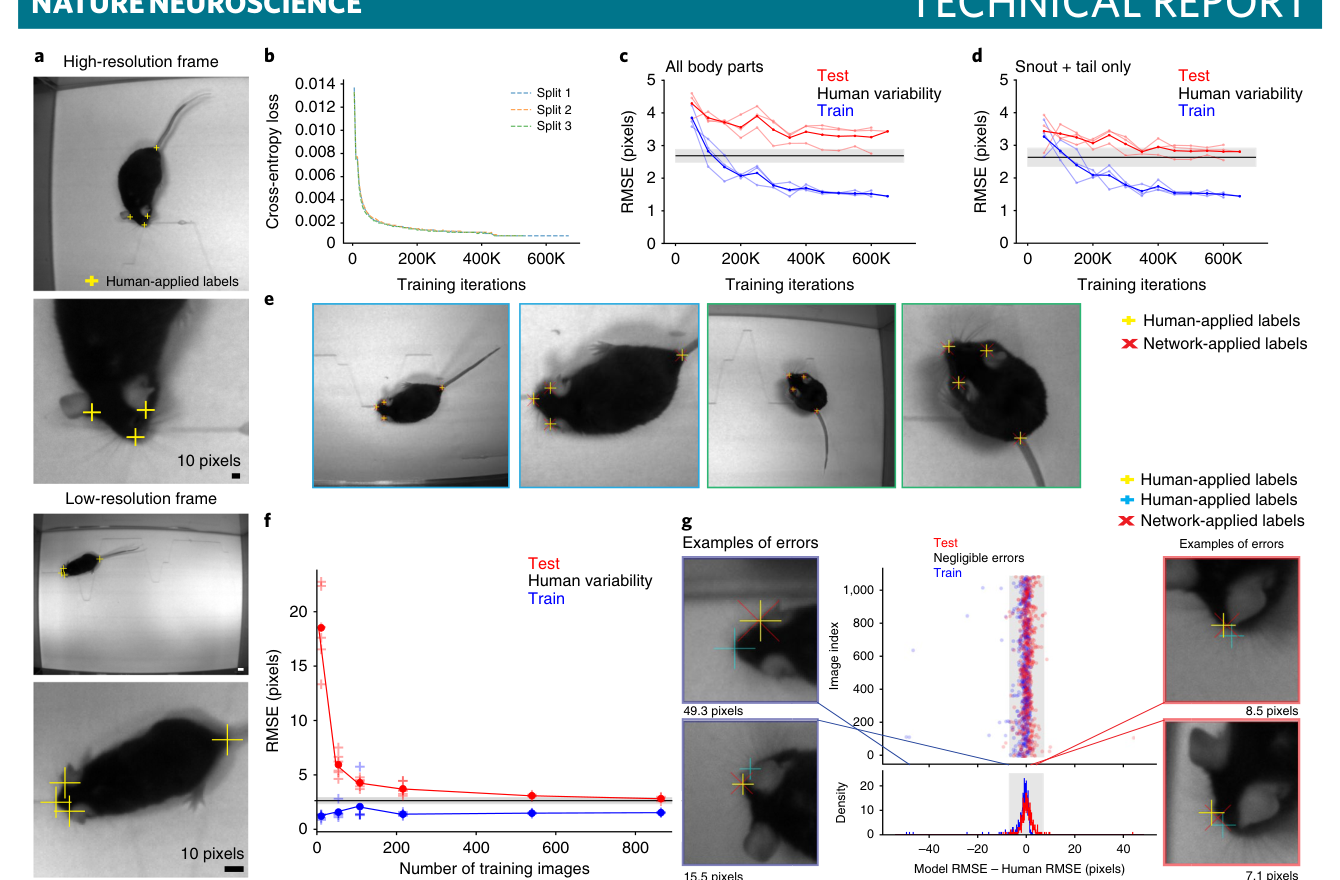
来源:原文 Fig. 2,PDF 第 3 页。
图 2 · 气味轨迹任务上的基准测试。 (a) 双视角相机示例:红外照明下的气味痕迹与奖励构成时变背景,标注了鼻尖、双耳及尾根。(b、c) 在 80%/20% 训练/测试划分下,三个不同 split 的交叉熵与 RMSE 随迭代轮次的收敛曲线,阴影带表示人工重复标注的变异范围及其 95% 置信区间,模型测试误差最终落入该基准范围内。(d) 针对鼻尖与尾根的测试误差,达到人工标注一致性水平。(f) 核心消融曲线:训练帧数从约 1,000 帧降至约 100 帧时,测试 RMSE 平缓上升,在约 100 帧时仍保持在 5 像素以内。(g) 模型与人工标注误差的逐点对比,多数散点聚集在零点附近,少数较大偏差源于人工标注的离群值。
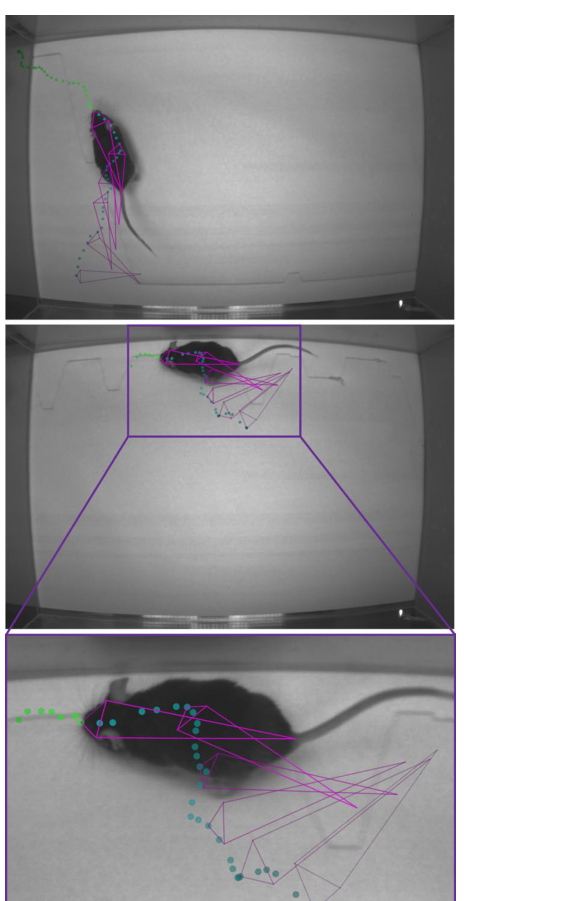
来源:原文 Fig. 3,PDF 第 4 页。
图 3 · 追踪行为的"舞蹈谱"。 绿色与青色散点分别代表小鼠鼻尖在未来与过去 30 个时间步的位置轨迹(采样间隔 33.3 ms),品红菱形对应特定时刻的头部与躯干姿态,灰色线代表地面的气味轨迹。四个关节点的追踪完整重现了啮齿动物沿气味轨迹左右摆头搜寻的典型运动模式,展示了自动化姿态提取在精细行为学量化中的直接应用。
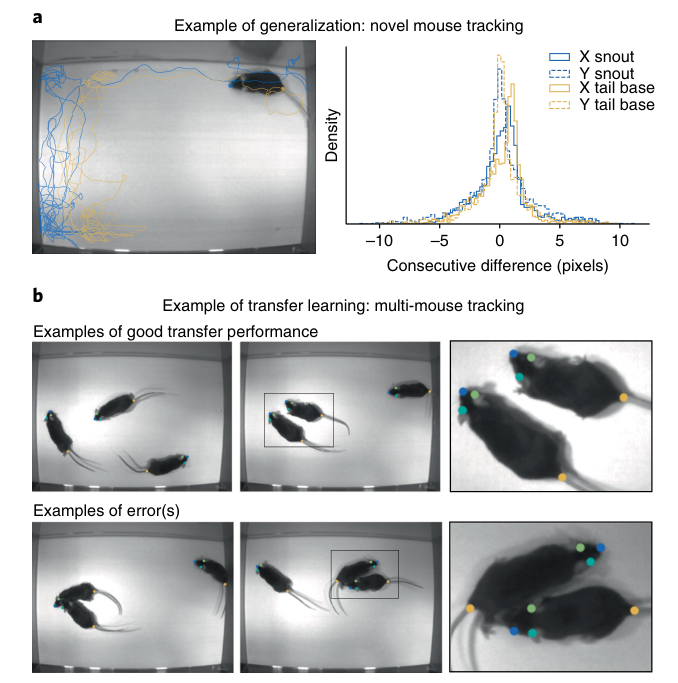
来源:原文 Fig. 4,PDF 第 5 页。
图 4 · 泛化与迁移。 (a) 未见测试个体在传送带上追踪气味的鼻尖与尾根逐帧轨迹(n=2,331 帧),位置变化平滑连贯,连续帧间位移直方图主要分布在低像素区间,验证了跨个体的预测泛化。(b) 多目标场景测试:单鼠数据训练的模型在三只小鼠同场互动的画面中,能够分别检出各只鼠的身体部位,在无遮挡情况下表现稳定,而在相互遮挡时出现局部漏检。
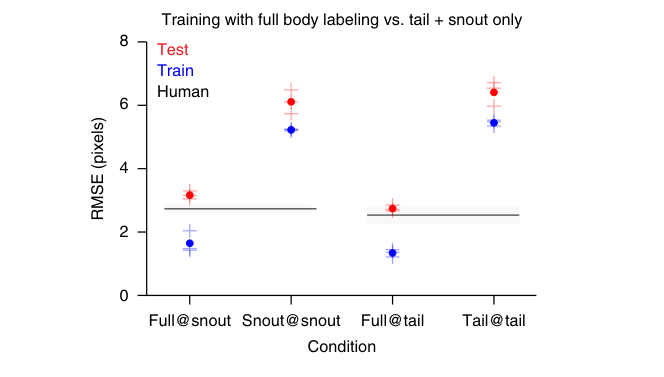
来源:原文 Fig. 5,PDF 第 5 页。
图 5 · End-to-end 训练的收益。 在相同的三个 50% 训练集划分下,对比包含全部关节点监督的全模型与仅标注单一关节点的专用模型:全模型在鼻尖和尾根上的 RMSE 几乎只有专用模型的一半。两个模型在目标关节点上的监督标签一致,误差差异表明共享卷积层有效利用了多关节点之间的协同空间几何约束。
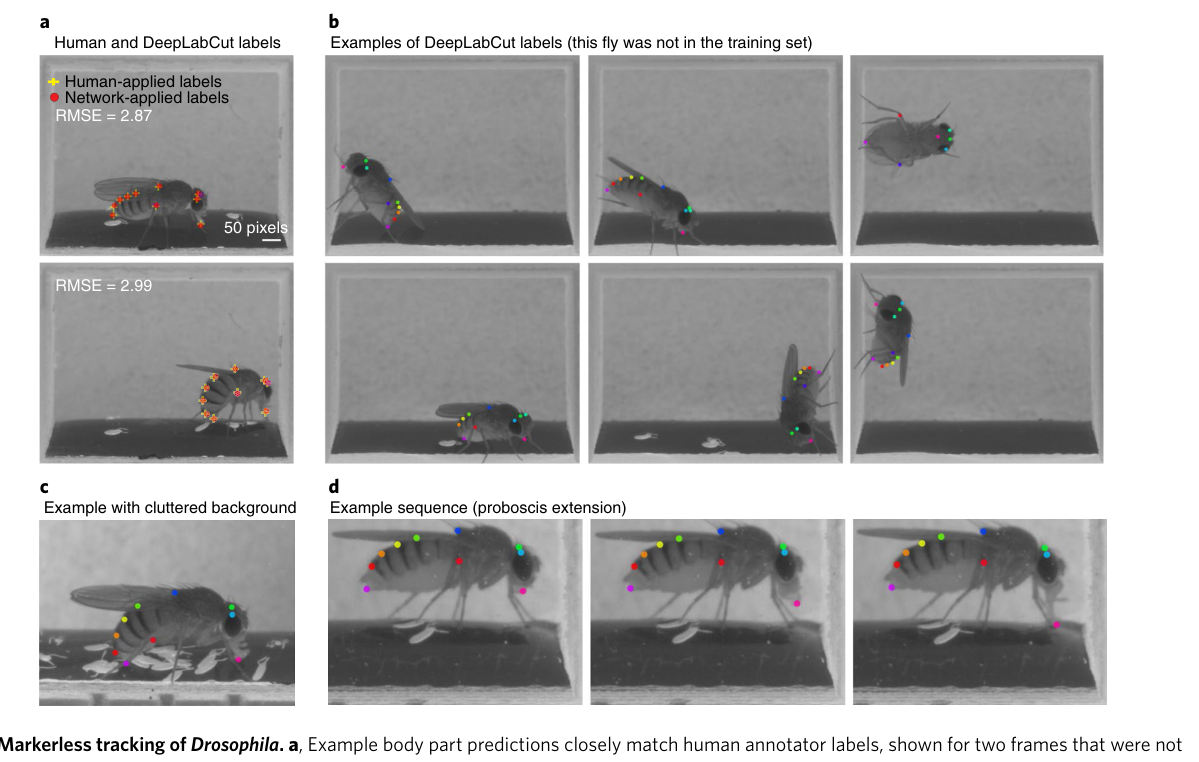
来源:原文 Fig. 6,PDF 第 6 页。
图 6 · 果蝇:朝向、背景与快速动作。 (a) 测试帧上人工标注与模型预测高度贴合(两个示例帧的 RMSE 分别为 2.99 与 2.87 像素)。(b) 未参与训练的果蝇以多种身体朝向出现在容器侧壁与顶面,检测表现稳定。(c) 面对被产下卵粒逐渐覆盖的杂乱背景,模型维持了检测能力。(d) 能够连续捕捉口器伸展等高动态细微形变动作,证实该方法经针对性训练后可扩展至无脊椎动物精细行为。
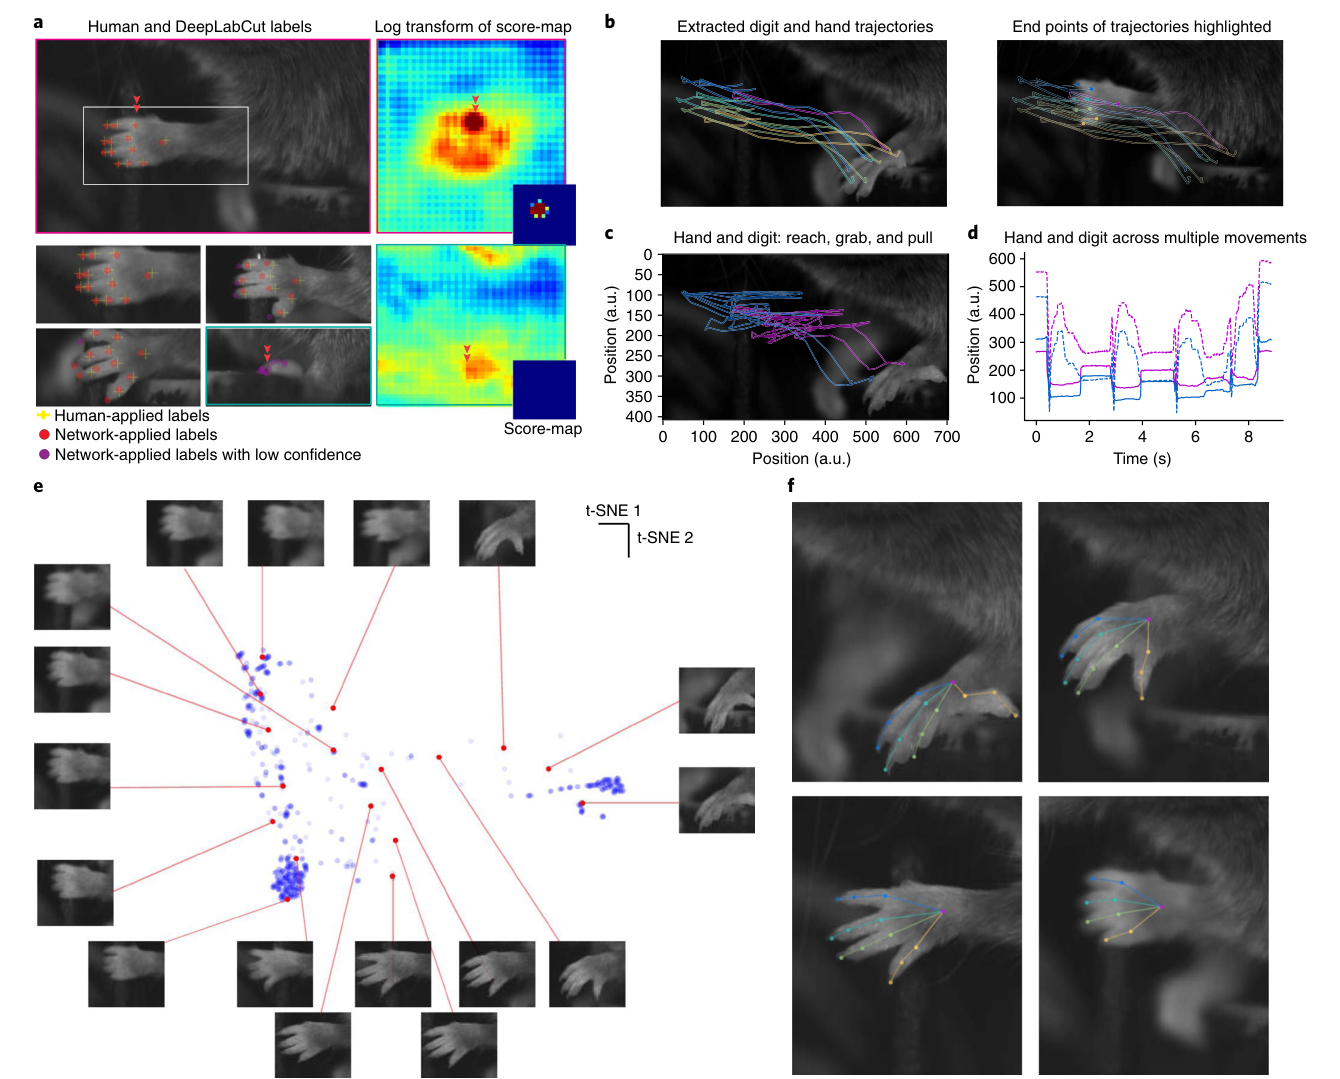
来源:原文 Fig. 7,PDF 第 7 页。
图 7 · 手指追踪与置信度读出。 (a) 人工标注(黄)与模型预测(红/紫)对照:热图峰值概率大于 10% 标为红色,否则标为紫色。经 141 帧训练的模型在测试帧上贴近人工标记,且在操纵杆遮挡部位自发降低置信度(紫色显示)。(b–d) 运动控制下游分析应用:未加滤波的逐帧手指运动轨迹,以及三次抓握拉动过程中腕部与各指运动模式的定量对比。(e) 基于预测腕部位置对 1,139 帧手部图像进行 t-SNE 降维嵌入展示。(f) 连接语义关节点构建的前肢骨架示意图。
讨论与解读边界
本文的主要贡献是降低定制姿态估计的门槛,并给出标注量、误差和迁移表现的实测比较。像素误差依赖分辨率、部位大小与标注规则,不能将“约100帧”或“人类水平”当作任何实验都成立的保证。
新动物轨迹平滑是有用的定性检查,但不替代有真值的定位误差。多鼠画面中的部位检测并不是稳定的个体身份追踪。score-map峰值可用于筛选低可信预测,却不等于经过校准的不确定性;吞吐帧率也不等于闭环端到端延迟。本文没有直接验证猕猴三维手姿态、遮挡下关节恢复或实时VR闭环。
思考问题
- 若测试集按动物、拍摄日和相机条件整体留出,误差会比随机帧划分增加多少?
- 在猕猴抓握中,应如何标注被遮挡关节,并分别评估定位误差、身份一致性和闭环延迟?