C07 · Neural population dynamics underlying motor learning transfer
Vyas, S., Even-Chen, N., Stavisky, S.D., Ryu, S.I., Nuyujukian, P., & Shenoy, K.V. (2018). Neuron, 97, 1177–1186. doi:10.1016/j.neuron.2018.01.040
猴子通过 BCI 适应视觉旋转后,部分学习能迁移到真实手臂运动。迁移伴随准备期群体状态的持续偏移,跨情境状态相似程度与迁移量相关。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
在手臂受限时学习BCI控制,能否影响随后真实手臂动作,为研究跨情境运动学习提供了入口。两种情境的准备活动是否共享,是一个可以检验的候选联系。
研究思路
动物在真实手控与手臂受限的脑控之间切换,并在脑控中适应视觉旋转。作者测量手控后效应、准备态变化及跨情境重叠与迁移的关系。这里的covert是具体BCI任务,不等同于无反馈的纯心理想象。
方法
两只雄性恒河猴(R,12 岁 15 kg;J,15 岁 16 kg),各植入两片 96 通道 Utah 阵列(PMd 与 M1,实验时已植入 5 年和 7 年),threshold crossing(−4.5×RMS)不做 spike sorting,PMd 与 M1 数据合用。任务为 instructed-delay 的 Radial 8 Task:中心 hold 500 ms,400–800 ms 随机延迟期(期间光标速度须低于 1 mm/s),随后在 2 s 内获取目标(4×4 cm 窗口,hold 500 ms)。VMR 有 4 个角度(±45°、60°、90°),为迫使猴子认真适应,逐步收紧时间限制(从 10 s 降到 1.5 s)并引入路径效率检查。主实验流程:covert(BMI)无 VMR 或有 VMR 各 2000±1000 个 trial(约 90 min),然后实验者进屋解开手臂约束,做 500 个 overt 无 VMR trial,比较 after-effect;每项分析至少 4 个 session,对照与实验条件交替。covert 期间的残余运动用 3 台 24 fps 红外摄像机加 Lucas-Kanade 光流监控,任何可测运动与光标的相关都低于 ±0.1。decoder 用 ReFIT Kalman filter:每个 session 开始时猴子观看 3 组各 200 个自动光标运动(速度 8、10、12 cm/s)来标定。神经分析集中在延迟期末 200 ms 的准备期活动,PCA 降维(猴 R 取 4 个 PC、猴 J 取 6 个,捕获 90% 以上方差),核心量化是把准备态投影到"目标质心—反 VMR 目标质心"连线上,得到 0(完全朝向目标)到 1(完全朝向反 VMR 方向)的归一化距离。
主要结果
行为上,covert 到 overt 的迁移是实打实的。在 covert 情境适应 VMR 之后切回无 VMR 的手臂控制,猴子的手臂轨迹一开始系统性地偏向 VMR 的反方向——标准的 after-effect,其初始误差角显著大于"covert 无 VMR 后切 overt"的对照条件。迁移不完全:误差角和 washout 速度都小于 overt 内部的适应迁移。两个细节很有味道:一是 covert 期间适应得越充分,之后无论 covert 还是 overt 的 washout 都越长,而且两情境的数据点落在同一条线上——暗示它们调用的是同一个适应过程;二是 decoder 性能越好(越接近手动控制),迁移越大,这与"表象越鲜明的心理练习效果越好"的人类文献遥相呼应。
神经上,学习迁移伴随准备态的系统变化。刚从 covert VMR 切到 overt 无 VMR 时,8 个目标方向的准备态全部偏向各自的"反 VMR 邻近目标",之后随 washout 逐渐归位,且归一化距离与行为误差角在逐 trial 层面强相关——神经偏移和行为偏移是绑定的。单神经元的 preferred direction 也在学习期间朝 VMR 方向旋转、washout 期间转回。共享性的检验分三层:overt、covert、watch(decoder 训练时的观看情境)三者的准备期协方差子空间互相投影,共享方差比例无显著差异;准备同一目标时 covert 与 overt 的神经状态在全维分布上高度重叠(对角线接近零);最重要的是逐 session 的状态重叠度显著预测该 session 的迁移量。既然初始条件共享,动力学系统是否也共享?运动期的协方差结构在两情境间同样共享,用 covert 数据拟合线性动力学系统、以 overt 初始条件驱动,能高保真预测 overt 的 trial-averaged 轨迹;Churchland 2012 描述的伸手振荡成分在 covert 数据里也存在(以低频为主)。
最后的"预言检验"最有说服力:根据准备态偏移与迁移相关的解释,那么先在 covert 情境练一遍 45° VMR,再做 overt 45° VMR,应该学得更快。事实如此——有隐蔽练习的手臂轨迹明显更直,误差角更小,准备态从更"已适应"的位置起步,更少 trial 就逼近适应渐近线,而且单个 trial 的准备态偏移量预测随后的行为误差。
逐图解读
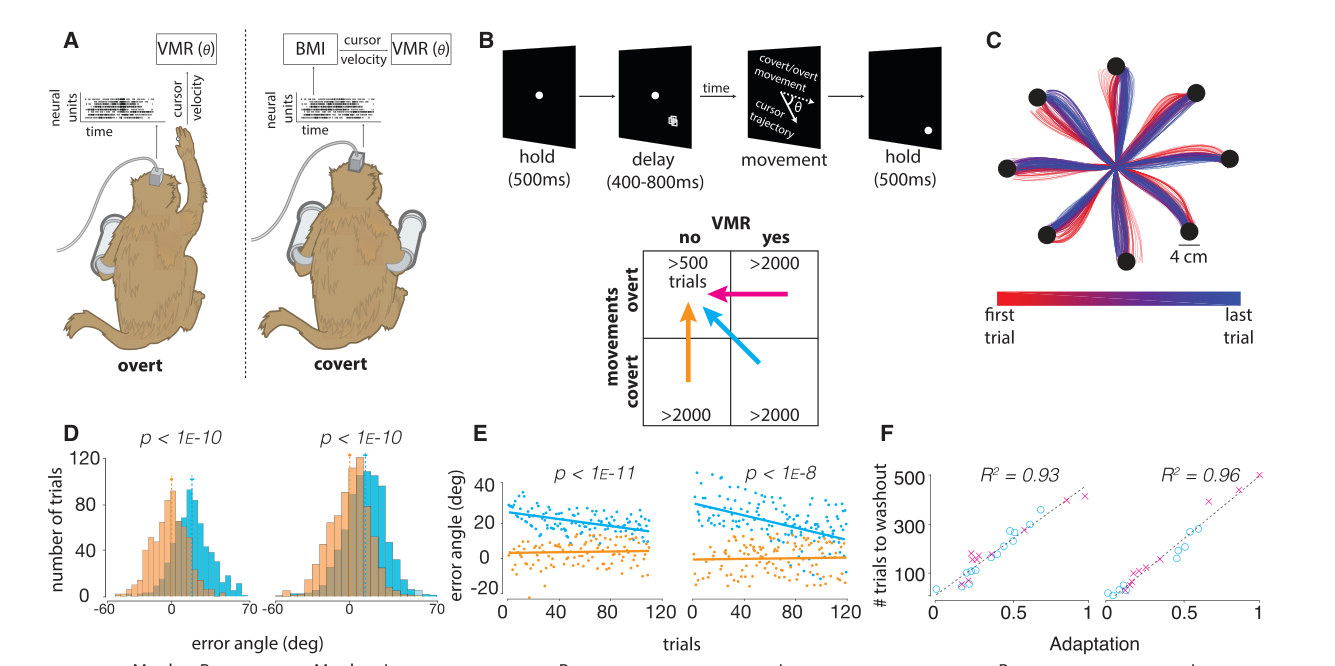
来源:原文 Fig. 1,PDF 第 4 页。
图 1 · covert 学到的适应迁移到了 overt 手臂运动。 (A) 两情境示意:overt 光标随手走,covert 光标由 BMI 神经活动驱动,VMR 使光标偏转 θ 角。(B) 上:instructed-delay 任务流;下:实验流程。(C) covert VMR 适应后切回手臂控制(无 VMR)的原始轨迹:初始轨迹(红)带弧度,朝 VMR 反方向弯——这是 after-effect 的直接可视化。(D) 各 session 前 100 个 trial 的误差角直方图:covert VMR 后的 overt 运动(青)显著偏转,大于 covert 无 VMR 的对照(橙)。(E) 误差角随 trial 数的 washout 曲线。(F) 全文的点睛之笔:washout 所需 trial 数与前一 covert 块的适应程度强相关,且随后做 covert(青)还是 overt(洋红)的 Washout 点落在同一条线上——两种情境像是同一个适应过程的两个出口。
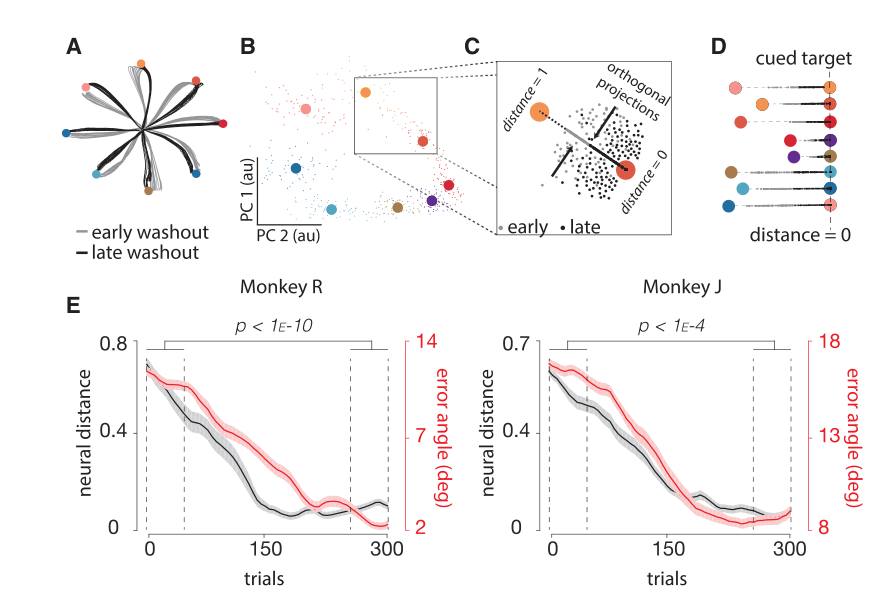
来源:原文 Fig. 2,PDF 第 5 页。
图 2 · 适应写进了群体准备活动。 (A) 手臂轨迹按 washout 前 25%(灰)与后 25%(黑)分组,可见从偏转到回正。(B) 无 VMR 基线 overt trial 延迟期末 200 ms 活动的 top-2 PC 投影:8 个目标各成一簇(三 trial 平均,大圆为质心),构成参照坐标系。(C) 对单个目标条件的放大:把切换后的准备态正交投影到"目标质心—反 VMR 目标质心"连线上,投影距离 0 为完全对准目标、1 为完全偏向反 VMR 方向。(D) 八个条件全部对齐后汇总:刚切换时准备态显著偏向反 VMR 目标。(E) 归一化神经距离随 trial 数衰减(与红色误差角曲线同步),插图比较前 25% 与后 25% 的 trial,差异显著(Wilcoxon)。这张图建立了"准备态偏移=适应的神经残留"这一核心度量,后面所有机制分析都建立在它上面。
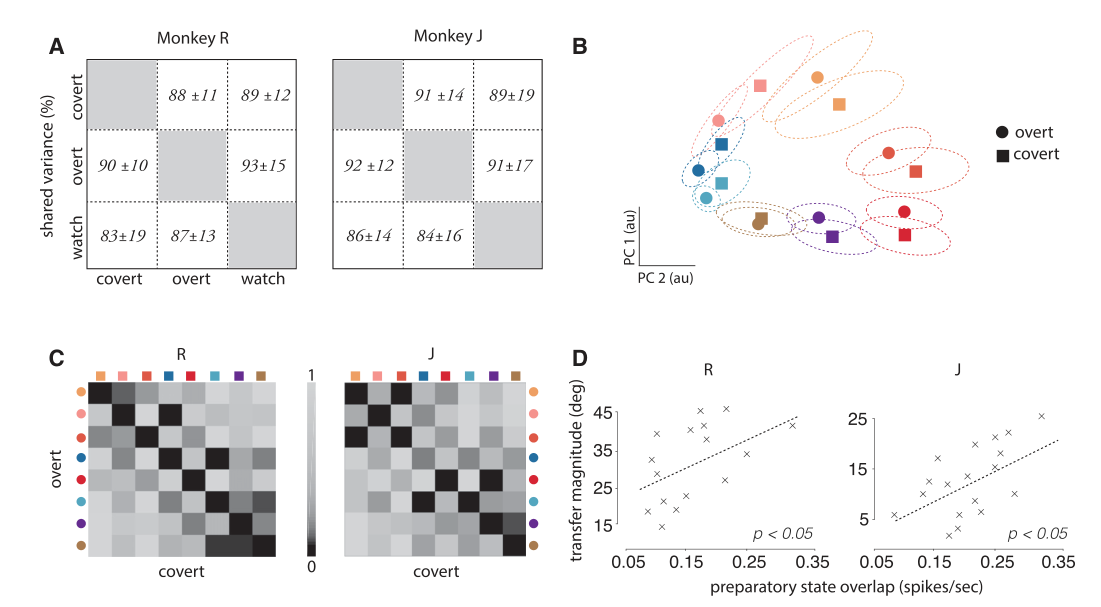
来源:原文 Fig. 3,PDF 第 6 页。
图 3 · covert、overt 与 watch 共享准备态子空间。 (A) 三个情境两两投影计算共享方差(子空间取 4 个 PC(猴 R)或 6 个(猴 J),捕获 90% 以上方差),三者的共享程度无统计差异——没有哪个情境独占一块地盘。(B) overt(圆)与 covert(方)各目标的平均准备态在 2 个 PC 平面上按颜色配对贴合,虚线椭圆为 SEM。(C) 全维空间里准备同一目标的 covert 与 overt 神经分布的统计重叠(原文归一化的 Bhattacharyya 重叠指标:0表示完全重叠,1表示不重叠),对角线接近零,即同目标跨情境比不同目标同情境更像。(D) 迁移的定量预测:一个 session 里 covert-overt 准备态重叠度越大(单位 spikes/s),切换后前 5 个 trial 的误差角越大(即迁移越强),F 检验显著。这张图是机制主张的核心证据:准备态相似程度与迁移相联系,但尚未被直接干预验证。
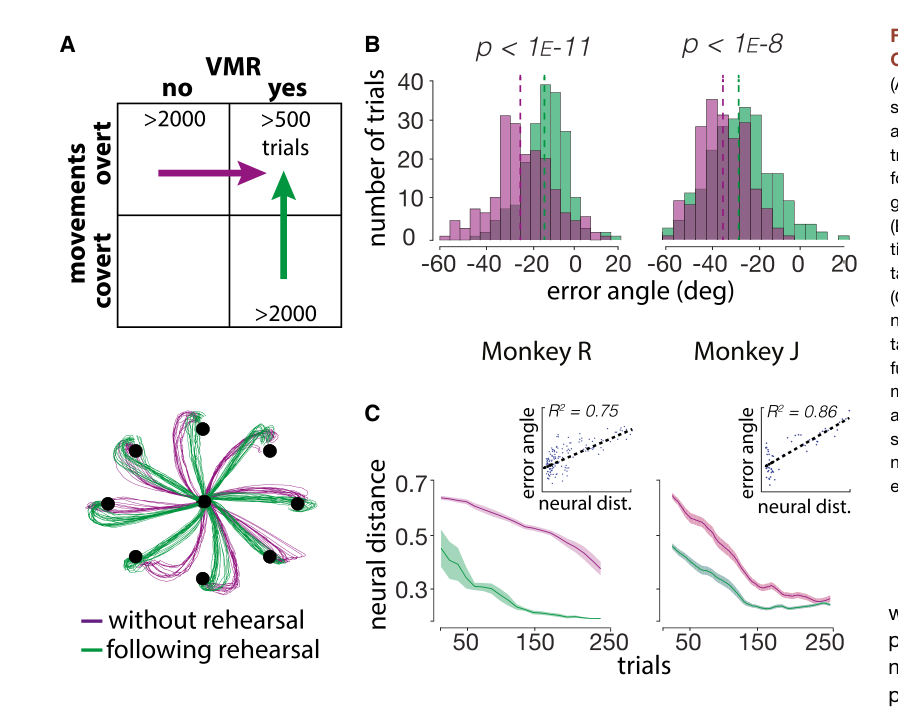
来源:原文 Fig. 4,PDF 第 7 页。
图 4 · 隐蔽练习可以预训练真实运动。 (A) 上:实验流程;下:紫轨迹是无预习直接做 45° VMR 手臂运动,绿轨迹是先在 covert 情境练过同样 45° VMR 再做手臂运动——明显更直。(B) 两种条件的误差角直方图,绿色显著更小(t 检验)。(C) 归一化准备态距离随 trial 数的轨迹:有隐蔽练习(绿)从更低(更接近适应渐近线)的位置出发,更快收敛;插图显示单 trial 的准备态偏移与行为误差角显著相关(p<0.05)。这张图把前三个图建立的机制反过来用:如果迁移靠准备态共享,那就应该能用 covert 练习去"预装"overt 学习——结果立住了。
讨论与解读边界
BCI 提供了可观察、带反馈的隐蔽练习条件。先前练习既产生切换后的后效应,也改善同旋转下的手臂适应;这些行为结果与准备态变化相互支持。视频监测降低了明显手臂运动参与的可能,但不是肌电层面排除所有残余运动。
准备状态相似和线性动力学跨情境预测支持共享表征,尚不能单独证明同一回路机制,也不能将主动闭环 BCI 等同于没有外部反馈的运动想象。该实验没有选择性操纵准备态来检验其必要性。对康复或VR训练的启示是设计跨情境可共享的状态和反馈,但疗效仍需独立验证。
思考问题
- 在匹配反馈和任务难度后,主动 BCI、被动观察和纯运动想象的迁移是否不同?
- 如果改变解码器使准备态与手动条件的相似性降低,迁移量会随之下降吗?