C08 · Cortical preparatory activity indexes learned motor memories
Sun, X., O'Shea, D.J., Golub, M.D., Trautmann, E.M., Vyas, S., Ryu, S.I., & Shenoy, K.V. (2022). Nature, 602, 274–279. doi:10.1038/s41586-021-04329-x
力场学习伴随两类准备态变化:力预测子空间内的调整随行为改变,另有近正交的一致平移在洗脱后仍保持。平移方向可区分所学力场,并与再学习速度相关。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
准备活动可以与即将产生的力相关,也可能保留训练情境的信息。本文尝试区分这两类变化,并检验后者与记忆保持和再学习的关系。
研究思路
作者先在基线中定义力预测子空间,再分析力场学习中的方向相关改变与整体平移。不同力场、不同训练方向、洗脱和再学习用于检验平移的几何与行为意义;相对力预测子空间正交不等于对所有输出均无作用。
方法
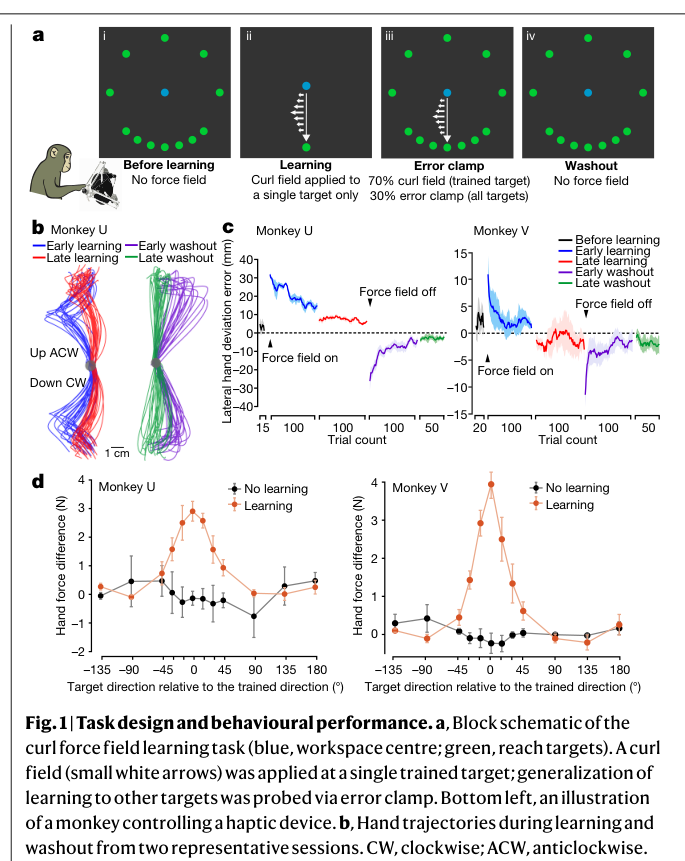
两只成年雄性恒河猴(U,8 岁 14 kg;V,8 岁 10 kg),instructed-delay 伸手任务,通过力反馈手柄控制光标够 12 个目标(训练目标附近排布更密,以便采样泛化)。每 session 依次为:学习前无场直线伸手;学习块——只对一个训练目标施加 curl force field(垂直于运动方向、正比于手速);学习晚期按 70% 场 trial(训练目标)+30% error clamp trial(全部目标)交错,error clamp 把运动锁成直线、误差反馈归零,用以测量前馈学习在各个方向的泛化;最后 washout 块撤掉场和 clamp。记录手段在同类工作里算联合记录:PMd 与 M1,猴 U 用三片 Utah array,猴 V 用 V-probe 与 Neuropixels 探针,另配 6 条上肢肌肉的 EMG 用于检查共收缩等可能混淆;Neuropixels 数据用 Kilosort 加人工校验做 spike sorting。神经分析集中在 go cue 前后 −50 到 +50 ms 的准备期。行为泛化用 error clamp trial 里垂直于伸手方向的手力差度量;神经泛化用力预测子空间里准备态的旋转角度量;repertoire 改变量直接沿用 Golub 2018(C05)的 KNN 距离指标;uniform-shift 轴定义为学习前后全目标准备态质心的连线(扣掉子空间内的微小分量)。对照包括无场控制 session、以及幅值相当但不允许学习的随机脉冲力扰动 session。
主要结果
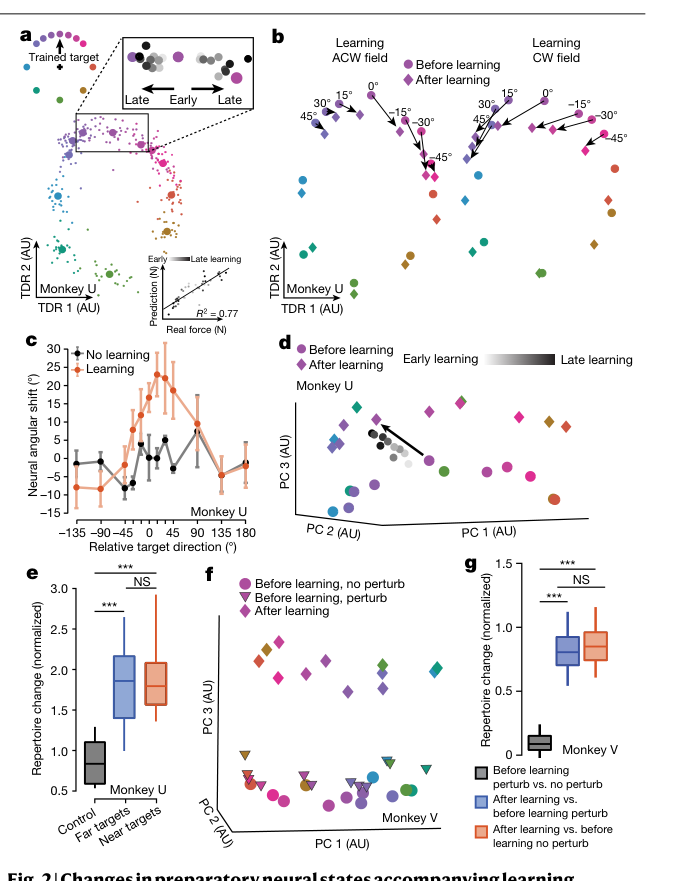
行为层面先复现经典:学习期间侧向偏差逐渐减小,washout 出现反向 after-effect,泛化呈以训练目标为中心的钟形(且向"顶场"方向略偏),与人类文献一致。神经上第一层结果干净利落:力预测子空间里,学习前 12 个目标的准备态按伸手方向呈放射状排布,学习期间训练目标的准备态逐渐转向反场方向的邻近目标(两个 inset 分别展示 ACW 与 CW 场的例子),且子空间内的准备态能高保真预测初始手力(例示 R²=0.77);学习后邻近未训练目标的准备态同样旋转,旋转角随目标角距的衰减曲线与行为泛化曲线同形。这一层与 VMR 里的 re-aiming、C05 的 reassociation 一脉相承——输出要变的部分靠既有模式的重新配对解决。
第二层是这篇文章的独有发现:沿第三个主成分(与力预测子空间正交),所有目标的准备态在学习后一致平移——包括运动学未见明显改变的目标。一串对照说明这个 所测速度、肌电、姿势、error clamp、调谐和背景变化不足以简单解释 uniform shift:随机脉冲力扰动(有力、无学习)不产生平移,无场控制也不产生;用 C05 的 repertoire 指标检验,学习后出现了学习前没用过的新准备态模式,近目标远目标都有,而 VMR 学习(用猴 R、J 做的控制实验)既无 uniform shift 也无 repertoire 改变。也就是说:VMR 这类"重定向"学习靠 reassociation 就够了,curl field 这类"新动力学"学习才会动用新模式——本文两类任务表现出不同模式,但不能据此认定两种策略普遍互斥。
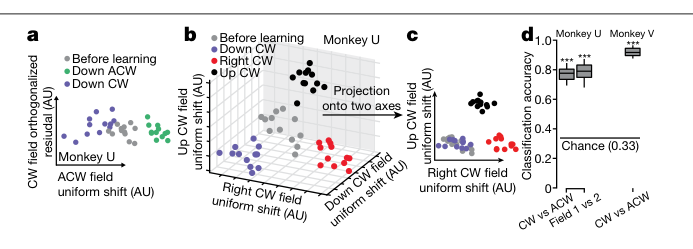
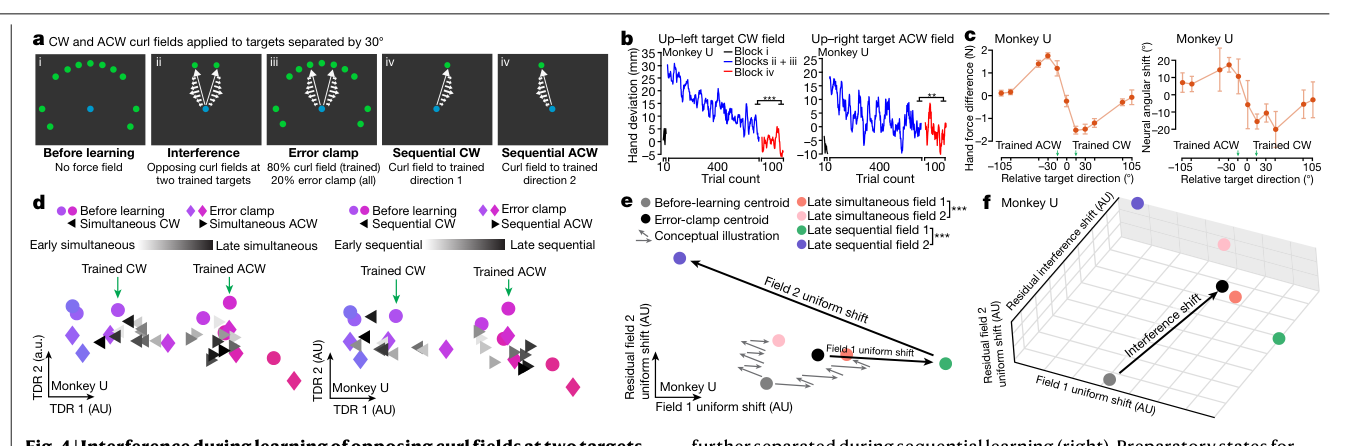
第三层是索引几何。同一目标先后学相反的场,两次 uniform shift 方向几乎反平行(点积约 −0.79 与 −0.64);三个相隔 90° 的目标各学一个场,shift 轴两两近正交;从单 trial 准备态能以远高于随机(0.33)的准确率解码出"学的是哪个场"。干扰实验则把几何和行为勾连起来:两个相距 30° 的目标同时学相反的场(在泛化范围内),行为学得慢——单个场单独学不到 200 trial 就适应,同时学要 400 trial 以上——两场的 shift 轴呈 127°/128° 的钝角,同时学习期间两场准备态的移动互相部分抵消;而同一目标随机交错两个相反场(完全干扰,学不会)时,两场准备态挤在一起不分家,另有一个正交的"干扰残留平移"出现。最后是记忆证据:washout 期间力预测子空间里的旋转角逐 trial 回落(R²=0.29,P=2.96×10⁻¹⁵²),但 uniform shift 保持在原位不回落(P=0.44),washout 还沿另一近正交维度再平移一次;relearning 比初学快(savings),神经轨迹更快逼近学习末状态,relearning 后的准备态与初学末态无法区分;同一场的 shift 轴在相隔 18 天的两个 session 里近于平行;跨 5 个 session,shift 起点越远,行为适应所需 trial 数越少(P=0.017,R²=0.72)。
逐图解读
来源:原文 Fig. 1,PDF 第 2 页。
图 1 · 任务范式与经典的行为学习。 (a) 块设计示意:学习前无场 → 学习块对单一训练目标施加 curl field(白色小箭头)→ 学习晚期 70% 场 trial 加 30% error clamp trial 探测泛化 → washout;左下角是猴子操作力反馈手柄的示意。(b) 两个代表性 session(CW 与 ACW 场)的轨迹:学习早期弯曲、晚期拉直,washout 早期朝反方向弯出 after-effect。(c) 侧向手偏差随 trial 数的学习与 washout 曲线,两只猴各约百个 trial 量级完成一个过程。(d) error clamp trial 与学习前 trial 的垂直手力差对目标角距作图:钟形的局部泛化(橙),对照 session 则平坦(黑),与人类行为研究一致。这张图把"学到了什么、泛化长什么样"的参照系立好了,后面所有神经分析都对着这条钟形曲线对表。
来源:原文 Fig. 2,PDF 第 2 页。
图 2 · 两种准备态变化:子空间内的旋转与全方向的平移。 (a) TDR 力预测子空间里学习前准备态按方向放射排布(小点为单 trial,大圆为条件平均);上插图显示学习期间训练目标的准备态从灰到黑逐渐转向反场方向的邻近目标(ACW、CW 各一例);右下插图显示子空间准备态对初始手力的预测(例示 R²=0.77)。(b) 学习后训练目标(0°)与 45° 以内邻近目标的准备态发生旋转,控制 session 不转。(c) 旋转角对目标角距的曲线——神经泛化与行为泛化同形。(d) 换到主成分空间看:所有目标(包括远处未受影响的)的准备态一致偏离原位,即 uniform shift。(e) 用 C05 的 repertoire 指标量化:学习后近、远目标都出现了新模式,对照 session 无。(f, g) uniform shift 与 repertoire 改变只在真学习中出现,随机力扰动控制(有力无学习)一概没有(***P<0.001,NS)。这张图是全文的枢纽:上半(a–c)讲"与输出绑定的 reassociation",下半(d–g)讲"与输出解耦的新模式",一图分野两个世界。
来源:原文 Fig. 3,PDF 第 3 页。
图 3 · uniform shift 的几何像索引一样排列。 (a) 同一目标先后学两个相反的场:两次 shift 方向相反,轴近反平行。(b) 三个相隔 90° 的目标(上、右、下)各学一个 CW 场:三条 shift 轴近正交,各场的学习后状态在状态空间里占据互不重叠的方位。(c) 把 (b) 的状态投影到两条轴上,分离清晰。(d) 用最小距离解码器从单 trial 准备态分类场的身份(CW vs ACW vs 学习前;场 1 vs 场 2 vs 学习前),两只猴都远高于 1/3 的随机水平(***P<0.001)。这张图论证的是"索引"这个词的字面含义:学过哪个场,可以从准备态反查出来。
来源:原文 Fig. 4,PDF 第 4 页。
图 4 · shift 几何预测干扰。 (a) 干扰实验设计:两个相距 30° 的目标同时各学一个反向场(80% 场 trial + 20% error clamp),再接顺序学习块。(b) 同时学习期间侧向手偏差下降缓慢(蓝),顺序学习后进一步下降(红)——单独学每个场不到 200 trial 就适应,同时学要 400 trial 以上,部分干扰成立。(c) 行为与神经泛化:两场的泛化在中间目标处叠加。(d) 力预测子空间里,两个训练目标(三角)的准备态朝相反方向旋转,顺序学习后分得更开。(e) 两场的 uniform-shift 轴呈 127°(猴 U)/128°(猴 V)钝角,同时学习时各自沿轴前进的分量互相拆台(灰箭头为假想的逐 trial 轨迹)。(f) 同时学习期间还出现一个正交于两场 shift 轴的"干扰残留平移"。这张图把"为什么靠得近的技能会互相干扰"翻译成了状态空间的几何命题:索引方向钝角相交,两场状态变化的几何关系与行为干扰相容,尚未直接测量或操纵学习信号的抵消。
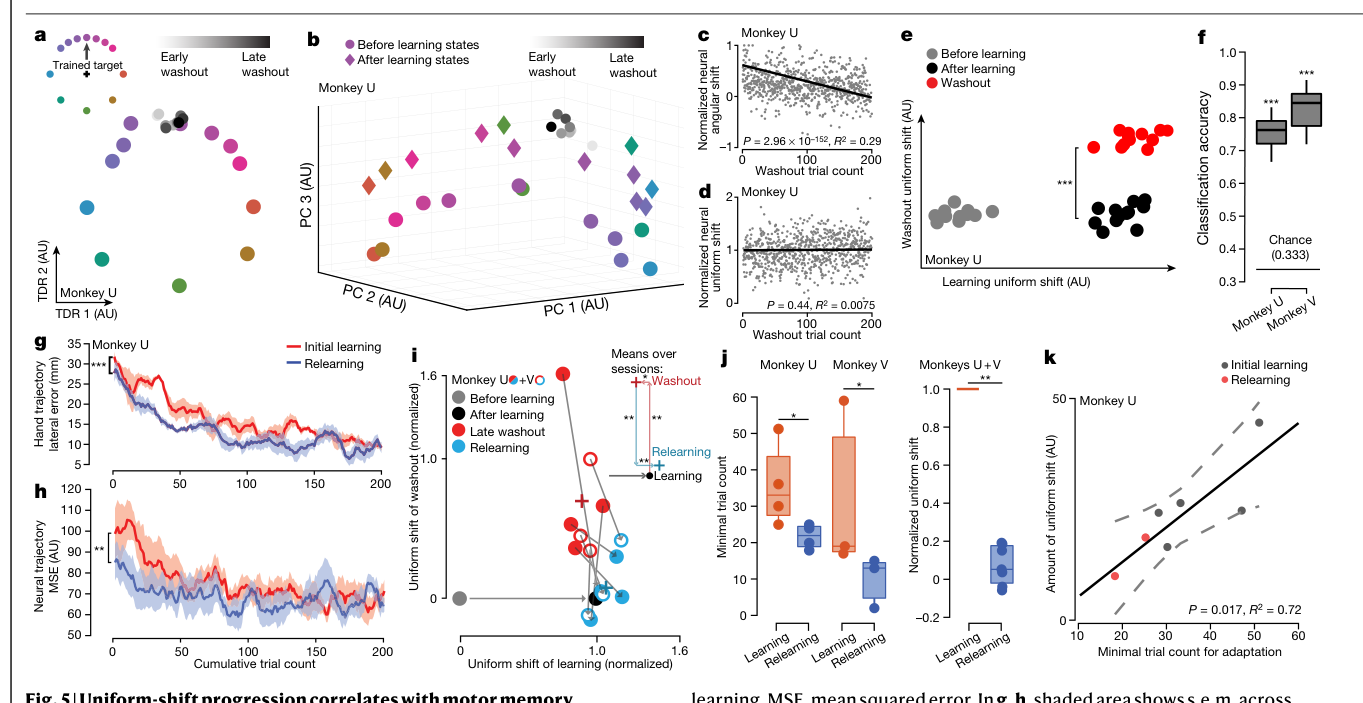
来源:原文 Fig. 5,PDF 第 5 页。
图 5 · washout 不擦除索引,shift 量预测 savings。 (a) 力预测子空间里,训练目标的准备态在 washout 期间逐渐转回学习前位置(例示 session)。(b) 但沿 uniform-shift 轴,washout 后的准备态与学习前仍保持分离(例示 session)。(c, d) 定量:旋转角随 washout trial 显著回落(P=2.96×10⁻¹⁵²,R²=0.29),uniform shift 无回落趋势(P=0.44)。(e) washout 还沿另一条近正交维度发生第二次一致平移。(f) 学习前、学习末、washout 末三种状态可从单 trial 准备态解码区分。(g, h) relearning 行为上更快(g),神经轨迹也更快逼近学习末轨迹(h)。(i) 把各 session 的 washout 末与 relearning 末质心投到归一化的学习轴/washout 轴上:washout 沿 washout 轴显著平移、沿学习轴小幅回退,relearning 时反转。(j) relearning 所需最少 trial 数显著小于初学,沿学习轴的 shift 进程也更短。(k) 全文的定量收口:跨 5 个 session,shift 起始量与行为适应所需 trial 数强相关(P=0.017,R²=0.72)——准备态在索引轴上站得越远,学得越快。
讨论与解读边界
一致平移出现在多个目标方向,包括行为变化较小的方向;它在洗脱后持续存在,并具有力场特异的几何结构。这些观察及对照支持将其解释为运动记忆的候选索引。力预测子空间内的调整与平移是不同的分析成分,不能把所有学习变化统称为重新关联。
“索引”仍是功能解释,研究没有证明沿该轴的活动对存储或提取记忆必不可少。与一个力预测子空间正交,也不等于与全部运动输出无关。跨5次实验的关联需结合样本量理解。VMR 对照来自另一组猴,不能据此给全部运动学学习和动力学学习划定互斥机制。
思考问题
- 在保持初始力预测不变的情况下,干预一致平移方向会改变 savings 吗?
- 同一动物学习匹配难度的视觉旋转和力场后,是否仍出现相同的策略差异?