F01 · Divergent neural representations of space and task between physical and virtual navigation in macaques
Yan, W., Huang, Y., Cao, X., & Mao, D. (2026). Nature Communications, 17, 5365. doi:10.1038/s41467-026-72141-0
两只猕猴在视觉相近的虚拟和真实导航环境中均能学习隐藏目标位置,但HPC和OFC的空间选择性与任务表征存在差异。研究直接提醒我们:行为目标相近,并不能保证两种环境调用相同的神经表征。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
VR提供可控视觉环境,但头部固定和摇杆导航与自由行走的感觉运动条件不同。本文直接比较两种条件下的HPC和OFC空间及任务表征。
研究思路
两只动物在视觉相近的真实和虚拟场景寻找隐藏目标。研究结合行为、多变量编码模型、共同单元追踪和群体几何比较;目标相似并不意味着奖励、身体运动和感觉输入全部匹配。
方法
两只 7 岁雄性恒河猴(D 6.3 kg、P 9.2 kg),VR 49 个 session、RW 69 个 session。VR 端:head-fixed 坐猴椅里摇杆导航,画面投在约 163° 视野的碳纤维穹顶屏(内径 1.0 m、高 1.7 m)上,4K 激光投影,场景在 Unity 2020.3 里建模并以鱼眼变换渲染,四壁挂水果图案当地标,trial 结束 teleport 到新随机起点,奖励是两滴水(约 0.4 mL),每 block 前 10 个 trial 有逐渐淡出的圆柱提示目标,之后目标完全不可见。RW 端:同一尺寸的有机玻璃围栏,猴子自由行走,Vicon 系统用 8 个红外相机追踪头上 3 个反光标记(100 Hz、亚毫米精度、6 自由度头动),背驮式无线双眼眼动仪(60 Hz)加第一视角场景相机(30 Hz),奖励是 0.66 kcal 食丸,进目标区后还要走到四块触摸屏之一领取(多出一个 RW 特有的 pre-reward 阶段);目标区半径 200 mm(VR 为 200-250 mm),在离墙至少 500 mm 的中央区域随机放置,每次迁移距上一目标至少 600 mm。每个 session 前用 NIMH MonkeyLogic 的随机注视任务做眼动标定(就是 E06 那套软件)。记录硬件是重头戏:CT 加 MRI 个体化设计的植入体(钛头板、PEEK 头环、碳纤维头帽),分三次手术植入;电极为定制微驱 tetrode 阵列——沿海马长轴 4 个阵列(各 8 个 tetrode),后内侧 OFC 2 个阵列,tetrode 用 17 μm 镍铬丝,shuttle 螺杆每转进给 350 μm,全部位于右半球;信号由 256 通道 SpikeGadgets logger 以 30 kHz 记到 256 GB microSD 卡,电池供电、射频校钟防时钟漂移,电极每次推进约 40-180 μm 后隔天记录。锋电位经 SpykingCircus 自动分拣加 Phy 人工校正:全程稳定且波形干净的算 single unit(共 1033 个),±3 ms 不应期受污染的算 multiunit(共 1340 个)。分析主力是 LNP 模型:20 ms 分箱、结构化 5 折交叉验证、增量式特征选择,以交叉验证的对数似然衡量各变量解释力;空间信息含量用 Skaggs 公式(10×10 箱、剔除停留不足 2 s 的箱);泛化分析用 population vector correlation(搜索期 40 箱、1000 次循环移位 shuffle)和 8 条件的表征距离矩阵加 MDS。
主要结果
行为层面两种环境都成立:猴子学一个新目标位置大约要 7-9 个 trial,位置占据密度显著聚集在隐藏目标周围(目标近旁对远处的占据时间,VR p=6.5×10⁻³²,RW p=6.0×10⁻³⁰),gaze 占据集中在房间地标上——两边都用了以视觉为主的 allocentric 策略,这减少了完全未学会任务的解释,但不构成严格的行为等效性证明。细节有分化:RW 里接近目标时头部转动更多、看地标的时间更长;VR 里每个 session 完成的 block 更多(3.7±0.3 对 2.5±0.1)。
神经表征的主结果很干脆:RW 中 HPC 和 OFC 的空间信息含量都显著高于 VR(OFC p=1.8×10⁻⁷,HPC p=3.5×10⁻⁴),且增量集中在 allocentric 变量上——两只猴、两个脑区的 allocentric 编码神经元比例全部大涨,最夸张的是 monkey D 的 OFC,从 9.8% 涨到 34.8%。spatial view 在两种环境里都是主导变量,但以 SV 为最强解释变量的神经元比例在 RW 从 7.7% 升到 13.6%。更有信息量的是混合编码的相反走向:从 VR 到 RW,OFC 的多变量混合编码比例从 69.6% 降到 49.4%,HPC 却从 59.1% 升到 68.5%;纯 allocentric、纯 egocentric、混合三类的构成在 VR 里两脑区本无差异(p=0.39),到 RW 里分道扬镳(p=0.0013)。所以 VR 不是简单地"表征变弱",而是编码策略系统性偏向 egocentric。
个体神经元层面的结果更激进。跨越两种环境记录到的 248 个 common single unit 里,只有约 10% 在两种环境都保持空间选择性,超过 30% 只在 RW 有选择性,只在 VR 有选择性的不到 10%;HPC 的平均放电率在 RW 升高 1.09±0.31 Hz(OFC 不动)。同一批 tetrode、同一天前后两个 session,波形还是那个波形,编码的东西却几乎换了一茬——知道一个神经元在 VR 里的反应,几乎预测不了它在 RW 里的行为。作为对照,同一物理环境里换任务(自由觅食对空间记忆),HPC 的整体空间信息含量并没有差异(p=0.62),反衬出环境切换的效应有多大。
任务表征的结果同样反直觉。trial progression(trial 内归一化的时间进程)这种本该与感觉模态无关的抽象变量,在 RW 里跨 block 泛化得很好,population vector correlation 沿对角线连成显著亮带;在 VR 里泛化明显更差,跨两种环境则几乎不相关。用 RDM 和 MDS 看任务相位(搜索对奖励)的表征几何:相位之间的表征距离大于 block 之间(OFC、HPC 均 p=0.02),也大于环境之间(OFC p=0.0002,HPC p=0.0004);MDS 里 VR 和 RW 两团点云几乎正交。OFC 里始终存在能把相位或 block 切开的超平面而 HPC 没有;把 VR 数据投进 RW 的主成分空间,OFC 沿 PC3 分离(p=1.4×10⁻²³)、前两个主成分上与 RW 重叠,HPC 则在 PC1 上就分开(p=0.0001)——两个区域对环境切换的敏感方式也不一样。RW 中还有更多 OFC 神经元把峰值活动放在奖励来临之前,与奖励预期一致,但并非特异性证明。
逐图解读
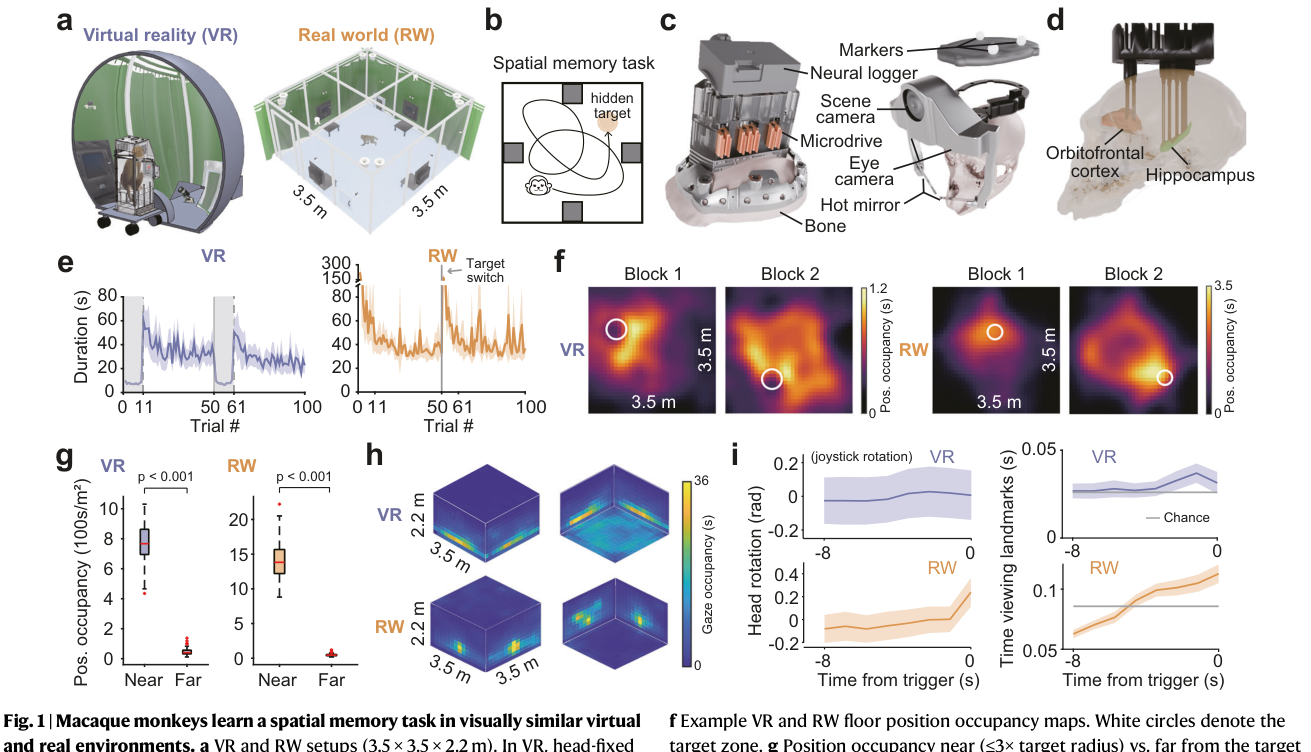
来源:原文 Fig. 1,PDF 第 2 页。
图 1 · 两套环境与空间学习行为。 (a) VR(head-fixed、摇杆、穹顶屏)和 RW(自由活动、开放场地)两套装置对照,场地同为 3.5×3.5×2.2 m。(b) 空间记忆任务示意:随机起点、隐藏目标、闭环位置追踪触发奖励,VR 里前 10 个 trial 有渐隐提示。(c, d) 植入系统:个性化定制的头板、头环、微驱加上无线 logger、眼动仪和动作捕捉标记,tetrode 阵列分别指向 OFC(橙)和 HPC(绿)。(e) 学习曲线(平均 trial 时长,n=49 VR、69 RW session),灰带是 VR 的 10-trial 提示期,两种环境都学得动。(f, g) 位置占据图与目标近旁(≤3 倍目标半径)对远处的占据统计——占据密集聚在隐藏目标周围,这是"真学会了"的硬证据。(h) gaze 占据图集中在地标上,视觉 allocentric 策略两边都成立。(i) 接近目标时的头部转动量和看地标的时间,RW 明显更多。这张图的任务是确认两种条件都能完成学习,同时保留行为与感觉差异作为解释因素。
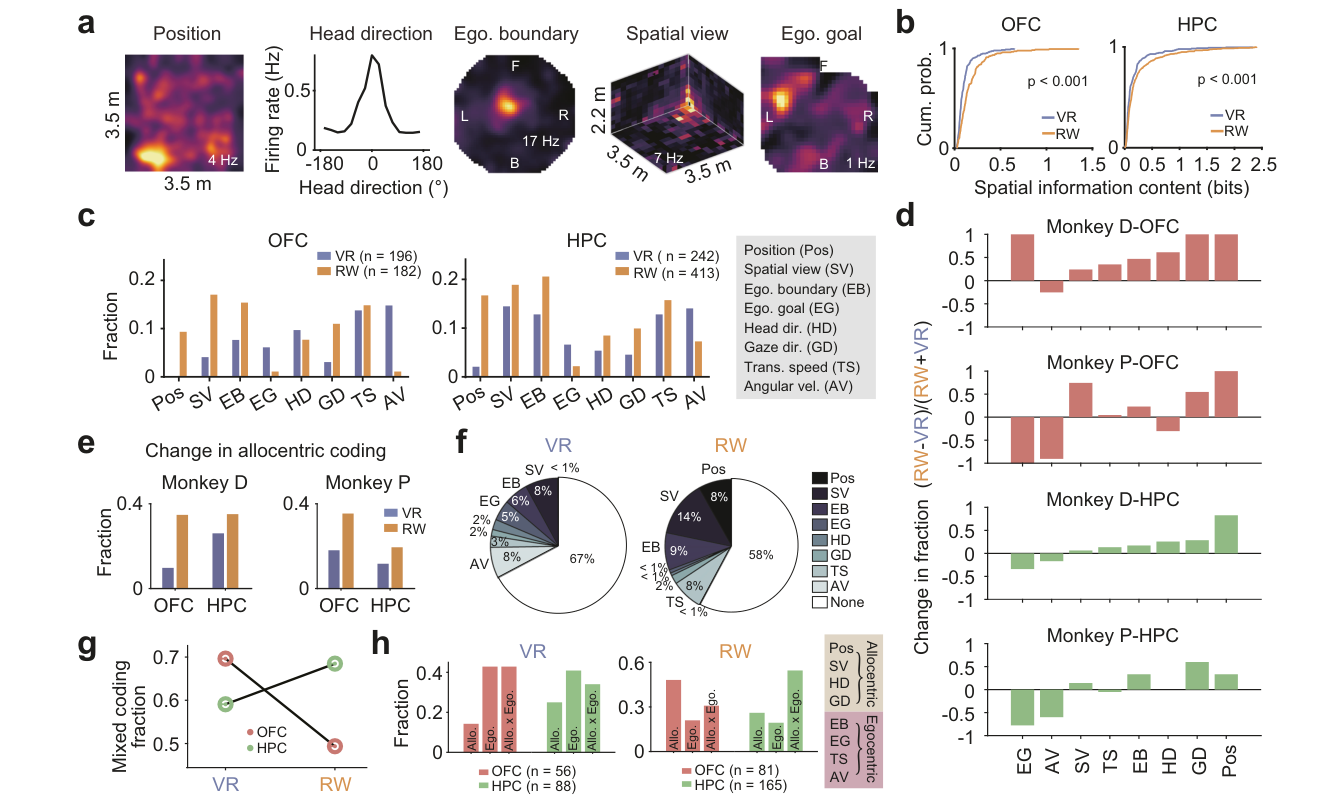
来源:原文 Fig. 2,PDF 第 3 页。
图 2 · VR 中两个脑区的空间表征整体衰减。 (a) 五个示例神经元,分别对 position、head direction、egocentric boundary、spatial view、egocentric goal 有调谐,给出各变量调谐的直观长相。(b) 全部 single unit 空间信息含量的累积分布(OFC 196 VR 对 182 RW,HPC 242 对 413),OFC 和 HPC 都是 RW 整体右移。(c) 各变量编码神经元的比例,VR 与 RW 并排、两只猴分开统计。(d) 从 VR 到 RW 各变量编码比例的变化量,position、SV、GD、EB 一致增强。(e) allocentric 变量合计的编码比例,按脑区和猴拆开——monkey D 的 OFC 从 9.8% 涨到 34.8% 这类数字都在这里。(f) 主导变量饼图:SV 在两种环境都是第一解释变量,RW 占比更高。(g, h) 混合编码的变化:OFC 混合编码减少、HPC 增加。读这张图要抓住"衰减"与"重组"并存——不是所有编码等比例变弱,而是 allocentric 成分选择性塌陷、egocentric 相对保留,这正是作者主张"编码策略偏移"而非"整体变弱"的依据。
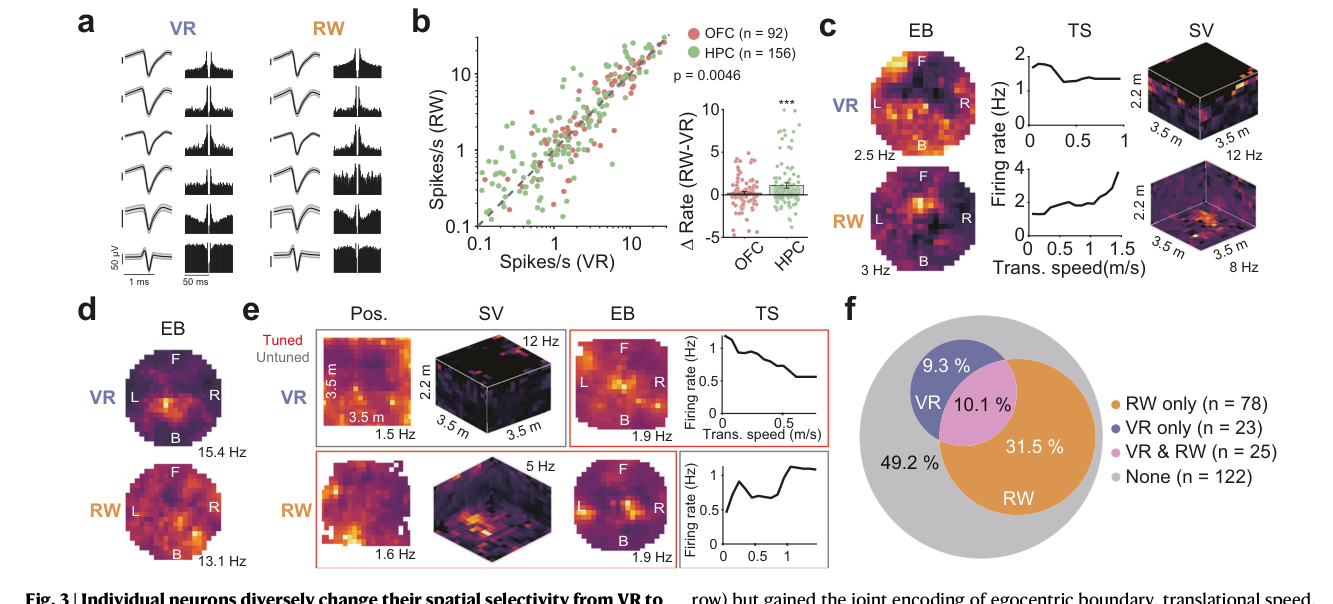
来源:原文 Fig. 3,PDF 第 4 页。
图 3 · 个体神经元在两种环境间的剧变。 (a) 跨环境 common neuron 的鉴定:同一天先后 VR 和 RW session,平均波形(mean±SD)和自相关图对得上的才算同一个单元。(b) 248 个 common single unit 的放电率散点(双对数轴):HPC 整体上移(RW−VR 差 1.09±0.31 Hz,p=0.0003),OFC 不动(p=0.15)。(c-e) 三个命运各异的例子:一个在 VR 里毫无空间调谐、到 RW 获得了 boundary+speed+spatial view 的联合编码;一个在 VR 里有清晰的 boundary 编码、到 RW 丢掉了;一个从 boundary+speed 换成了 position+SV+boundary——同一个神经元换个环境就像换了个编码身份。(f) Venn 图收尾:248 个单元里只有 25 个(约 10%)在两种环境都保持空间选择性,78 个(31.5%)只在 RW 选择性,23 个(9.3%)只在 VR。这张图是全文"不可预测"论点的核心证据。
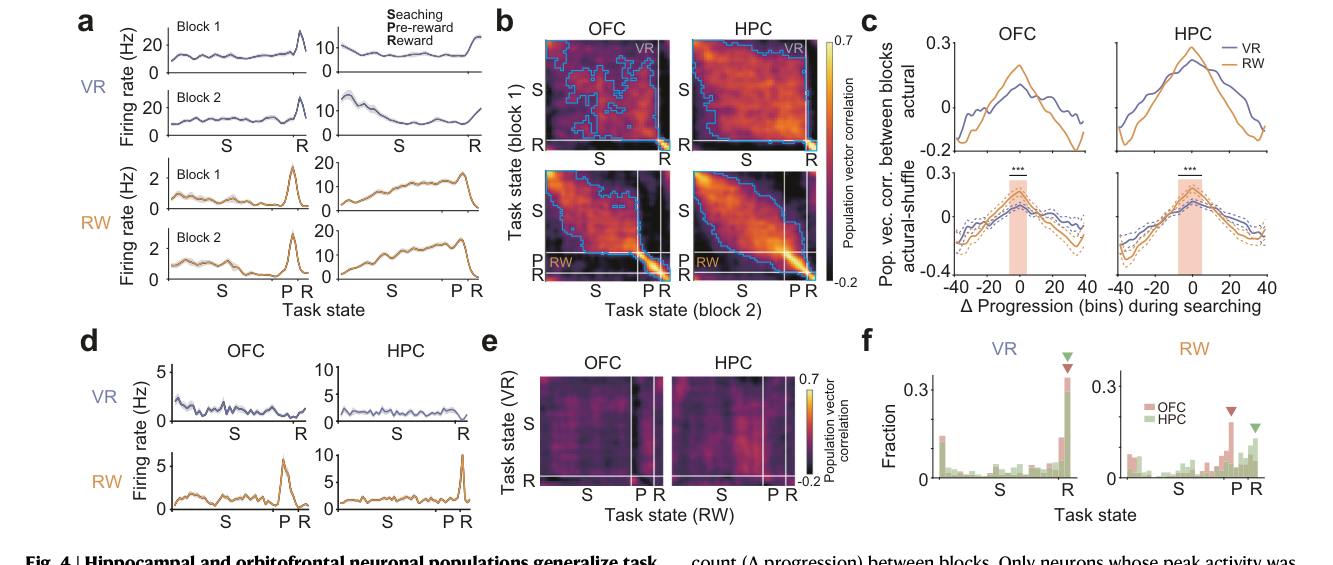
来源:原文 Fig. 4,PDF 第 5 页。
图 4 · trial progression表征在RW中表现出更强的跨目标泛化。 (a) 四个示例神经元随 trial 进程(归一化 0-1)的调谐曲线,跨两个 block 对比,有跨 block 稳定的也有漂移的。(b) population vector correlation 矩阵:block 2 对 block 1 的 progression,四个格子(两脑区×两环境),蓝线圈出显著相关区——RW 的对角亮带明显更连贯,目标换了表征照旧。(c) 把搜索期的 PVC 画成 Δprogression 的函数,上排真实值、下排扣除 shuffle 分布的有效值(mean±95% CI),红色区标出 RW 显著高于 VR 的位置。(d, e) 同一批 common neurons 跨 VR/RW 的示例调谐和 PVC 矩阵——对角线几乎空白,跨环境的 progression 表征基本不相关。(f) 峰值活动落在各 progression 箱的神经元比例,RW 中更多 OFC 神经元把峰值放在奖励来临前。这张图显示任务进程表征的跨环境差异;身体参与是否为必要原因,仍需单独操纵检验。
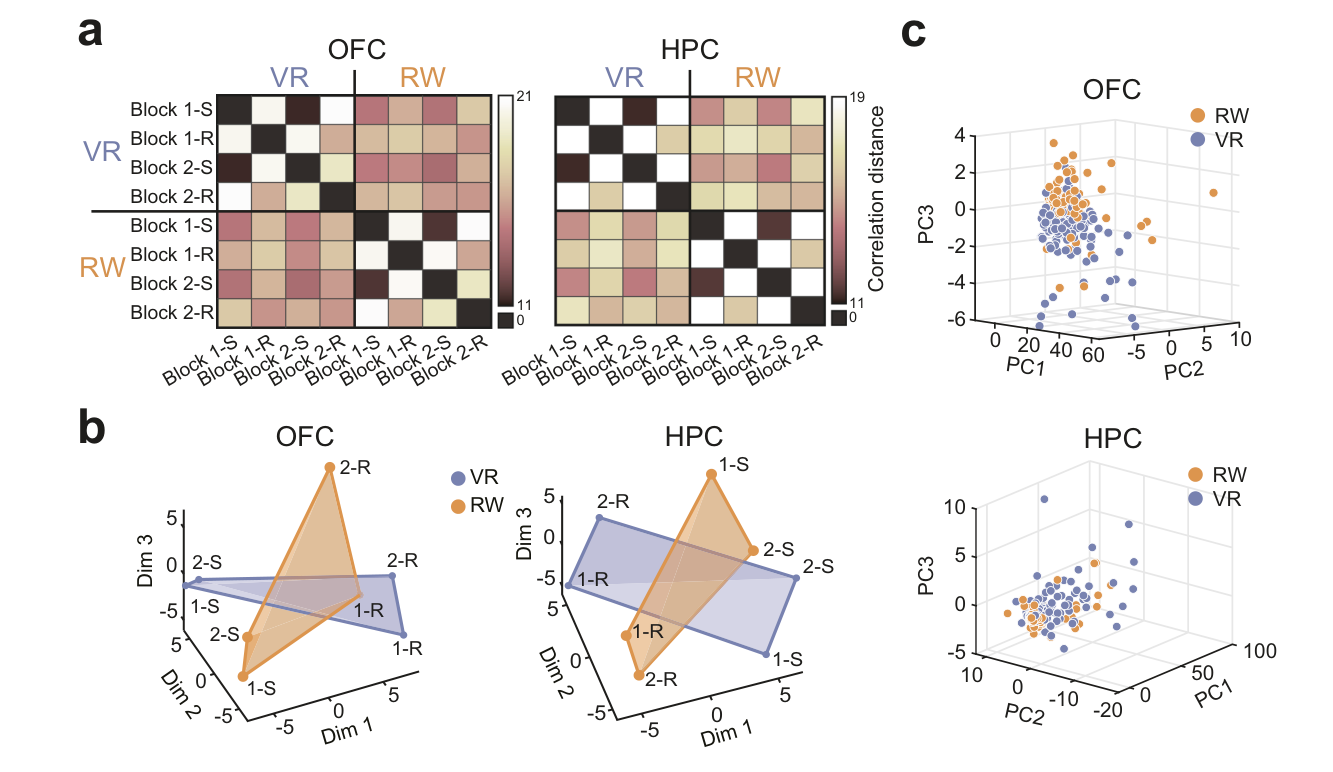
来源:原文 Fig. 5,PDF 第 6 页。
图 5 · 任务相位表征在两个环境间正交。 (a) 8×8 表征不相似度矩阵(两环境×两 block×两相位),核心读法是比三组距离:相位间大于 block 间(OFC、HPC 均 p=0.02),相位间大于环境间(p=0.0002、p=0.0004)。(b) MDS 三维可视化:紫点 VR、橙点 RW,1-S/1-R/2-S/2-R 分别是 block 1 搜索、block 1 奖励等;同一相位跨 block 的点聚在一起,而 VR 和 RW 两团云几乎正交——这里应以原始距离统计为准:任务相位间距离大于环境间距离。OFC 里始终存在可分开相位或 block 的超平面,HPC 里没有。(c) 把 VR 的群体活动投影进 RW 的主成分空间:OFC 沿前两个主成分与 RW 重叠、只在 PC3 上分开,提示编码策略共享但留了一维环境专属;HPC 在 PC1 上就分开,对环境切换更敏感。这张图把"分歧"从单变量层面提升到群体几何层面,是全文论证的收口。
讨论与解读边界
跨环境追踪的共同单元减少了不同细胞采样的解释空间,任务进程和表征几何分析又表明差异不限于单一空间变量。真实环境中更丰富的allocentric编码与更好的跨目标泛化,是本研究的重要观察。
两条件同时改变身体运动、前庭和本体输入、视觉呈现、起点重置、奖励种类及取奖过程。它们并非只操纵“是否VR”,因此不能将差异唯一归因于具身性,更不能外推为所有VR伸手结论无效。MDS是距离的低维展示;图5报告的任务相位间距离大于环境间距离,不能反写为环境区别比任务内容更大。奖励前活动可以与预期有关,尚未排除相应行为阶段的贡献。
思考问题
- 逐一匹配奖励流程、运动速度和起点重置后,哪些跨环境神经差异仍然存在?
- 若在VR中增加与视觉一致的自运动反馈,共同单元的空间选择性和任务进程泛化能否恢复?