B04 · Intracortical brain-computer interface for navigation in virtual reality in macaque monkeys
Saussus, O., De Schrijver, S., Garcia Ramirez, J., Decramer, T., & Janssen, P. (2026). Science Advances, 12, eadw3876. doi:10.1126/sciadv.adw3876
猕猴通过皮层内 BCI 在立体 VR 中完成导航、目标跳变与绕障等任务。解码器在一次在线实验阶段内保持固定,但每次实验仍需被动观察校准,改变任务几何或视角时可重新训练。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
导航要求连续改变行进方向,并应对障碍和目标变化。本文检验观察数据初始化的皮层解码器能否支持立体虚拟场景中的这类控制。
研究思路
作者联合记录运动和前运动区,用被动观察数据训练解码器,再测试固定映射下的导航及目标变动任务。应区分同一控制阶段内不重训,与整个研究永不重新校准;任务几何和视角改变时的方法安排也影响解释。
方法
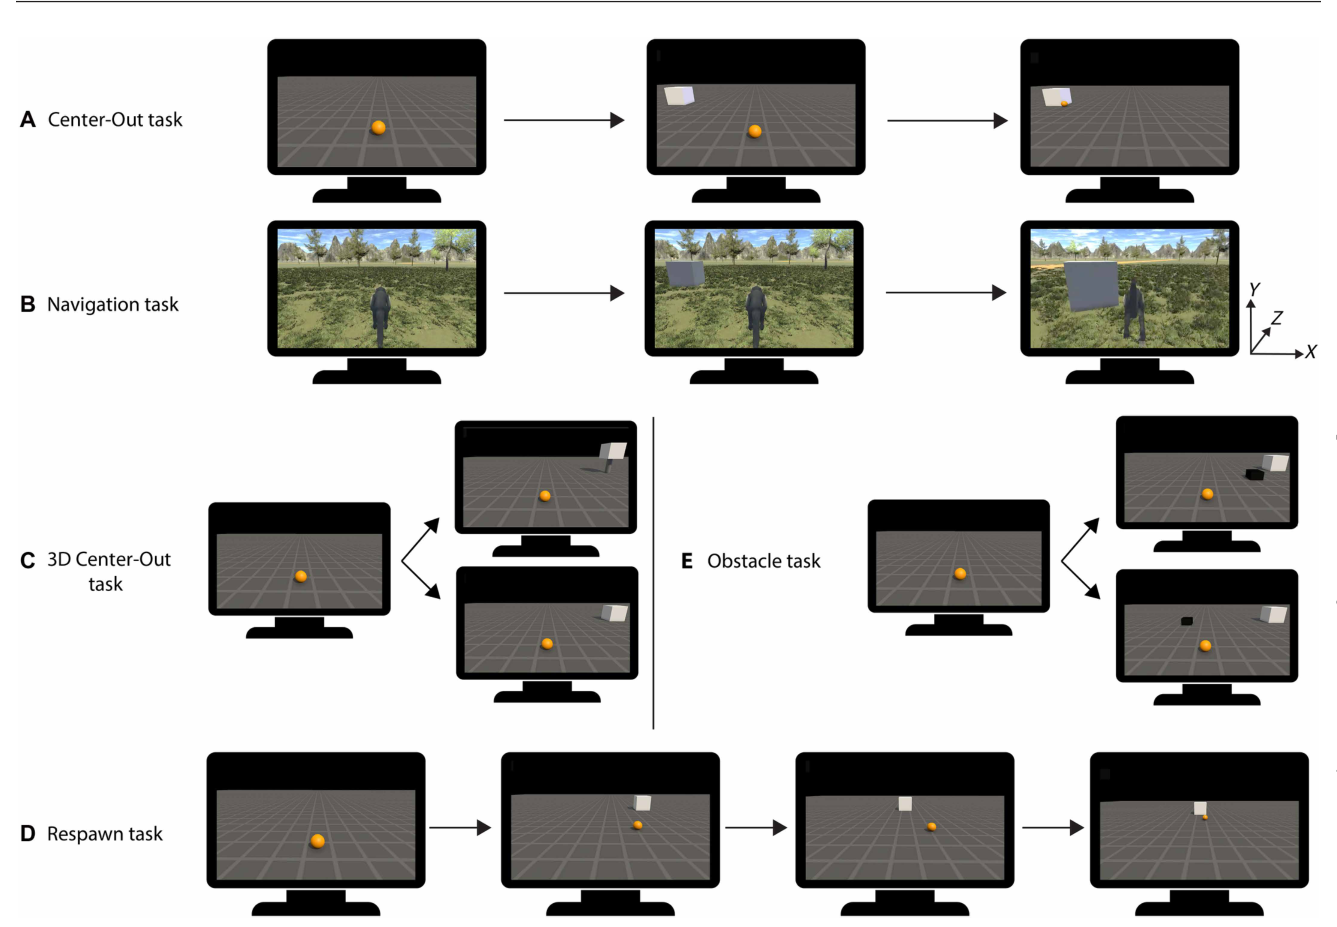
三只雄性恒河猴(7–9 kg),钛合金头柱,三枚 96 通道 Utah 阵列(电极长 1 或 1.5 mm、间距 400 μm)植入 M1 手/臂区、PMd(F2)与 PMv(F5c),3T MRI 验证位置;256 通道 Cerebus 同时记录三区(PMd 有 32 电极一档未接),750 Hz 高通、30 kHz 采样,阈值下多单元、不做 spike sorting。猴子头固定坐椅中、双臂约束,面对 120 Hz 的 3D 屏幕戴液晶快门眼镜(每眼 60 Hz)获得立体视觉,EyeLink 500(500 Hz)监控眼动。任务由 Unity 2021.3 搭建,三台计算机经 ZeroMQ 通信:一台跑 Unity 渲染,一台跑 Python 解码器,一台做中央调度。每个 session 三阶段:Passive Fixation(约 7 分钟,观察三个方向各 30 个 trial,Bézier 曲线驱动、Unity Nav Mesh Agent 自动导航)→ Decoder Training(数秒到 1 分钟)→ Online Decoding(神经活动实时驱动)。解码器是 PSID(Sani 2021)的非线性改造版:50 ms 分箱的多单元活动经 PSID 提取 6 个行为相关潜状态(projection horizon 5),Nystroem-RBF 核近似(700 个采样点)映射到高维空间捕捉非线性,ridge 回归(α=0.1)输出 vx/vy/vz,在线用递归 Kalman 滤波更新潜状态,每 50 ms 把速度发给 Unity。训练在所有有 spike 的通道上进行。五个任务:Center-Out(球体在 xz 平面到达五个靶位,摄像机固定,5.5 s 限时);Continuous Navigation(起点为上一 trial 终点,摄像机动态跟踪,在线阶段换成森林环境里的猴 avatar,五靶位,8 s 限时,avatar 按解码速度旋转并有走/跑动画);3D Center-Out(球体 xyz 三维运动,10 个靶位其中 5 个高架,5.5 s);Respawn(trial 中目标跳换到相邻位置,13 种模式,6.5 s);Obstacle(障碍物随机出现在路径上或路径外,6.5 s)。成功标准为进入靶窗并停留 500 ms,主任务每 session 100 trial、附加任务 120 trial。Chance 水平由一万次 target 标签 permutation 估计。两只猴另录肱二头肌与拇短展肌 sEMG 以检查所测肌肉的活动贡献。
主要结果
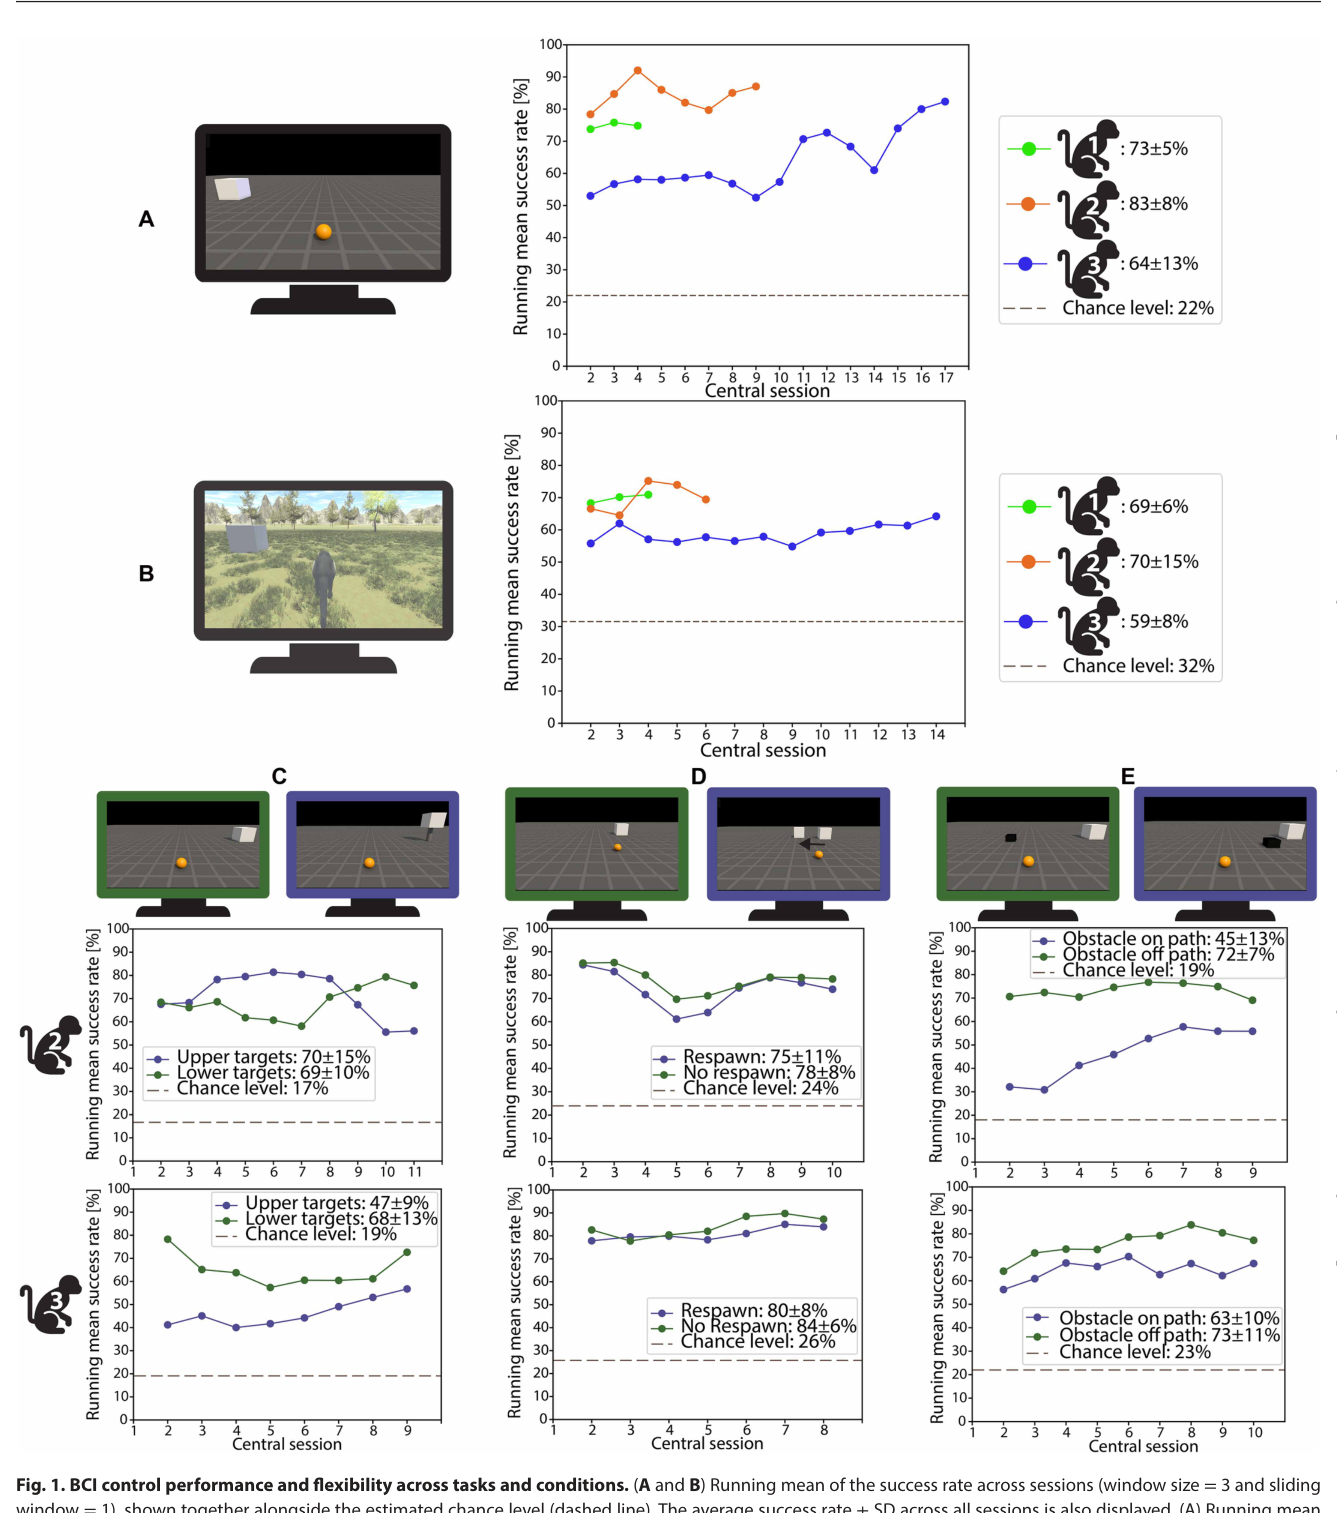
三只猴从记录期一开始就在两个主任务上显著超过 chance(全部 P<0.0001),单个 session 最高冲到 96%。Center-Out 平均成功率猴 1 为 73±5%、猴 2 为 83±8%、猴 3 为 64±13%(chance 20–23%);Continuous Navigation 略低(比 Center-Out 少 4–13% 个成功 trial),摄像机动态跟踪是主要原因。猴 1 和猴 2 参与过实验室先前的 BCI 项目(即 B03 那套范式),一开始就有约 70% 的成绩;naive 的猴 3 分别用了 11 和 14 个 session 追平,Center-Out 呈清晰的学习趋势(β=0.0156, P=0.0022, R²=0.433)。去掉 avatar 的第一人称视角下猴 3 依然有 54±1% 的成功率。
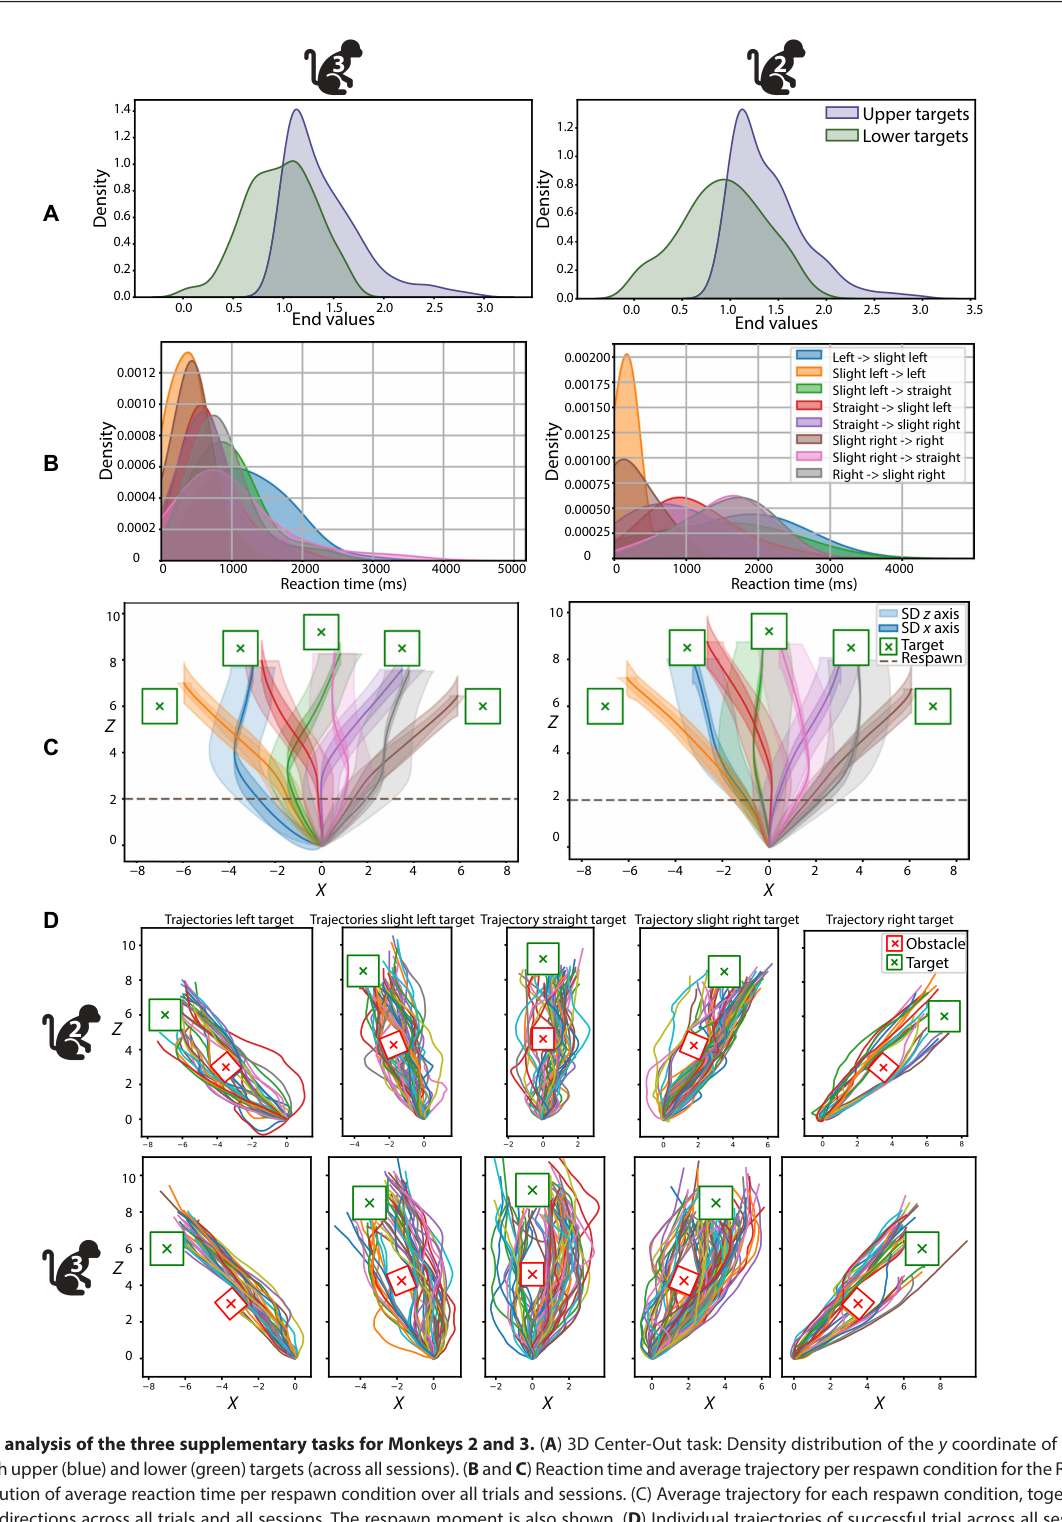
三个附加任务展示了罕见的灵活性。3D Center-Out 里两只猴(69±6% 与约 58%)在没有任何额外行为训练的情况下就掌握了第三维(y)的控制,高低靶的终点 y 坐标分布显著分离(猴 2:P=5.26×10⁻⁶⁰)。Respawn 任务里目标中途跳变后表现仍高于机遇水平;表 1 给出猴 2 的跨实验平均成功率为 76±9%,与无跳变 trial 无显著差异;从目标跳变到轨迹转向的平均反应时间猴 2 为 661 ms、猴 3 为 1058 ms——这是闭环在线修正能力的直接度量。Obstacle 任务最难:猴 2 起初 on-path 只有 36%(off-path 66%),训练后期升到 55%;猴 3 达到 63%(off-path 73%)。轨迹分析还揭示了个体策略差异:猴 2 两侧绕行、临近障碍才偏移,猴 3 偏好一侧、出发就大幅绕开。
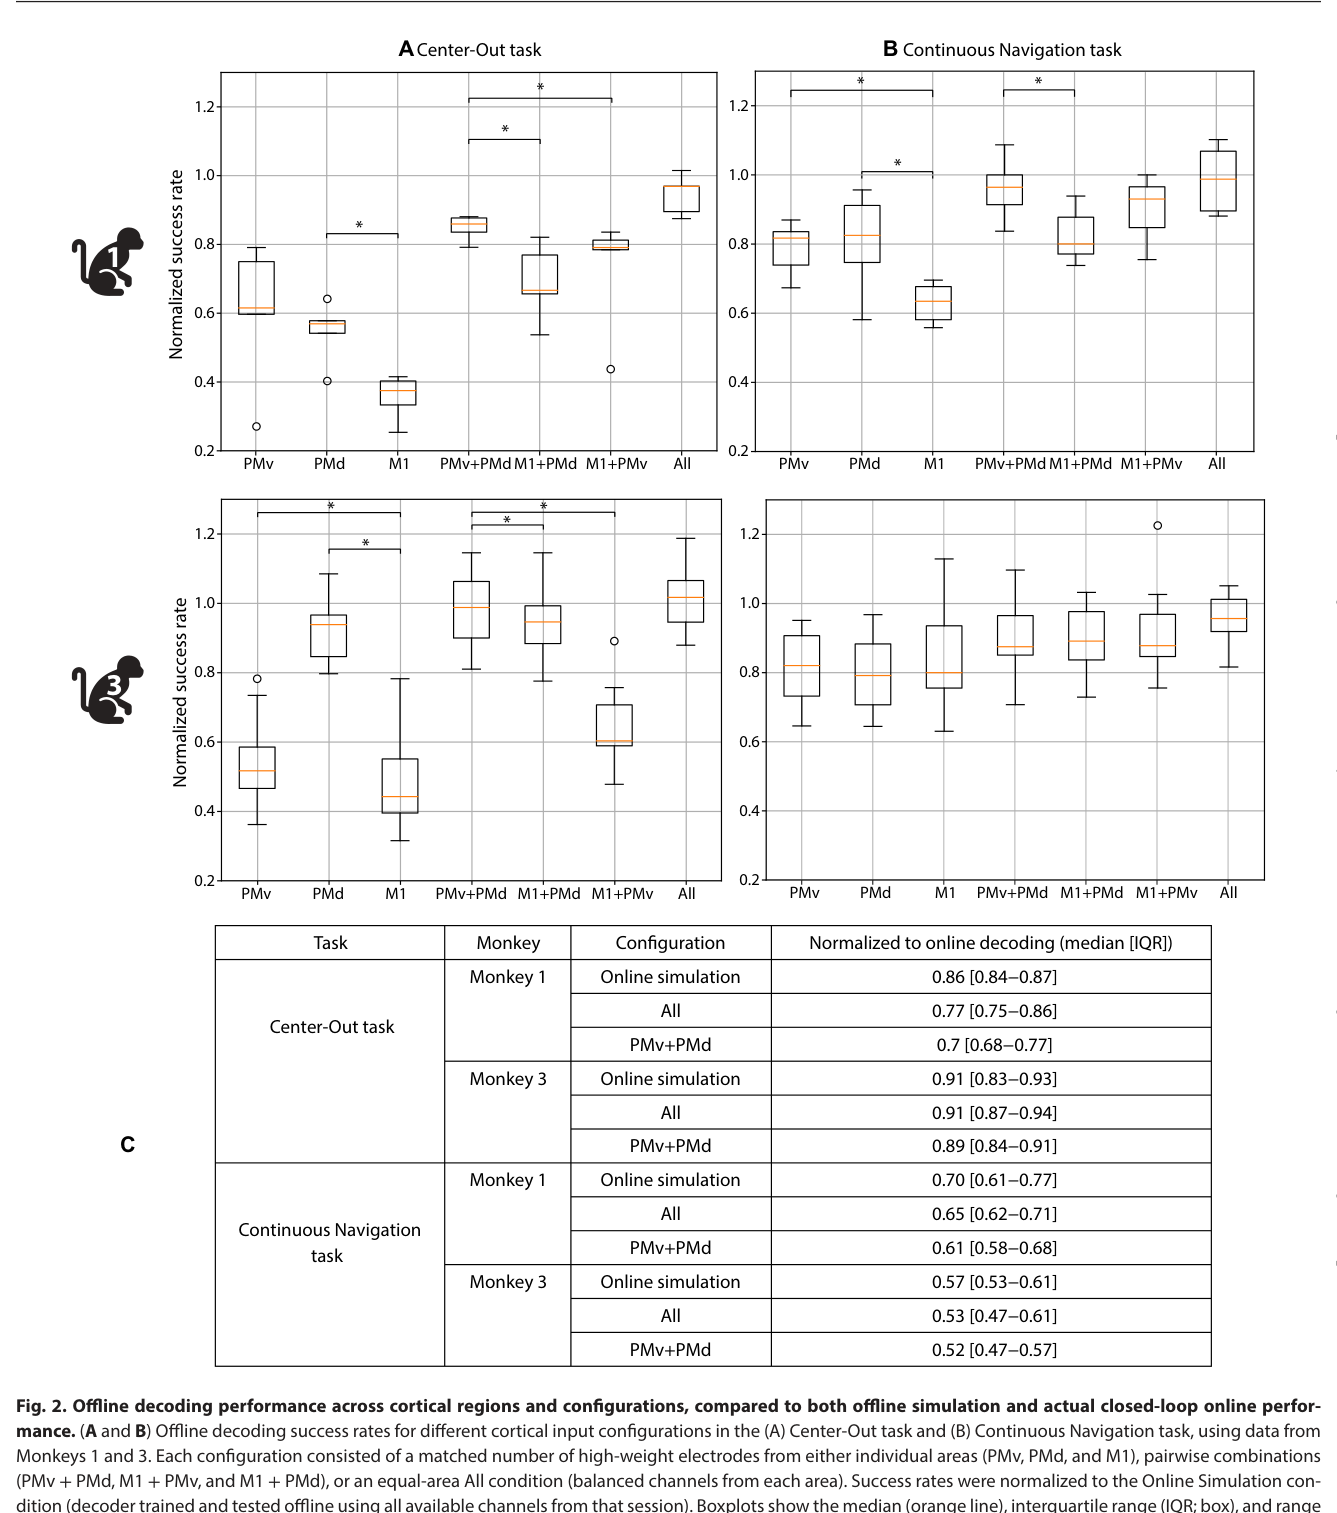
最有分量的分析是离线-在线对比与区域贡献。用匹配数量的高权重通道做离线解码(猴 1 和 3),PMv 和 PMd 一致优于 M1,PMv+PMd 是最强组合,在 Center-Out 中与三区 All 条件及全通道离线模拟统计不可区分——premotor 信号之间存在协同,在该通道选择和离线指标下,加入 M1 未显示明确的额外增益。解码器权重分布同向:猴 1 为 60% PMv、21% PMd、19% M1;猴 3 为 42% PMd、39% M1、19% PMv。而所有离线条件(包括用同一解码器同一分箱数据的"在线模拟")都系统性低于真实闭环成绩——归一化到在线成绩后,在线模拟只有 0.86–0.91(Center-Out)和 0.57–0.70(Continuous Navigation)。作者的解释有两个:闭环里 50–100 ms 的可变视觉延迟使离线的理想化 50 ms 重放失真;更重要的是猴子确实在适配真实的闭环系统——在线-离线差距最大的猴 1 恰好 session 内进步的比例最高(53.4%)。控制分析显示 sEMG 与解码速度的相关仅在 −0.20 到 0.13 之间、R² 近零,眼动除"眼睛跟随受控目标"带来的 eye-x 与 vx 相关外也无实质贡献,且连续导航任务的解码是世界坐标系而非眼睛坐标系,减弱了这些已测变量解释控制结果的可能性,但不能排除全部运动或眼动相关因素。
逐图解读
来源:原文 Fig. 1,PDF 第 3 页。
图 1 · 五个任务的成功率与灵活性。 (A, B) 两个主任务的跨 session 成功率滑动均值(窗口 3):Center-Out(A)与 Continuous Navigation(B),虚线为 permutation 估计的 chance,附全程平均±SD——三只猴全程悬在 chance 之上,猴 3 的上升斜坡在 A 里清晰可见,就是那只 naive 猴的学习曲线。(C–E) 逐条件拆解灵活性:(C) 3D Center-Out 高靶(蓝)与低靶(绿)分别的成功率,猴 2 两种靶几乎一样好(69 与 70),第三维的控制不是靠偏科;(D) Respawn 任务有跳变(蓝)与无跳变(绿)的对比,两组几乎重合——未检出两类试次成功率的显著差异,不能据此证明代价为零;(E) Obstacle 任务 on-path(蓝)与 off-path(绿),差距存在但随训练收窄。读这组图的方法是把五个面板连起来看:它们共同回答"这套 BCI 是只会做练习题,还是真会临场应变"。
来源:原文 Fig. 2,PDF 第 5 页。
图 2 · 区域贡献与离线-在线差距。 (A, B) Center-Out(A)与 Continuous Navigation(B)的离线解码成功率,猴 1、猴 3,七种通道配置(单区 PMv/PMd/M1、成对组合、均衡三区 All)按高权重通道数匹配后比较,归一化到全通道离线模拟,箱线图加显著性星号。绿色 PMv 与蓝色 PMd 系统性高于红色 M1,PMv+PMd 组合在成对配置里最高、在 Center-Out 中追平 All——在该离线比较中,前运动区组合具有较好的解码表现,这是全文主要的神经科学结论。(C) 归一化到真实在线成绩的汇总表:所有离线配置的中位数都低于 1(如猴 1 的 Continuous Navigation 在线模拟仅 0.70),同样的解码器、同样的数据,只在理想重放里跑就掉分——闭环本身(视觉延迟加实时适应)是性能的一部分,离线重放永远测不出完整的能力。
来源:原文 Fig. 3,PDF 第 6 页。
图 3 · 附加任务的轨迹分析。 (A) 3D Center-Out 终点 y 坐标的密度分布,高靶(蓝)与低靶(绿)在两只猴里都干净地分开(猴 2 的 P 值到了 10⁻⁶⁰ 量级)——第三维控制是真的,不是靠平面内的运气。(B) Respawn 任务每种跳变条件下反应时间的密度分布(左→偏左、直行→偏右等八种),平均 661 ms(猴 2)到 1058 ms(猴 3);(C) 每种条件的平均轨迹加 x、z 方向 SD,跳变时刻标出——轨迹在跳变点后果断弯折,SD 也随之重新收束。(D) Obstacle 任务 on-path 成功 trial 的全部单条轨迹按靶位分列,障碍(红方块)与靶(绿方块)标出:猴 2 双侧绕行、临近才偏,猴 3 固定一侧、出发即绕——两种策略都能完成任务,说明绕障不是解码器偶然输出的副产品,而是有计划的在线路径修正。
来源:原文 Fig. 4,PDF 第 9 页。
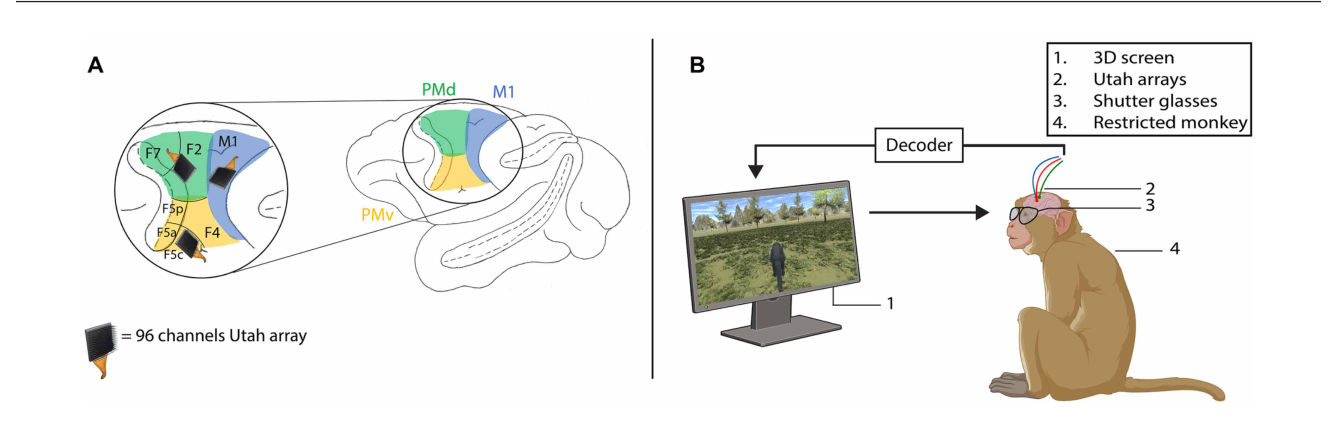
图 4 · 植入与实验装置。 (A) 三枚 Utah 阵列的植入位点:PMd、PMv、M1,同一半球同时记录。(B) 闭环 BCI 的实验现场:头固定、双臂约束的猴子坐在 3D 屏幕前,戴与屏幕同步的快门眼镜获得深度知觉。这张图值得细看的不是示意图本身,而是它交代的设计约束——双臂全程约束加 sEMG 记录,表明任务不要求明显的手臂运动,但不能将健康猴的约束条件等同于完全瘫痪;快门眼镜给出的真实双眼视差,提供了双眼深度线索,但跨研究比较尚不能直接检验 B03 中表现差异的原因。实验室多年用同一套立体视觉装置做 3D 形状分类研究,猴子的立体视功能是有保证的。
来源:原文 Fig. 5,PDF 第 10 页。
图 5 · 五个任务的时序与结构。 (A, B) 两个主任务:Center-Out 的时序(A)与 Continuous Navigation 在 xyz 空间中的示意(B),后者起点接续上一 trial 终点、摄像机动态跟随。(C–E) 三个附加任务的结构:3D Center-Out 的高靶与低靶(C,高靶立在高出平面的细圆柱上)、Respawn 的目标中途跳变时序(D)、Obstacle 的 on-path 与 off-path 两种情形(E)。读这张图时注意一个贯穿性的细节:Obstacle 与 Respawn 可沿用 Center-Out 校准;3D 等几何变化的校准需按 Methods 区分——障碍、跳变、三维运动在训练相里从未出现过,在线阶段的全部应对都得靠固定解码器加猴子自己。这正是"generalization"主张的实验基础。
讨论与解读边界
本文展示的是短时校准后、相关任务家族内的灵活闭环控制。Center-Out、Obstacle 与 Respawn 可共享固定解码器;Continuous Navigation 和三维任务的校准还涉及相应几何或视角。Methods 明确允许这些条件变化时训练新解码器,因此不能写成“一个解码器从此适用于所有任务且永久无需校准”。
脑区贡献主要来自离线通道组合比较;猴 2 的可用信号仅来自 M1,不能说三只猴都使用三区联合活动。前运动区组合表现良好,不等于 M1 在导航中没有独立贡献。离线与在线的差距与闭环适应、显示延迟等因素相容,但无法单独证明其中哪种机制占主导。健康动物的手臂约束也不等于完全瘫痪,更不替代真实轮椅环境的验证。
思考问题
- 固定解码器跨日连续使用时,信号漂移会怎样影响泛化,需要多频繁的重新校准?
- 在相同通道数下做在线区域消融,PMv/PMd 的优势是否与离线比较一致?