B05 · Assistive algorithms influence neural representations in motor brain-computer interfaces
Rajeswaran, P., Payeur, A., Lajoie, G., & Orsborn, A.L. (2026). Nature Communications, 17, 9832. doi:10.1038/s41467-026-76109-y
自适应解码器数据中,学习相关的任务信息集中到较少的读出单元及低方差群体模式。匹配的网络模拟支持解码器适应可促成这种集中,但猴数据的跨研究比较并非随机对照。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
辅助算法会改变BCI中的误差和神经活动到输出的映射,因此也可能改变动物学到的表征。性能提高本身不能说明信息在群体中如何重新分布。
研究思路
研究分析固定与适应性解码范式的数据,用单元加入曲线和主成分分析比较任务信息的集中程度。随后在RNN中操纵解码器适应,检验一种可能的形成机制;跨动物实验比较和模型内操纵的证据强度不同。
方法
核心数据来自两只恒河猴(J 和 S,Orsborn 2014 的原数据),128 通道微丝阵列植入运动皮层和前运动皮层手臂区;monkey J 用通道级 threshold crossing、monkey S 用 spike-sorted multi-unit,统称 units。按记录稳定性(而非功能性质)选出一部分 unit 输入 position-velocity Kalman filter 控制 2D 光标,即 readout 群体;其余为 nonreadout。任务为 8 方向 center-out:到达外周目标限时 3–10 s,入靶后保持 250–400 ms 得果汁奖励。分析聚焦长度至少 4 天的 learning series(monkey J 7 个、monkey S 3 个,共 10 个;两只猴分别累计学过 13 和 6 个映射),early/late 定义为每方向至少 25 次成功到达的首日与末日(示例 series 为第 2 天与第 17 天)。CLDA 用 SmoothBatch(J)或 ReFIT(S):day 1 跑 5–15 min 把性能提高到能够到达各方向目标,之后只在成功率跌约 10–20% 或丢失 readout 单元时做 3–5 min 的短暂更新。离线分析用 multiclass logistic regression,从 go-cue 起 1800 ms、100 ms bin 的发放率预测 8 个目标身份,每天每方向取 25 个 trial、做 100 次训练-测试划分。fixed-decoder 对照数据来自 Ganguly & Carmena 2009(monkey P、R,Wiener filter),按 150-trial epoch 分早晚期。模型端是一个 100 单元 ReLU RNN:先在二关节平面手臂模型上学 center-out,再随机选 12 个单元做 readout、拟合速度 Kalman filter,切换 context 进入 BCI 训练;学习用 REINFORCE(奖励取负的任务损失),CLDA 强度 α 取 0.1、0.25、0.5 三档,α=0 即 fixed decoder,每组 10 个种子。
主要结果
Credit assignment 的第一层结论是保守的:离线分类器用全部 unit 预测目标身份的平均准确率为 0.83 ± 0.11(monkey J)和 0.78 ± 0.13(monkey S),且 readout 的准确率在早晚期都显著高于 nonreadout(两者 p = 0.002),但从 early 到 late 只有 readout 显著提升(p = 0.006),nonreadout 无变化(p = 0.13)。稳定 readout 的分类器权重在相邻两天的相关系数从 0.34 ± 0.045 升到 0.64 ± 0.045(p = 0.001,N = 10),与成功率的爬升同步,说明任务编码在逐步稳定。控制分析显示:同样的分析用在手臂运动数据上看不到 readout/nonreadout 的分离,减弱仅由记录质量差异解释的可能性;在单次 CLDA 事件前后比较分类准确率也没有即时变化,支持变化主要随学习逐步形成,未检出单次算法更新对应的即时效应。
第二层是关键结果:compaction。用 NAC 把 unit 按单单元分类准确率排序、逐个累加,取达到归一化峰值 80% 所需的 unit 数 Nc。Adaptive decoder 下,late 的 Nc 一致地小于 early(monkey J 的 ΔNc 在 −4 到 −1 之间、最大 p = 0.018;monkey S 在 −2 到 −1 之间、最大 p = 0.031;跨 10 个 series 汇总 p = 9.8 × 10⁻⁴)。而 fixed decoder 数据恰好相反:两只猴的 Nc 晚期不降(monkey P ΔNc = 0,p = 0.55;monkey R ΔNc = 2,p = 0.8),信息保持分布。组合式 NAC 进一步显示这种集中指向特定的神经元子集:晚期包含全部 top-Nc 单元的组合与不含任何 top 单元的组合之间,用 d′ 量化的性能差距随学习显著拉大(p = 1.9 × 10⁻³),支持准确率增益主要集中在这些高预测性单元。同一批 top 单元也足以离线重建光标速度,且这一效应在手臂运动任务中看不到。
模型在其设定内检验了解码器适应的因果贡献。CLDA 无论强度都能加速早期性能提升,中等强度下最终性能与 fixed 持平或更好(10 个种子里最好情况 9/10 优于 fixed),但过度适应(α = 0.5)反而降低最终性能——因为 CLDA 的目标(朝目标移动)与任务目标(限时到达且末速趋零)在训练后期冲突。关键是模型完整复现了 compaction:fixed decoder 训练到晚期需要 12 个 readout 里的 11 个才能达到 80% 性能,而 adaptive decoder 下 dominant 单元越来越 dominant、少数单元即可支撑控制;提前停掉 CLDA 或拉长适应间隔则既能保住性能又会削弱 compaction。把有无 CLDA 下的循环权重总变化 ΔW 逐一配对比较,决定系数从 α = 0.1 时的 0.27 一路掉到 α = 0.5 时的 0.046——适应越强,可塑性模式离 fixed 条件越远,说明 brain–decoder co-adaptation 走的是一条不同的学习路径。模型还给出一个数据里看不到的细节:adaptive decoder 的组合式性能分布更窄(IQR 更小),意味着它同时压制了不可靠单元的负面影响。
群体层面的结果值得关注。把 NAC 搬到 PC 空间后,adaptive decoder 下达到 80% 分类准确率所需的 PC 数(NPC)随学习下降(跨 series p = 9.7 × 10⁻⁴),fixed decoder 下则未见明显变化。与此同时,方差在 PC 间的分布反而更弥散,用 participation ratio 量度的维度不减反增——这与自然运动学习和 fixed-decoder BCI 中"变异性和 shared dimensionality 随练习收缩"的已知规律正好相反。另一个结果是任务信息的位置:占方差 80–84% 的 top-50% PCs,其晚期分类准确率反而低于只占方差 16–22% 的 bottom-50%(p = 0.001);PC 准确率的变化量与其解释方差之间未检出显著相关。loading 分析显示,解码力最强的 PC 几乎完全由 top 任务预测性单元组成(top-4 与 bottom-4 单元的 loading 平方和差异 p = 0.002),而高方差 PC 的单元构成则像随机混合。这些结果提示,仅按解释方差筛选主成分可能漏掉预测任务的重要维度。
逐图解读
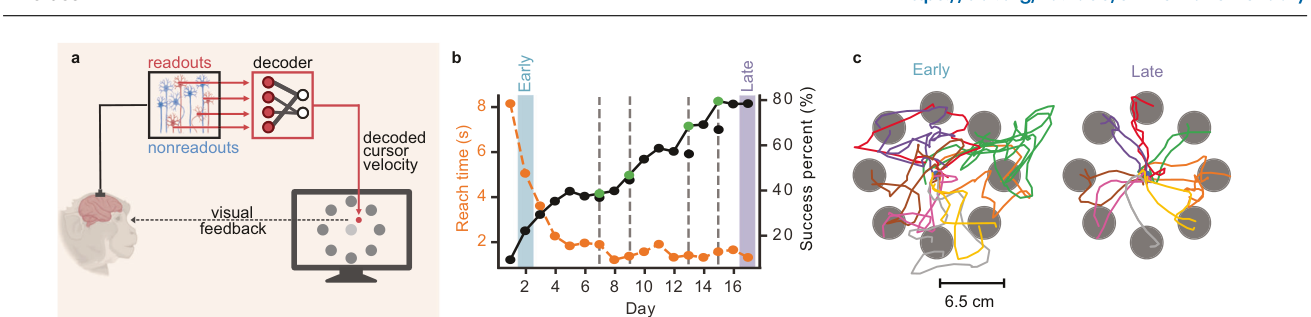
来源:原文 Fig. 1,PDF 第 2 页。
图 1 · 实验设置与示例学习曲线。 (a) 闭环 BCI 示意图:运动皮层记录的 multi-unit 分为 readout(红,进解码器)与 nonreadout(蓝,只记录不控制),仅 readout 活动被 Kalman filter 解码为光标速度,猴子在 2D center-out 任务里靠视觉反馈闭环控制。(b) 一个示例 learning series(monkey J):黑色实线为成功率、橙色虚线为平均 reach time,竖直灰线标记 CLDA 事件、绿点标出算法带来的性能增益;early(第 2 天)与 late(第 17 天)用颜色带标出。(c) 同一 series 的早期(左)与晚期(右)光标轨迹——轨迹随训练变得更直接,显示控制表现改善。这张图先立住一个事实:虽然训练中包含初始化及必要时的短时 CLDA 更新,学习曲线的形态与当年 fixed-decoder 研究报告的定性一致,为后面的表征分析提供了行为学前提。
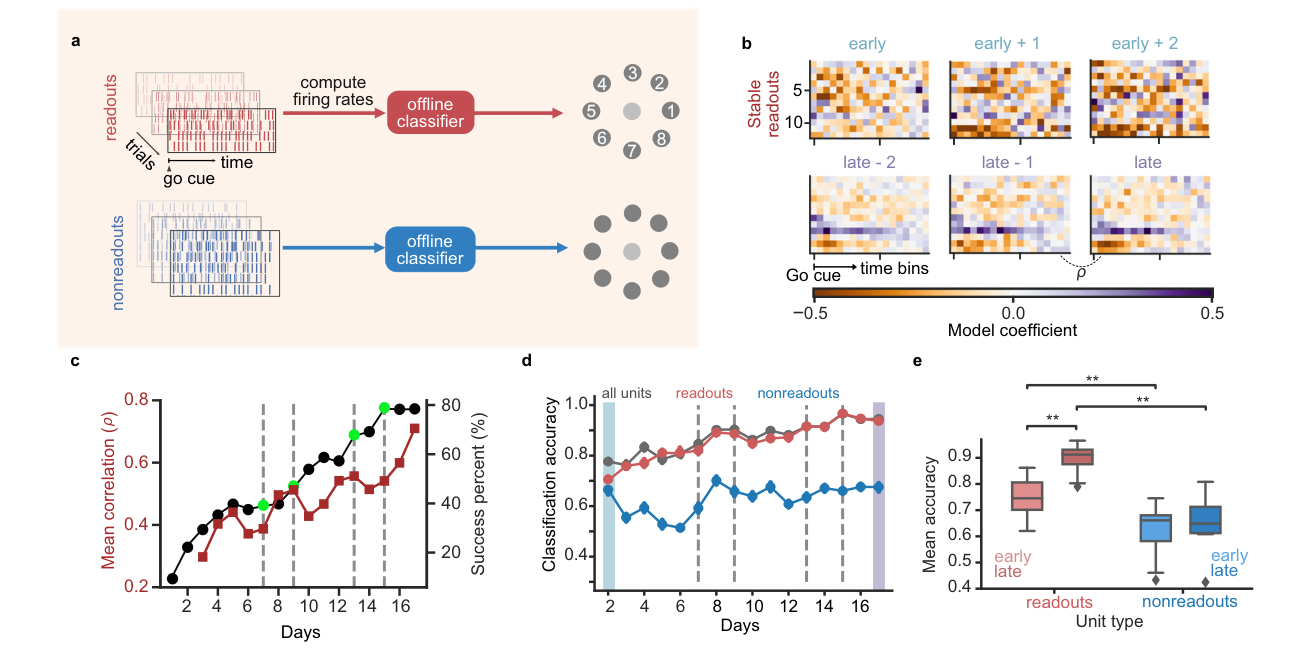
来源:原文 Fig. 2,PDF 第 3 页。
图 2 · Credit assignment 指向 readout 单元。 (a) 离线分析框架:每天用 logistic regression 从 go-cue 后的分箱活动预测 8 个目标身份,readout 与 nonreadout 分开评估。(b) 示例 series 中稳定 readout 群体对单一目标(target 2)的分类器权重热图,逐日对比可见权重模式随天数渐趋相似。(c) 相邻两天权重的平均相关(深红)从 early 的约 0.34 爬到 late 的约 0.64,与成功率曲线(黑,复制自图 1b)平行——编码稳定化与行为改善具有相近的时间过程。(d) 全部 unit(灰)、readout(红)、nonreadout(蓝)的分类准确率逐日演化,readout 全程居上。(e) 10 个 series 的 early/late 箱线图:readout 内部 early→late 显著提升(p = 0.006),nonreadout 无变化(p = 0.13)。这张图论证的是"辅助算法没有取消 credit assignment",同时为图 3 提供后续分析的依据——看 (b) 的最下面几行,权重明显向少数单元集中了。
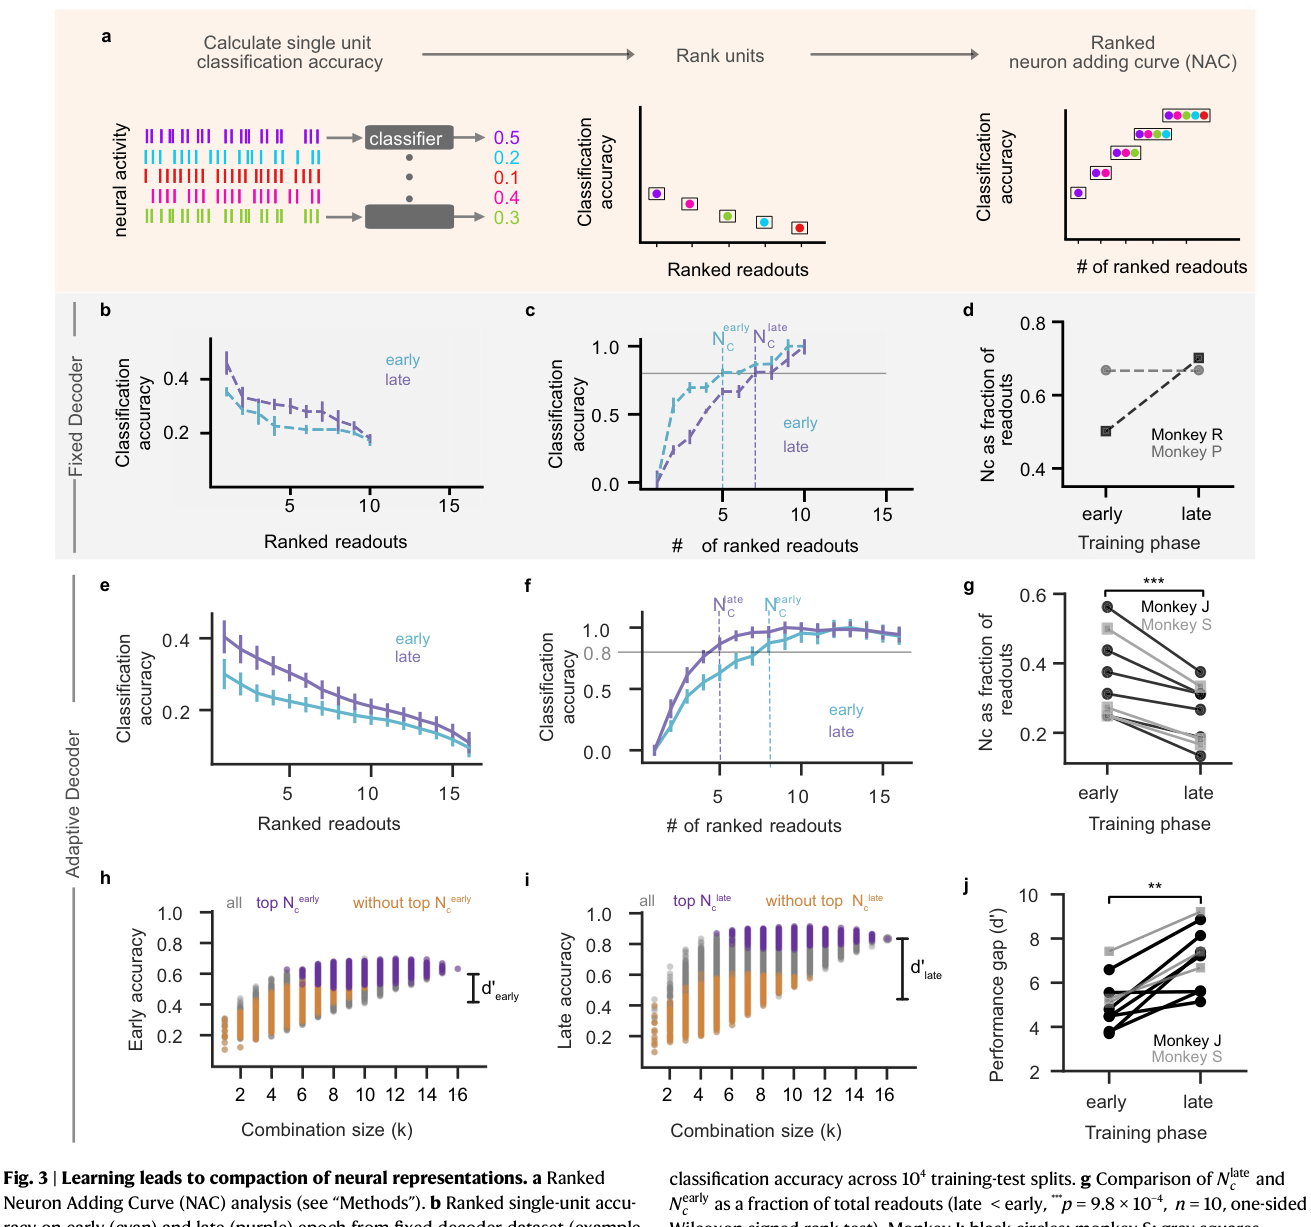
来源:原文 Fig. 3,PDF 第 5 页。
图 3 · 学习导致神经表征的 compaction。 (a) NAC 分析示意:先算每个 unit 的单单元分类准确率,排序后逐个累加。(b–d) fixed decoder 数据(示例为 monkey R):早期(青)与晚期(紫)的排序准确率和归一化 NAC 几乎重合,达到 80% 峰值所需的 Nc 不降反稳(monkey P ΔNc = 0,monkey R ΔNc = 2,均不显著)。(e–g) adaptive decoder 数据(示例 series):Nc 随学习显著缩小,跨 10 个 series 以 readout 总数的比例表示,late < early(p = 9.8 × 10⁻⁴)。(h, i) 组合式 NAC:横轴为组合大小,紫色点为包含全部 top-Nc 单元的组合、橙色为不含任何 top 单元的组合,早期两种组合尚有重叠,晚期紫橙分离。(j) 用 d′ 量化的性能差距在 late 显著大于 early(p = 1.9 × 10⁻³)。这张图是全文的核心证据:fixed decoder 下信息保持分布,adaptive decoder 下学习把任务信息压进了特定的一小撮 readout——而且这撮单元同时也最能离线重建光标速度。
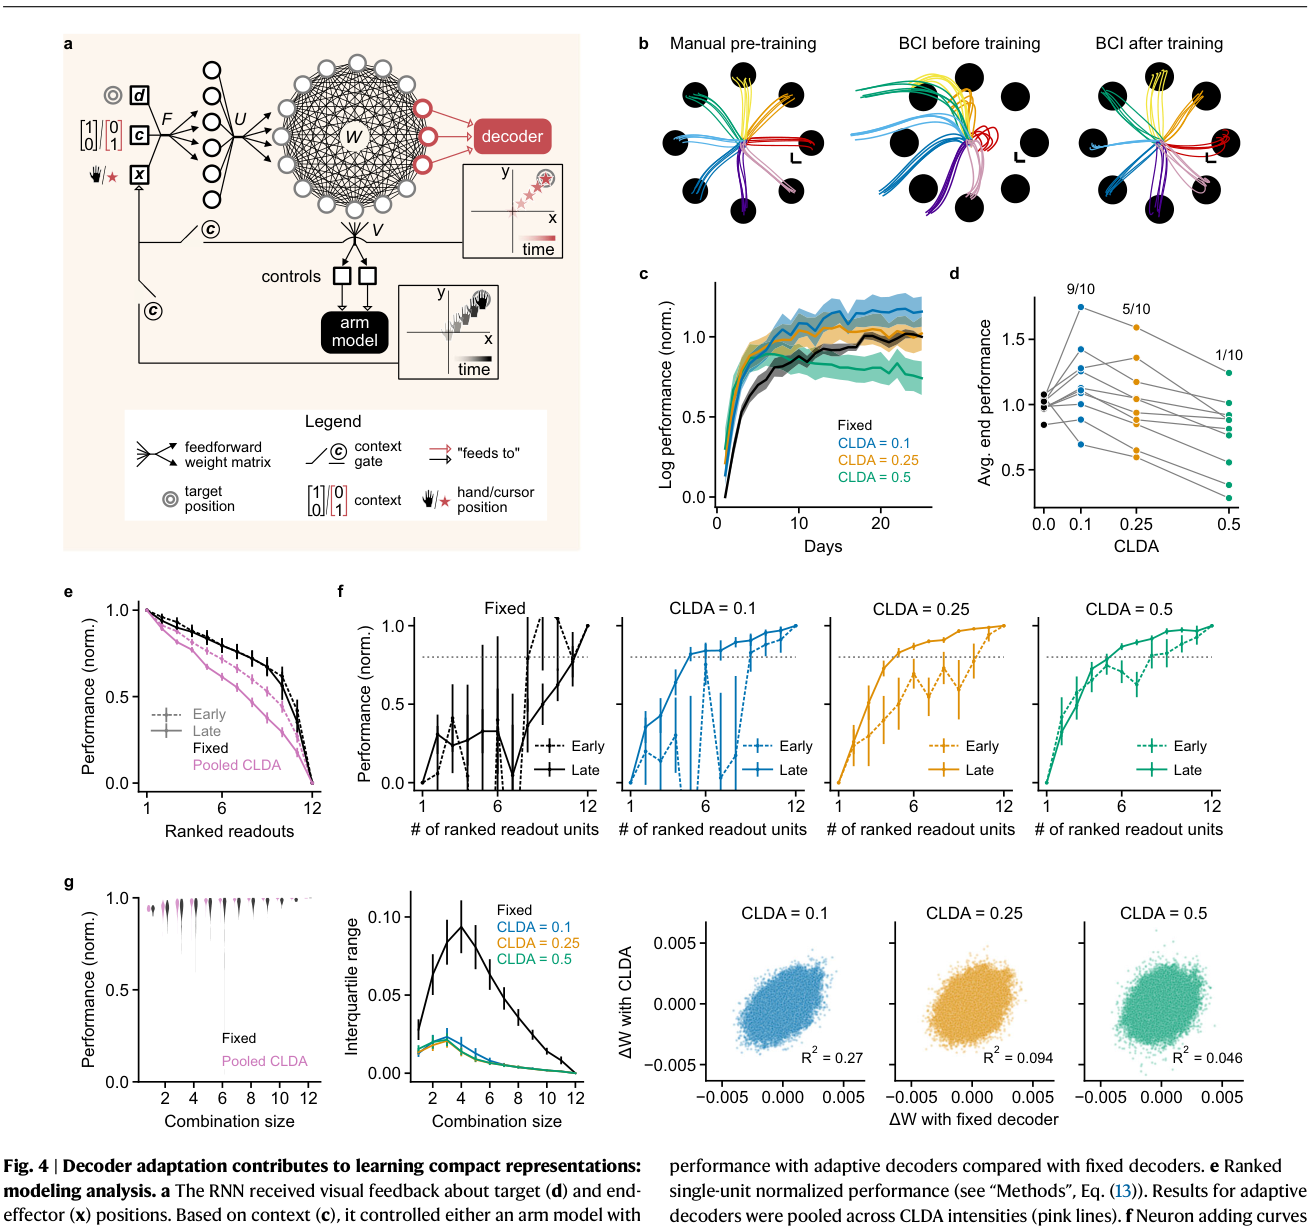
来源:原文 Fig. 4,PDF 第 6 页。
图 4 · 模型:decoder adaptation 直接参与塑造 compaction。 (a) RNN 架构:输入层经随机编码矩阵 F 接收延迟的目标、末端执行器位置与 context 信号,循环权重 W、输入权重 U 可塑,输出经 V 控制手臂模型(arm context,全部单元)或 BCI 光标(BCI context,仅 readout)。(b) 三阶段训练:先学手臂任务,再用手臂轨迹拟合解码器,最后切到 BCI 训练。(c) 不同 CLDA 强度下的归一化 log 性能:无论强度,adaptive 都加速早期学习。(d) 末 5 天平均性能——中等强度维持或改善最终性能(种子胜率最高 9/10),最强适应(0.5)反而最差(1/10),因为算法目标与任务目标后期冲突。(e) 排序的单单元在线性能:adaptive(粉)晚期衰减更陡,即强者愈强。(f) 用在线性能算的 NAC:fixed 晚期要 12 个 readout 里的 11 个才到 80%,adaptive 则明显压缩。(g) 组合式性能分布的 IQR:fixed 更大,说明 adaptive 同时压制了低贡献单元的干扰。(h) 有无 CLDA 下循环权重变化 ΔW 的散点,决定系数随 CLDA 强度从 0.27 降到 0.046——共同适应驱动的是一条不同的模型权重更新路径。这张图提供模型内部的因果对照:同样的初始网络,只改算法这一个变量,compaction 就出现或消失。
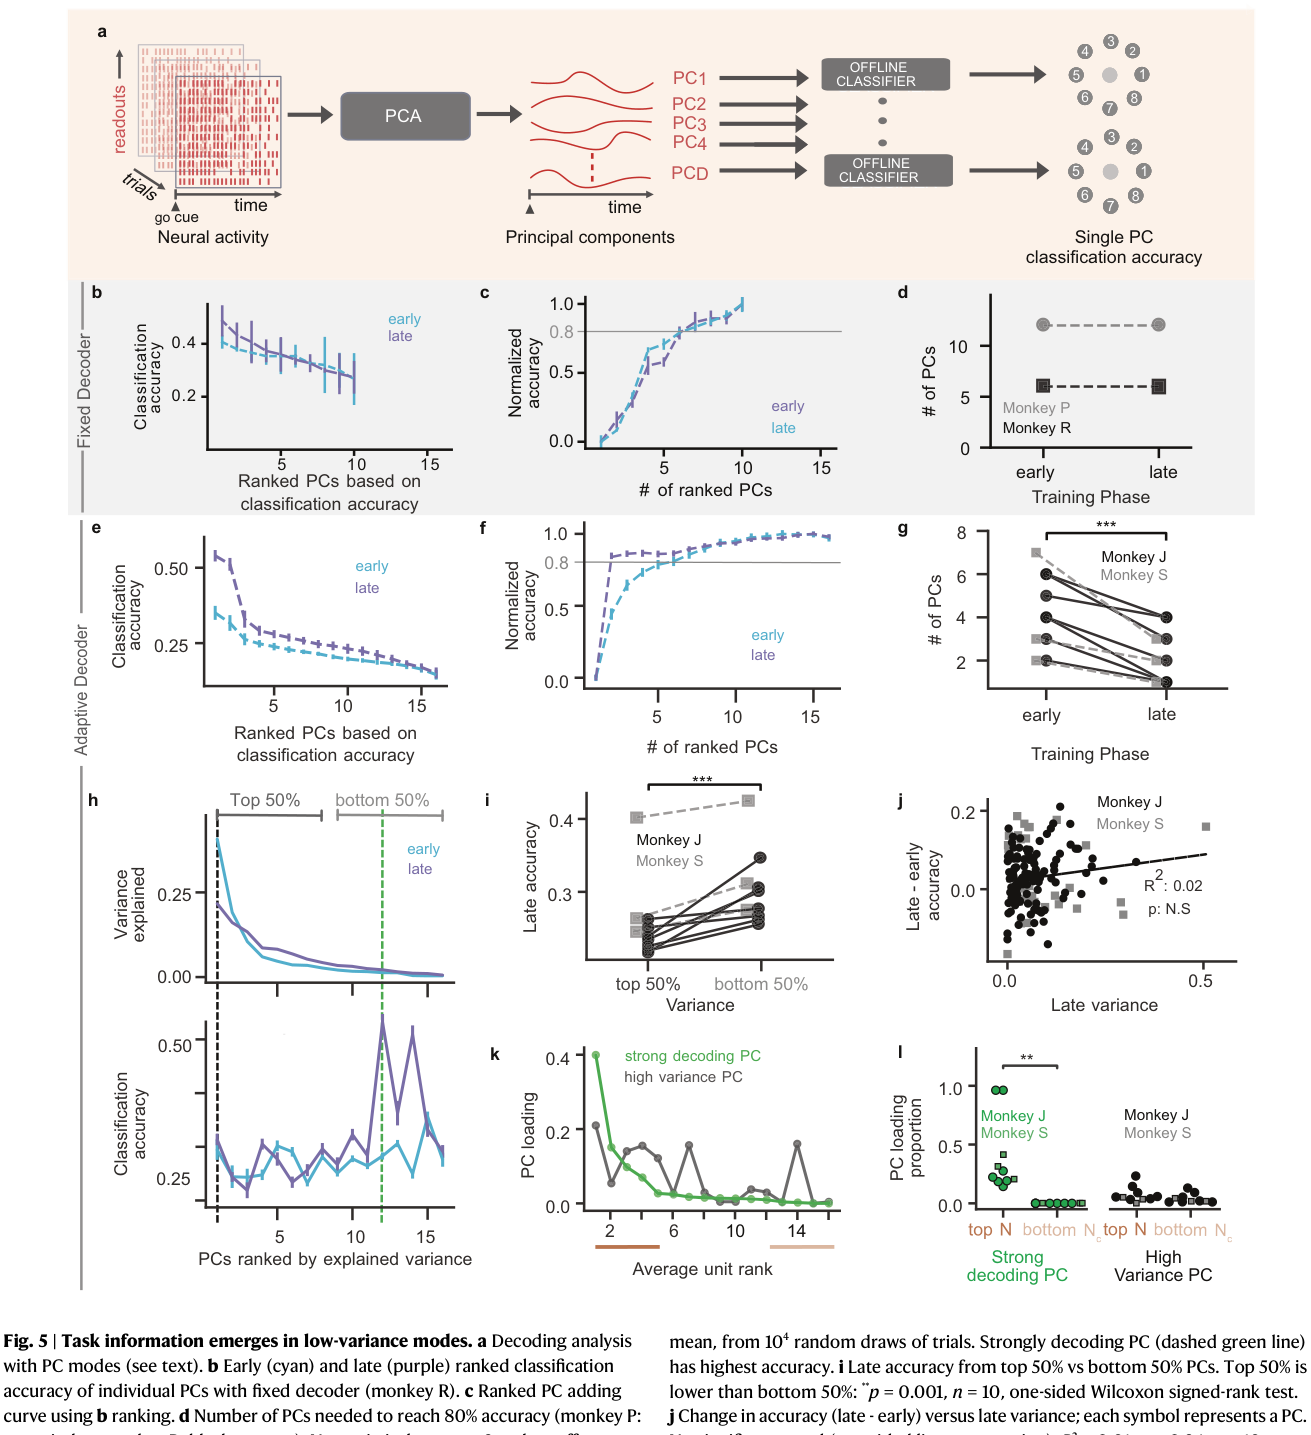
来源:原文 Fig. 5,PDF 第 8 页。
图 5 · 任务信息涌现于低方差神经模式。 (a) 把 NAC 的特征从单神经元换成 PC 模式的分析示意。(b–d) fixed decoder(monkey R 示例):排序 PC 准确率与 PC adding curve 早晚期几乎不变,所需 PC 数无变化(两只猴 ΔNPC 均为 0)。(e–g) adaptive decoder:NPC 随学习显著下降(p = 9.7 × 10⁻⁴)。(h) 左右两列对比是这张图的关键比较——按方差排序的各 PC,其方差分布(上)与分类准确率(下)并不对齐:解码力最强的 PC(绿色虚线)解释的方差并不靠前。(i) 晚期分类准确率在 bottom-50%(低方差)PC 组显著高于 top-50%(高方差)组(p = 0.001)。(j) 每个 PC 的准确率增量与其方差无相关(R² ≈ 0.01)。(k, l) loading 分析:强解码 PC 的 loading 平方几乎全由排序靠前的单元贡献(top-4 vs bottom-4,p = 0.002),高方差 PC 则是随机混合(p = 0.38)。这张图把 compaction 从"少数神经元"升级到"少数协同模式",并给出一个对领域方法论的警告:只看 top PCs 可能刚好漏掉大脑真正用来干活的那部分活动。
讨论与解读边界
本文提醒我们,帮助控制的算法也可能改变学习后可读出的神经表征。值得保留的是两个不同结果:任务信息可集中在较少单元中,而总活动方差的维度不一定下降;按方差选择主成分也可能遗漏有用的任务信息。
动物数据中的固定与自适应条件来自不同实验和解码设置,不能把组间差异全部归因于 CLDA。模型通过控制其他条件展示了一个可行机制,因果解释仅在模型假设内成立,并不是实测突触改变的证据。低方差模式含有较多可分类信息,也不自动证明它们是实际驱动行为的唯一通道。信息集中会提高效率还是增加对单元丢失的脆弱性,本文未直接检验。
思考问题
- 在同一动物、同一解码器家族中随机交替辅助强度,神经信息集中现象是否仍出现?
- 若移除高信息单元,集中表征与分布式表征哪一种更能维持在线控制?