A03 · Trial-by-trial motor cortical correlates of a rapidly adapting visuomotor internal model
Stavisky, S.D., Kao, J.C., Ryu, S.I., & Shenoy, K.V. (2017). The Journal of Neuroscience, 37, 1721–1732. doi:10.1523/JNEUROSCI.1091-16.2016
目标出现前的运动皮层群体状态与近期视觉增益经验相关,并能预测随后伸手的速度。结果支持内模型相关状态在具体运动目标确定前已经可被读出;补偿增益的应用验证仍是离线分析。
核对版本:Zotero VR 集合中的本地 PDF(2026-09-18);Zotero 条目 · 打开原文。图下页码均为该 PDF 的文件页序,从 1 开始,可能不同于期刊印刷页码。
背景
运动适应不仅改变某一次动作,也可能改变下一次动作开始前的神经状态。本文问的是:目标尚未出现时,运动皮层群体活动能否反映近期视觉增益经验,并预测随后伸手的速度。
研究思路
固定增益和逐试次随机增益交替出现。作者用固定增益条件的群体均值定义增益轴,在目标前窗口分析单试次投影、近期经验和下一次速度的关系,并检验跨方向表现及离线补偿的可行性。
方法
两只雄性恒河猴 J 和 R,慢性 Blackrock 阵列。J 双阵列(M1 加 PMd 共 192 电极,本研究不区分两者),R 只有 PMd 阵列信号质量过关(95 电极)。主要分析用 threshold-crossing 多单位(阈值 -4.5×RMS),理由坦率:关心的是群体状态里的信息而非单神经元响应;同时对各自最大的 dataset 手工分选(J 得 69 个单神经元、52 个运动调谐、中位调制 3.7 Hz;R 9 个全部调谐、中位 6.9 Hz),复验全部关键分析。任务是 VR 里的 Radial 8 Target:光标速度等于手速度乘 gain,Wheatstone 立体镜让猴子看不到手臂;中心目标 4×4 cm 获取框 hold 1 s(进入 hold 约 212 ms 后光标锁定在屏幕中心,防止猴子从 hold 期的残余手动里读出 gain),随后 8 个 6 cm 远的辐射状目标之一出现,再 hold 1 s 拿第二份奖励。每个 session 先约 250 trial 的 RG,再各约 100 trial 的三个 CG block(顺序 {0.5, 2, 1} 或 {2, 0.5, 1},故意非单调以区分疲劳与适应),循环到猴子喝饱;每个 block 开头至少 10 个 transition trial 不分析。每猴 5 个 dataset 全部保留,剔除失败 trial(0.2–3.1%)、超时和异常 RT 后,共分析 J 6695、R 11001 个 trial。行为指标是手速度(按目标逐 ms z-score);群体放电率差异用 1001 次 shuffle 校正的欧氏距离(再除以电极数开方,单位 Hz/电极)。
主要结果
行为先确认适应存在。CG 条件下 J 猴的平均伸手速度(目标出现后 0–400 ms)为 10.9、7.6、5.6 cm/s(gain 0.5/1/2),低 gain 下比高 gain 快 95.6%(R 猴为 85.6%)。RG 条件下猴子带着上一 trial 的内模型出手:J 的 RG 0.5 比 CG 0.5 慢 23.9%、RG 2 比 CG 2 快 50%(R:20.9% 与 38.7%),到靶时间因此变长。上一 trial gain 的影响高度显著——J 在 RG 0.5/1/2 试次中,刚经历低 gain 之后比刚经历高 gain 之后快 32.4%、45.5%、26.0%(R 为 24.1%、35.1%、14.5%),连续遇到同 gain 的试次会进一步向 CG 速度收敛。RG 0.5 与 RG 2 的速度分布直到目标后 449 ms(J)、355 ms(R)才显著分开——这些时间点是两种增益条件的行为差异达到统计显著的时刻,可作为反馈修正的行为指标,不能证明此前完全没有反馈作用。
神经结果分三层。第一层是存在性:pretarget 的群体放电率在 CG 0.5 与 CG 2 之间显著不同——J 有 110/192 个电极显著(p<0.01),平均差 4.0±5.7 Hz;R 信号弱(15/95 个电极,0.5±0.7 Hz)但方向一致。RG trial 按上一 trial gain 分组同样分层,且差异随目标临近而增大——内模型在"预期要用"之前就被装载。第二层是结构:PCA 前两维(该 dataset 65% 方差)上各条件的 pretarget 状态近似共线,gain axis 投影的分布均值严格按近期 gain 经验排序——J 的 CG 为 -0.94、0.61、0.97,RG 为 -0.52、-0.08、0.50(R 相应为 -0.65、0.26、0.75 与 -0.62、0.26、0.59),全部两两显著(p<0.001);连续两个同 gain trial 会把投影推得更远。第三层是个重要的反直觉结果:把 CG 0.5 与 CG 2 的时变放电率差投影到 gain axis 上,pretarget 的分离度为 2,到运动开始时掉到接近 0——目标前定义的增益轴对运动期差异的描述能力减弱;不能仅凭这一结果断定两个时期的活动完全正交。
行为预测与跨方向泛化进一步支持内模型相关状态的解释。pretarget gain axis 投影的线性回归解释下一 trial 伸手速度方差的 22–26%(J 的 CG 与 RG 各条件,全部 p<0.001),比"知道上一 trial 的 gain"强 2–3 倍;用手位置回归只能解释 1–2%,减弱了仅由手位置解释这一关系的可能性。跨方向泛化用 8×8 的 train-target/test-target 矩阵:用单个目标的 CG 数据造 target-specific gain axis,去预测其他目标的速度——全部 192 个组合显著(CG p<0.05、RG p<0.01),且对角线不占优(24 个组合里只有 2 或 3 个最佳,与机遇无异),说明这个信号不是"默认准备某个特定目标"。R 猴信号质量差,效应量只有 3–4%,但 leave-one-target-out 变体下全部显著(p<0.001)。最后的 BMI 演示:用 pretarget 神经(前 23 个主成分、二次回归)预测即将发生的朝目标位移,反算补偿增益——J 的 RG 2 误差降到 46.3%(p<0.001),R 降到 68.9%;RG 0.5 本来误差就小,改善不显著。
逐图解读
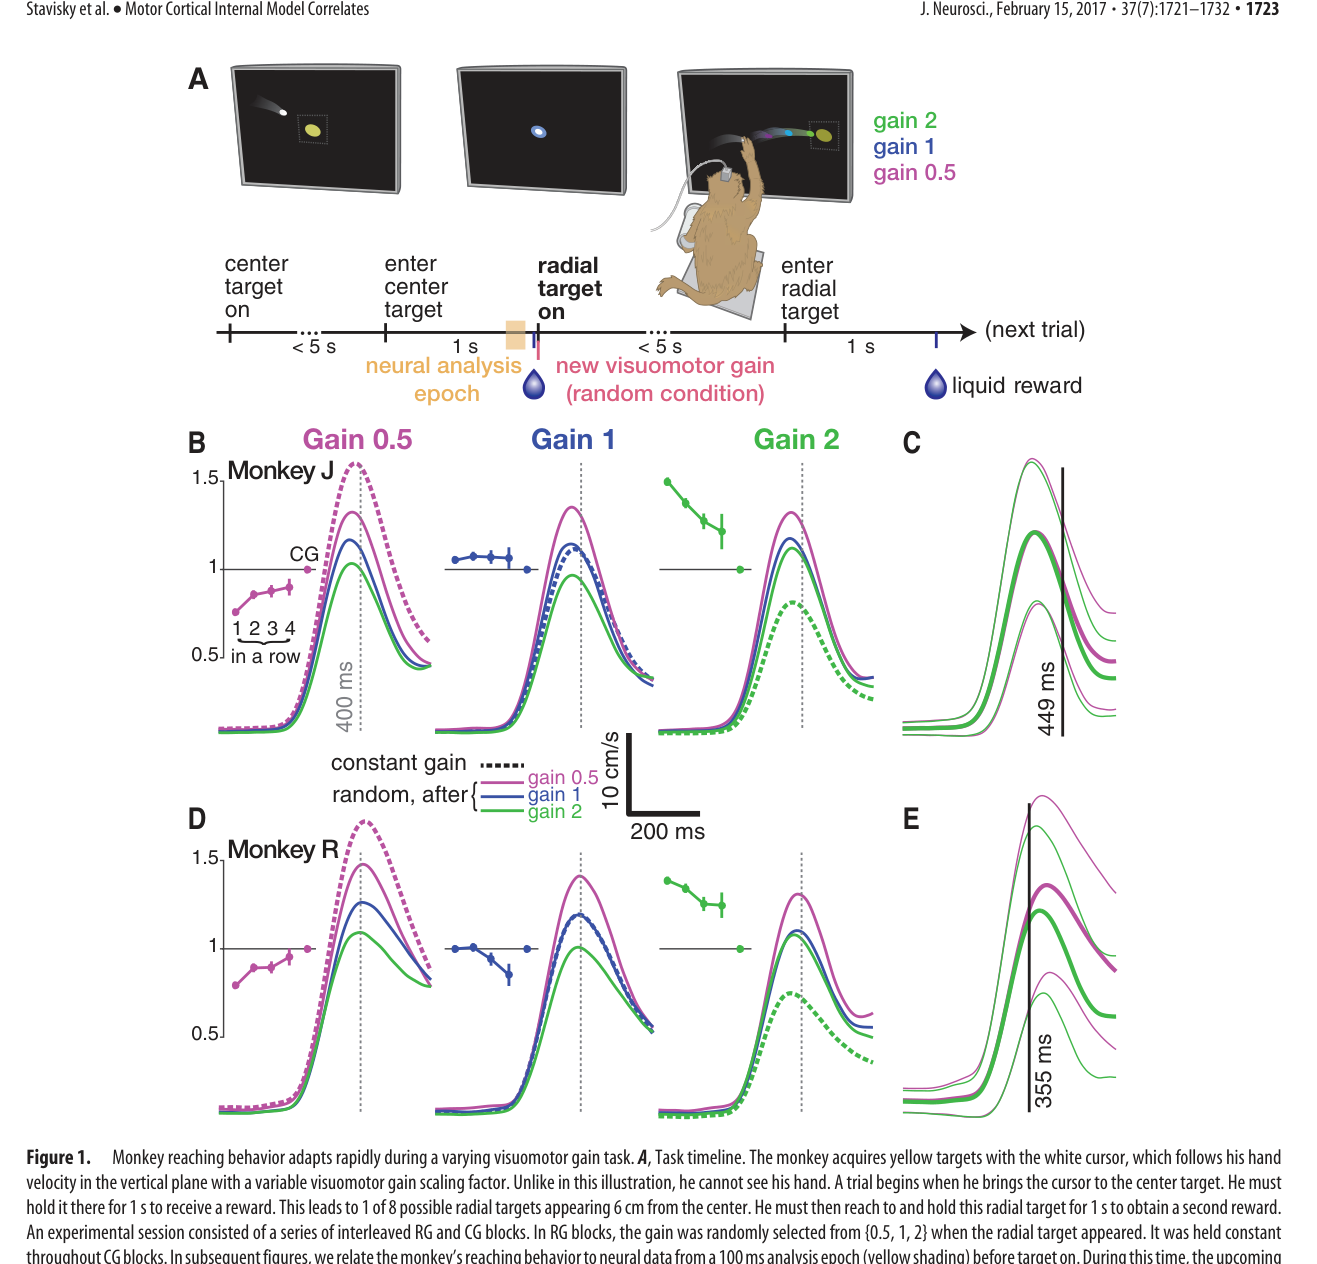
来源:原文 Fig. 1,PDF 第 3 页。
图 1 · 任务与行为适应。 (A) 时间线:中心 hold 1 s、光标锁定、8 选 1 辐射目标、RG/CG block 交替,黄色阴影是 100 ms 的 pretarget 分析窗;(B, D) 两猴的手速度按当前 trial gain 与上一 trial gain 分层——实线的排序就是"上一 trial 的内模型在支配这一 trial",插图显示连续 1–4 个同 gain trial 的渐进收敛;(C, E) RG 0.5 与 RG 2 速度分布的分叉点(449/355 ms),它们标记了可检测的增益相关行为分化,不是视觉反馈通路开启的精确时刻。这张图的行为分析本身就是一次完整的单 trial 适应刻画,也是后面所有神经解读的行为学地基。
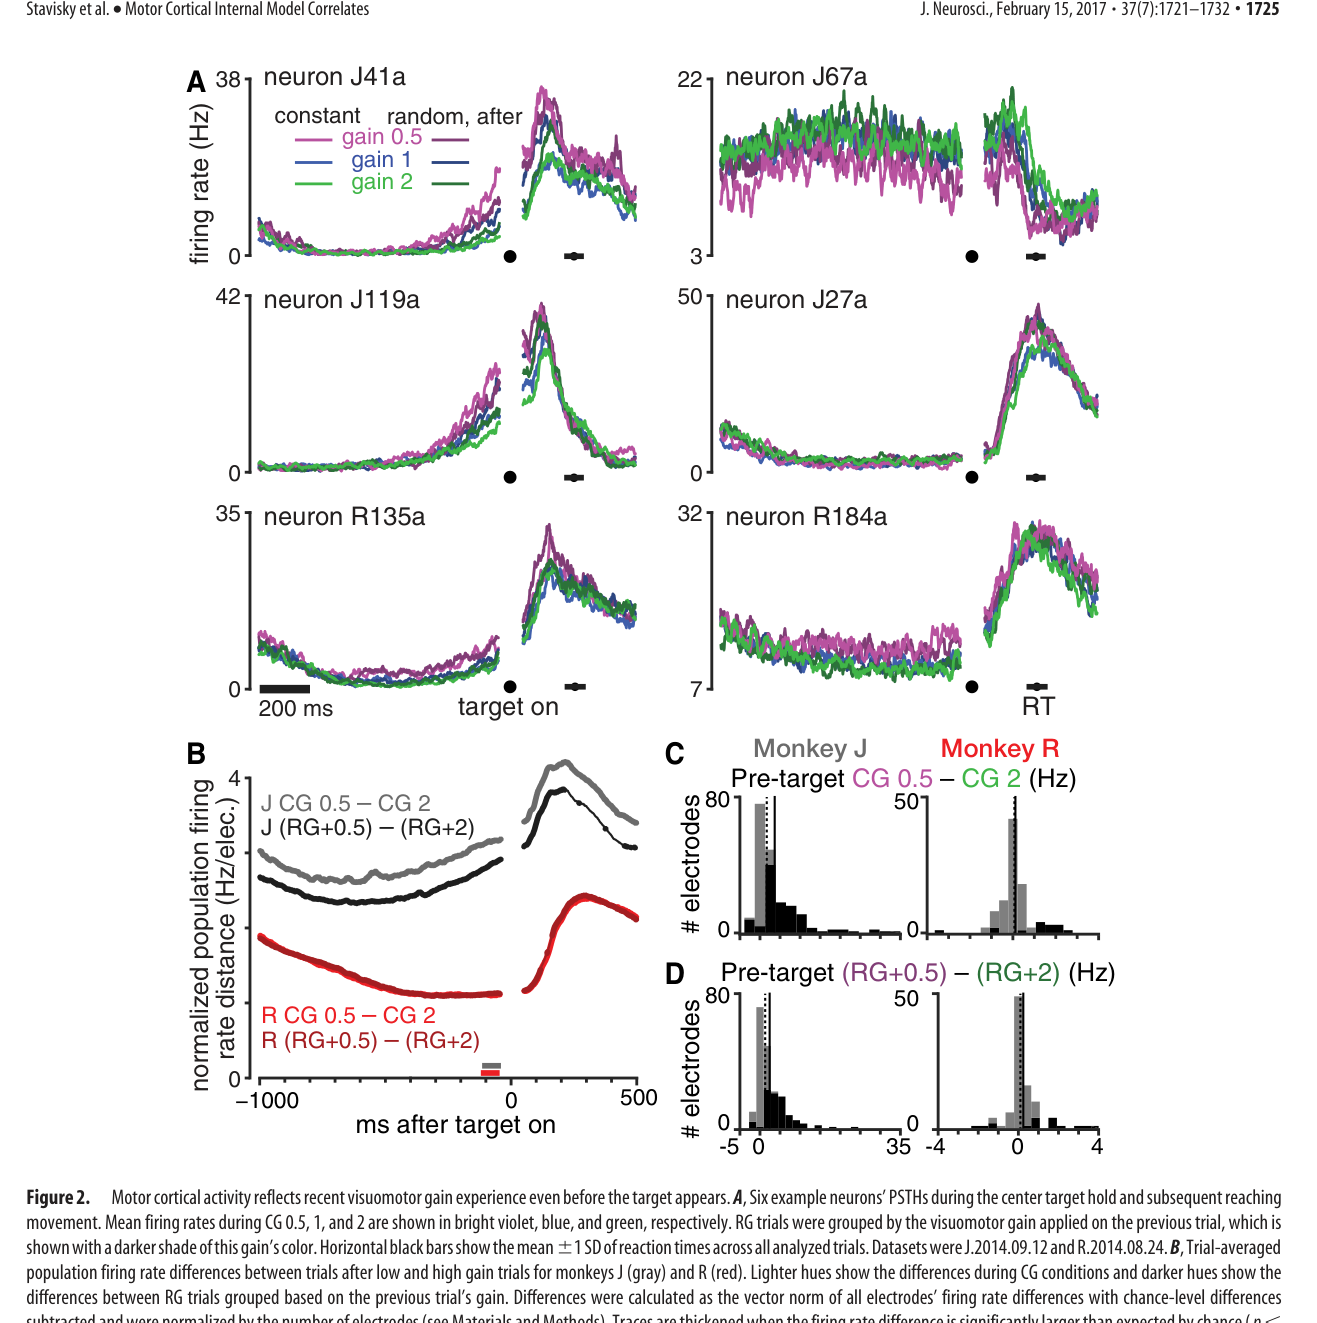
来源:原文 Fig. 2,PDF 第 5 页。
图 2 · 神经相关量的存在性。 (A) 六个示例神经元的 PSTH:多数在期待低 gain 时放电更高(如 J119a),少数相反(J67a),也有无差异的(J27a);(B) 群体放电率距离(shuffle 校正、按电极数归一)随时间的变化:pretarget 全程显著高于机遇,CG 差异大于 RG 差异;(C, D) 电极级差异直方图,黑色为显著电极。注意 J41a 展示的排序——CG 0.5 与 CG 2 是两端,RG←0.5 与 RG←2 是缩小版,CG 1 居中——与行为速度的排序完全同构。
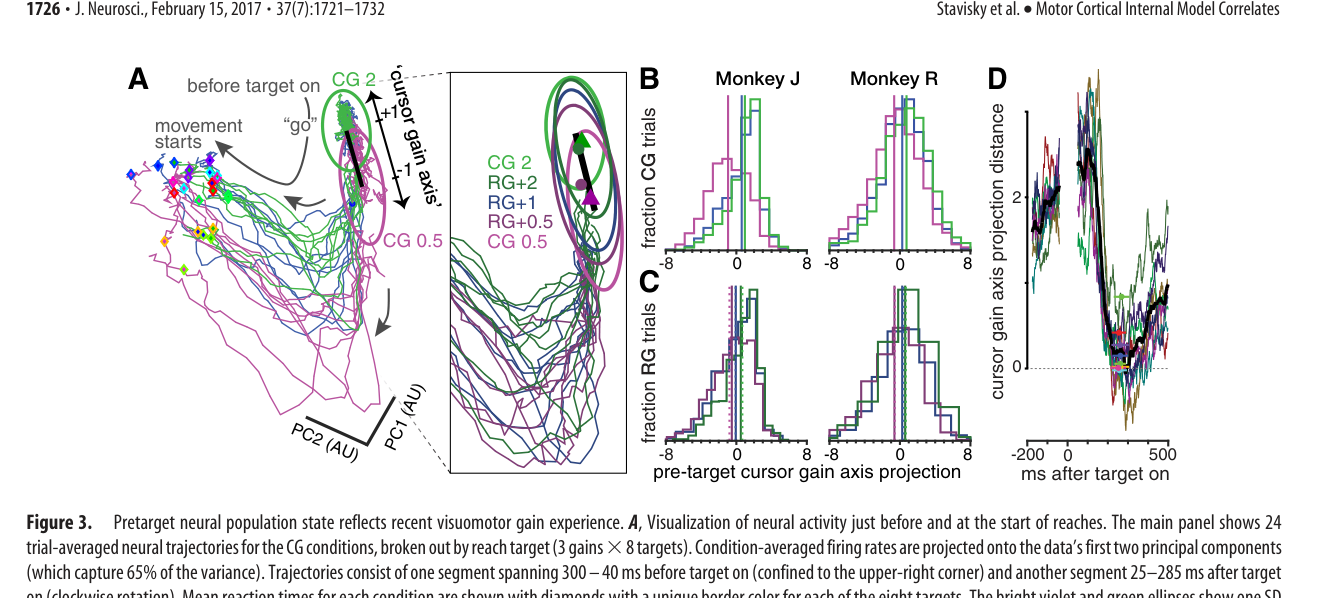
来源:原文 Fig. 3,PDF 第 6 页。
图 3 · 群体状态空间的几何。 主图是 24 条 trial 平均轨迹(3 gain × 8 目标)在 PC1/PC2(65% 方差)上的投影,pretarget 状态聚在右上角、按 gain 分层,粗黑线是连接 CG 0.5 与 CG 2 质心的 gain axis;插图显示 RG 各组的 pretarget 状态沿这条轴依次排开(含连续两个同 gain trial 的外推)。(B, C) 单 trial 投影直方图:CG 与 RG 的分布均值都按 gain 经验分层;(D) 是重要的投影检验——沿 gain axis 的分离在运动开始时几乎归零,说明解释低维投影时,需要检验所选轴在不同时间段是否仍有解释力。
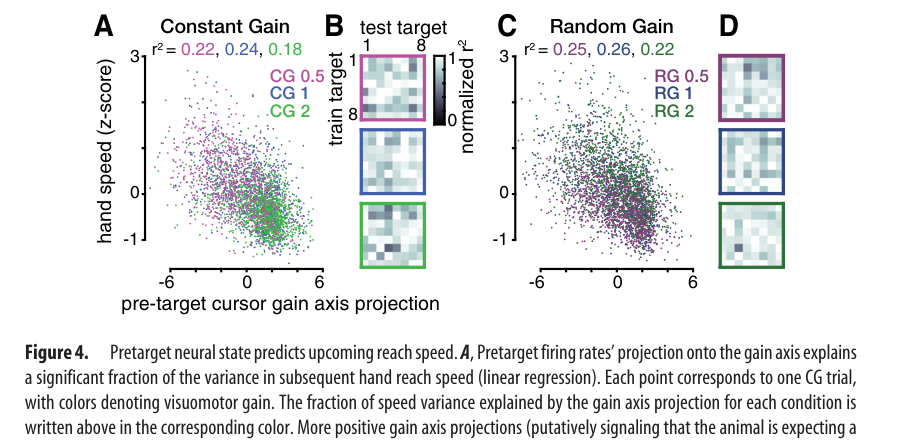
来源:原文 Fig. 4,PDF 第 6 页。
图 4 · 投影预测伸手速度。 (A) CG trial 的散点:gain axis 投影与 z-score 速度显著负相关——投影越正(期待高 gain)下一 trial 伸手越慢,三种 gain 各自的方差解释量标在图上方;(B) 8×8 泛化矩阵,最优解码不聚在对角线上;(C, D) RG 版本,按即将到来的 gain 分组。这张图是"内模型"标签的合法性来源:它不仅反映经验,还预测即将发生的行为,且与伸手方向无关。
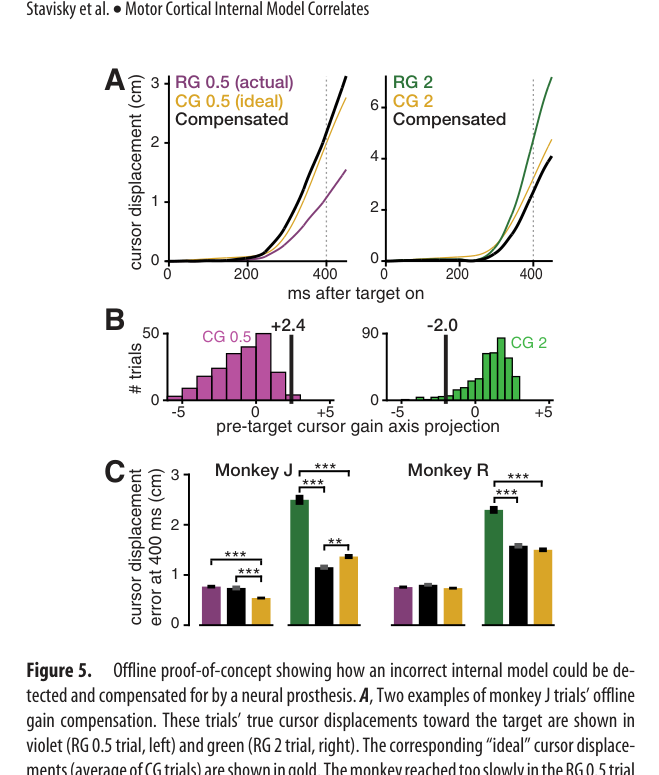
来源:原文 Fig. 5,PDF 第 7 页。
图 5 · offline 补偿演示。 (A) 两个示例 trial:紫(RG 0.5)伸手太慢、绿(RG 2)太快,金线是该 gain 下的理想位移,黑线是按神经预测反算补偿增益后"本应发生"的位移——RG 0.5 例是补偿表现的第 90 百分位,RG 2 例是中位水平;(B) 这两个 trial 在 gain axis 上的投影位置:正投影正确预测了过慢,负投影预测了过快;(C) 误差条形图:RG 2 的误差显著压缩(J 降到 46.3%、R 降到 68.9%),RG 0.5 无显著改善。这是给 BCI 界看的 proof-of-concept:在用户出错的 trial 开始之前就能侦测并预调增益。
讨论与解读边界
随机增益与恒定增益条件的配合,使作者能够把近期经验、目标前神经状态和随后行为联系起来。跨方向预测也削弱了“信号只反映某个特定目标的预先准备”这一解释。这里的“内模型”是原文的宽泛操作性概念,包含影响后续行为的试次历史效应,不区分前向模型与逆模型。
神经状态具有预测力,并不证明它独自生成适应,也不能排除未测量的肌肉状态等共同影响。沿增益轴的组间差异在运动开始时减弱,表明这一固定投影不再充分描述运动期差异;这不等价于证明准备与执行完全正交。两只猴的效应量不同,离线补偿主要改善高增益条件,仍需在线闭环实验验证收益。
思考问题
- 若同时记录 EMG、眼动和姿势,目标前的增益轴还能解释多少独立的行为变异?
- 在线根据该轴调节增益后,动物会不会再次适应新的映射,使离线预测的收益发生变化?