这篇文章用 7T 超高场 fMRI 和对 1,854 个物体概念的密集采样,做了一件此前少有人做的事:不从任何预设模型出发,直接从腹侧颞叶皮层(ventral temporal cortex, VTC)的多体素响应模式里用探索性因子分析(exploratory factor analysis)"长出"表征的主轴。结果是,尽管这个神经编码是高维的,超过一半可解释方差却集中在两条可命名的轴上,二者拼出一个以动物、家具、食物为三个极点的三角几何,并沿皮层横向-内侧方向平滑铺开。它值得读,是因为它把"面孔区/场景区等类别选择区"与"连续维度组织"这两派表面冲突的叙事统一进一幅图景,同时展示了"表征模型空间应当从神经数据中反推"这一新方法学路线的可行规模。
研究背景
数十年的证据已确立 VTC 在把视觉输入转化为支持物体识别与概念分类的表征中的核心地位,但其组织原则仍存争议。主流研究一贯用预设描述符来刻画它:影像学绘出了对面孔、身体、场景、词汇等生态重要类别优先响应的类别选择区(category-selective regions),损伤研究揭示焦点损伤后的类别特异性缺陷;多体素解码与表征相似性分析(representational similarity analysis, RSA)则表明物体身份与类别信息广泛分布、越出任何单一区域的边界;近年又有人提出连续维度观——人类 VTC 响应沿动物性(animacy)、真实世界尺寸(real-world size)等特征平滑变化,猴下颞叶皮层也已被映射到一个由少数预设轴定义的连续物体空间。类别选择区于是被重新理解为更广连续表征空间中的局部敏感峰。
作者指出的缺口是方法论性的:上述工作大多是把预定义模型(语义特征空间、行为相似性判断、深度网络表征)套在神经数据上检验,因而继承了各自模型空间内嵌的假设——结果反映的究竟是 VTC 群体编码固有的组织原则,还是模型空间强加的结构,并不清楚。要直接从神经响应中推断潜在维度,存在两道现实障碍:既有影像研究的刺激集通常较小、对多维物体空间采样稀疏,表征几何估计不稳;常规 fMRI 时空分辨率有限,群体水平的结构难以精细刻画。克服二者需要跨宽物体概念的密集采样加高保真测量——这正是 THINGS 数据库与 7T fMRI 得以组合的前提。
研究思路
作者的总体策略是"反演标准编码模型逻辑":不问"哪个预设模型能解释神经数据",而是把 VTC 响应视为一个概念×顶点的响应矩阵,用因子分析将其分解为(一)捕捉物体层面表征结构的潜在因子得分,与(二)刻画顶点层面敏感度剖面的因子载荷,事后再去解释这些轴。选择因子分析而非主成分,是因为它把共享方差与残差(独特)方差分离,在响应有噪声、目标是恢复跨变量共同结构的场合更为合适。数据先行检验了适用性(KMO = 0.96,Bartlett 球形检验 p < 0.001),因子数用对半交叉验证确定——留出对数似然在 50 因子处达峰,说明编码确实高维;而在此解中,前两个因子合计解释超过 50% 的方差且稳定性远高于更高因子,故后续聚焦二维解。
围绕这个二维解,作者铺开了一条层层设防的验证链:先对几何做行为扎根(与独立的大规模人类相似性判断得到的 66 个连续语义维度求相关);再用嵌套交叉验证的岭回归检验既有维度(动物性、真实世界尺寸、66 维行为嵌入)能解释两轴到什么程度、因子几何又能否在此基础上增量预测被试留出的神经 RDM;然后从三类层面检验稳健性——类别均衡重采样、留出刺激(176 张共享图像)、逐个被试单独拟合——最后把整条分析流水线原样搬到两个完全独立的 3T 数据集(THINGS-fMRI 与 CNeuroMod-THINGS,被试、场强、任务设计均不同)上做复制。如此设计的原因很直接:数据驱动的潜在结构最容易被"统计伪影"或"采样偏差"的质疑击中,验证链的每一环对应一种具体质疑。
方法
20 名健康年轻成人(平均 24.56 岁,女 14/男 6,全右利手、母语为中文)参加。首诊在 3T 上采集 T1/T2 解剖像与静息态;随后连续五天各做一次 7T 任务扫描(相邻两次的中位间隔 23.8 小时)。刺激取自 THINGS 图像数据库:22,256 张嵌入背景的自然主义物体图像、覆盖 1,854 个概念;类别级分析基于其中 960 个带 WordNet 自上而下标签的概念,人工归入 14 个高层语义类别(动物、身体部位、衣物、装饰、武器、食物、植物、乐器、运动器材、玩具、工具、容器、车辆、家具)。主任务为连续物体识别(old/new 判断):每试次 4 秒(图 3 秒 + 空屏 1 秒),每轮 75 试次(64 图像试次 + 11 空白试次);每名被试共看 1,280 张图(1,104 张独有 + 176 张全员共享),每图呈现 3 次,合计 3,840 试次、60 轮(每时段 12 轮);每时段另含一个功能定位任务(面孔、身体、场景、物体、字符五域,6 秒区组快速呈现,做怪异刺激检测)。7T 扫描为 1.5 mm 各向同性多带 EPI(TR 1500 ms,TE 25 ms)。试次级响应幅度用 GLMsingle 估计(从 20 个候选血流动力学响应函数中优选、GLMdenoise 去噪、分数岭回归正则化单试次 beta),在 32k fsLR 表面空间分析。VTC 感兴趣区由三部分并集构成:功能定位定义的类别选择顶点、文献来源的腹侧视觉掩模、以及 HCP-MMP 图集中 12 个高位腹侧视觉区块(FFC、PH、PHA1-3、PIT、TE2p、V8、VMV1-3、VVC)。分析流程上,试次级 beta 先按顶点在时段内做 z 标准化,再按图像平均、按概念汇总;因子分析在 960 概念×顶点矩阵上进行,varimax 旋转,对半交叉验证选 50 因子解;类别级 RSA 用 14×14 的表征相异矩阵(RDM,顶点空间取相关距离、因子空间取欧氏距离),显著性用类别节点自助法与 10 万次类别标签置换检验。
主要结果
- 高维编码由两条主轴主导:留出对数似然在 50 因子处达峰(编码高维、携带细粒度信息),但前两个因子合计解释超过 50% 的方差且稳定性显著更高;仅用二维因子得分重建的类别 RDM 与全顶点数据 RDM 相关达 r = 0.60(95% CI [0.31, 0.84],达到可靠性天花板 0.96 的 62.5%)——图 1、图 2 交代数据质量(应答率均值 97.81%,校正击中率 0.47 且全程显著高于 chance,t(19) = 10.38;VTC 平均噪声天花板 8.72%,共享图像顶点级 ICC 中位数 0.63)。
- 几何是三角形而非离散聚类:14 个类别在二维因子空间中各据其位,动物、食物、家具相关物体锚定三个极点,其余类别沿三角形的边与内部铺开;Silhouette 分数为 -0.12,说明类别之间渐变交融、没有锐利边界,但三个极点类别的分离仍足以支持 86.9% 的线性 SVM 三分类(对打乱标签基线 p < 0.001)——图 3。
- 两轴各自含义明确、又不可还原为单一标签:因子 1 大致沿"动物性"连续体展开,高生物显著度居一端,但娃娃、面具、假发这类具拟人特征的无生命物体也被拉入同端;因子 2 把家具与车辆类物体与其他物体分开,这一端融合了室内外场景关联、真实世界尺寸与可操纵性(大而不可握持的物体聚一极、小而可抓握的居另一极)。行为扎根显示因子 1 与动物、身体/人物、头部相关维度负相关最强,因子 2 与房屋/家居、座位、交通/移动维度负相关最强,两因子共同与食物/植物(水果蔬菜为主)维度正相关——图 3b。定量上,动物性+真实世界尺寸只能解释两轴留出方差的 38.7% 与 29.8%,66 维行为嵌入解释 61.4% 与 48.5%;且把因子导出的 RDM 加进先验模型后,被试留出的神经 RDM 预测 R² 从 0.10 升至 0.22(ΔR² = 0.12,在 96.0% 的训练-测试方向上为正)——轴与既有特征空间重叠但未被其穷尽。
- 几何稳健且可泛化:类别均衡重采样下(100 个子集、每类别 20 个概念),因子载荷与全数据解的相关达 r = 0.984(因子 1)与 0.992(因子 2);176 张留出共享图像投影回固定因子空间仍复现三角结构(二维 RDM r = 0.73);逐被试拟合与组级一致;两个独立 3T 数据集完整复制——THINGS-fMRI 的顶点空间 RDM 与主数据相关 r = 0.84(天花板的 88.4%),CNeuroMod-THINGS 的二维因子 RDM 相关 r = 0.91(天花板的 92.8%),因子载荷相关分别达 0.73 与 0.88/0.93——图 4。
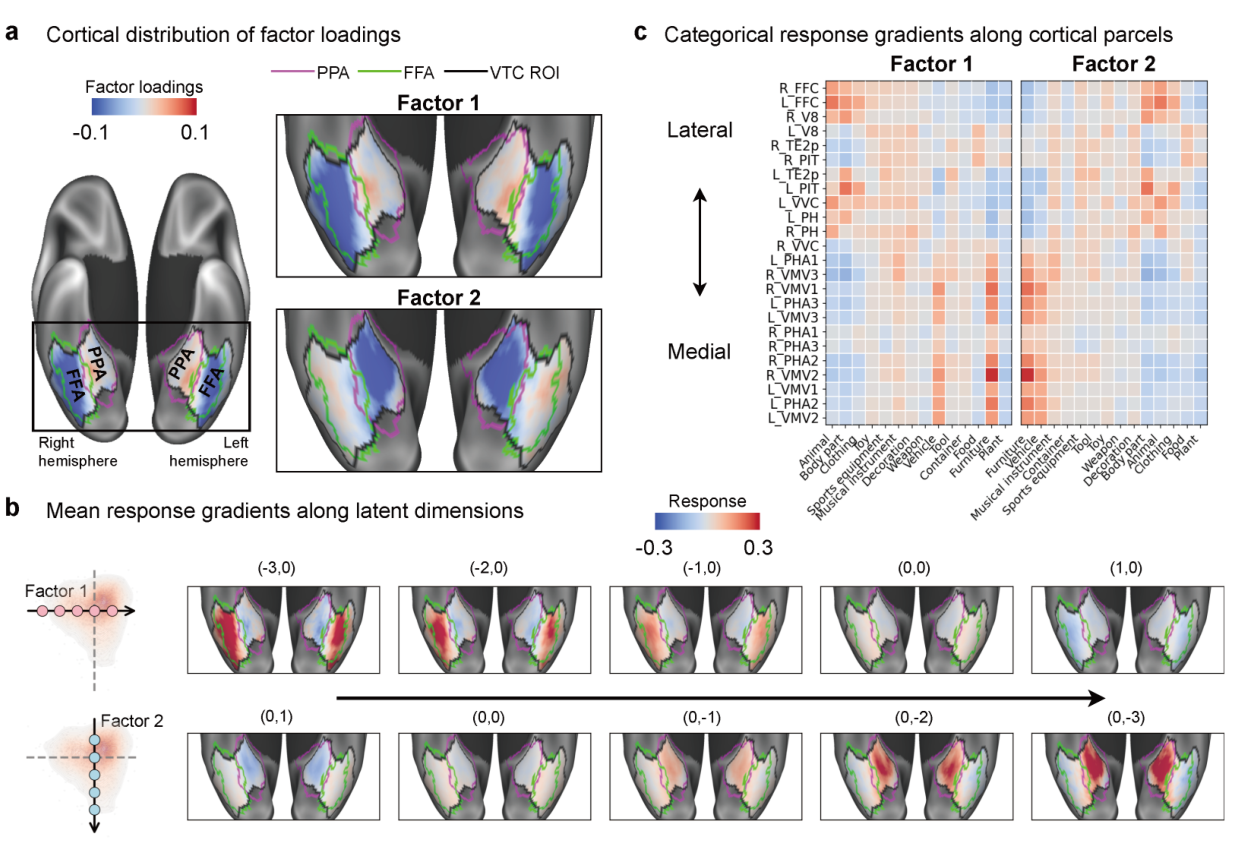
- 潜在几何在皮层上实现为平滑的横向-内侧梯度:因子 1 载荷在 VTC 外侧最强、与梭状回面孔区(Fusiform Face Area, FFA)大幅重叠,因子 2 最强的负载荷落在内侧、与海马旁回位置区(Parahippocampal Place Area, PPA)重叠;沿任一轴采样坐标时,皮层响应剖面在横向加权与内侧加权模式间渐进过渡、无跳变;按 FFA-PPA 重叠指数排序 HCP-MMP 区块后,动物/身体部位类响应在外侧端最强、家具/车辆类在内侧端最强、居两极之间的食物/植物类分布更分散。FFA、PPA 由此成为连续拓扑体中的局部响应峰——图 5。
图注解读
图 1 · 实验设计与分析框架
原文图注:Figure 1 | Experimental design and analytical framework. a. Experimental stimuli were drawn from the THINGS database, comprising 22,256 high-quality naturalistic object images spanning 1,854 object concepts, with category-level analyses based on 960 WordNet-labelled concepts organised into 14 high-level semantic categories. b. During each scanning session, 20 participants performed a continuous object recognition task, making old/new judgements. Participants viewed 1,104 unique and 176 shared images, each presented three times across the experiment. c. Every participant completed five 7T fMRI sessions on consecutive days. Sessions comprised 12 object recognition task runs (64 stimulus trials per run) and one functional localiser run. ……
这张总览图从左到右画出整条流水线:(a) 刺激规模(THINGS 数据库、1,854 概念、960 个带标签概念入分析);(b) 任务形态(连续新旧判断、独有/共享图像及三次重复);(c) 扫描结构(连续五天、每天 12 轮主任务加 1 轮功能定位);(d) 分析路径(GLMsingle 提取试次响应、三种成分并集成 VTC ROI、概念×顶点矩阵 Y 分解为因子得分 Z 与载荷 W)。读懂它就拿到了全文的坐标系统:后面所有"因子得分/因子载荷"的讨论都对应 (d) 中这个分解的两半。
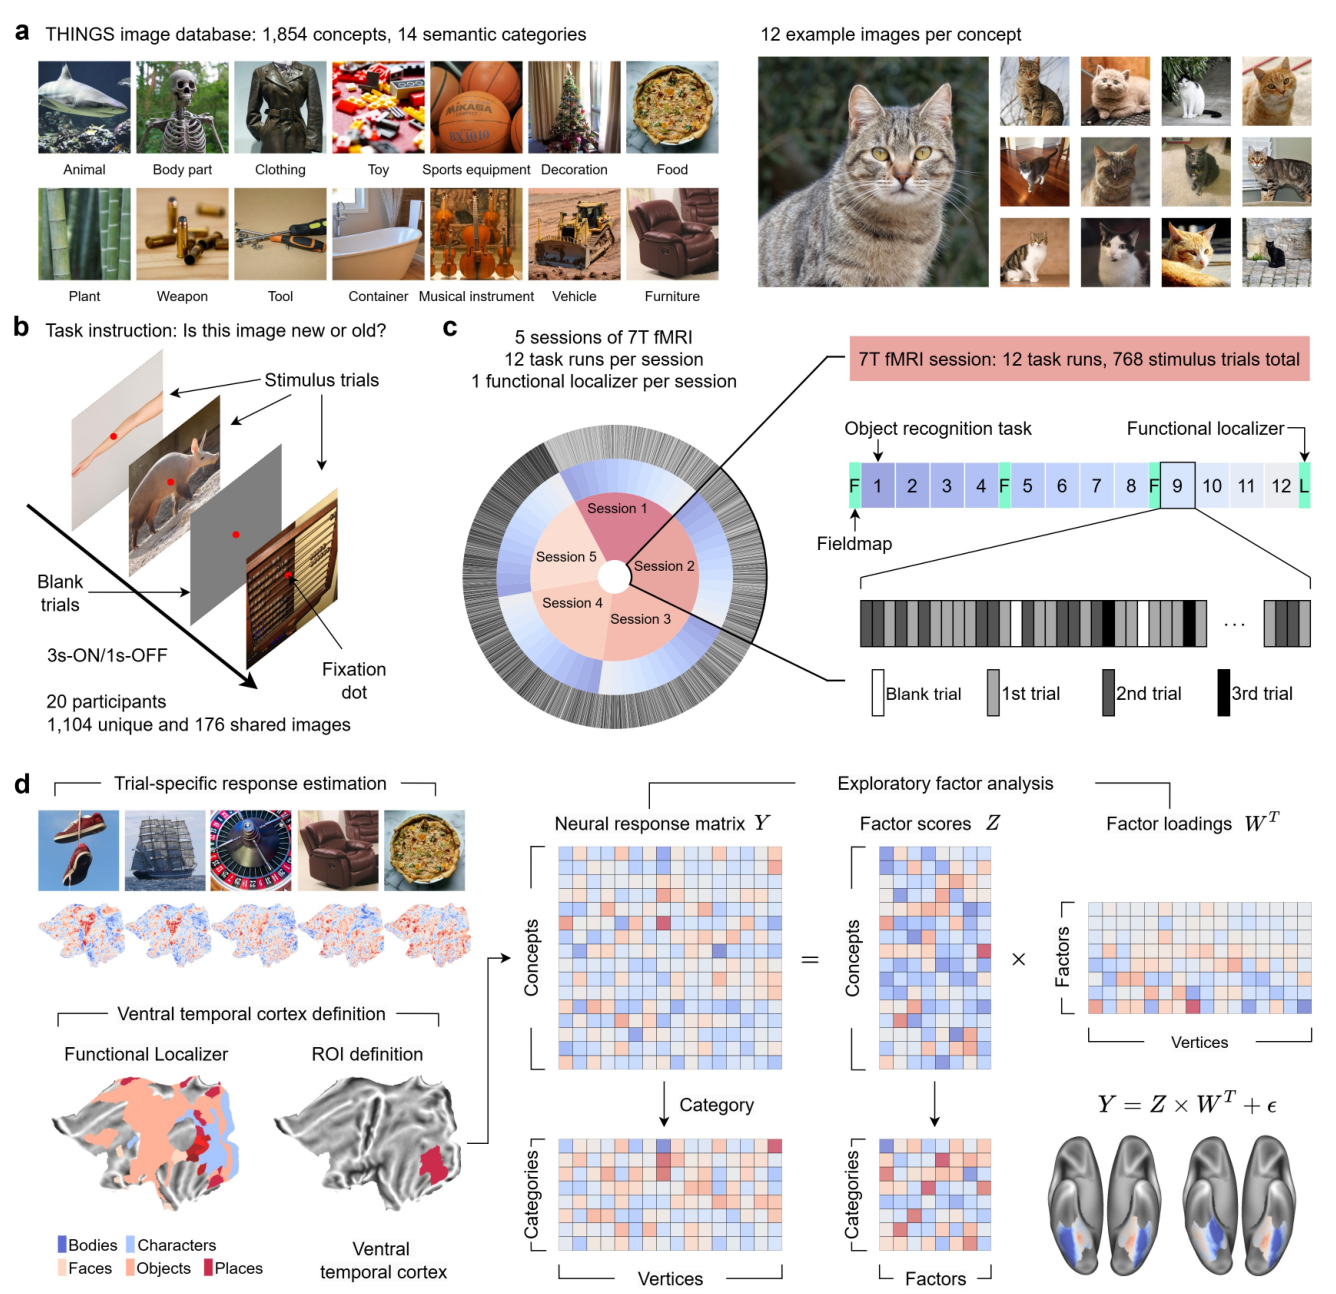
图 2 · 数据质量与可靠性
原文图注:Figure 2 | Dense sampling of the object space generates reliable behavioural and neural responses. a. Behavioural performance across sessions. Left: response rates per session, with each dot representing one participant. Right: adjusted hit rates (hit rate minus false alarm rate) across the experiment; the thick black line indicates the median across participants, and each dot represents a binned average across two consecutive runs. b. Task-evoked BOLD response reliability and noise ceiling within the ventral temporal cortex. Each data point denotes the median value per participant (n = 20). For all boxplots, the centre line denotes the median, box bounds the 25th and 75th percentiles, and whiskers extend to 1.5 times the interquartile range. ……
四个面板分别回答一个数据质量疑虑:(a) 行为端——应答率与校正击中率在各时段稳定、全程高于 chance,排除被试后期走神;(b) 三种 beta 估计方案(b1 标准 HRF、b2 HRF 库、b3 HRF 库+去噪+岭回归)下任务诱发响应的可靠性与噪声天花板,说明信号提取方法收敛;(c) 一名代表性被试的噪声天花板皮层图(黑框为 VTC);(d) 用 176 张共享图像量化跨被试一致性——类别 RDM 两两相关的分布(均值 r = 0.41)与顶点级 ICC(中位 0.63)。这一图支撑主要结果第 1 条的前半:在谈几何之前,先证明密集采样产生的测量本身站得住。
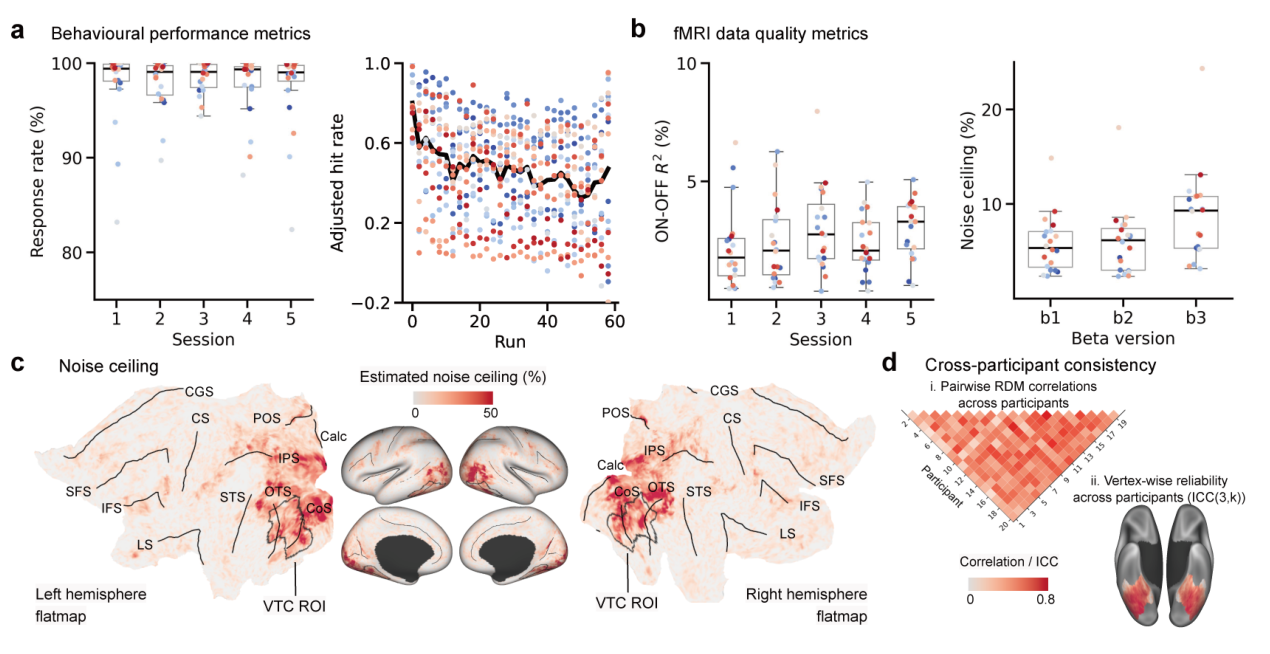
图 3 · 二维因子空间中的三角几何与行为扎根
原文图注:Figure 3 | Object representations in the ventral temporal cortex are structured by a dominant and continuous two-dimensional geometry. a. Projection of object representations onto the two-dimensional factor space defined by Factor 1 and Factor 2. Upper panel: category-level distributions for 14 high-level semantic categories, with shaded regions indicating 95% confidence intervals. Lower panel: individual object concepts (n = 960) coloured by superordinate category; concepts at the three poles of the triangular geometry are marked by +, ×, and ★, with representative images shown on the right panel. b. Behavioural grounding of the latent factors. Bar plots show Pearson correlation coefficients between each factor score and 66 continuous semantic dimensions derived from independent human similarity judgements. ……
(a) 是全文核心图:上半是 14 个类别的分布及 95% 置信域,下半是 960 个概念按大类着色散布,三个极点概念以 +、×、★ 标出并配代表图。读图要点是看类别的置信域如何彼此搭界、又如何在三个角上收拢成尖——这正是"连续但有三极"的几何直观。(b) 为两根轴各列出与 66 个行为语义维度相关最强的一组正、负维度,把"因子 1 像动物性/生物显著度、因子 2 像场景-尺寸-可操纵性"的命名锚定在独立的行为数据上,而非研究者的事后描述——对应主要结果第 2、3 条。
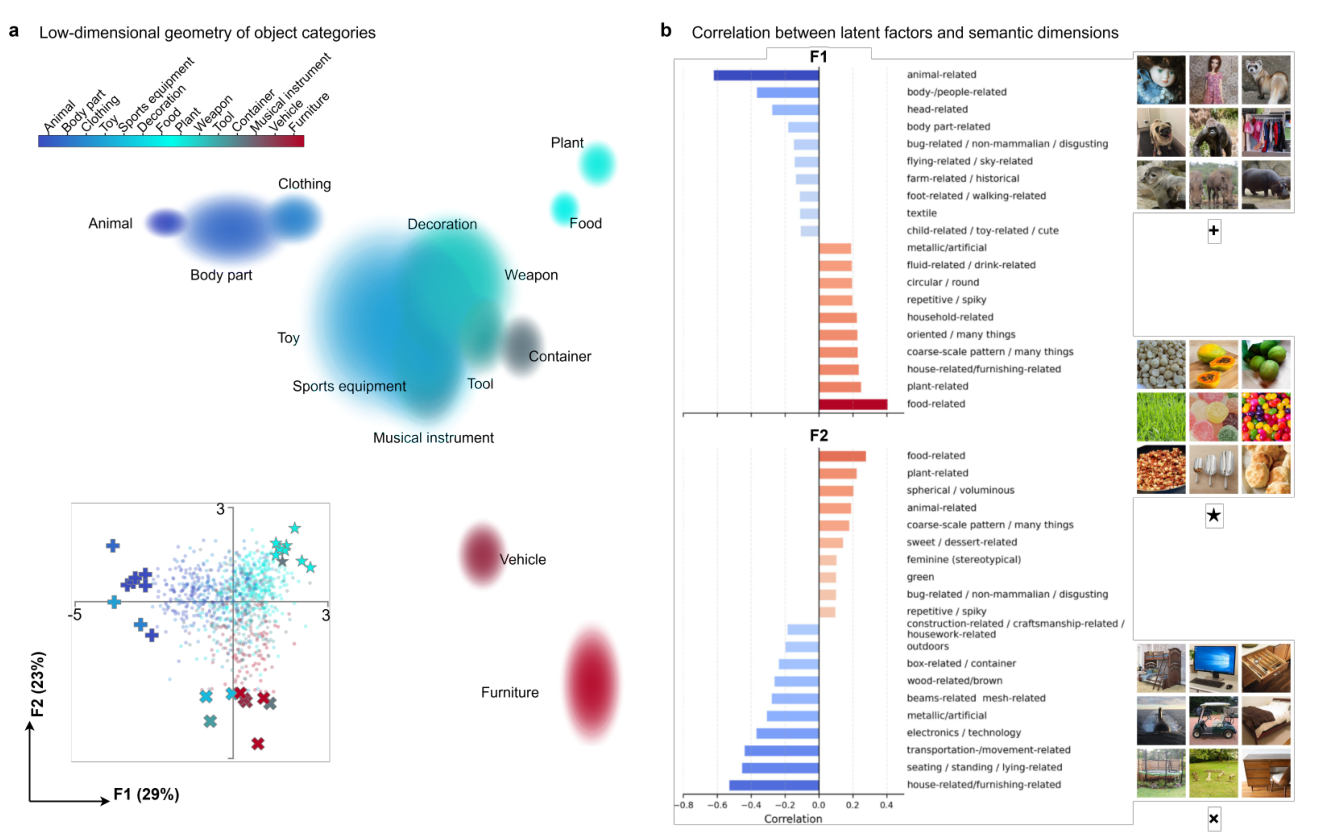
图 4 · 几何的稳健性与跨数据集复制
原文图注:Figure 4 | The two-dimensional representational geometry is robust and generalisable. a. Stability under balanced category sampling. Left: correlations between category-level RDMs from 100 category-balanced concept subsets (n = 20 concepts per category, 280 concepts total) and the full 960-concept dataset, computed in factor space (Euclidean distance; Factor) and vertex space (correlation distance; Data). Right: factor loading correlations between balanced subsets and the full dataset across the first 50 factors. b. Consistency across individual participants. Left: correlations between participant-level and group-level category RDMs in factor space and vertex space. Right: correlations between group-level and individual-participant factor loadings for Factor 1 and Factor 2 (n = 20 participants). c-d. Replication in independent datasets. The characteristic triangular geometry is reproduced by direct application of factor analysis to the THINGS-fMRI dataset (c) and the CNeuroMod-THINGS dataset (d), despite differences in participant samples, scanner field strength (3T versus 7T), and experimental design. ……
(a)(b) 处理"是不是采样偏差/是不是只对这批被试成立"两类质疑:均衡重采样下 RDM 相关约 0.92、前两因子载荷相关达 0.984/0.992;逐被试解与组级高度一致。(c)(d) 是最有分量的部分:把整条流水线直接用在 THINGS-fMRI(3 名被试、3T、快序列怪异检测任务)与 CNeuroMod-THINGS(4 名被试、3T、连续识别任务)上,三角几何照常出现——(d) 中因子 2 的符号被翻转只是为了视觉对齐,因子符号本身任意、不影响几何。它支撑主要结果第 4 条:结构跨场强、跨任务、跨人群可复制。
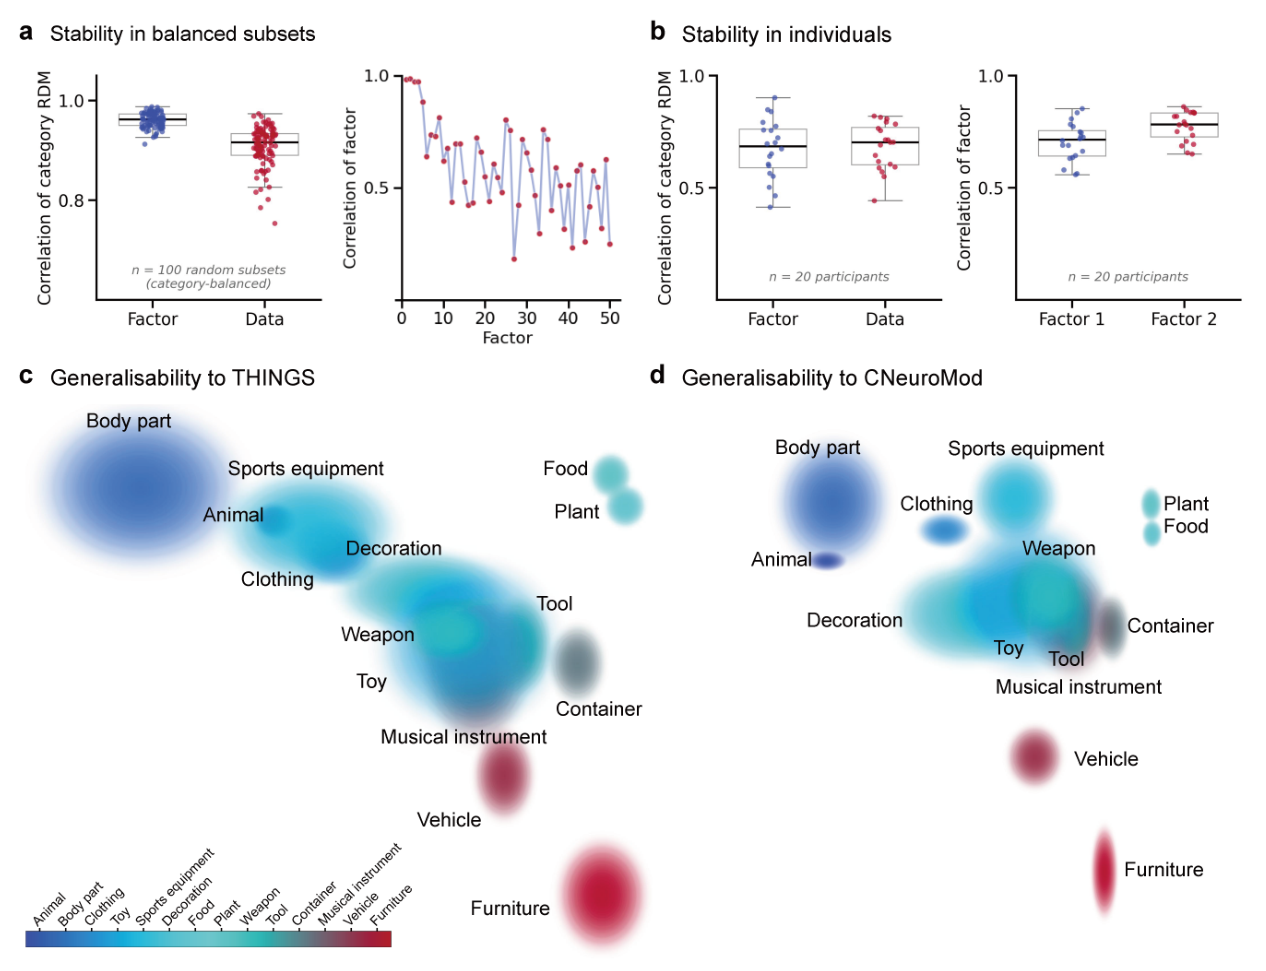
图 5 · 潜在几何的皮层实现
原文图注:Figure 5 | The two-dimensional latent geometry is neurally implemented as a smooth lateral-to-medial cortical gradient. a. Cortical distribution of factor loadings (W) for Factor 1 and Factor 2, projected onto ventral cortical surfaces. Factor 1 loadings are strongest in lateral ventral temporal regions; Factor 2 loadings are strongest in medial ventral temporal regions. Fuchsia and lime outlines denote the Fusiform Face Area (FFA) and Parahippocampal Place Area (PPA), respectively, defined from the Natural Scenes Dataset (NSD) functional localiser task. b. Mean cortical response patterns sampled at selected coordinates along each latent dimension. Schematics indicate sampled positions within the two-dimensional factor space, with coordinates labelled above each surface map. Response profiles transition smoothly across both axes, shifting gradually between lateral- and medial-weighted patterns without abrupt boundaries. ……
(a) 把两因子的载荷映射到腹侧皮层表面:因子 1 强在外侧(品红圈为 NSD 定义的 FFA)、因子 2 强在内侧(青绿圈为 PPA),且两图都存在异号载荷与交叠的中间带——不是两块互斥补丁。(b) 沿因子轴取坐标点采样皮层响应,可见响应剖面随坐标连续滑动、无突然边界。(c) 把 12 个 HCP-MMP 区块按 FFA-PPA 重叠指数排序、显示 14 类响应的渐变热图,动物类在外侧端最强、家具类在内侧端最强。这张图支撑主要结果第 5 条,也是全文叙事的落点:FFA/PPA 等经典选择区是连续统上的局部峰。
讨论
作者的讨论围绕三层展开。与既有账目的关系上,三角几何收敛于猴下颞叶的连续物体空间与人类腹侧流"三分组织"(动物性×尺寸划分有生命/大无生命/小无生命物体)中已确立的两个极,但对第三个极做出修正:小而可操纵的人造物(工具、容器)并没有占据第三极,它们落在三角形的边与内部,占据极点的是食物与植物相关概念——由于植物类以水果蔬菜为主,这一极更宜以"可食性"刻画;食物选择性本身直到近年才经由无假设的体素分解等方法被描述,本文在类别均衡重采样、留出刺激、单个被试与两个独立数据集下都复现了这一极,为它是真实组织原则提供了迄今最强证据。解释框架上,类别选择区与分布式解码的旧分歧被统一:占据轴端位置的类别(动物、家具)产生选择性的局部峰,落在边与内部的类别产生渐变过渡,单变量与多体素两种读数是同一连续空间的互补描述。作者坦承的限制相当具体:varimax 旋转只固定轴在子空间内的朝向,几何(而非两轴的具体命名)才是主张所在;因子分析是线性方法,非线性结构不在其视野;与轴最强对齐的行为维度多描述外观,而 ROI 延伸到中间腹侧视觉区,跨数据集一致尚不能排除中层图像统计的贡献(作者视之为解释边界而非混杂,与图像可计算特征模型的显式比较是下一步);主分析限于 960 个带标签概念,更广采样(动态刺激、自然场景)待做;样本为 20 名年轻成人,几何是否随年龄、文化或视觉经验变化仍开放。
一句话总结
我认为这篇文章最漂亮的不是"找到两条轴",而是用"连续统上的局部峰"一句话化解了 Kanwisher 式模块叙事与分布式表征叙事之间将近三十年的表面矛盾——2000 年 Haxby 的"分布式重叠"与 1997 年的"面孔模块"在这里握手言和。当然要记得这是未经同行评审的预印本,且二维解只占可靠性天花板的六成多,作者自己也把"轴是否只是中层图像统计的投影"列为未决问题;但作为把数据驱动表征学习范式推到整个人类物体空间的一次示范,它是我近年读到的 VTC 组织原则研究里最有野心也最自洽的一篇。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[]