这篇计算神经科学方法学预印本探讨了基于嵌套编码模型(nested encoding models)的多模态表征推断问题:在评估视觉特征相较于语言特征的额外神经解释增量(additional predictive contribution)时,仅改变作为条件化基准的语言预测器的构建方式(如文本长度或拼接结构),即可使视觉增量对比的符号发生反转。作者基于 Natural Scenes Dataset(NSD)的 fMRI 数据、DINOv2 视觉特征及 MPNet 文本嵌入,展示了该方法学效应在两名深度采样被试的多个视觉皮层脑区中均稳定存在。
研究背景
深度学习视觉模型与大语言模型的特征空间被广泛用于预测大脑神经活动,研究关注点逐步转向探讨不同模态特征对皮层表征的特异性贡献。一种常见的研究范式是构建嵌套编码模型:先以语言模型特征作为基准预测器拟合脑活动,再加入视觉特征构建联合模型,以联合模型预测表现相对于单一语言模型的性能增量(ΔV)来评估视觉模态解释的独立方差。通过对比不同文本类型(如简短说明与详细叙述)留下的视觉增量大小,研究者尝试推断大脑特定皮层区域的表征更贴近哪种语义描述。然而,此类推断隐含了一个关键前提:作为比较基准的语言预测器必须具备可比的构建条件,否则增量差异可能仅仅反映了基准模型自身预测能力的基线变动,而非皮层真实表征偏好的改变。
在自然图像的文本描述中,这一构建差异十分显著。同一幅图像的简短说明(如 COCO caption)与长篇叙述(如 Localized Narrative)不仅在语义表达形式上不同,更伴随文本词数、信息覆盖面、标注者数量及内容冗余度的显著差异。即便采用完全相同的预训练语言模型提取文本特征,输入文本形式的变异仍会直接影响特征向量的统计特性及其对神经响应的拟合优度。如果一个较小的视觉增量仅仅是因为输入文本更长从而机械性提升了语言单项模型的解释力,则据此得出高阶视觉皮层与长篇叙述更加对齐的推论便存在系统性偏差。
本研究利用自然场景功能磁共振成像(NSD)数据集,在保持视觉图像、脑响应数据以及视觉特征空间完全恒定的前提下,系统检验不同语言预测器构建方式对多模态对比的影响。通过对短说明进行拼接以实现与长叙述在字数上的近似匹配,并在长叙述内部截取不同片段进行片段选择,检验对比结果对文本输入的敏感性;将视觉增量差值在代数上拆解为联合模型项与单一语言模型项,追踪对比变化的驱动源头;结合实词置换控制排除一般性文本统计特征的混杂。该研究旨在评估此类编码模型推断的稳健性边界,并非否定语言特征在神经建模中的有效性。
研究思路
研究设计控制视觉输入与神经数据不变:固定测试图像、fMRI 反应数据以及视觉特征预测器,仅改变语言预测器 L 的输入文本构造方式,观察视觉特征带来的额外预测增量 ΔV(L) = r(V+L) − r(L) 的变化。语言语料采用同一批 NSD 图像的两种配对描述——MS COCO 短说明(平均 10.4 词,每幅图约 5 条独立标注)与 Localized Narratives 长叙述(平均 41.3 词,单人连续语音转录),两者在平均文本长度上具有约四倍的差异。
实验推进包含三个环节:首先评估未做长度匹配的原始 caption 与 narrative 之间的 ΔV 对比;随后采用两种长度匹配策略——将 4 条独立 caption 拼接(平均 41.7 词)以匹配 narrative(41.3 词),以及将 narrative 截取至各图 caption 的对应长度(分别保留句首片段的 Narrative-first 与中段连续片段的 Narrative-span)进行逐图匹配,评估多模态对比符号的稳定性;最后,基于代数恒等式将多模态增量差值 ΔV(LA) − ΔV(LB) 严格拆解为联合模型项 [r(V+LA) − r(V+LB)] 与单一语言项 [r(LA) − r(LB)],并利用语义实词替换(scramble)评估词汇特异性语义信息的贡献。
方法
数据源自 Natural Scenes Dataset(NSD)中完成全量扫描的两名被试(subj01 与 subj02),每位被试完成 9,000 幅独有图像与 1,000 幅跨被试共享图像的多次观测;采用 1.8 mm 各向同性单试次 GLMdenoise 估计的 beta 响应值,并计算跨重复呈现的均值。测试定义的兴趣区(ROI)包含场景敏感区 Places(OPA、PPA、RSC 联合)、面孔敏感区 Faces(OFA、FFA-1/2 联合)、身体敏感区 Bodies(EBA、FBA-1/2 联合)、独立分析的 EBA 亚区,以及早期视区 V1 与 V4;各 ROI 仅保留信噪比 ncsnr ≥ 0.2 的体素(对应噪声天花板约 0.33),在所有对比模型间保持体素集合严格一致,并在 0.3 与 0.4 信噪比阈值下完成稳定性验证。
模型与特征提取:视觉特征提取自 DINOv2(ViT-B/14),按层级分别选取第 2 层(匹配 V1)、第 6 层(匹配 V4)与第 11 层(匹配高阶类别选择性皮层);语言特征提取自 MPNet 的对应深度层(第 2、6、12 层),且在测试前预先设定匹配规则,避免后验筛选。所有特征空间均经由稀疏随机投影映射至统一的 256 维空间,以消除特征维度差异带来的拟合优势。采用带状岭回归(banded ridge regression)拟合脑活动,视觉特征带与语言特征带分别施加独立的正则化超参数,通过五折嵌套交叉验证逐体素确定正则化强度。预测精度 r 以折外预测值与重复平均观测值之间的 Pearson 相关系数衡量,并经由体素噪声天花板标准化后在 ROI 内计算均值。核心度量为视觉增量 ΔV(L) = r(V+L) − r(L);模型不确定性采用针对 10,000 幅图像的配对 bootstrap 重抽样(1,000 次,重抽样索引在所有比较模型间完全一致)计算 95% 置信区间。
主要结果
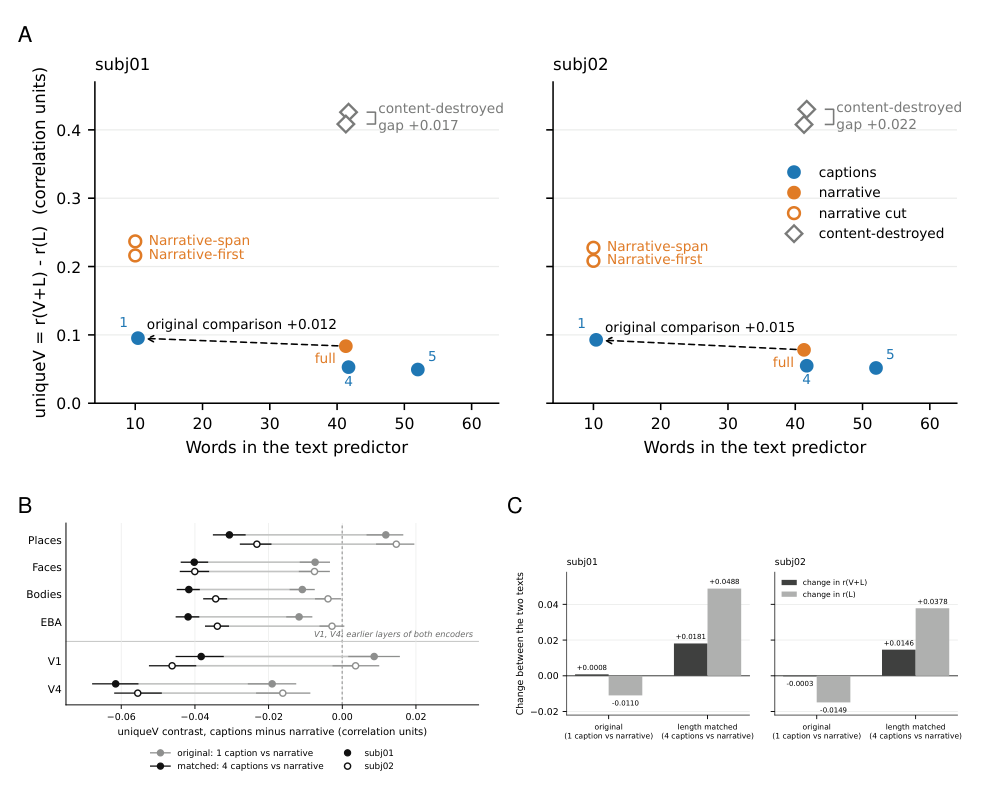
- 未匹配长度的原始对比偏向 narrative:在 Places 区域中,单条短说明对比长叙述的 ΔV 差值分别为 +0.0118 [95% CI: +0.0066, +0.0166](subj01)与 +0.0147 [95% CI: +0.0092, +0.0196](subj02),指示长文本条件下留给视觉特征的增量相对更小;两种描述形式的 ΔV(L) 均随文本词数的增加呈单调递减趋势(图 1A)。
- 文本长度匹配引发对比符号的反转:当采用 4 条拼接 caption(41.7 词)对比叙述(41.3 词)时,Places 区域的 ΔV 对比值反转为 −0.0307 [−0.0351, −0.0262](subj01)与 −0.0232 [−0.0278, −0.0192](subj02);将叙述截取至单条 caption 长度时同样出现符号反转:在 Narrative-first 条件下对比值为 −0.121/−0.116,在 Narrative-span 条件下为 −0.141/−0.135(两名被试)。且两种截取方式之间存在 0.020/0.019 的显著差异,表明在词数恒定条件下,输入文本的片段选取结构同样会改变 ΔV 的估计(图 1A)。
- 系统性负向偏移跨所有测试脑区存在:长度匹配使得测试的六个 ROI(Places、Faces、Bodies、EBA、V1、V4)中的多模态对比均向 caption 偏好方向偏移了 −0.030 至 −0.050,所有 95% bootstrap 置信区间均排除零点,且匹配后全部对比值均转为负值。虽然绝对符号反转仅发生在原始值为正的脑区(两被试的 Places 与 subj01 的 V1),但数值偏移的方向在全皮层表现出高度一致性(图 1B)。
- 对比反转主要由单一语言预测器的性能变动驱动:对 ΔV 差值的代数分解显示,在 Places 的原始对比中,联合模型项贡献仅为 +0.0008/−0.0003,而单一语言项贡献为 −0.0110/−0.0149;匹配长度后,单一语言项贡献(+0.0488/+0.0378)仍显著大于联合模型项(+0.0181/+0.0146)。在所有被试与脑区中,单一语言项的数值绝对值均占主导地位:在类别敏感皮层中单一语言项的幅度达到联合模型项的 2.2–3.1 倍,在 V1/V4 中达到 14–24 倍(图 1C、表 A4)。
- 图像特异性实词置换控制下的效应残留:利用自然语言处理工具将文本中的名词、动词、形容词等内容实词替换为与图像无关的同词性词汇后,Faces、Bodies 与 EBA 区域中长度匹配后的对比仍显著为负(如 Faces 分别为 −0.062 与 −0.052),表明该偏置在去除特定语义指代后仍部分存在;而在 Places 区域置换后对比转变为正向(+0.017/+0.022)。由于置换保留了虚词结构与句法长度(在 Places 中仅虚词数量即可达到 r(L)=0.14/0.16 的基线拟合),残存的对比表明通用结构特征在拟合中同样发挥作用。
图注解读
图 1 · 预测器构建方式如何翻转多模态对比
原文图注:Figure 1A shows that ∆V (L) decreased with text length for both predictor families. When four concatenated captions (41.7 words) were matched to a narrative (41.3 words), the contrast reversed to −0.0307 [−0.0351, −0.0262] and −0.0232 [−0.0278, −0.0192]. Truncating narratives to caption length gave the same result: one caption versus Narrative-first yielded −0.121/−0.116, and versus Narrative-span −0.141/−0.135, for subj01/subj02. The two narrative truncations themselves differed by 0.020/0.019, showing that predictor construction matters even at fixed word count.
图幅由三个面板构成:A 面板以 Places 区域为例,横轴为文本词数,纵轴为视觉额外预测贡献 ΔV(L);展示了单条 caption(虚线箭头指示)与长叙述之间的原始正向差值,随后展示 4 条 caption 拼接后(约 41 词)差值发生反转,以及截断叙述导致的更大负向偏移,灰色菱形标注实词置换控制点;B 面板并列展示六个 ROI 在两名被试(实心与空心点)上的原始与匹配后对比值,显示跨区域一致的向负向偏移;C 面板展示 Places 对比中联合模型项 r(V+L) 与单一语言模型项 r(L) 的条形分解,明确指示单一语言项贡献占据绝对主导地位。对应主要结果第 1 至 4 条。
讨论
研究表明,在嵌套编码模型的评估中,如果不严格控制条件化基准预测器的物理长度与构建方式,多模态增量对比可能产生完全相反的结论。原始对比中观察到的 narrative 优势,在控制词数后发生符号反转,证实原始效应显著受制于输入长度差异带来的基线拟合偏差。作者进一步指出,该反转不能简单归结为字数的单一片面因果,因为拼接短说明在增加词数的同时也引入了多标注者的视角多样性与词汇重叠度;而在相同语料内部截断片段的实验同样证实,即使字数严格一致,不同的文本片段选取策略仍会引发显著的模型表现差异。
从计算机制上看,将嵌套对比代数拆解为联合项与单一语言项的分析表明,表征对比的波动主要源于单一语言模型预测性能的改变,而非联合表征结构的真实变异。因此,当研究者试图通过“模态 A 在模态 B 之外解释的剩余方差”来推断大脑表征的模态归属时,该差值在很大程度上受制于模态 B 预测器的基线解释力。研究指出了相关局限:实验基于两名深度采样的个体被试以及特定的视觉—语言模型配对(DINOv2 与 MPNet),结论主要作为方法学稳健性边界的实证反例。作者建议在未来的神经多模态表征对比研究中,应将预测器的文本长度、词汇构成及构建方式作为关键实验变量予以匹配和报告,并常规执行模型代数分解与扰动敏感性分析。
一句话总结
研究证实利用嵌套编码模型评估视觉与语言特征的大脑预测增量时,条件化语言预测器的长度与构建方式足以反转多模态对比的结论,且该反转主要由基线语言模型的拟合波动所驱动。