Wu, Jiang & Li · bioRxiv 预印本(2026-09-18 发布,未经同行评审) · 2026 · DOI: 10.64898/2026.09.16.752038
该研究将自然场景分解为“头实体—关系—尾实体”三元组,并通过独立行为实验评估不同三元组在知觉加工中的可达性。结果表明,基于行为权重筛选的 top-3 场景图模型比未加权三元组更贴合人类高级视觉皮层的神经表征,并能保留实体、关系及空间视野的可解耦性;跨物种分析显示人脑高级视觉区相对猴下颞叶皮层更贴合三元组模型,但该差异属于条件性模型比较,并不代表猴脑缺乏关系语义加工能力。
研究背景
自然场景理解不仅需要识别场景中的单个实体,还需要解析实体间的空间位置、动作交互与功能关联。当前视觉皮层计算建模多采用卷积神经网络(CNN)或基于图像字幕的大语言模型表征预测神经反应,但这类全局特征通常将物体、背景和关系压缩为单一高维向量,难以直接分离神经调谐究竟来自实体类别、空间共现还是抽象关系结构。场景图(scene graph)将视觉场景形式化为头实体、谓词关系与尾实体构成的三元组,为离散化解析场景语义单元提供了工具,有助于检验特定关系类型的皮层定位及其表征特征。
然而,图像标注中客观存在的所有三元组,在人类快速知觉过程中并不具备均等的可达性。若对一幅图像中的全部三元组进行简单无加权平均,容易忽略物体尺寸、视觉显著性、距注视点距离以及关系类型等认知因素的调节作用。因此,需要结合行为可达性构建加权实体—关系结构,并检验其对皮层神经反应的增量预测效能。同时,需检验该结构化模型是否保留了视野空间对应关系,以及实体与关系是否在神经表征层面具备统计可分解性。需要指出的是,该论文为 bioRxiv 未经同行评审的预印本,其相关结论应作为可检验的理论假设对待。
研究思路
研究者采用 RotatE 知识图谱嵌入算法对 PSG 数据集中的场景图三元组进行向量学习,并利用 NSD 7T fMRI 数据集进行表征相似性分析(RSA)。随后通过招募 25 名参与者开展行为异常检测实验,建立三元组感知可达性的计算权重,据此构建行为优先化的场景图模型。后续分析依次考察该模型的增量预测能力、实体与关系的统计解离度、视野对齐特征,并扩展至非人灵长类(Triple-N 数据集)电生理数据的跨物种对比,评估结构化表征在视觉层级中的对应关系。
方法
神经影像数据来源于自然场景数据集(NSD,包含 8 名被试的高分辨率 7T fMRI);场景图数据来源于 PSG 数据集(含 47,636 张图像及 275,371 个三元组,其中 28,962 张图像与 NSD 重叠)。使用 RotatE 算法在复数向量空间将关系建模为头实体到尾实体的旋转变换,实部与虚部拼接后每个头实体、关系、尾实体均为 200 维向量,单个三元组共计 600 维。独立行为实验招募 25 名健康成人,针对 240 张自然图像中的 720 个三元组执行不一致成分判断任务;依据距注视点距离、实体面积、视觉显著度及关系类别拟合回归权重,选出各图像感知权重前 1–6 个三元组,主分析采用 top-3 平均模型。
皮层表征分析采用 RSA、偏相关分析、全脑 searchlight 以及基于脊回归的体素编码模型,并设置基于物体类别标签的共现模型(object2vec)、预训练视觉网络(VGG19)及预训练句子嵌入模型(MPNet)作为对照。跨物种比较采用 Triple-N 猴 IT 皮层 Neuropixels 探针记录数据,在 NSD、Triple-N 与 PSG 共有的人猴重叠刺激子集(412 张图像)上对比 VGG19 与 top-3 模型的 Deming 回归斜率,分析仅纳入三元组编码相关系数为正的神经单元或皮层体素。
主要结果
-
三元组模型优于物体共现模型,并提供独立于深度视觉和语言模型的增量信息。 在三个高级视觉通路区域(腹侧、外侧、背侧 stream),无权重三元组模型的表征相似性较 object2vec 模型高 Δ = 0.055,但低于 VGG19(低 0.034)与 MPNet(低 0.043)。行为优先的 top-3 模型相比无权重模型进一步提升了 0.023,但在绝对相似度上仍略低于 VGG19 与 MPNet(分别差 0.011 与 0.013)。在控制 VGG19、MPNet 与 object2vec 后的偏相关分析中,top-3 模型的偏相关系数在多个高级视觉区仍显著大于零,表明其提供了独特的结构化语义信息。
-
行为感知可达性具有跨被试一致性与跨图像泛化性。 行为实验中不同被试间的选择一致性为 0.6655,显著高于置换检验基线。回归分析显示,实体尺寸更大、视觉显著性更高、距离注视中心更近以及出现频次更高的三元组,其行为辨别正确率显著更高;空间几何关系与动作非几何关系在错误率模式上存在分化。由独立样本拟合的行为权重能够稳定提升对另一批被试神经数据的预测效力。
-
实体表征与关系表征在皮层层面表现出统计解离。 偏相关分析显示,下颞叶(IT)与顶内沟(IPS)沿线对实体信息的解释权重更突出,而外侧顶叶皮层(LPC)则同时呈现实体与关系的显著独立贡献。在语义子类对比中,非几何/几何关系以及室内/室外实体对比在皮层呈现特异性分布,其中枕叶位置区(OPA)的室内—室外偏好沿腹背轴呈现显著梯度变化(r = 0.281,p < 0.001)。
-
结构化模型保留了空间视野信息。 依据物体在图像中的空间位置分别构建左、右视野三元组模型,模型能特异性预测具有对应对侧视野偏好的皮层体素,在多个视觉通路及类别选择区均观测到显著的“模型×视野”交互作用;对于上、下视野,则表现为下视野模型的整体预测效力占优,未表现出对称的交叉偏好。
-
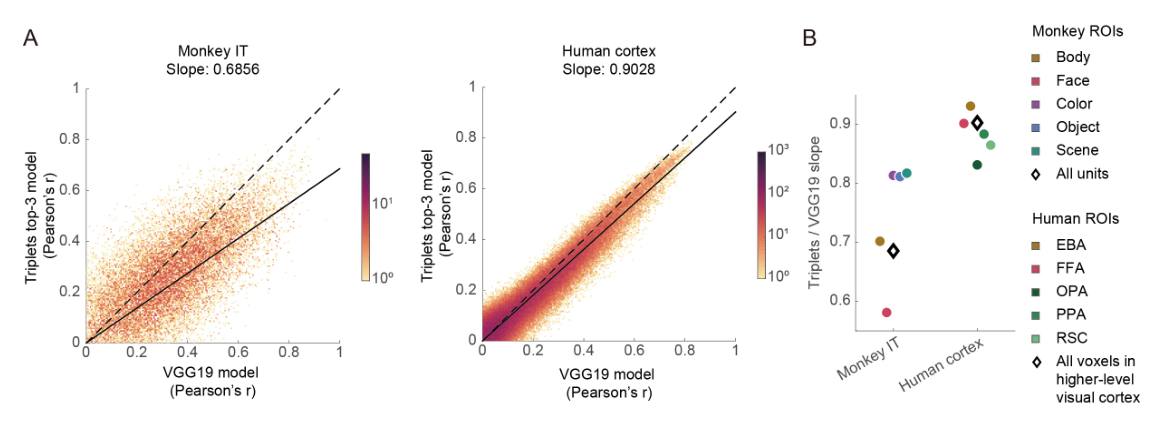
跨物种比较体现了相对模型拟合差异。 VGG19 对 top-3 编码相关性的 Deming 回归斜率在猴 IT 皮层为 0.686,在人类高级视觉皮层为 0.903,表明三元组模型在人脑表征中的相对权重高于猴脑。该差异在面孔和身体选择区尤为显著。由于分析限制在三元组预测为正的单元,且两物种间记录技术(fMRI 体素 vs 电生理单/多单元)与刺激子集存在差异,该结果主要反映当前模型在特定数据集下的拟合表现。
图注解读
图 1 · RotatE 与基础神经对应
(a,b) 把图像标注转为实体和关系向量;(c) 比较多 ROI 的 RSA。三元组超过 object2vec 支持关系结构的贡献,但 VGG19/MPNet 更高的条形提醒不要写成“三元组是最佳场景模型”。
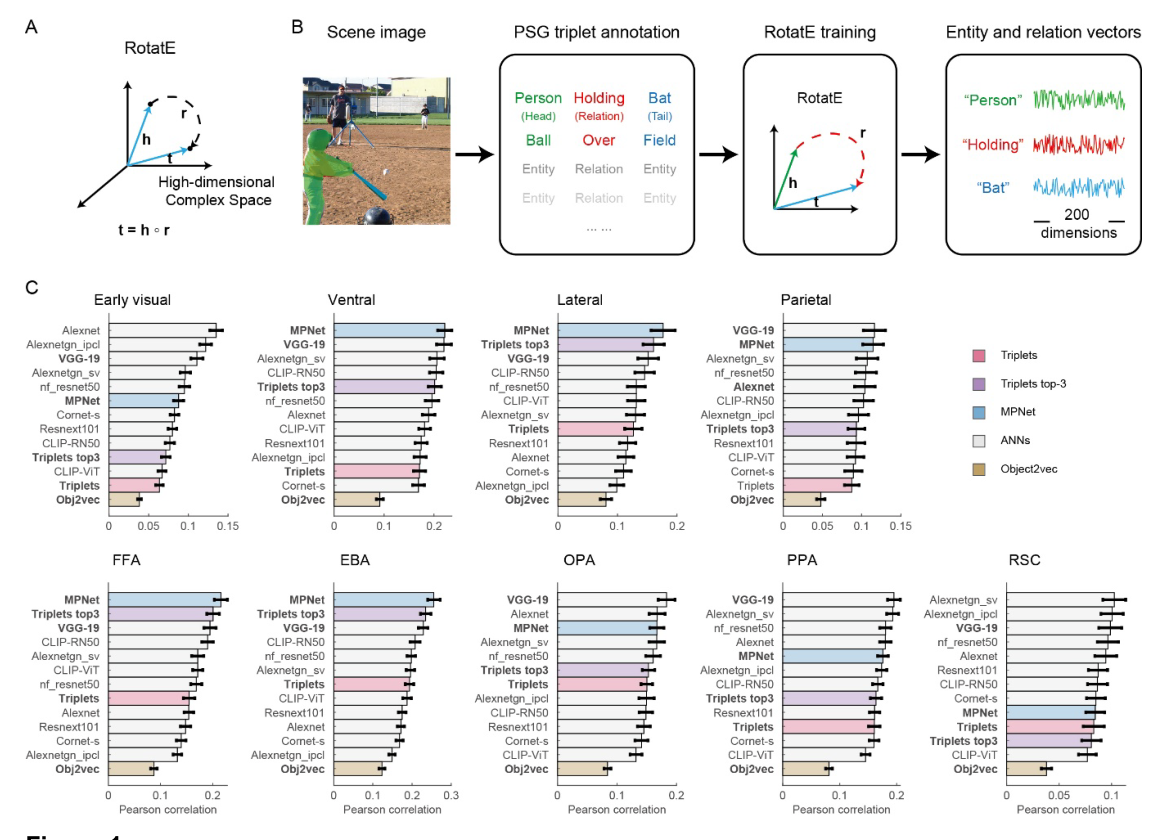
图 2 · 三元组的感知可达性
行为任务要求找出不一致成分;一致性、视觉特征和关系嵌入共同用于构建权重。关系类型的几何/非几何划分是模型特征,不是已证实的皮层分类边界。
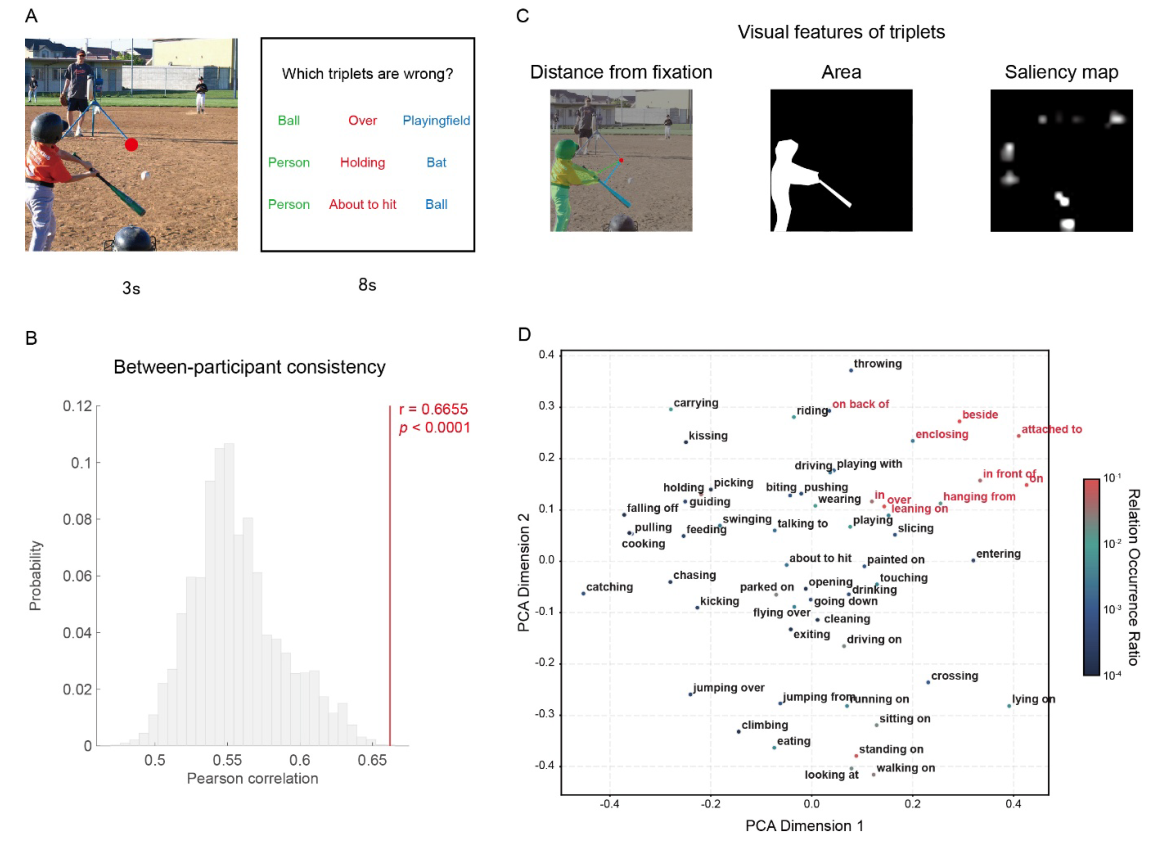
图 3 · 行为优先化改善预测
top-k 曲线在多个高阶 ROI 于 k≈3 附近较好,searchlight 显示改善集中于高阶视觉、LPC 与梭状区域。k 是按预测表现选择的模型参数,后续结论应与这一选择共同理解。
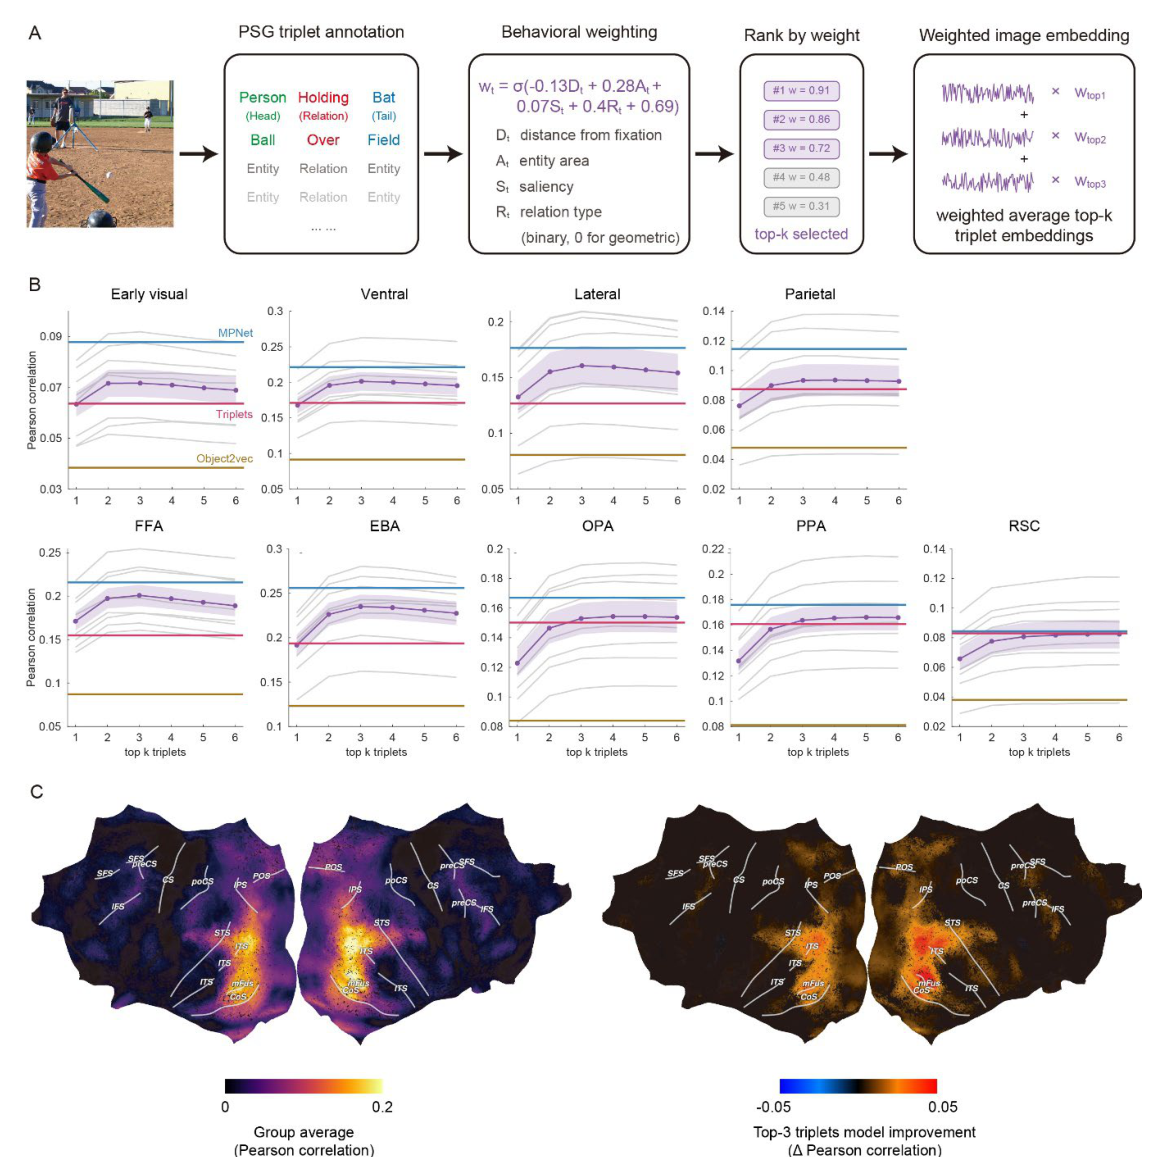
图 4 · 实体与关系的偏贡献
绿色实体与红色关系在皮层图上部分重叠,ROI 偏相关显示 EBA/FFA 等也有不同组成。可分解指统计模型能区分增量贡献,不是完全独立的神经编码或解剖模块。
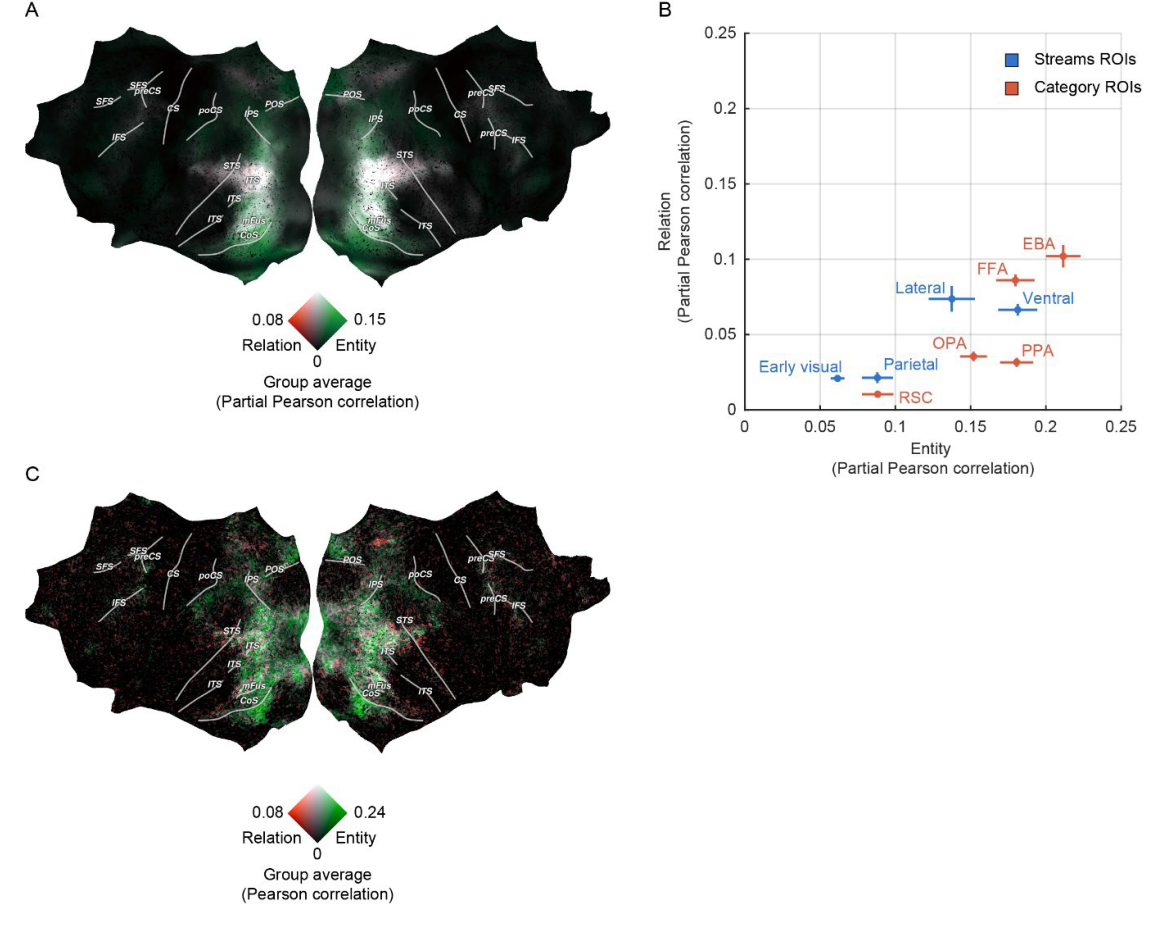
图 5 · 视野特异预测
左右匹配点偏离对角线并出现交互,说明局部关系信息与视网膜位置相连;上下结果主要是下视野整体优势,不能将两维都概括为视野匹配。
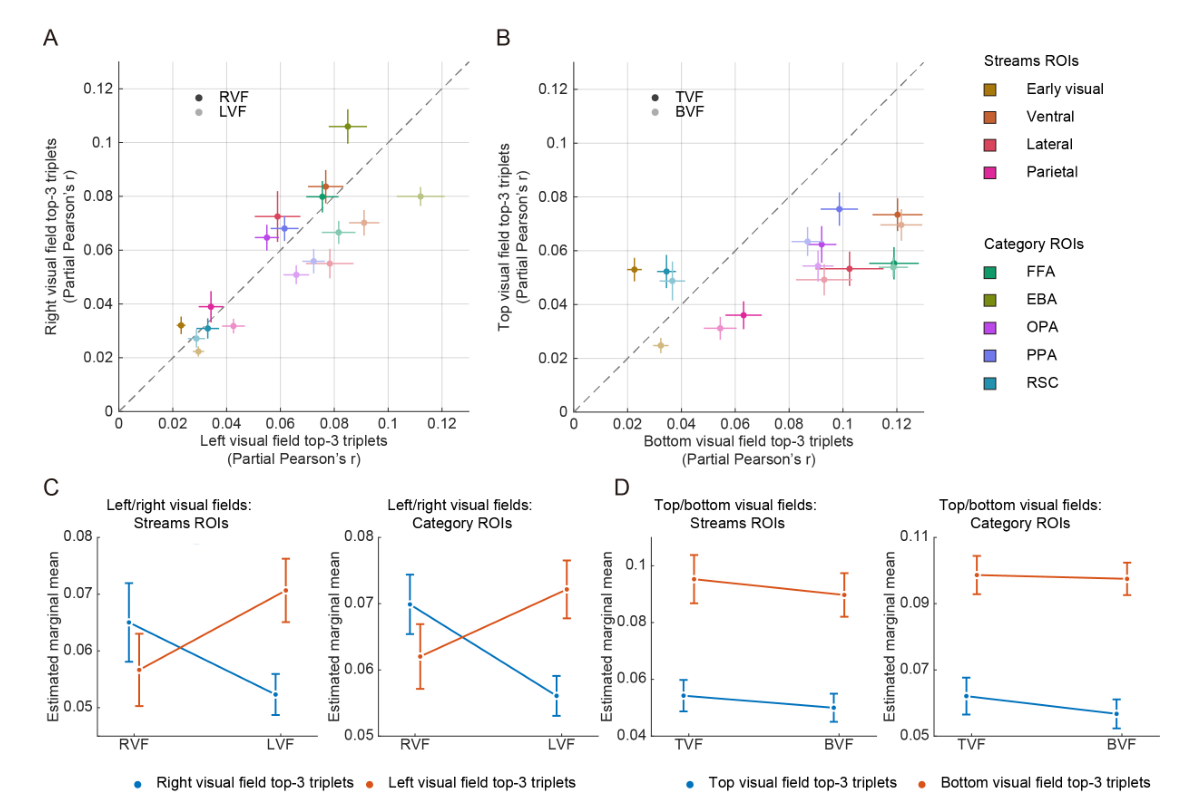
图 6 · 定向语义对比与 OPA 梯度
非几何/几何关系及室内/室外实体对比展示模型的可检验用途。OPA 梯度是基于编码预测和组级分析的解释性结果,作者也将其视为 heuristic,需要独立实验验证。
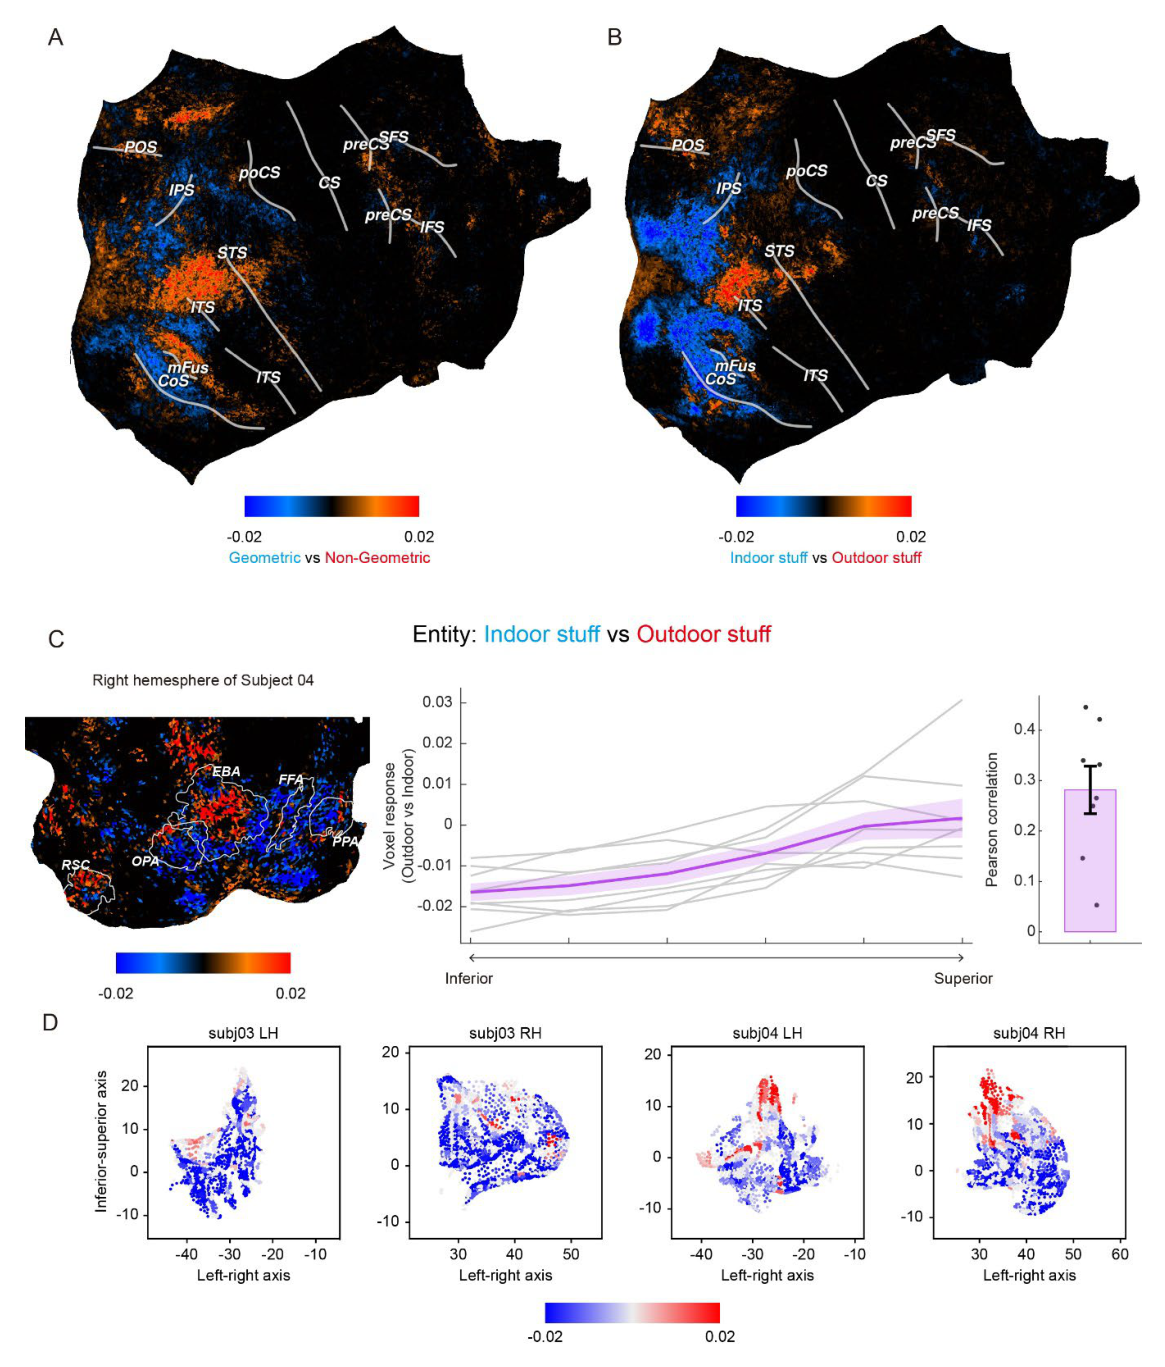
图 7 · 猴 IT 与人高级视觉皮层的相对模型对应
两个物种的斜率均小于 1,猴更低;区域排序也不同。散点只含三元组预测为正的单元/体素,斜率不是全样本固定效应,更不能直接换算为关系语义“含量”。
讨论
本研究的理论意义在于将复杂的场景语义表征细化为可定量加权、具有空间对应关系的结构化三元组,表明客观环境中的关系信息需经过人类注意和认知可达性筛选后才能有效匹配神经表征。
该研究的边界包括:第一,RSA 与体素编码模型仍受限于底层图像统计特征、场景图手工标注偏倚及计算模型的表征容量;第二,top-3 筛选阈值、关系语义分类及 OPA 轴向梯度等发现属于特定数据集下的模型拟合结果;第三,行为实验任务与扫描任务在注意状态和时间尺度上并不完全一致;第四,跨物种比较受限于成像模态(fMRI 体素 vs Neuropixels 神经元采样)和刺激子集规模,相对拟合斜率不能否定非人灵长类处理空间与社会关系的能力。未来研究需结合动态场景刺激与眼动追踪进行进一步验证。
一句话总结
该研究表明基于行为可达性加权的场景图三元组能够为人类高级视觉皮层提供具备空间拓扑特征与可分解性的结构化语义表征,为解析复杂视觉场景的神经计算机制提供了计算模型框架。