Prince, Wang, Fel, Jagadeesh, Vaziri, Alvarez, Livingstone & Konkle · bioRxiv 预印本(2026-08-20 发布,未经同行评审) · 2026 · DOI: 10.64898/2026.08.16.745063
这篇文章利用模型生成的图像扫掠序列替代传统的自然图像预测分数,用以区分不同的视觉编码模型:十种在自然图像预测上表现接近的深度神经网络(DNN),沿各自拟合的编码轴生成刺激后,对 25 个猕猴视觉皮层位点的参数化控制表现出显著分化。该结果表明闭环刺激能够揭示传统静态基准所掩盖的模型差异,但尚未证实对抗训练或特定的输入梯度频谱结构就是脑对齐的唯一机制。
研究背景
以自然图像预测神经反应,是深度神经网络应用于视觉神经科学的主要评估范式:研究者从网络特定层提取特征,利用线性映射拟合视觉皮层活动,以比较不同网络架构和训练目标的预测表现。随着领先模型的预测分数逐渐接近且趋于饱和,此类评估方法面临辨别力不足的瓶颈。自然图像中物体的轮廓、纹理和语义类别等属性高度共变,不同模型即使依赖截然不同的特征组合,也可能对同一批自然图像产生相似的响应预测。因此,较高的预测相关性不足以证明模型切实捕捉到了神经位点依赖的内在调谐维度;模型可能准确描述了既有分布内的图像变化,却难以预测实验者主动干预图像后的神经响应。
这一局限推动研究视角从“模型拟合精度评估”转向“模型干预方向对神经活动的实际调控效力”。若拟合得到的编码轴确实反映了神经位点的调谐特征,沿该轴逐级调整图像特征,应当能够按预测方向增强或减弱实际放电。反之,若在自然图像预测上表现相当的模型在此类检验中产生分化,则说明传统基准掩盖了具有生物学意义的模型差异。在此过程中需要排除两类替代解释:控制失败可能源于跨天记录的神经信号波动,也可能受图像合成算法及优化约束的影响。因此,重播图像的测试稳定性、每个模型专属的刺激生成逻辑,以及不同刺激集合间的对比,均是合理解释控制表现的关键前提。
本文据此将校准记录、编码轴拟合、图像合成与体内回播整合成闭环系统,在五只猕猴的 25 个视觉皮层位点上系统测试了十种模型,并检验了对抗训练、输入梯度结构与神经控制表现之间的关联。研究进一步对比了针对特定位点和模型生成的定向刺激与汇集的大规模混合刺激集,探讨诊断效力究竟来自刺激数量还是定向假设检验。需要指出的是,本文为未经同行评审的预印本,记录位点多数属于多单元活动通道,且皮层采样数量有限;参数控制的有效性仅针对当前测试的编码轴及刺激范围。因此,该工作提供了一种比被动图像拟合更具区分度的模型评估方法,而非确立了某种训练范式的唯一生物学合理性,亦不能直接推论模型完整解释了下游知觉行为。
研究思路
研究采用校准—拟合—合成—控制四阶段闭环。每个模型、每个位点先得到独立编码轴,再用 axis-aligned feature accentuation 生成从抑制到增强的图像序列并回播给动物。随后比较自然图像预测与参数控制,分析对抗训练、对抗敏感性和输入梯度频谱,最后检验个性化刺激与大而杂的 pooled benchmark 哪种更能区分模型。
方法
五只清醒猕猴在注视下完成 RSVP,图像呈现 250 ms、间隔 250 ms。R、P 分别使用 aIT 微丝阵列和 cIT 浮动微电极阵列,L、T、V 使用 Neuropixels,目标覆盖 V3、V4、STS、cIT、aIT。每猴选 5 个可靠且调谐不完全冗余的记录位点,共 25 个;位点多为通道级多单元活动,不能全部称为单神经元。
校准集 969 张图像,774 张训练、195 张验证。十种 DNN 各自经 ridge 与交叉验证层选择拟合编码轴。每个轴从 10 张种子图生成 11 级刺激,共 2,500 条扫掠、27,500 张控制刺激,目标覆盖自然响应范围下方 25% 至上方 50%。控制实验在校准后 4–8 天开始。校准验证集同时用于层选择,因此相应 encoding 分数是选择后的验证分数;另有跨 session 重播图像检查泛化。
主要结果
- 自然图像高分不保证参数控制。 一个 aIT 位点的 ResNet50 编码轴在自然图像上 r=0.87,跨 session 重播达 0.95,但控制刺激仅 r=0.28、控制斜率 0.05;控制刺激重复响应仍可测量,排除了“完全没有信号”的简单解释。
- 模型在控制条件下显著分化。 十模型自然图像平均 encoding r=0.67±0.07,控制降至 0.45±0.15;九个训练模型的自然预测均值范围仅 0.67–0.71。CLIPAG 与 ResNet50-Robust 两种对抗训练模型整体控制最好,并在不同动物和脑区保持趋势,但位点间差异很大。
- 对抗敏感性不是充分解释。 全模型中敏感性与控制相关,去掉两个对抗训练模型后该关系消失(site-level 斜率相关 r=-0.05)。输入梯度频谱集中度仍保留预测(r=0.26,p=0.0006;模型均值 r=0.93),并有留出模型/位点/动物分析支持,但仍有大量未解释方差。
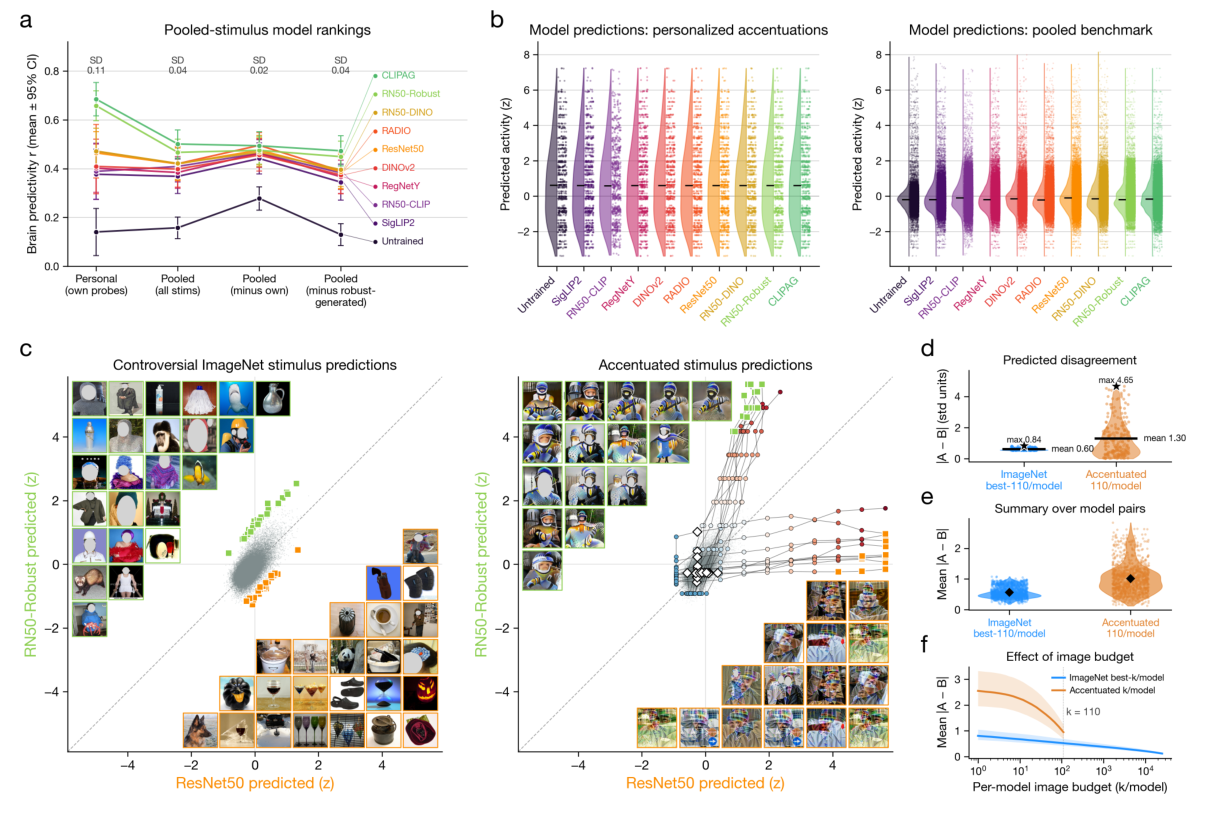
- 个性化控制刺激比 pooled 图像更有诊断力。 个性化刺激、全 pooled、去掉本模型刺激、去掉对抗模型刺激四种 regime 的跨模型 SD 为 0.11、0.04、0.02、0.04。与预算匹配、刻意挑选的最大分歧 ImageNet 图像相比,accentuation 在 90.5% 的通道—模型对组合中产生更大预测分歧,说明其价值在针对性而非单纯图像数量。
图注解读
图 1 · 四阶段闭环设计
校准记录、逐模型编码轴、特征增强和回播记录构成闭环。底部列出十模型,提醒比较是在同一批位点上进行,但每个模型使用自己生成的控制刺激。
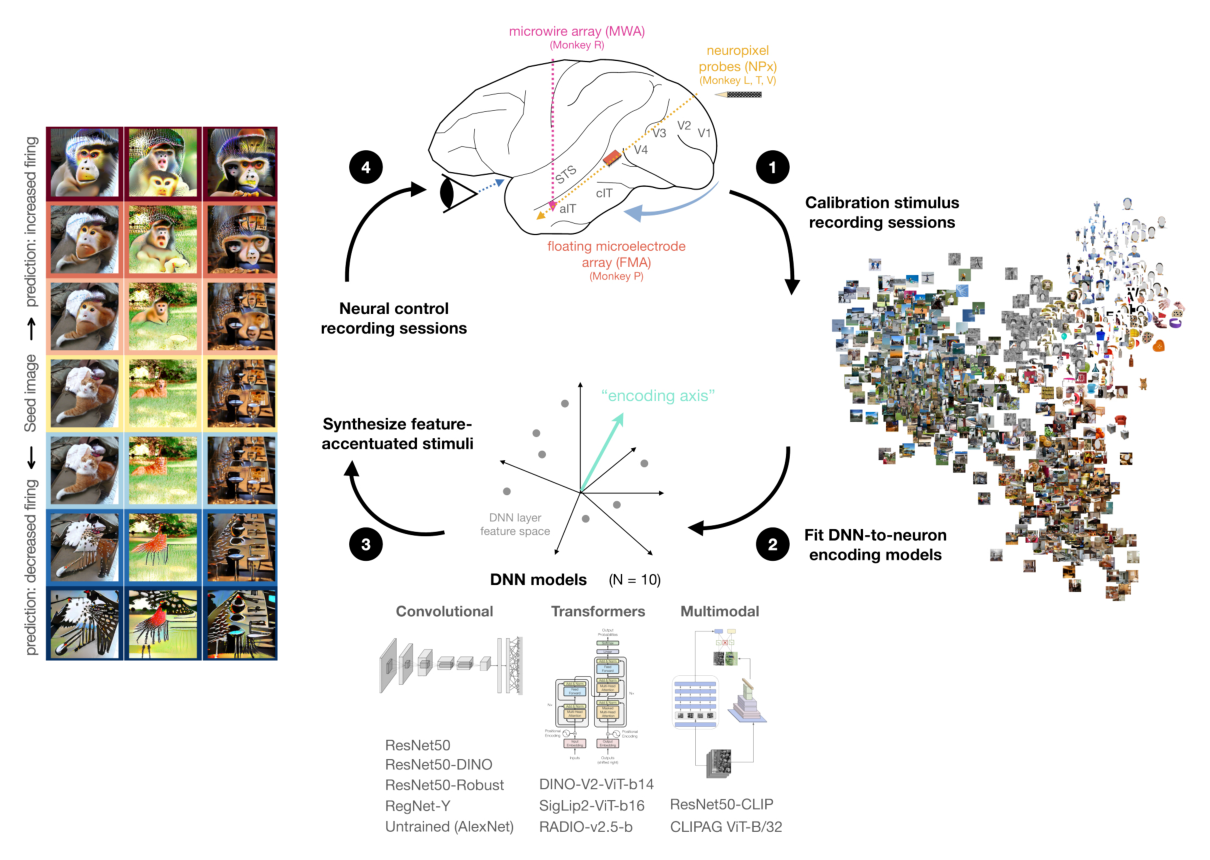
图 2 · 编码轴变成图像扫掠
(a–c) 从种子图沿编码轴优化到不同预测响应;(d) 显示 27,500 张刺激超出自然图像分布的范围;(e) 展示同一神经位点在不同模型下产生的外观差异。图像可辨认并不保证其神经效应符合预测。
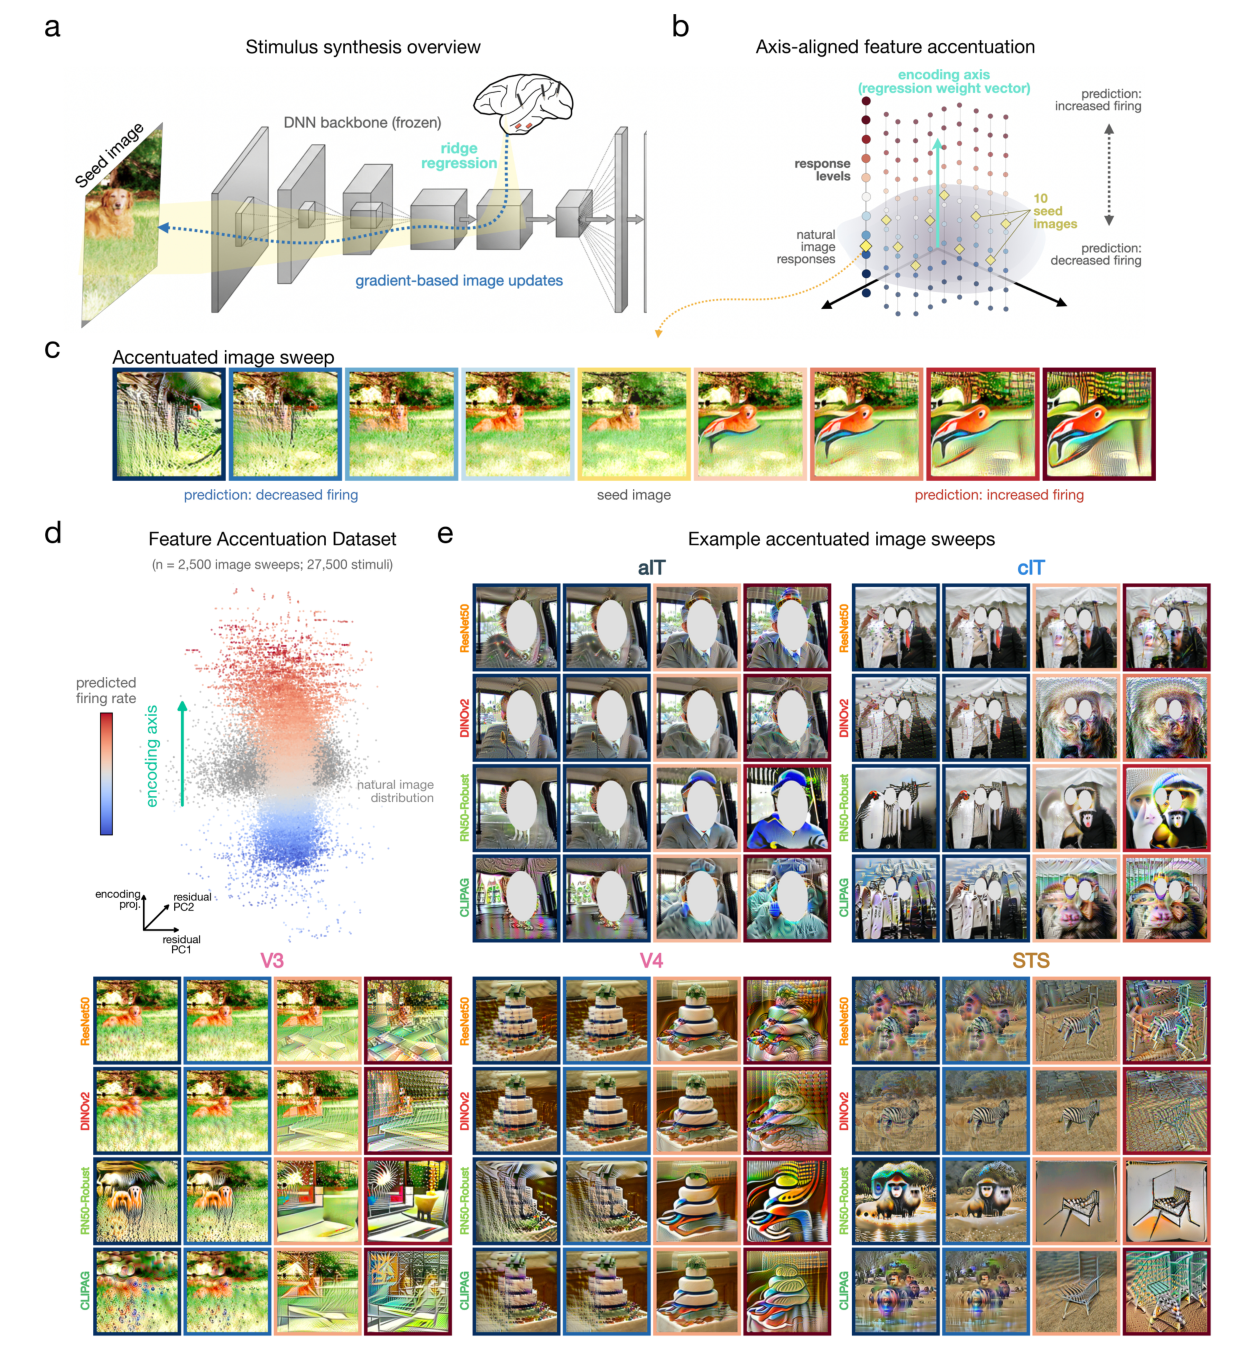
图 3 · 同一位点的预测—控制分离
自然图像拟合和跨 session 重播都接近对角线,控制扫掠却近乎平坦。该例直观说明插值成功与恢复调谐函数不是同一证据层级。
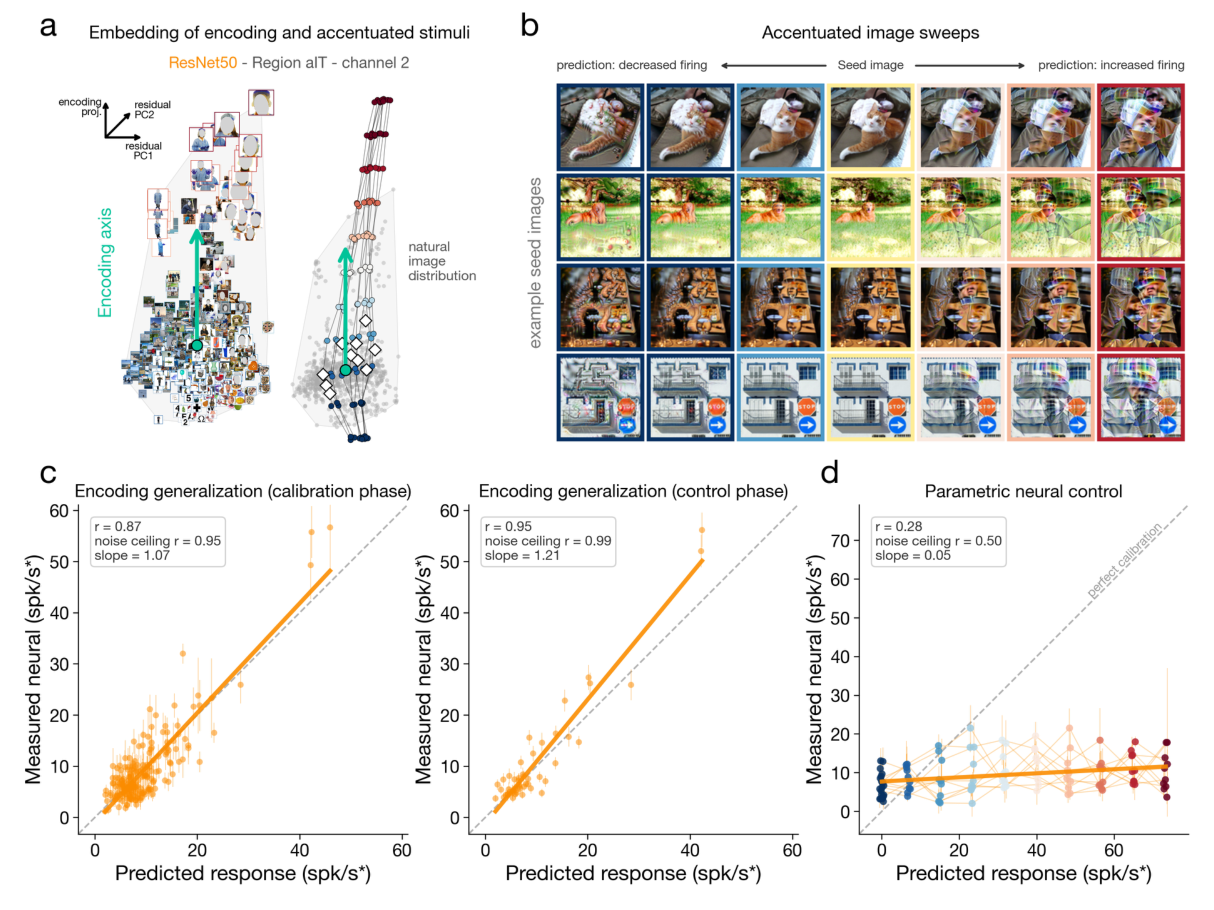
图 4 · 十模型及五只动物的汇总
自然 encoding 柱形接近,控制柱形拉开,对抗训练家族下降较少。按动物/脑区拆分显示趋势有一致性,但每猴只有 5 个位点,不能视作大样本脑区排名。
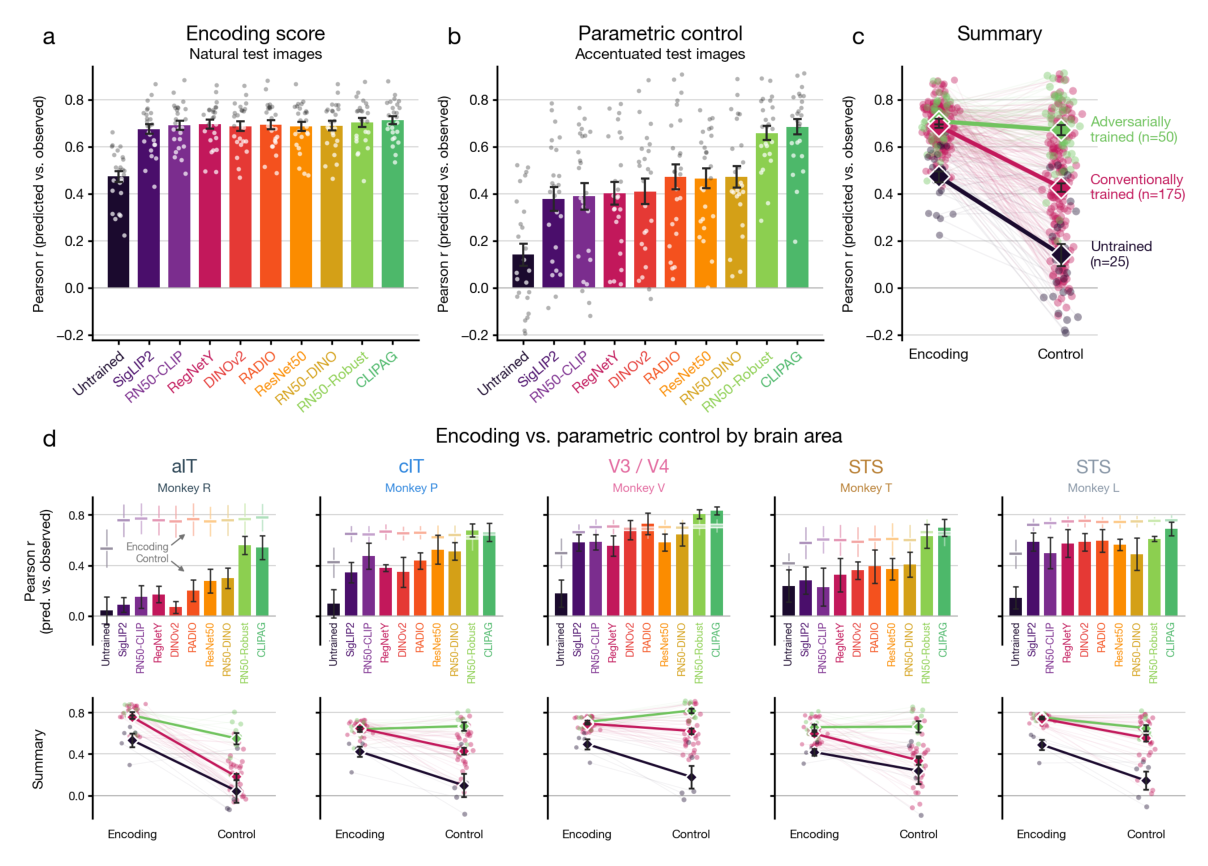
图 5 · 输入梯度结构比对抗敏感性更有预测力
对抗训练模型的梯度和增强图像更集中、低频;去掉它们后,对抗敏感性不再预测控制,频谱参与比仍保留相关。该指标是可预先计算的候选标志,不是已确认的神经机制。
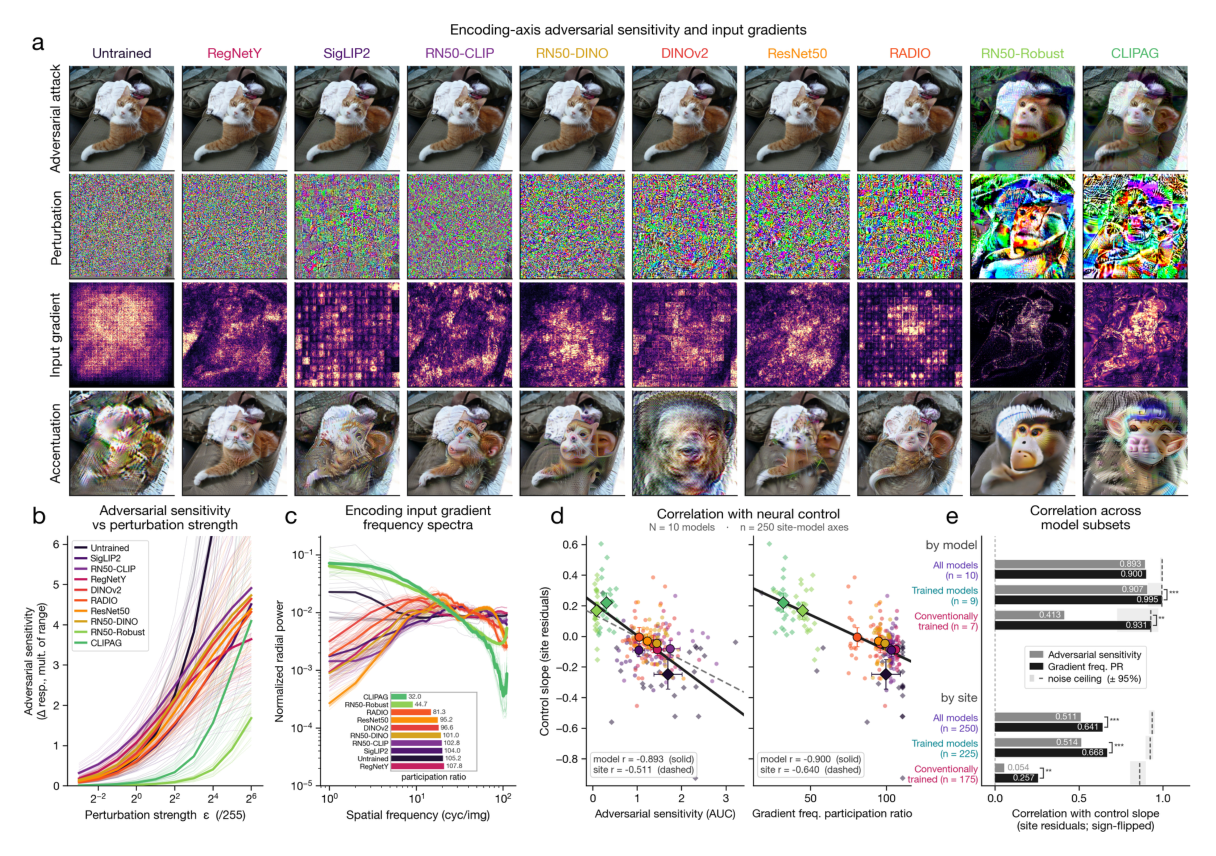
图 6 · 个性化刺激的基准效率
pooled 刺激压缩模型差异,个性化 accentuation 保留最大分歧;与精心挑选的自然图像相比,控制刺激用更少图像拉开模型预测。这里的“分歧更大”是诊断效率,不自动等于脑对齐更好。
讨论
参数化神经控制把模型评价从观察预测推进到输入干预:实验者设置模型指定的图像,检验其预测神经效应是否发生。这比继续增加同质自然图像更能暴露模型在输入空间外推时的错误,也为选择后续记录实验提供量化依据。
仍需限制结论。25 个位点不是广泛皮层抽样,且不少为多单元通道;特征增强只沿一个编码轴,失败可能来自轴外结构、图像合成约束或位点选择,不能概括为整个模型完全不理解视觉皮层。对抗训练与梯度频谱优势可能相关但机制未确定,作者也明确警告不要把频谱当作核心因果机制。最后,control r 高说明对模型自定义干预的预测成功,不等于模型解释了所有自然知觉或下游行为。
一句话总结
闭环特征增强揭示了自然图像基准不可见的模型差异,并提供“用模型自己的预测去检验神经控制”的严格评价路径;它更适合作为模型筛选和实验设计工具,而不是新的单一脑对齐排行榜。