猕猴是人类视觉加工研究的重要动物模型,但恒河猴的不变物体识别行为与人类的定量相似程度长期缺乏系统验证。该研究通过让两只猕猴与大规模网络人类被试完成相同的 276 个二选一物体识别任务,发现猕猴不仅平均识别表现与人类相当,其物体混淆模式与人类高度相关,且在统计上落入人类个体差异范围内;而基于像素和 V1 模型的低层表征对照则被显著排除。这为灵长类动物模型在物体识别领域的有效性提供了系统的定量行为证据。
研究背景
人类能够在位置、尺度、视角和背景变化时迅速识别物体,猕猴则长期承担研究这项能力的动物模型角色。两者视觉皮层的解剖与功能对应,为这种使用提供了基础;低级视觉中对比、颜色和朝向辨别的定量比较,也积累了跨物种相似的证据。然而,高级物体识别还有一个不能靠解剖相似补上的环节:猕猴完成任务时,是否遇到与人相同的辨别困难?动物经过训练能够达到高正确率,只说明它学会了解题,并不排除它依赖人类较少使用的特征或策略。即使两者平均成绩一致,也可能分别在完全不同的图像和物体对上犯错。
这一缺口在动物模型与计算模型同时发展的背景下更加明确。其他动物也能表现出一定的变换容忍性,说明“能跨视图辨别”本身不足以证明猕猴具有特殊的人类可比性;深度卷积网络开始取得接近灵长类的识别成绩,又使行为比较可以加入明确的表征模型对照。因此,需要把平均正确率拆解为大量任务上的敏感度模式,并问哪些物体对在不同系统中共同容易或共同困难。比较还必须排除图像记忆:若测试图与训练图过于接近,动物只需匹配已见样本,就可能获得看似不变的识别能力。人类个体之间本来存在的差异,则应成为判断物种差异大小的参照。
本文让人和两只猕猴完成同一套二选一任务,用渲染物体在视角、位置、大小和自然背景上的变化构成刺激,再通过留出的新图像检验泛化。二十四个物体形成二百七十六个配对任务,其敏感度模式被用于比较人、猴与像素、早期视觉及层级识别模型。研究由此检验猕猴的混淆结构能否落入人类个体差异范围,而不只看总体成绩是否接近。结论仍受任务范围约束:每类只有一个三维实例,测量聚焦短时呈现下的视觉辨别,不能直接外推到跨实例语义分类、所有精细识别任务或学习速度。统计上未能区分人猴,也不等于证明两者机制完全相同;它提供的是采用猕猴研究这类核心识别行为的定量依据。
研究思路
该研究重点排除了受试者依赖简单“图像模板匹配”完成任务的可能。作者利用 3D 模型渲染生成多视角合成图像,对每个物体的二维位置、三维视向及观察距离进行随机采样,并将前景叠加于多变的自然场景背景中,确保受试系统必须依赖变换容忍性表征完成识别。任务采用"核心物体识别"的操作定义:单次注视、图像呈现仅 100 ms、位于注视中心附近,不给反馈,从而排除特征注意策略和反复审视的可能。比较逻辑分三层:第一层比较成绩水平(学习速度、对新图像的首次泛化);第二层把 276 个二选一任务的 d′(无偏敏感度)排成"行为成绩模式",用去噪秩相关(consistency)量化猴、人、机器三者模式的相关;第三层用人类被试个体差异做参照系——如果猴与人类总体的不完美相关只是"两个个体的正常涨落",那么猴应该落在人类个体分布之内、统计上无法与人区分,而低层视觉模型应该被这个分布剔除。研究进一步以像素和 V1+ 模型作为低层阴性对照、以 HMAX 与深度卷积神经网络(CNN)作为计算模型对照,从表征计算层面验证了跨物种混淆模式的相似性。
方法
动物为两只成年雄性恒河猴(M 约 6 kg,Z 约 12 kg)。刺激来自 24 个基本水平(basic-level,Rosch et al., 1976 定义)物体(从 64 个可靠命名的物体集中随机抽成 3 组、每组 8 个,抽样偏向人类混淆模式丰富的组):每个物体渲染 2400 张测试图像(每物体 100 张,1024×1024 灰度、方形光圈)和 4800 张训练图像(每物体 200 张),训练/测试集的图像空间采样密度经像素距离分析验证接近"理想泛化"条件。行为范式为二选一匹配:猴 M 在头部固定、眼动仪(Eyelink II)监控下注视 200 ms 触发中央 6°×6° 测试图(100 ms),随后在 ±6° 偏心处出现两张标准视角选项图,用注视选择图 700 ms 报告;猴 Z 不做手术、头部自由,用触屏触摸报告。人类数据全部来自 Amazon Mechanical Turk:605 人合计 69,000 次试验(每任务约 250 次)汇成"人类池",另招募 33 人作为个体样本(每组 8 物体 16/16/12 人,人均约 3003 次试验,以拆半信度显著大于 0.5 为纳入标准),任务与猴子逐字相同、276 个任务逐试次随机穿插,约 1% 疑似乱猜的被试被剔除。分析上用信号检测论的 d′ 作为无偏成绩(限幅 [0,5]),276 维 d′ 向量即为"行为成绩模式";信度用拆半相关的 Spearman–Brown 校正估计;两个模式之间的一致性(consistency)用去噪秩相关计算;机器模型(像素、V1+、HMAX、CNN2013)在同一批图像上提取特征、用最大相关分类器经两折交叉验证 50 次置换给出各自的 276 维模式。
主要结果
- 猴子几天学会一个新物体,之后与人持平且不再随经验变化。每组 8 个新物体直接上全变化图像,约 1000–2000 次图像呈现(约 10–15 个行为场次)即达高成绩;而 15 名有足够纵向数据的人类个体一开始就是高成绩,且成绩不随无监督曝光次数变化,说明人类对这些物体早已"训练有素"(图 2A–C)。
- 猴子不是在背图像。全部 276 个任务训练达标后换用保留测试图像,两只猴首次见新图的正确率分别为 88%(M)和 85%(Z);首次成绩与该图到最近训练图的像素距离无显著相关(M:r=0.036,p=0.07;Z:r=0.010,p=0.63),训练/测试两套图像集的混淆模式一致性高达 0.9566/0.9489,后续重复曝光也不再提升成绩(图 2D)。两猴共采集 106,844 次试验,人类池 69,000 次。
- 混淆模式高度共享。276 维成绩模式矩阵上人猴定性相似,如(骆驼,狗)和(坦克,卡车)都是两物种的易混对(图 3A);以人类池为金标准,去噪一致性为:合并猴 0.78±0.007(单猴 M 0.80±0.009、Z 0.66±0.005),远高于像素 0.37±0.003 和 V1+ 0.52±0.004;CNN2013 达 0.86±0.006,高于腹侧流(ventral stream)替代模型 HMAX 的 0.55±0.004(图 3B、C)。
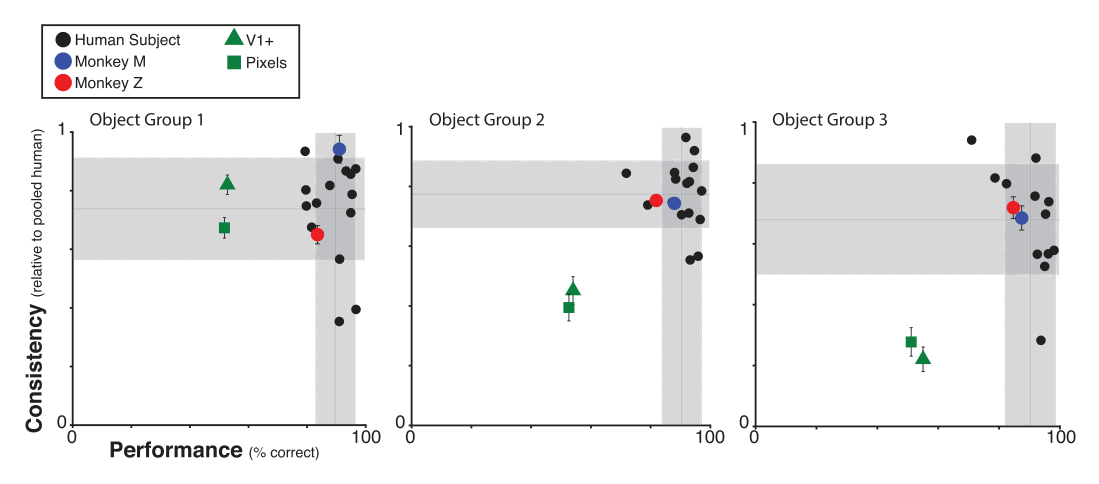
- 猴落在人类个体分布之内,低层模型落在分布之外。人类被试之间存在显著的个体差异(个体与人类池的平均一致性仅 0.74/0.77/0.68,三组两两个体间中位数 0.76),以个体分布为参照,两只猴与人类个体统计上无法区分(M:p=0.4/0.21/0.22;Z:p=0.16/0.22/0.27,Fisher 精确检验),而像素和 V1+ 在三组中的两组被剔除(V1+:p=0.30/0.03/0.03;像素:p=0.17/0.02/0.03);CNN2013 三组都无法剔除,HMAX 被剔除一组(图 4)。即使把两猴合并与"两名人类合并"的抽样分布比,合并猴也无法被拒绝(图 3C 虚线阈值)。
- 偏置不可比,d′ 才是可靠的行为指纹。用反应偏置指标 c 分析发现其跨被试一致性(个体对中位数 0.40)远低于 d′(0.76),即"倾向选哪个选项"的偏置远不如混淆结构稳定,故不是比较物种的可靠行为指纹。
图注解读
图 1 · 刺激图像与猴行为范式
原文图注:Figure 1. A, Two example images for each of the 24 basic-level objects, sampled from the test set (each row corresponds to a group of 8 objects). To enforce true object recognition behavior (rather than image matching) and tackle the invariance problem, we generated thousands of naturalistic images, each with one foreground object, by rendering a 3D model of each object with randomly chosen viewing parameters (2D position, 3D rotation, and viewing distance) and placing that foreground object view onto a randomly chosen, natural image background. B, Behavioral paradigm (for monkey M). Each trial was initiated when the monkey held gaze fixation on a central fixation point for 200 ms, after which a square test image (spanning 6° of visual angle) appeared at the center of gaze for 100 ms…
A 部分按三组、每组 8 个物体列出测试集示例,读者能直观看到同一物体在不同姿态、位置、背景下的变化幅度,理解为什么要强调"识别物体而非匹配图像";B 部分以猴 M 为例画出试次时间线(注视 200 ms → 测试图 100 ms → 左右两张标准视角选项图,注视选定图 700 ms 报告),并注明猴 Z 用触屏完成相同任务、答对给果汁、答错罚 1.5–2.5 s 停顿。这张图是理解后面所有行为数据的前提。
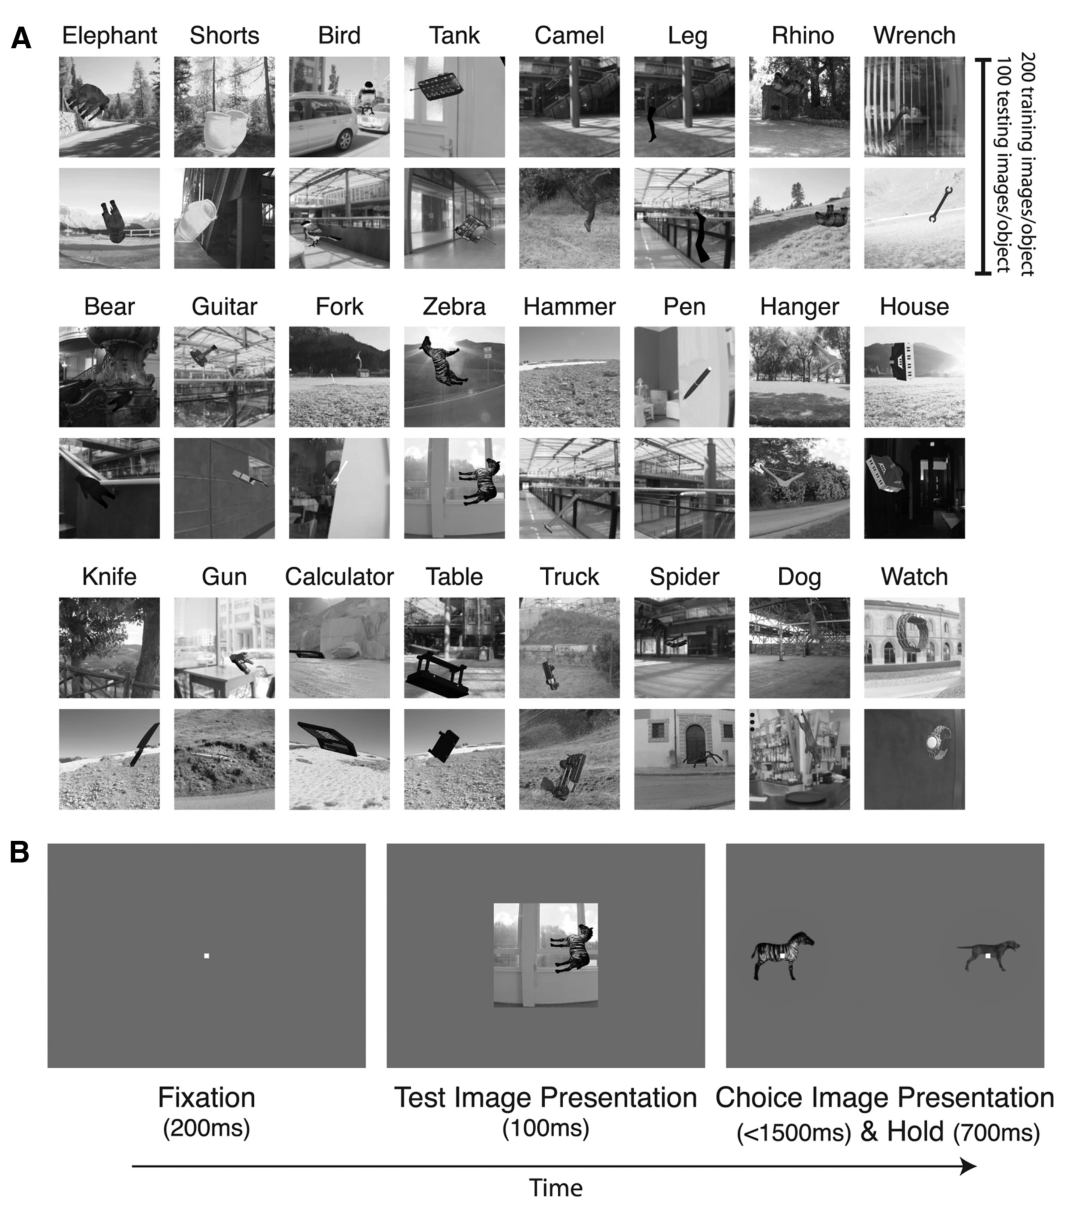
图 2 · 新物体学习速度与对新图像的泛化
原文图注:Figure 2. A, B, Learning of novel objects. For each monkey, performance relative to the human pool, quantified as a Turing ratio d′/d′ human pool (one-versus-all d′), for each of these 16 objects (colored dots) and the mean over objects (black line) are shown. For these 16 objects, animals were exposed to full-variation images in groups of eight objects and reached high performance in 1000–2000 image presentations per object. C, Performance relative to the human pool, quantified as a Turing ratio, of two monkeys and 15 unique individual humans subjects with sufficient longitudinal data on the same tasks (mean ± SE over subjects)…
A、B 面板分别追踪两只猴接触 16 个新物体时的相对成绩(以人类池的 d′ 归一),彩色点为单个物体、黑线为均值,曲线快速爬升到 1 附近说明每物体约 1000–2000 次呈现即可学成;C 把两只猴和 15 名人类个体制在同一坐标里,人类起点即高、随曝光无变化,猴达标后(Test 标记)也与人类持平;D 上图检验泛化是否依赖与训练图的相似度(首次成绩对像素距离回归,斜率不显著),下图用"理想泛化"替代集证明训练集并未把图像空间采得太密。这张图支撑结果 1 和 2,是排除"猴子只是过拟合/背图像"的关键。
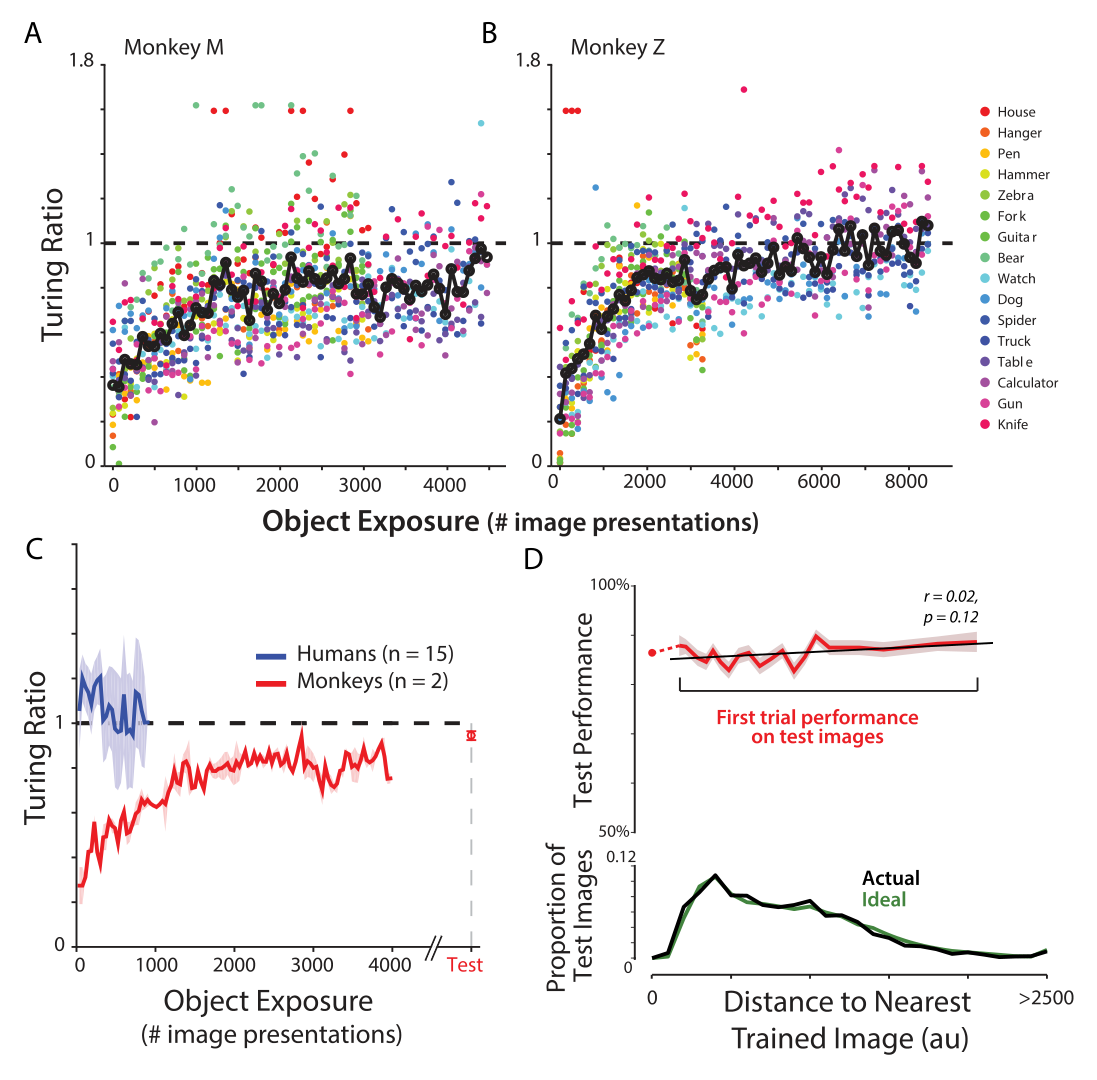
图 3 · 276 个任务的混淆模式及其跨物种一致性
原文图注:Figure 3. A, Pattern of behavioral performances for the pooled human and pooled monkey. Each 24×24 matrix summarizes confusions of all two-way tasks: the color of bin (i, j) indicates the unbiased performance (d′) of the binary recognition task with objects i and j. Objects have been reordered based on a hierarchical clustering of human confusion patterns to highlight structure in the matrix. We observe qualitative similarities in the confusion patterns. For example, (camel, dog) and (tank, truck) are two often confused object pairs in both monkeys and humans…
这是全文主图。A 把人类池和猴池的 276 维 d′ 模式各画成一张 24×24 对称矩阵(按人类混淆的层次聚类重排物体),两矩阵呈现清晰一致的深浅纹理对应;(camel, dog)、(tank, truck) 这类易混对在两物种同样成立;B 以散点把合并猴、像素模型对人类池的 276 个 d′ 逐一比较——猴的点沿对角线紧密排布,像素则明显偏离;C 给出量化的一致性柱状对比(合并猴 0.78、单猴 0.80/0.66、像素 0.37、V1+ 0.52、CNN2013 0.86、HMAX 0.55),虚线为人类个体对之间的一致性置信阈值;D 比较两只猴彼此的模式。它支撑结果 3、4 的核心结论。
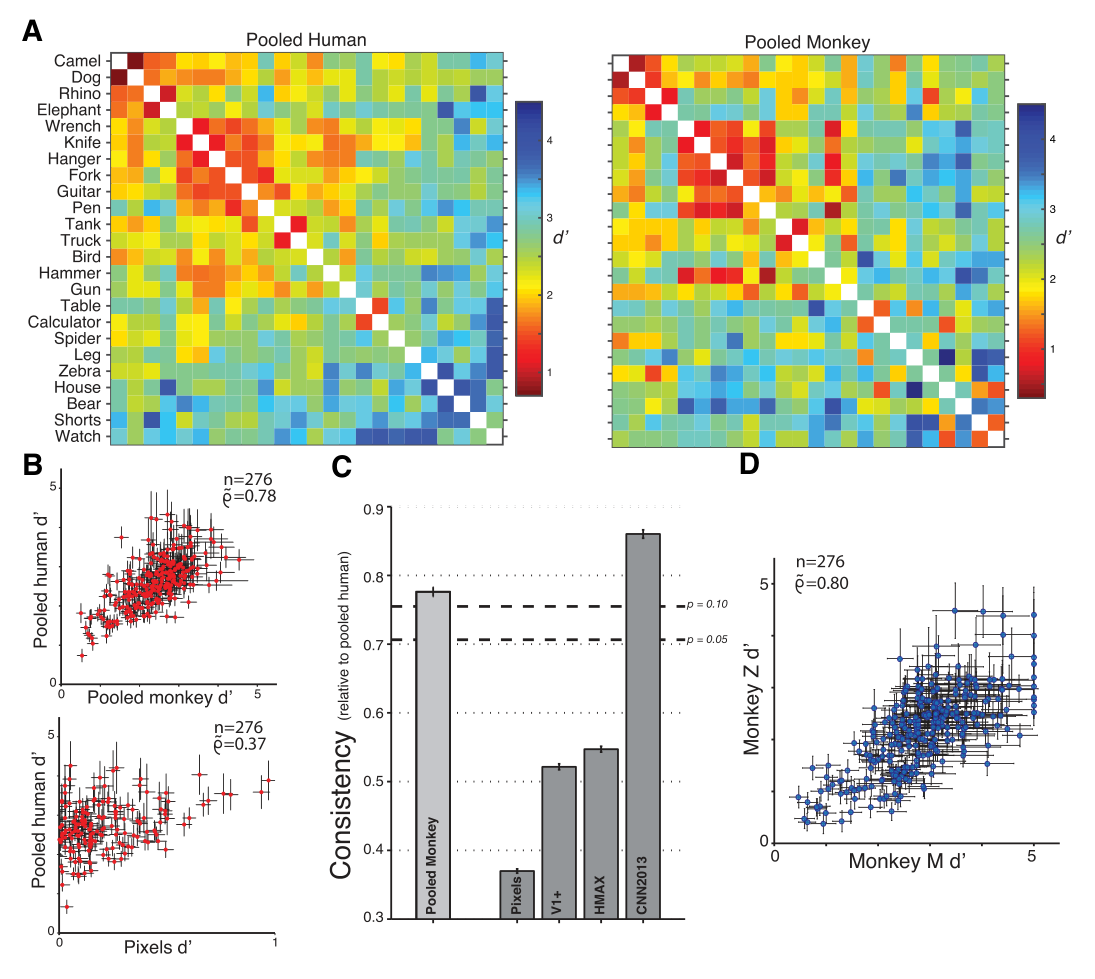
图 4 · 以人类个体差异为参照检验猴与机器
原文图注:Figure 4. Accounting for intersubject variability. For each of three groups of eight objects, the absolute performance and consistency of individual human subjects, individual monkeys, and machine features are shown. Error bars for consistency relative to pooled human (mean ± SD) are shown for individual monkeys and machine features for each group (error bars for monkeys are not visible in object group 2 because of small variability). The shaded gray areas indicate the distribution of performance/consistency over individual human subjects (mean ± SD)…
这张图回答一个关键质疑:"猴与人类池一致性不到 1,是不是物种差异?"作者把每只猴、每个机器模型的绝对成绩和对人类池的一致性,放到人类个体成绩/一致性的灰色分布带里看:两只猴都落在带内(p=0.16–0.4),像素和 V1+ 则在两组物体上掉出分布(p=0.02–0.03),CNN2013 三组都在带内、HMAX 掉出一组。读者需注意这只有 3×28=84 个任务、占图 3 全集的 30%,但正是"个体差异参照系"让"猴≈个别人"从定性说法变成统计检验。它支撑结果 4。
讨论
作者的解读分三步走。第一,行为层面的结论是"稳态相似":猴子学会任务后,成绩与混淆模式都与人类定量可比,且额外经验对两物种的稳态行为都没有可观影响——但这并不意味着两物种学习新物体的速度相同。第二,他们把这种行为相似与比较影像学的证据接上:腹侧视觉流在猴与人之间近乎完整保守(Mantini et al., 2012),IT 末端的物体类别表征在两物种间匹配(Kriegeskorte et al., 2008),于是提出人猴可能共享一套直接支撑基本水平物体知觉的神经"形状"表征。第三,CNN2013 能预测两物种共同的行为模式而 HMAX 和低层模型不能,提示当前高性能深度卷积网络可能恰好捕捉到了这套共享表征。局限方面作者说得很直白:猴只有 2 只,无法证明人猴绝对无差异,只能说现有检验有足够统计力剔除像素和 V1+ 这类模型、却剔除不掉猴;猴 Z 成绩较低(83.4% 对 M 的 89.2%)且模式信度较低(p<0.001),可能与其不受控的注视有关,两猴间的差异无法区分是真实个体差异还是效应器(眼动 vs 触摸)不同;另外每类别只有单一 3D 模型实例,结论只覆盖"3D 物体的视觉相似性判断",不能外推到跨实例的语义类别或从属水平辨别(如面孔倒置效应这类可能的物种差异,文中明确表示未检验)。
一句话总结
该研究将物种间的行为对比从总体平均正确率推进至辨别混淆的几何结构:猕猴与人类在识别难易程度与错误倾向模式上展现出高度一致的拓扑分布,为猴腹侧通路的神经记录与人类视觉加工的跨物种对应提供了扎实的行为基准。需注意其实验边界:任务局限于基本水平的二选一测试,每类仅采用单个三维模型实例,且受试动物样本量为两只;在统计上落入人类个体变异范围内表明当前测试未发现显著偏离,而非证明两者的神经计算机制完全等同。