这篇论文回答了一个此前几乎无解的问题:如何为腹侧视觉通路最高层的下颞叶皮层(inferior temporal cortex,IT)建立定量准确的神经编码模型。作者的做法是在"生物学上合理的层级神经网络"这一模型类里做高通量计算搜索,发现模型在识别任务上的性能与其预测 IT 神经反应的能力强烈相关——于是把一个纯粹按性能优化、从未见过神经数据的卷积网络直接拿来对神经数据验证,其顶层竟能定量预测 IT 单点反应,中间层预测 V4。这是"性能优化塑造皮层表征"这一思想的首次定量验证,也是后来深度学习与神经科学汇流的关键文献之一。
研究背景
腹侧视觉流(ventral visual stream)支撑着人类快速、准确、对巨大变化鲁棒的物体识别:同一物体的视网膜成像会因姿态、大小、位置、光照、非刚性形变、遮挡等因素剧烈变化,而人对此毫不费力。这个通路被理解为一系列层级加工阶段,V1 里的细胞可用 Gabor 型边缘检测器很好描述,但其群体对复杂图像变换不具备鲁棒容忍性;IT 的群体活动则可直接支持实时的、变化不变的物体归类;中层的 V4(IT 皮层输入的主要来源)介于两者之间。问题在于:低层如 V1 已有既概念上说得通、又能定量预测单细胞对新刺激反应幅度的模型,而 V4 与 IT 的高层建模长期失败——基于第一性原理的模型(如 HMAX 一类)无法匹配人猴的高层表征,直接在一般图像刺激上拟合调谐曲线的尝试也只有有限的预测成功。
当时的缺口是方法论上的两难。一方面,高层模型不能只追求"神经上可预测",因为腹侧流还承载着行为层面的识别能力,模型应同时达到(至少不差于)IT 神经元的解码能力;另一方面,直觉上似乎必须先弄清下层调谐曲线才能解释上层——这条自底向上的路在高阶层走不通。作者提出的关键洞见是:在合适的模型类(层级线性-非线性网络,HLN 假设,即 IT 这类高层神经元的输出是中层输入的线性加权再加简单非线性)之内,识别性能与 IT 预测力可能强烈相关——如果为真,性能本身就是寻找 IT 样模型的高效指南针。
研究思路
全文逻辑分三步递进,每一步都为下一步铺垫。第一步是"相关性发现":用三种方式(随机采样参数空间、按八类不变物体识别任务做性能优化、直接按 IT 预测力优化)各生成上千个卷积神经网络模型,逐一测它们的归类性能与 IT 单点预测力,画出性能-预测力散点图。若性能优化出的模型在预测力上也逼近甚至达到直接按神经数据优化的水平,就说明"追性能"这条路可行。第二步是"登顶":既然相关性成立,就把模型推向性能轴的更右端——用层级模块化优化(hierarchical modular optimization,HMO,一种类似自适应 boosting 并穿插超参数优化的算法)在一个筛查任务集上预训练,找出达到人类识别性能的深层网络(HMO 模型),全程不用任何神经数据。第三步是"盲测":拿这个从未见过神经数据的模型,逐层与 IT、V4 的真实神经反应对比,看顶层是否预测 IT、中间层是否预测 V4。
这个设计之所以有力,在于两个关键的控制思想。其一,模型是从语义内容完全不重叠的筛查图像集(不同物体、不同类别、不同背景、不同光照噪声)迁移到测试集的,性能提升能迁移就说明学到的表征具有一般性;其二,设置了语义理想观察者(semantic ideal observers,包括能完美接触所有类别标签的假想模型)作为对照——若 IT 预测力自动跟随类别选择性而来,理想观察者应该同样好,结果并非如此,从而把"性能优化"与"单纯的类别结构"区分开来。
方法
神经数据来自两只清醒、注视任务的恒河猴(Macaca mulatta,7 与 9 kg),用慢性植入的多电极阵列(Cerebus 系统)并行记录,共 296 个视觉驱动的神经位点(IT 168 个、V4 128 个,多数为多单位位点)。测试图像为 5,760 张照片级逼真 3D 物体图,取自八个自然类别(动物、船、汽车、椅子、面孔、水果、飞机、桌子),物体被放置在随机选取的杂乱自然背景上(保证背景内容与物体身份无相关),并包含物体位置、尺度、姿态的大幅变化。每张图像呈现 100 ms,取刺激呈现后 70–170 ms 的平均 spike 数作为标量反应。模型侧,每个候选网络由 57 个参数指定(层数与各层参数、扇入扇出、激活阈值、池化指数、各层局部感受野大小),层数一到三层,滤波权重从参数界定的均匀分布随机抽取;卷积层由线性滤波、阈值、池化、归一化等简单操作堆叠而成。
两个核心分析管线:归类性能用模型输出层单元训练 SVM 线性分类器、算交叉验证测试准确率(八分类 chance 为 12.5%,散点图里用 balanced accuracy,chance 为 0.5);神经预测力用标准线性回归——对每个目标神经位点,在固定样本图像上找出模型输出的最优线性加权("合成神经元"),再在未参与拟合的新图像上比较预测与实测,计算按神经位点逐次变异归一化后的解释方差百分比(explained variance percentage),取全区域中位数作为该模型的预测力。人类行为参照点用网络众包心理物理学测得。群体层面用表征不相似矩阵(representation dissimilarity matrix,RDM)比较模型与 IT 群体的高维表征布局,并做图像级、物体级(回归训练只用 32 个样本物体)、类别级(只用一半类别)三种泛化检验。
主要结果
-
性能与 IT 预测力强烈相关,且性能优化足以逼近神经数据优化。 三种筛选方式下性能都与 IT 预测力显著相关:随机采样组 r = 0.55,性能优化组 r = 0.78,直接按 IT 预测力优化组 r = 0.80(图 1A)。没有任何单一模型参数与 IT 预测力的相关接近性能那么强(Fig. S4),排除了感受野大小之类的简单机制解释。关键的是,性能优化虽然完全没用神经数据,其最优模型的 IT 预测力已达直接神经优化模型的水平,而且方向不对称:性能优化的模型能同时拿下高性能与高预测力,反过来按预测力优化却拿不到同样高的性能。
-
HMO 模型在行为上追平了 IT 群体与人类。 神经参照点显示:在低、中、高三种变化等级上,IT 群体的解码性能全程追踪人类水平,V4 群体在低变化时与 IT、人类持平,高变化时大幅掉队(且即使去掉平移变化,V4–IT 差距仍几乎不减,说明并非 IT 感受野更大所致);像素、SIFT、V1 样、V2 样、HMAX 等对照模型在高变化条件全部大幅落后——连直接在测试集上训练过的 HMAX 都不如 V4 群体样本。HMO 模型(四层 CNN、1,250 个顶层输出)则在筛查集预训练后直接匹配了 IT 神经样本的识别性能(图 2B),并跨多种识别任务、多种训练样本量保持稳健。
-
HMO 顶层定量预测 IT 单点反应,逐层递进。 顶层预测 48.5 ± 1.3% 的 IT 可解释方差(图 3B、C),比最好的对照模型提升近 100%,达到 V1 低层建模在复杂刺激上的水平。四层依次为 L1 约 4%、L2 约 21%、L3 约 36%、顶层约 48%——类别选择性与变换容忍性沿层级逐渐涌现(图 3A)。理想观察者(类别标签模型约 15%)确实高于 chance 但显著低于 HMO,说明高 IT 预测力不会自动从类别选择性推出,层级网络结构本身贡献了 IT 反应中大量非类别的结构。
-
群体表征相似性接近噪声上限,且跨物体、跨类别泛化。 HMO 输出层预测群体的 RDM 与实测 IT 群体的 RDM 高度相似,接近 IT 群体分半一致性(Spearman-Brown 校正)给出的噪声上限(图 4);这一相似性在图像级、物体级(对 32 个全新样本物体)、类别级(对完全没见过的类别)泛化检验下都保持。作者据此推断:单点水平上未被解释的残差方差,可能有相当部分在 IT 群体编码的意义上并不重要。
-
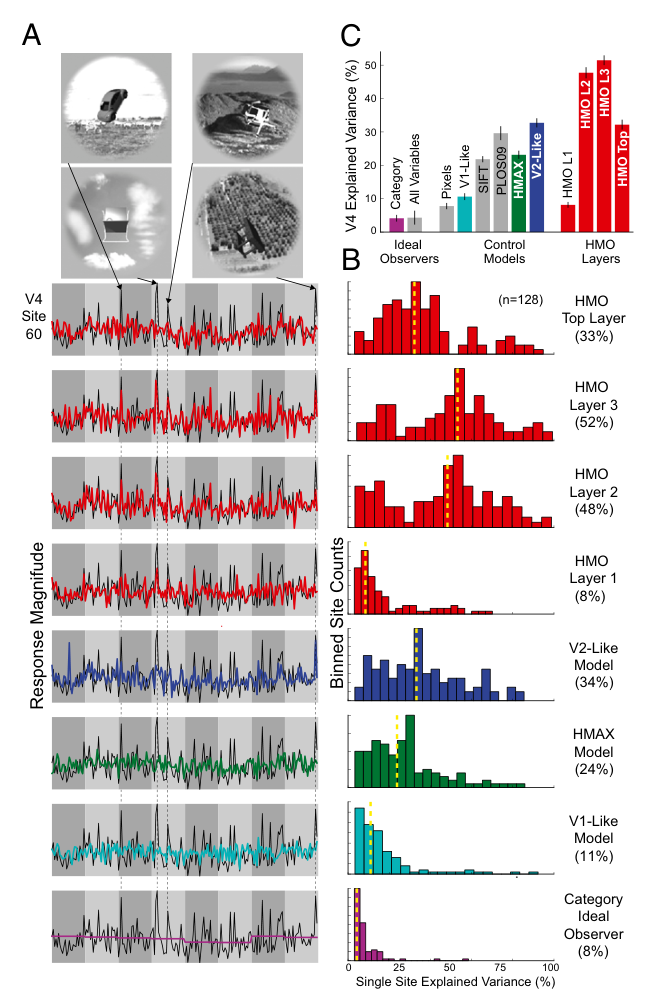
V4 对应中间层,且语义模型解释不了 V4。 HMO 的倒数第二层(L3)预测 51.7 ± 2.3% 的 V4 方差,显著优于该模型的顶层(约 33%)与更底层(图 5);最好的对照 V2 样模型只有 34.1 ± 2.4%。与 IT 形成鲜明对照的是,语义模型(类别理想观察者等)在 V4 上几乎解释不了方差——与 V4 缺乏类别选择性一致。这有力支持了"V4 是一个顶层为 IT 的层级模型的中间层"的假说:性能优化不仅把顶层推向 IT 样表征,还对支撑下游性能的中间表征施加了与生物学一致的约束。
图注解读
图 2 · 用性能优化造出"神经样"模型:流程与行为验证
原文图注:Fig. 2. Neural-like models via performance optimization. (A) We (1) used high-throughput computational methods to optimize the parameters of a hierarchical CNN with linear-nonlinear (LN) layers for performance on a challenging invariant object recognition task. Using new test images distinct from those used to optimize the model, we then (2) compared output of each of the model's layers to IT neural responses and the output of intermediate layers to V4 neural responses. To obtain neural data for comparison, we used chronically implanted multielectrode arrays to record the responses of multiunit sites in IT and V4, obtaining the mean visually evoked response of each of 296 neural sites to ∼6,000 complex images. (B) Object categorization performance results on the test images for eight-way object categorization at three increasing levels of object view variation (y axis units are 8-way categorization percent-correct, chance is 12.5%). IT (green bars) and V4 (hatched green bars) neural responses, and computational models (gray and red bars) were collected on the same image set and used to train support vector machine (SVM) linear classifiers from which population performance accuracy was evaluated. Error bars are computed over train/test image splits. Human subject responses on the same tasks were collected via psychophysics experiments (black bars); error bars are due to intersubject variation.
A 图是整条流水线的示意图:第一步在"滤波-阈值-池化-归一化"的线性-非线性(LN)层堆成的层级 CNN 上做性能优化(空间卷积保证全视野计算一致),第二步用与优化所用完全不同的新测试图像,把模型每一层的输出分别与 IT 反应、中间层输出与 V4 反应对比;神经数据来自慢性植入阵列对 296 个 IT/V4 位点对约 6,000 张复杂图像的平均视觉诱发反应。B 图把所有玩家拉上同一起跑线:纵轴是八分类正确率(chance 12.5%),横分低、中、高三个变化等级。读图要点:绿色实心条(IT)与黑色条(人类)在三个等级下始终贴近,阴影绿条(V4)在高变化等级明显掉队,灰色对照模型(V1 样、V2 样、HMAX、像素、SIFT、PLOS09)高变化时全面落后,只有红色条(HMO)追平 IT 与人类。这张图支撑上文第 2 条结论,也是后面神经预测验证的资格门槛。
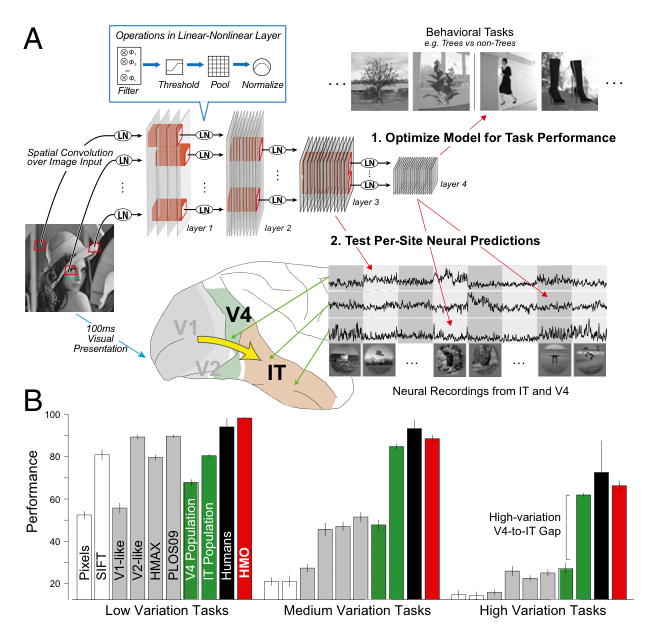
图 3 · 逐层逼近 IT:单点反应预测的定性与定量结果
原文图注:Fig. 3. IT neural predictions. (A) Actual neural response (black trace) vs. model predictions (colored trace) for three individual IT neural sites. The x axis in each plot shows 1,600 test images sorted first by category identity and then by variation amount, with more drastic image transformations toward the right within each category block. The y axis represents the prediction/response magnitude of the neural site for each test image (those not used to fit the model). Two of the units show selectivity for specific classes of objects, namely chairs (Left) and faces (Center), whereas the third (Right) exhibits a wider variety of image preferences. The four top rows show neural predictions using the visual feature set (i.e., units sampled) from each of the four layers of the HMO model, whereas the lower rows show the those of control models. (B) Distributions of model explained variance percentage, over the population of all measured IT sites (n = 168). Yellow dotted line indicates distribution median. (C) Comparison of IT neural explained variance percentage for various models. Bar height shows median explained variance, taken over all predicted IT units. Error bars are computed over image splits. Colored bars are those shown in A and B, whereas gray bars are additional comparisons.
A 图逐点看:三个 IT 位点(左为椅子选择性、中为面孔选择性、右为广谱偏好)各画一条图,横轴是 1,600 张测试图像(先按类别排序、类别块内按变化幅度从轻到重排),纵轴是该位点对每张图的实际反应(黑线)与模型预测(彩线),上层四行是 HMO 四层、下层是对照模型。读图要点是看彩线贴黑线的程度随层数加深而改善:低层只在有限姿态和位置范围内预测得好,越往上层,对类别块右侧(剧烈变换)图像的预测越好——这正是"untangling"逐步发生的过程。B 图是 168 个 IT 位点上各模型解释方差的分布直方图(黄虚线为中位数),C 图把中位数排成条形:HMO 顶层约 48%、L3 约 36%、L2 约 21%、L1 约 4%,V2 样约 26%、HMAX 约 25%、V1 样约 16%、类别理想观察者约 15%。该图支撑第 3 条结论:顶层预测力最高、逐层递进、且理想观察者远不如 HMO。
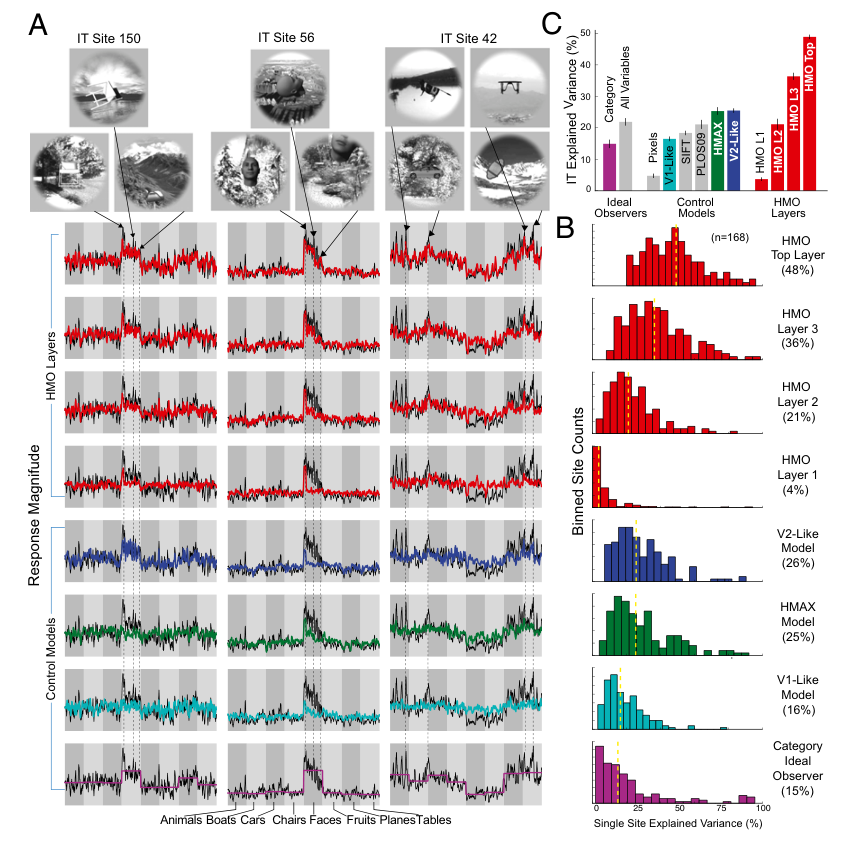
图 4 · 群体表征层面的对齐:RDM 相似性与三重泛化
原文图注:Fig. 4. Population-level similarity. (A) Object-level representation dissimilarity matrices (RDMs) visualized via rank-normalized color plots (blue = 0th distance percentile, red = 100th percentile). (B) IT population and the HMO-based IT model population, for image, object, and category generalizations (SI Text). (C) Quantification of model population representation similarity to IT. Bar height indicates the spearman correlation value of a given model's RDM to the RDM for the IT neural population. The IT bar represents the Spearman-Brown corrected consistency of the IT RDM for split-halves over the IT units, establishing a noise-limited upper bound. Error bars are taken over cross-validated regression splits in the case of models and over image and unit splits in the case of neural data.
A 图是物体级 RDM 的秩归一化色图:行列为 64 个样本物体(8 类各 8 个),每格的颜色表示该物体对在群体空间中的距离百分位(蓝为最相似、红为最不相似);实测 IT 的 RDM 呈明显块对角结构(同类物体彼此更近),块外也有可读的细结构。B 图并排展示实测 IT 群体与 HMO 模型群体的 RDM,在图像级、物体级、类别级三种泛化设定下分别计算。C 图给出定量比较:每个模型的 RDM 与 IT RDM 的 Spearman 相关(柱高),IT 柱本身是分半一致性的 Spearman-Brown 校正值,即噪声决定的上限。读图要点:HMO 的柱几乎顶到上限,而像素、SIFT、V1 样、V2 样、HMAX、V4 位点、理想观察者都明显更低。该图支撑第 4 条结论:单点层面的高预测不是拟合技巧,模型在"从未见过的物体与类别"上复现了 IT 群体表征的布局。
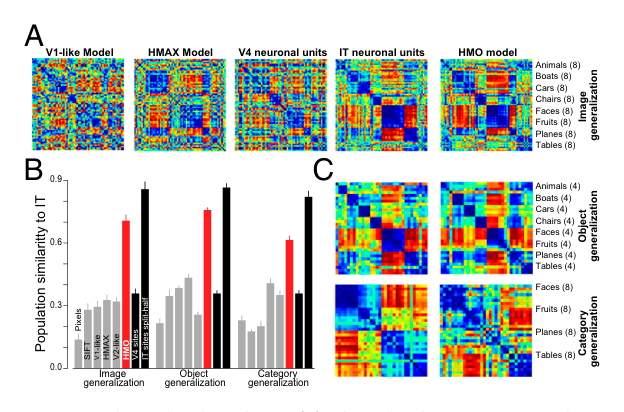
图 5 · V4 由中间层预测:层级对应关系的直接证据
原文图注:Fig. 5. V4 neural predictions. (A) Actual vs. predicted response magnitudes for a typical V4 site. V4 sites are highly visually driven, but unlike IT sites show very little categorical preference, manifesting in more abrupt changes in the image-by-image plots shown here. Red highlight indicates the best-matching model (viz., HMO layer 3). (B) Distributions of explained variances percentage for each model, over the population of all measured V4 sites (n = 128). (C) Comparison of V4 neural explained variance percentage for various models. Conventions follow those used in Fig. 3.
结构上与图 3 平行,只是目标换成 V4 的 128 个位点。A 图是典型 V4 位点的逐图实测-预测对比:黑线(实测)在类别间跳跃得更突然、几乎没有类别偏好——这正是 V4 与 IT 的质性差异,图中的红色高亮标出最佳匹配模型(HMO 第 3 层)。C 图的中位数条形给出关键数字:HMO L3 约 52%、L2 约 48%、顶层约 33%、L1 约 8%,V2 样约 34%、HMAX 约 24%、V1 样约 11%、类别理想观察者约 8%。读图要点是"倒挂":对 IT 最优的是顶层,对 V4 最优的却是倒数第二层,且语义模型在 V4 上几乎归零。该图支撑第 5 条结论:V4 对应层级模型的中间层,其表征被下游性能需求所塑造。
讨论
作者把自己的方法概括为两个约束的联合作用:功能约束(识别性能)与结构约束(层级网络架构),并强调两者缺一不可——高归类性能和层级模型类协同工作才能产生 IT 样群体,单独任何一个都不够。与既有工作的关键分歧在于"生成式"的建模立场:此前神经反应预测路线为每个神经单元单独调参,而本文除最后的线性加权外完全不用神经数据调参,模型参数由顶层性能独立选定,之后任何数量的 IT 或 V4 单元都可以从这个固定基组里"合成"出来——模型规模不随待预测位点数增长,预测结果可望泛化到任何新测量的位点。这解释了物体级与类别级泛化何以成立。
讨论部分最有意思的是立场上的宣言:传统视觉神经科学默认"先解释低层调谐曲线、才能解释高层",而作者主张用自顶向下的视角补充——把 IT 看作进化/发育过程针对识别性能优化出的产物,V4 则可被刻画为恰好为了支撑 IT 下游计算而被选择出来的中间层。这与寻找"曲率选择性"之类几何基元的路线在性质上不同,但结果表明在自底向上的基元尚未明确时,功能约束照样能给出定量可预测的模型。作者也坦承工作尚待推进:需要与 V1、V2 建立桥梁,并考察受腹侧流启发的更深层计算机视觉架构(文中引 Krizhevsky 等 2012 的 ImageNet 网络);对高阶腹侧区观察到的结构异质性(如功能特化亚区),性能优化视角提供了一个初步的、计算上严谨的解释线索(滤波统计量与最大/平均池化指数的敏感性),但确认这些假说仍需大量后续工作。
一句话总结
我读这篇文章最大的感触是它的验证姿态:模型在完全不相交的物体、类别、背景、光照上训练,然后才第一次接触神经数据——这种"先跑分、后对表"的顺序让"性能优化产生 IT 样表征"成为可检验的命题而不只是事后的解释。单点约 48%、群体逼近噪声上限、V4 由中间层倒挂预测这三组数字合在一起,基本宣告了"深层网络是腹侧流的候选模型"这一研究纲领的诞生;以今天的眼光看 48% 不算高,但在 2014 年它是把 HMAX 一代模型甩开整整一档的飞跃,也是我眼中计算神经科学与深度学习真正握手的那一刻。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度partial,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[A, B] - Fig3: 提取质量
good,对齐度full,识别面板[A] - Fig4: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig5: 提取质量
good,对齐度full,识别面板[A, B, C]