本文系统定量测定了灵长类下颞叶(IT)皮层神经群体所携带的视觉物体信息量。作者利用具有生物学可实现性的正则化线性分类器(SVM)读出技术,对猕猴 IT 皮层无偏抽样的多单位放电活性(MUA)展开群体解码分析。研究证实:仅需大约 100 个随机选取的 IT 记录位点,在短至 12.5 ms 的极短时间积分窗口内,即可高准确率读出呈现刺激的“物体类别”与特定“物体身份”,且所提取的信息对物体的视网膜位置与视角尺度变换展现出高度不变性。该发现确立了腹侧视觉流通路支持快速核心物体识别的群体编码参数基准。
研究背景
灵长类视觉系统能够在外界刺激呈现后约 100 至 200 毫秒内迅速完成物体的分类与身份识别,这一敏捷行为对大脑腹侧通路的神经计算提出了严格的时间与算法约束。从视网膜感光细胞经外侧膝状体、初级视皮层(V1)、中间视区(V2、V4)直至下颞叶(IT)皮层,视觉信号需跨越多级突触中继传递;在如此紧凑的时程内,每个皮层加工阶段仅有 10 至 30 毫秒的时间窗口进行局部整合,单神经元平均仅能发放极少数甚至单个动作电位。
既往大量单细胞电生理记录证实,前部 IT 神经元对复杂物体形状表现出选择性调谐,并且在一定程度上能够耐受物体大小与视网膜位置的变化。然而,单神经元的研究视角引发了长期的理论争议:大脑是否依赖专门调谐于特定物体的“特化神经元”,抑或依靠大范围神经群体的粗编码协同表征?单个神经元携带的信息量往往有限且试次间噪声显著,下游脑区(如前额叶皮层或运动运动规划区)究竟需要汇聚多少个 IT 神经元、需要多长时间积分窗口、以及采用何种计算规则才能稳定提取出不变的物体身份?
针对这一问题,Hung 等人引入了基于分类器的群体读出(classifier-based readout)分析方法。该方法并不假定大脑完美知晓复杂的神经计算规则,而是评估一个具有生物学可行性的单层线性感知机,能否从无偏抽样的 IT 群体发放率中快速分类物体。研究通过系统操纵物体类别、个体身份、空间位置及尺度变换,定量测定群体解码的准确率、神经元数量需求与最小时间窗口。需客观指出的是:本研究采用被动注视任务,未包含涉及多目标注意或主动搜索的情境;神经元群体采用跨 session 异步伪群体拼接构建,忽略了真实同试次网络中的瞬态噪声相关性;线性读出测量的是表征的“显式可读性”,确立了下游网络提取信息的充要性下限,但并不等同于大脑实际生理读出的唯一实现方式。
研究思路
研究的核心策略在于转向“下游脑区以线性方式读取群体表征”的计算框架。实验放弃了人为预先筛选具有高度选择性的“最优细胞”,转而采用无偏随机推进电极抽样的方法,从猕猴下颞叶皮层广泛记录数百个独立的记录位点(涵盖多单位活动 MUA 与单单位单细胞活性)。
分析流程采用基于边界最大化的支持向量机(SVM)分类器(并以正则化最小二乘分类器 RLS 作为稳健性对比):将每个记录位点在特定时间窗内的尖峰计数(或 LFP 功率)拼接为多维特征向量,使用部分试次训练线性分类边界,在未参与训练的独立测试试次上评估解码准确率。解码目标包含由浅入深的两个层级:将 77 个复杂物体归为 8 个粗类别的“类别分类任务”(8 选 1,随机基线为 12.5%),以及精确指认 77 个个体物体的“身份识别任务”(77 选 1,随机基线为 1.3%)。进一步地,通过跨位置与尺度的泛化测试,以及将时间窗逐步压缩至 12.5 ms,定量测定表征的不变性与时间分辨极限。
方法
实验使用两只健康成年雄性恒河猴(Macaca mulatta)。在维持中央注视任务(注视窗 1°)期间,向动物呈现物体图像序列,每张图像呈现时长为 100 ms,刺激间隔(ISI)为 100 ms。刺激集包含 77 个常见真实物体与人造物体的灰度二维图像,严格归入 8 个语义类别(玩具、面孔、身体部位、汽车等),测试涵盖 3 种空间位置(中心视野及向左、向右偏离 4°)与 2 种缩放尺寸(1.7° 与 3.4° 视角),每种组合重复测试 10 至 20 次。
记录定位于猕猴左半球前下颞皮层(AIT,立体定位前侧 15–22 mm,下颞沟腹侧唇与脑回表面)。电极每天随机推进至皮层灰质,记录多单位活动(MUA,高通滤波后能量检测)、分离出的单单位动作电位(SUA),以及局部场电位(LFP,1–300 Hz 带通滤波)。无偏采集共获得数百个响应位点(最终汇总分析涵盖 256 个 MUA 位点及对应 SUA)。解码算法采用线性 SVM,通过留一法或折半交叉验证,所有性能均以 20 次独立随机抽样的标准差(SD)呈现;时间进程分析采用 50 ms 滑动时窗及 12.5 ms 超短时窗,统计显著性通过置换检验对比线索前基线活动评定。
主要结果
- 类别与身份信息可从群体活动中被线性准确读出(图 1):仅使用 256 个无偏抽样的 MUA 位点(提取刺激后 100–300 ms 的尖峰计数),线性分类器对 77 个物体的八分类准确率达到 94 ± 4%(随机基准为 12.5%;插值显示仅需约 100 个位点即可达到 81% 准确率);在难度极高的 77 选 1 个体身份识别任务中,解码正确率亦高达 72 ± 3%(随机基准为 1.3%)(图 1B)。单单位(SUA)解码性能与 MUA 高度相当(64 个位点下分类准确率分别为 81% 与 83%),而局域场电位(LFP)的分类能力显著较弱(约 56%)(图 1C)。混淆矩阵显示分类错误主要发生在同一语义类别内部的近缘物体之间(图 1D)。
- 读出表征对空间位置与尺度变换展现出强健的不变性(图 2):当分类器在某一特定位置(如视野中心)训练、并在全新空间位置(向左或向右偏转 4°)测试时,类别解码性能仅从 94% 轻微下降至约 85%(图 2A);对于视角尺寸从 1.7° 放大至 3.4° 的尺度泛化测试,解码性能同样保持在 85% 以上(图 2B);即使在两维度联合不匹配测试下(同时跨尺度与跨位置),系统依然能保持高达 75% 以上的分类水平(图 2C)。这一结果证实,基于无偏抽样 IT 群体的线性超平面自然具备全局几何不变性。
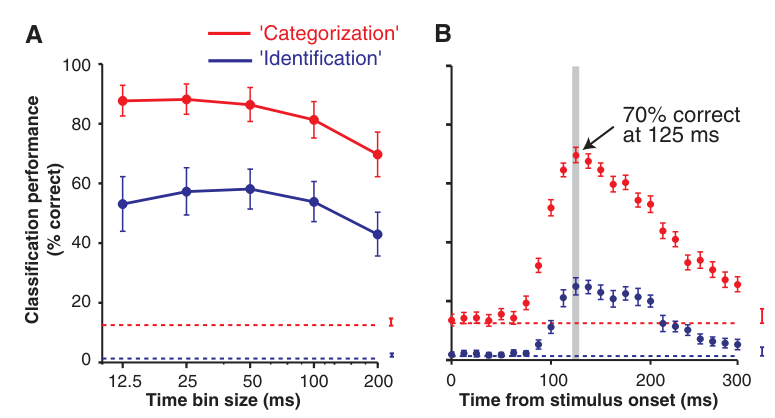
- 高精度信息在百毫秒极短时窗内即可提取(图 3):时程分析表明,线性分类性能在刺激呈现后约 100 ms 处开始显著脱离基线爬升,并在约 125 ms 处达到峰值平台期(图 3B)。当将积分时窗极端压缩至 12.5 ms 时,依靠约 100 个神经元在该超短时窗内的尖峰,仍能达到约 65% 的分类准确率(随机为 12.5%)(图 3A);在该时间尺度下,每个神经元平均产生的动作电位不足 1 个(均值约 0.1–0.5 个尖峰),表明系统依赖的是瞬态空间分布的二值化协同状态,而非单细胞的长时放电率累积。
- 位置与尺寸信息亦在相同神经群体中并行保留:利用相同记录位点的多维放电特征训练位置或尺寸分类器,能够以 70% 至 85% 的准确率判定物体所处的偏心度与视角大小,证实度量几何信息并未被擦除,而是以与类别正交的形式并存。
图注解读
图 1 · 类别与身份均可从群体活动准确读出
原文图注:Fig. 1. Accurate readout of object category and identity from IT popula- tion activity. (A) Exam- ple of multi-unit spiking responses of 3 indepen- dently recorded sites to 5 of the 77 objects. Ras- ters show spikes in the 200 ms after stimulus onset for 10 repetitions (black bars indicate object presentation). (B) Performance of a linear classifier over the entire object set on test data (not used for training) as a function of the number of sites for reading out object category (red, chance 0 12.5%) or identity (blue, chance 0 1.3%). The input from each site was the spike count in consecutive 50-ms bins from 100 to 300 ms after stimulus onset (28). Sequentially recorded sites were combined by assuming independence (Supporting Online Material). In this and subsequent figures, error bars show the SD for 20 random choices of the sites used for training; the dashed lines show chance levels, and the bars next to the dashed lines show the range of performances using the 200 ms before stimulus onset (control). (C) Categorization performance (n 0 64 sites, mean T SEM) for different data sources used as input to the classifier: multi-unit activity (MUA) as shown in (B), single-unit activity (SUA), and local field potentials (LFP, Supporting Online Material). (D) This confusion matrix describes the pattern of mistakes made by the classifier (n 0 256 sites). Each row indicates the actual category presented to the monkey (29), and each column indicates the classifier predictions (in color code).
(A) 先展示单点的反应:3 个独立记录位点对 5 个物体的栅格图(刺激后 200 ms,10 次重复,黑条为呈现期)——单个位点的响应有差异但远不足以判定物体,这是后面群体读出必须超越的"起点"。(B) 是全文主图:横轴为位点数(对数刻度 1→256),纵轴为测试数据上的正确率;红线(归类,机遇 12.5%)始终在蓝线(识别,机遇 1.3%)上方,虚线旁的短条为用刺激呈现前 200 ms 尖峰训练的对照(接近机遇)。(C) 比较 MUA、SUA、LFP 三种输入的归类性能(n=64,均值±SEM):前两者相当,LFP 低于两者但高于机遇。(D) 8×8 混淆矩阵(n=256),行=实际类别、列=分类器输出(颜色编码),显示哪些类别容易混淆。此图支撑主要结果 1、2。
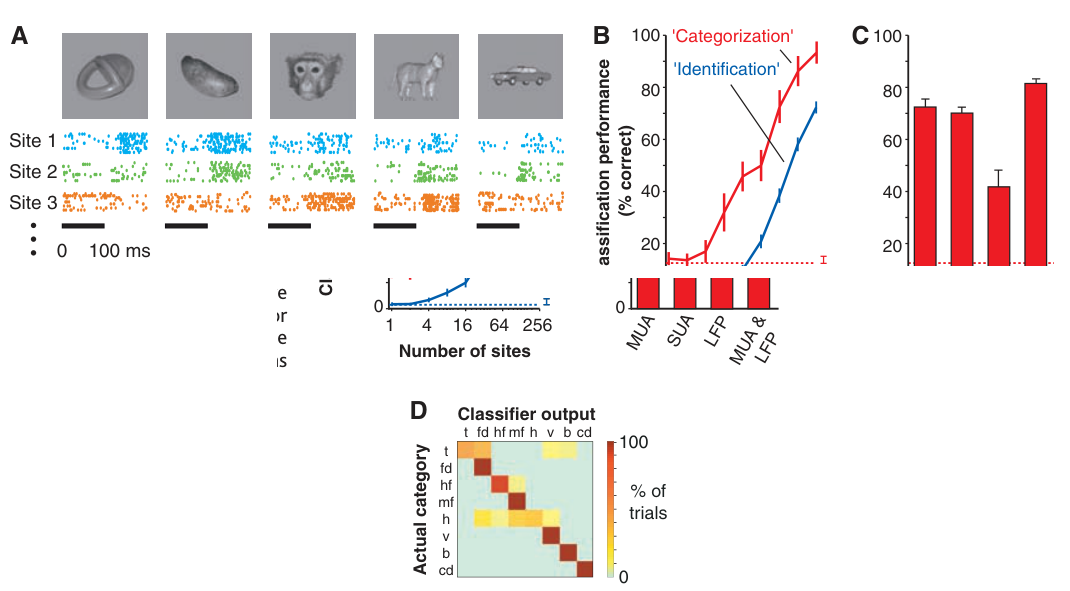
图 2 · 训练与测试的空间变换不匹配,性能几乎不掉
原文图注:Fig. 2. Invariance to scale and position changes. Classification performance (categori- zation, n 0 64 sites, chance 0 12.5%) when the classifier was trained on the responses to the 77 objects at a single scale and position (de- picted for one object by ''TRAIN'') and perform- ance was evaluated with spatially shifted or scaled versions of those ob- jects (depicted for one object by ''TEST''). The classifier never ''saw'' the shifted/scaled ver- sions during training. Time interval 0 100 to 300 ms after stimulus onset, bin size 0 50 ms. The left-most column shows the performance for training and testing on separate repetitions of the objects at the same standard position and scale (as in Fig. 1). The second bar shows the performance after training on the stan- dard position and scale (scale 0 3.4-, center of gaze) and testing on the shifted and scaled images of the 77 objects. Subsequent columns use different image scales and positions for training and testing.
柱状图:每根柱是一种"训练位置/尺度→测试位置/尺度"组合下的归类性能(chance 12.5%)。最左柱是训练与测试都在标准条件(3.4°、注视中心)但用不同重复次数的基准;第二柱为标准条件训练、变换条件测试;后续柱为不同的尺度(中心 1.7°、6.8°)与位置(水平位移 2°、4°)组合的训练/测试配对。要点在于:所有跨变换柱都贴近基准柱、下降不到 10%,而分类器在训练中从未见过被测的变换版本——这就是结果 3 的"不变性"证据。
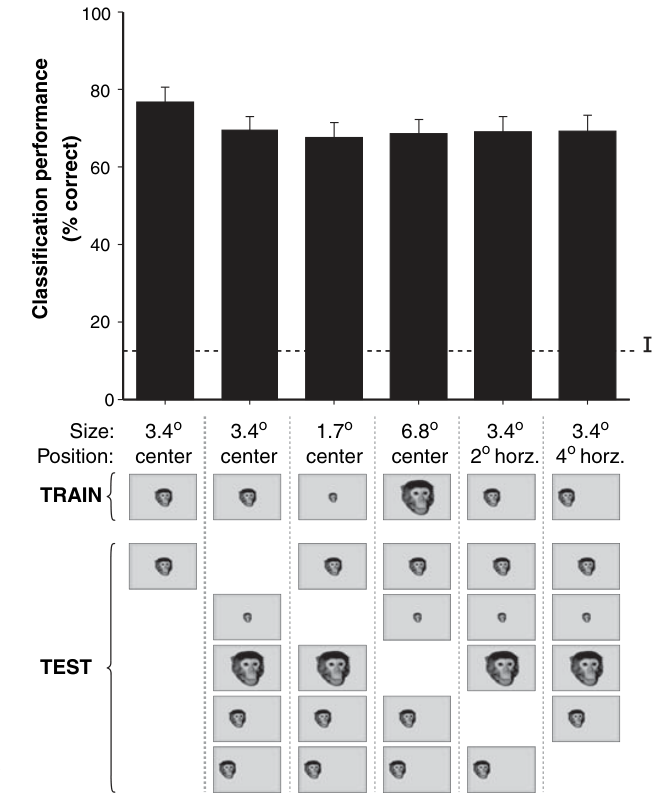
图 3 · 编码的时间分辨率与时程
原文图注:Fig. 3. Latency and time resolution of the neural code. (A) Classification performance (n 0 128 sites) as a function of the bin size (12.5 to 200 ms, i.e., temporal resolution) to count spikes within the 100- to 300-ms window after stimulus onset for categorization (red) and identification (blue). The same linear classifier as in Figs. 1 and 2 was used. (B) Classification performance (n 0 256 sites) using a single bin of 12.5 ms to train and test the classifier at different latencies from stimulus onset (x axis). The colors and conventions are as in Fig. 1B.
(A) 横轴为 bin 大小(12.5→200 ms),纵轴为性能:计数窗固定为刺激后 100–300 ms,bin 越小(时间分辨率越高)性能越好,12.5–50 ms 明显优于 100–200 ms。(B) 横轴为单个 12.5 ms bin 相对刺激起始的延迟(0→300 ms),性能曲线快速爬升,约 125 ms 处归类已达 70%(图中标注 "70% correct at 125 ms"),其后维持平台;归类与识别两条曲线形状相似。此图支撑结果 4、5:信息出现得早、分辨率要求不高,且同一群体可服务不同任务。
讨论
作者从计算机制与认知生理两个层面对解码结果进行深入阐释: 在神经信息可读性层面,研究证实无偏抽样的百余个 IT 记录位点在毫秒级时窗内足以支撑高精度的物体识别与分类。尽管该测量刻画的是神经群体中“客观存在的可读出信息”,并不必然等同于动物在所有自然场景下实际运用的唯一算法(Tjan, 2001);但由于线性分类器(加权求和后阈值化判定)在生物突触硬件上极其易于实现——下游前额叶皮层(PFC)或运动前区神经元只需对来自 IT 的轴突突触权重进行线性分配即可完成解码——因而极具神经生物学生理可行性。
在时空动力学层面,100 ms 的潜伏期与 12.5 ms 极短时窗内的高解码性能,直接支持了层级前馈视觉通路的高效计算架构。在每一个突触中继阶段,单个细胞甚至无需完成放电率的积分平滑,群体水平上动作电位的瞬时离散空间模式即可被瞬间捕获并传递。此外,跨位置与跨尺度的优良泛化表现,证实下颞叶皮层在完成特征非线性重组后,已将低级纠缠的几何流形展开为平滑线性可分的低维空间,从而使得下游网络能够利用极具计算效率的线性超平面同时读取物体类别与空间几何信息。
局限性方面,作者指出实验在被动注视范式下采集,单次刺激呈现仅 100 ms,未模拟长时观察中由于眼跳和注视转移引起的动态时序整合;同时,数据通过异步拼接构建伪群体,真实大脑中皮层同试次内的噪声相关性(noise correlation)对解码精度的潜在调制效应,有待后续多电极同步记录进一步厘清。
一句话总结
本研究通过严格的线性支持向量机读出分析,证实灵长类下颞叶皮层仅需约 100 个无偏抽样的神经元、在短至 12.5 ms 的极短时间窗口内,即可高准确率地线性读出物体的类别与个体身份,且表征对位置与尺度变换展现出高度不变性,确立了快速核心物体识别的群体神经编码基准。