一句话定位:这项计算建模研究探讨视觉皮层中类别专门化脑区与全皮层分布式表征的功能分工。作者使用两个生物启发的层级识别模型进行模拟,重点分析特征抽取尺寸与来源对分类性能的影响。研究发现:类别内识别(如同类个体面孔辨别)依赖类特异的中等尺寸特征模块;类别间识别(区分不同物体类别)则可通过尺寸分布均匀的通用特征词典实现。
研究背景
腹侧视觉通路的层级模型把识别描述为从局部边缘到复杂形状的逐级表征,但到了下颞叶,信息究竟以广泛分布还是类别专门化的方式组织,一直存在争论。成像中去除最偏好某类别的体素后,其余活动仍可能区分类别,说明信息并不限于选择性最强的区域;另一方面,人类面孔区和猴面孔斑块又显示明确的局部聚集。这两类证据未必互相排斥,因为区分一张脸与一辆车,和区分两张相似的脸,对视觉特征的要求不同。若任务层级没有分开,关于通用编码与专门机制的争论可能混合了不同的识别问题。
一个较少被直接操纵的环节是特征本身。细小局部片段可以描述边缘,却未必保留足以区分同类个体的部件关系;较大的片段能够携带组合信息,也可能对训练材料的分布更敏感。特征从目标身份、其他身份还是广泛自然图像中学习,也会改变后续可分性。真实神经实验难以在保持其余条件不变时,系统替换整套皮层特征词典,因此仅靠活动位置不容易确定专门化的计算收益。本文把模型作为受控比较工具,围绕特征来源与尺寸提出问题:在类别内身份识别和类别间分类中,什么样的词典有用,这种作用是否依赖某一种抽取算法?
Ghodrati 等人比较采用不同特征学习方式的 Stable 与 HMAX 模型,用面孔身份任务和多类别物体任务检验不同尺寸、不同来源的特征,并结合识别率与表征差异矩阵观察可分性。这将“是否需要专门表征”转换为可以逐项操纵的计算问题,也把经验和任务要求纳入解释。不过,面孔与一般物体来自不同数据库,类别内、类别间任务并未在所有图像条件上完全匹配;使用相同身份的其他图像学习特征,检验的也是已见身份的图像或视角泛化,不能当作陌生身份泛化。两种模型结果一致只说明该模式不局限于单个实现,不能证明皮层必然需要独立模块。斑块大小更不能单独定义心理学的整体加工,模型中的性能收益与真实神经组织之间仍需实验连接。
研究思路
研究设计包含三个步骤:第一步,选取特征来源不同的两个模型相互验证。Stable 模型(Rajaei 等,2012)采用基于自适应共振理论(Adaptive Resonance Theory, ART)的无监督机制学习特征,通过反馈环路模拟复杂细胞对简单细胞的中心兴奋-周边抑制作用,利用警觉参数(vigilance parameter)评估原型(prototype)与输入匹配度,匹配不足则补充新原型;HMAX 模型(Serre 等,2007)在 C1 层随机抽取图像子块作为特征,属于经典的前馈标准模型。若两模型得出一致结论,可表明效应主要源自特征属性而非单一算法细节。第二步,将特征尺寸(4×4 至 24×24 共六档,以占物体视图比例衡量)与特征学习范式(Within:测试同类别/身份的不同图像;Between:完全不同的类别;Natural:从约 6000 个斑块的多样自然图像集抽取)交叉组合。第三步,综合测试识别准确率与表征差异矩阵(representational dissimilarity matrix, RDM,基于特征向量间 1-相关构建),计算选择性指数以评估特征空间的类间可分性。该设计将专门化表征需求转化为分档检验的计算参数问题。
方法
两个模型都是四层前馈结构:S1 层为 Gabor 滤波器组,从输入图像中提取各朝向的条带与边缘;C1 层对同一朝向、稍有位置与尺度差的 S1 单元做最大值池化(max pooling),获得对平移与尺度变化的不变性;S2 层借助加权连接对原型模板做匹配,表征比边缘更复杂的图案;C2 层在全部位置与尺度上取各原型的最大/最高响应,输出一个长度为原型数的特征向量,最后送入线性支持向量机(support vector machine, SVM)分类。Stable 模型的特异之处在其训练过程:对每幅训练图,先选出响应最高的 5 个 C2 单元(该参数取自作者先前研究),由自上而下的期望把输入与原型对齐,警觉控制系统判断匹配度并决定是否添加新原型,从而以单次呈现即可学到一幅图像的代表性特征集合;中心兴奋-周边抑制网络为相关单元制造共振态(resonant state),是对皮层反馈连接的简化模拟。此外,Stable 模型以去相关的方式抽取斑块,倾向学习彼此差异大的原型。
数据库方面,类别间任务用 Caltech-256(256 类、最少的类别也有 80 张图),每次实验随机抽取若干类别,每类 30 张训练、50 张测试,类别数在 2、5、10、20、30、40 之间变化,每档跑 30 次随机划分;类别内任务用 CMU PIE 人脸库(68 个身份),每身份 21 张训练、12 张测试,训练集取 0°、±45°、±90° 五个视角(每视角三种表情),测试集用 ±22.5° 与 ±67.5° 以显式考察视角泛化,身份数 10–40,每档 15–30 次随机划分。全部图像灰度化、高度缩放到 140 像素并保持长宽比。性能指标为识别正确率,均值与标准差经多次随机运行汇总,组间显著性用 Wilcoxon 秩和检验并给出全配对的 p 值色块矩阵。文中也明确:包裹结果图像与误差条的坐标在正文里未逐图列出具体数值尺度,引用具体识别率时应查验原图。
主要结果
-
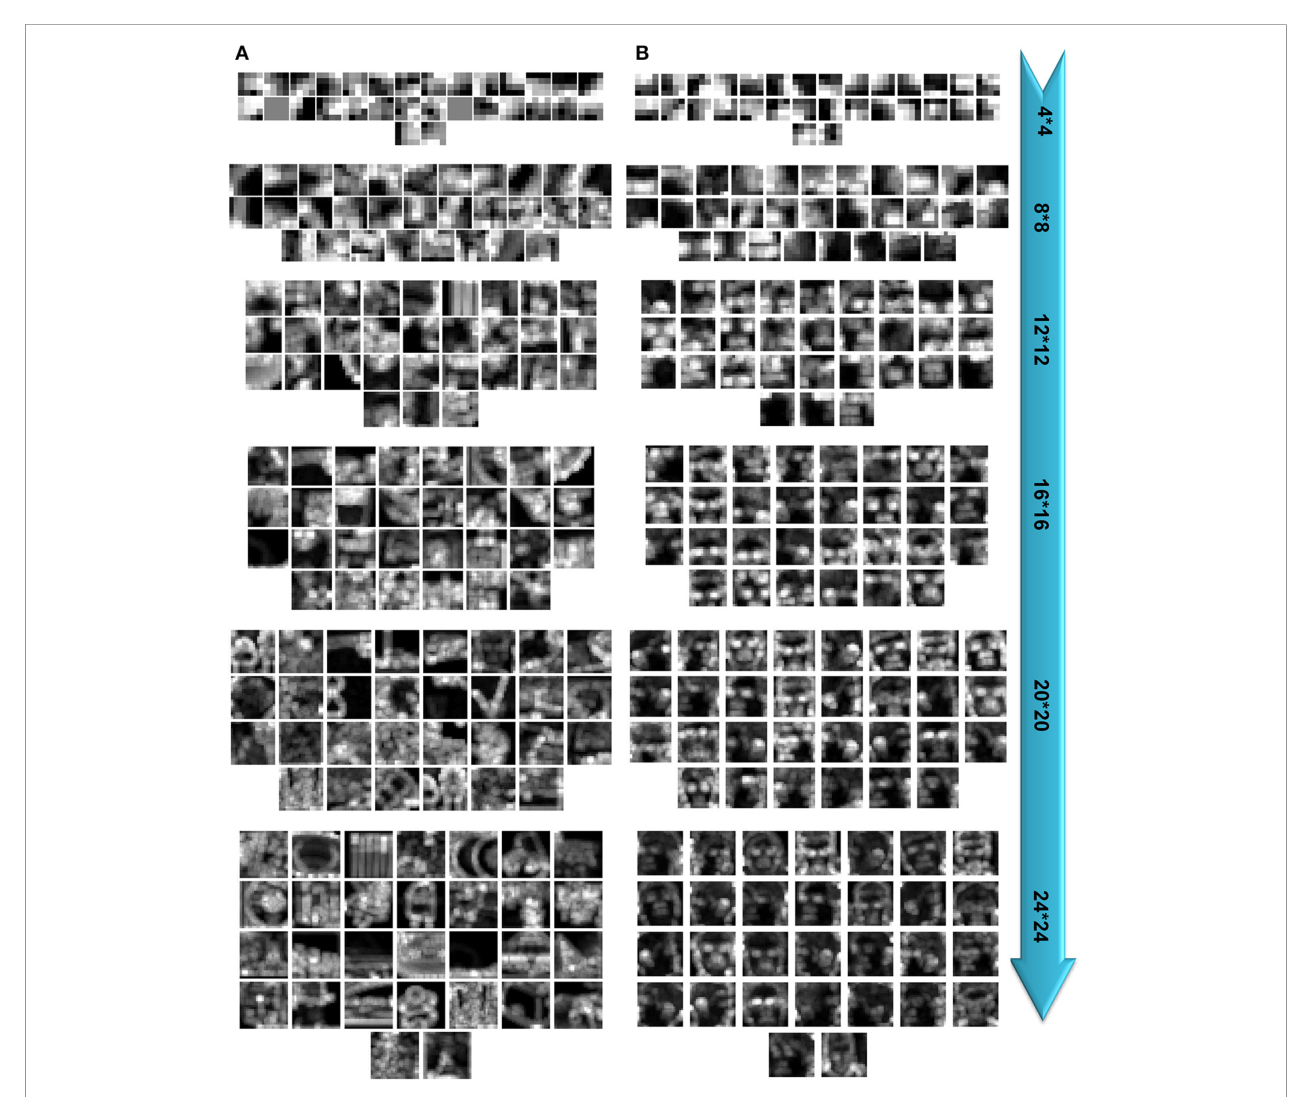
两个模型表现高度一致,结论不依赖特征抽取方式。无论特征来自随机抽取(HMAX)还是无监督 ART 机制(Stable),两模型在人脸识别与物体识别中给出同样的模式——这把后续所有结论都归因于特征属性本身。作为副产品,Stable 模型在人脸任务中"自发地"学出更多中到大尺寸斑块(其间与跨类别两种学习策略下都成立),在物体任务中各尺寸斑块数量则近似均等(图 11 展示了两种任务实际提取的斑块样例)。
-
人脸识别:类特异特征不可或缺。把所有尺寸的斑块聚合后比较三种学习策略(10 个身份),Within(同一批身份、不同图像)显著优于 Between(不同身份的同类图像)与 Natural(自然图像词典),Stable 与 HMAX 均如此(Fig. 7)。换言之,一个再丰富的通用词典也无法承载"从一个类别内辨认个体"的任务。
-
人脸识别:特征要中等尺寸。逐尺寸看,4×4 的小斑块在任何策略下都表现垫底——它覆盖面积太小,不足以提供一张脸或其部件(鼻、眼、嘴)的信息,缺乏编码细微差别所需的选择性;尺寸升到中间档(Stable 为 12×12、16×16、20×20,HMAX 为 8×8 到 20×20)时性能显著抬升(Fig. 5、Fig. 6)。而使用自然图像词典时,各中间尺寸之间几乎无显著差异——通用的特征字典即使在最佳尺寸上也无法把人脸个体分清。作者将"尺寸覆盖整脸或大半视图"类比为面孔整体加工(holistic processing)的概念。
-
特征空间证据:选择性与聚类。RDM 显示,随斑块尺寸自小变大,同一身份的人脸特征在矩阵对角线上聚成更清晰的方块(即同身份相似度更高、跨身份可分性增强),选择性指数(对角方块均值与其余像素均值之比)在人脸上随尺寸上升,在物体任务上各尺寸的贡献近似相等(Fig. 8)。这为"中间尺寸提高可判别性"给出了表征层面的机制解释。
-
物体识别:通用词典足矣。类别间任务中,不同斑块尺寸的性能差异远小于人脸任务,且无一种持续占优;除 4×4 显著较差(一个原因是信息量不足,另一个是 Stable 模型的去相关机制使低多样性的 4×4 斑块难以被学到)之外,Within 特征与 Natural 特征的性能无显著差异,在小斑块被剔除后亦然(Fig. 9、Fig. 10)。物体任务的特征空间里各尺寸贡献均衡——正是"分布式表征"在模型中的对应物。
图注解读
图 1 · Stable 模型的层级结构
原文图注:FIGURE 1 | The structure of the Stable model. Gray scale images are applied to the model and the outputs of S1 and then C1 are attained. Then, the S2 responses are computed using existing prototypes. To compute the C2 responses, the S2 units with the maximum response for each prototype are selected. The highest active C2 units are then selected as prototypes to …(图注较长,此处截断)
Stable 模型的架构图:灰度图像输入后依次经 S1(Gabor 边缘提取)、C1(最大池化),S2 层用现有原型计算响应,C2 层取每个原型在各位置尺度的最大响应;右侧绿框标出被选中的"最高响应"C2 单元,自上而下的期望机制完成输入与原型的匹配,警觉参数(ρ)决定匹配程度是否需要新增原型。这是理解方法节模型结构的底图。
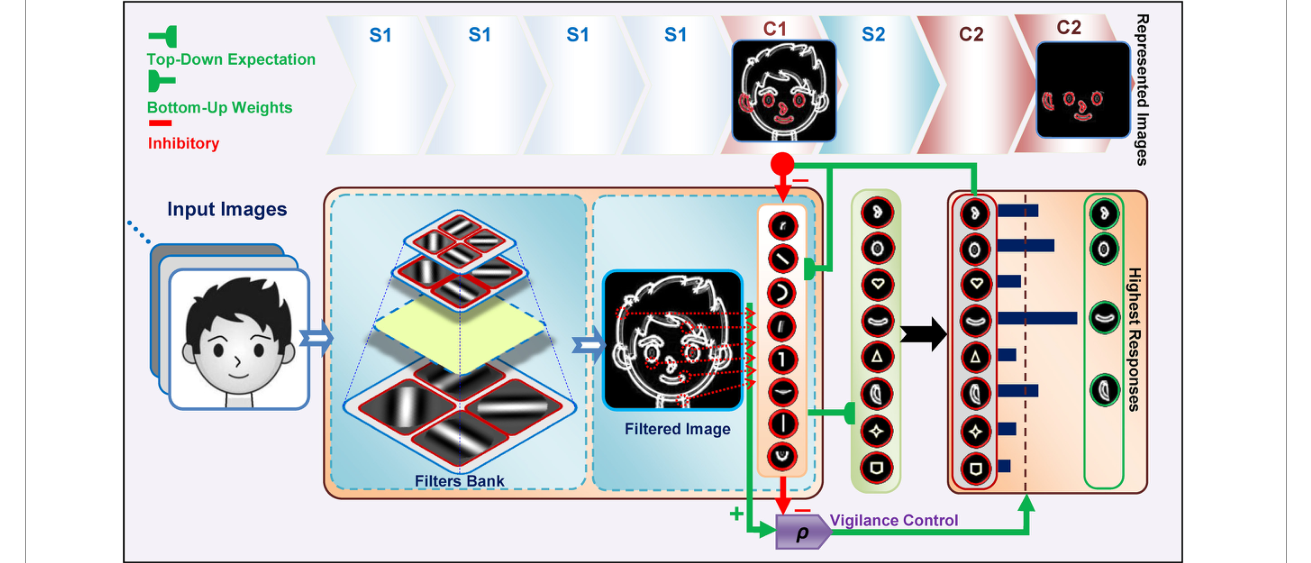
图 2 · 中心兴奋-周边抑制网络
原文图注:FIGURE 2 | On-center off-surround network. Some units in the upper layer are activated by bottom-up weighted connections. Excitation signals are sent via these units to the relevant units through direct top-down weights and inhibition signals are sent to all units. This amplifies the activities of cells within the matched (on-center) portion while suppressing the activities of irrelevant cells in the non-matched (surround) portion. …
上行连接激活上层部分单元;被激活的单元向经由直接自上而下权重的相关单元发送兴奋信号、向所有单元发送抑制信号,因此图像中与原型匹配的"中心"部分得到放大,不匹配的"周边"部分被压制。图注还区分了第一层单元同时接收兴奋与抑制的两种情形。这张图解释 Stable 模型反馈环路(模拟 V1/V2 复杂细胞向简单细胞的反馈)如何制造共振态,是"无监督学习为什么长这样"的图解。
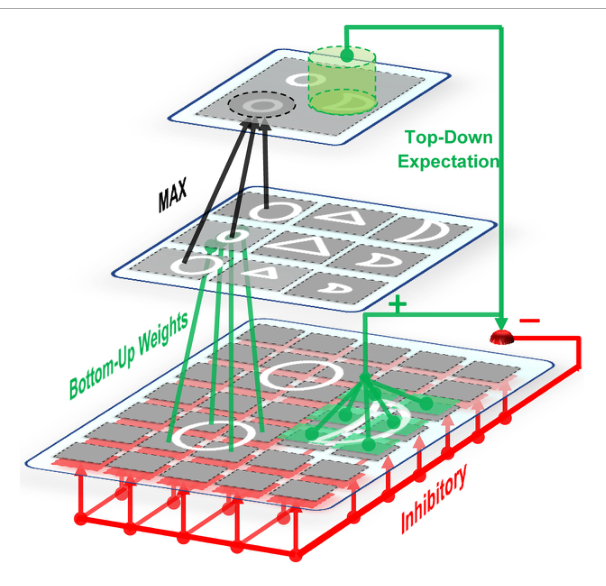
图 3 · 人脸任务的图像选取
原文图注:FIGURE 3 | Image selection for face identification task. Views of 0, ±45◦, and ±90◦, with three images in each view (expression), were used as train images (specified with green frame). Views of ±22.5◦ and ±67.5◦ were selected as test images (specified with yellow frame) and some other images were not used in experiments (gray-frame images).
PIE 库中的视角划分为绿色框的训练视角(0、±45、±90 度,每视角三种表情)与黄色框的测试视角(±22.5、±67.5 度),未用的是灰色框。读图关键是视角间的"错开"设计:训练与测试不含同一视角,因此任何好成绩都不可能来自记忆角度。它支撑方法节的严密性,也解释了为什么测试集视角是插在训练夹缝里的。
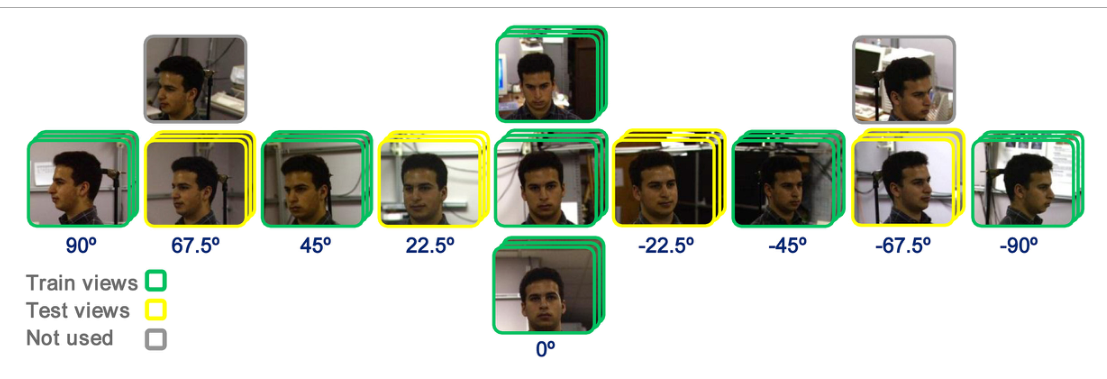
图 4 · 三种特征学习范式
原文图注:FIGURE 4 | Different modes of visual feature learning. In within feature learning mode visual features are learned using train images (train and test images are the same identities or object categories but images are completely different in both sets). In the second mode (between), a different set of identities or object categories are selected for feature learning stage. In the third mode, a large set of natural images are diversely selected from the web. This set are then used to learn visual features. In each mode, the images for feature learning are only changed.
三种特征的来源图解:Within 用与测试同身份/类别的不同图像学特征;Between 用另一批身份/类别;Natural 用从网络收集的多样自然图像。唯一被操纵的变量是"特征学习用什么图"。这张示意图是全文自变量定义的基准,与主要结果第 2、5 条直接相关。
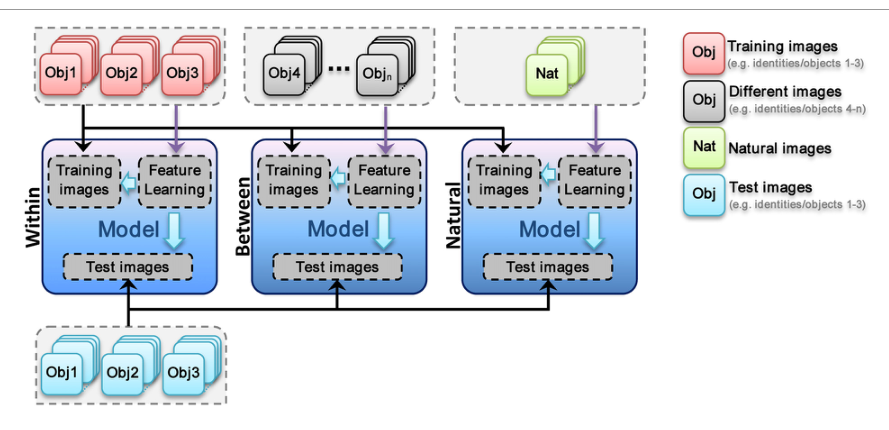
图 5 · Stable 模型的人脸识别成绩曲线
原文图注:FIGURE 5 | Performance comparisons between different patch sizes and feature learning strategies for the Stable model in face recognition task. (A) Comparing the performance of the Stable model when uses face images from identical identities to test images but with different views in feature learning phase. Each curve shows the results of different number of classes/identities that vary from 10 to 40 (specified with different colors). The results are the average of 15 random runs and error bars are standard deviation. …(图注较长,此处截断)
人脸识别任务中不同斑块尺寸与特征学习策略的性能比较:横轴为斑块尺寸、纵轴为识别率,每条曲线是一个身份数(10–40),误差条为 15 次随机运行的标准差;每图右侧嵌入全部配对比较的 p 值色块矩阵(星号标记 p < 0.05/0.01/0.001)。A 为 Within 学习,B 为 Between,C 为 Natural。读图要点:A 组曲线整体最高、且中间尺寸处出现明显的谷-峰形态(4×4 最低、12×12 附近最高),C 组曲线平坦。这是主要结果第 3 条的主图。
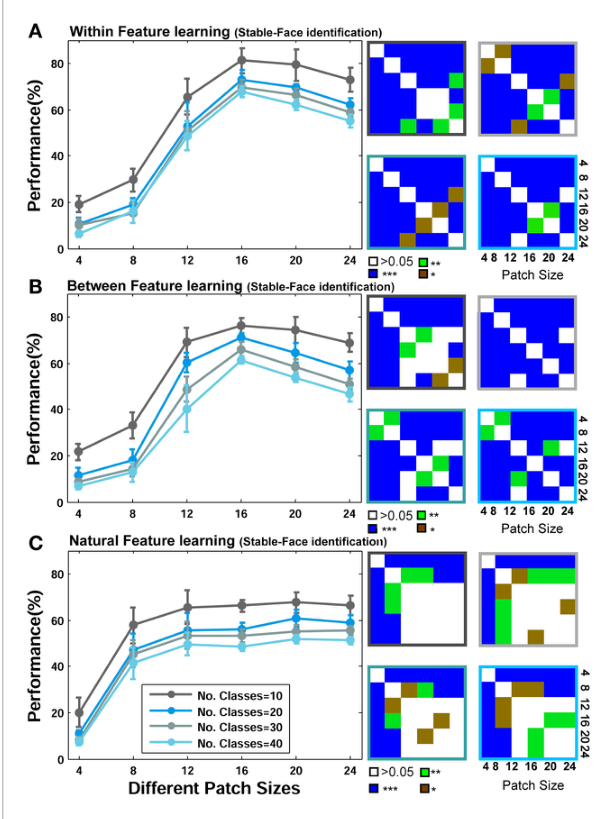
图 6 · HMAX 的人脸识别成绩曲线
原文图注:FIGURE 6 | Performance comparisons between different patch sizes and feature learning strategies for the HMAX model in face recognition task. (A) Comparing the performance of the HMAX model when uses face images from identical identities to test images but with different views in feature learning phase. Each curve shows the results of different number of classes/identities that vary from 10 to 40 (specified with different colors). The results are the average of 15 random runs and error bars are standard deviation. …(图注较长,此处截断)
与图 5 同构的 HMAX 版本,用于双模型互证。其峰值区间略向左移(8×8 已可用),但"4×4 失败、中间尺寸显著占优、自然词典下各尺寸无差"的形态与 Stable 一致。支撑主要结果第 1 条(两模型一致)与第 3 条(尺寸效应跨模型成立)。
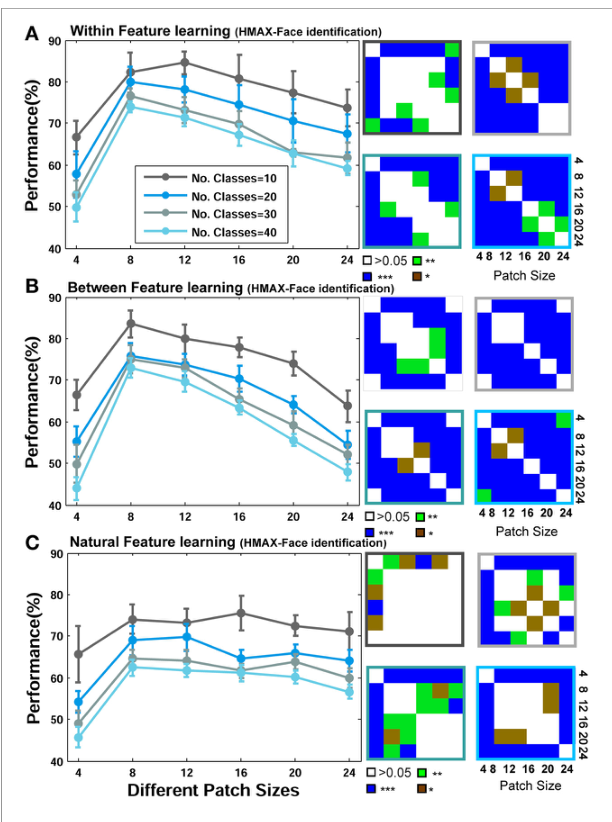
图 7 · 人脸任务中学习策略与尺寸聚合的箱线图
原文图注:FIGURE 7 | Comparing the performance of the Stable model as well as HMAX in different feature learning strategies in face recognition task. (A-left) The performance of the Stable model when all patches contribute to overall performance in face identification task for 10-class identification task. The dark gray boxplot shows the performance of the model when feature are learned from natural images. Pale gray boxplot represents the performance once model uses a different set of face images for learning visual features and the cyan boxplot illustrates the performance of within category feature learning strategy. …(图注较长,此处截断)
10 个身份的人脸识别箱线图组:左列把全部尺寸的斑块聚合,比较 Natural(深灰)、Between(浅灰)、Within(青色)三种策略;右列只聚合中间尺寸;C 组则以双色箱线图对比"全部尺寸"与"仅中间尺寸"在每个策略下的差别。读图要领是箱体位置与组间 p 值标注(红色叉为离群值)。它把"人脸识别需要类特异特征+中间尺寸"简化为两组显著性结论,支撑主要结果第 2、3 条。
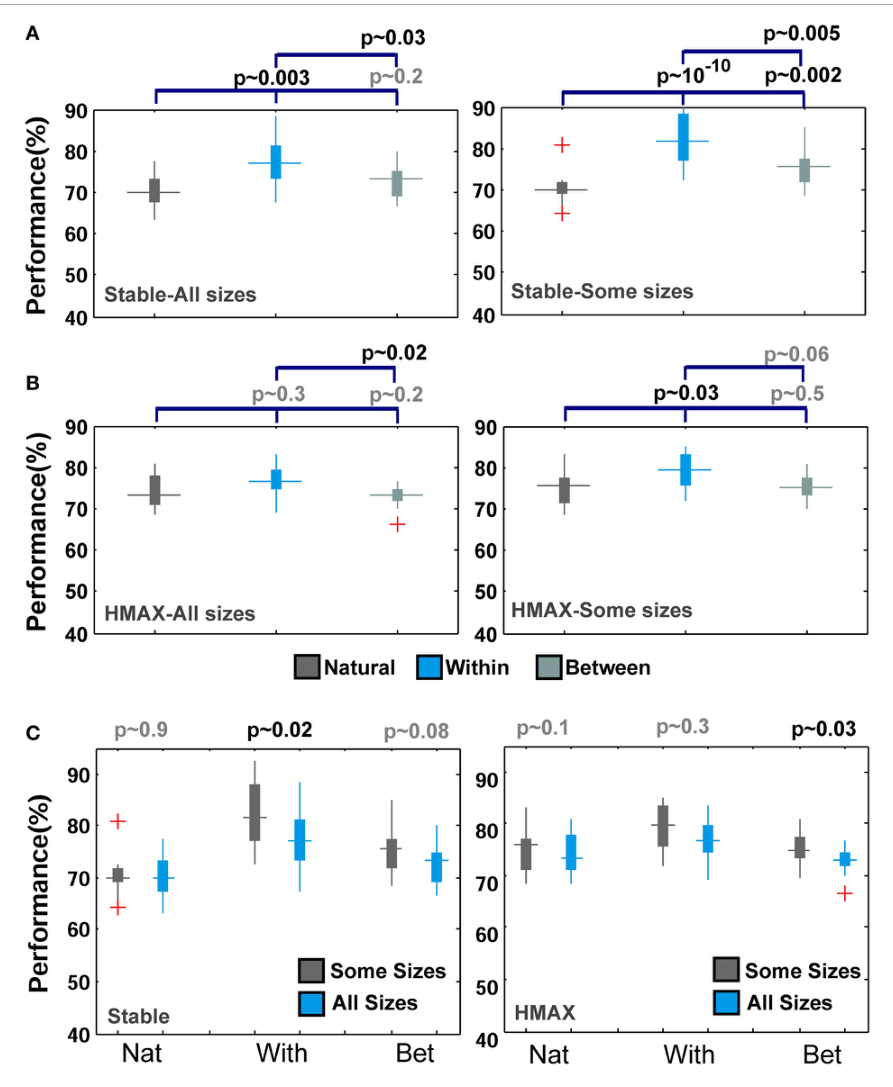
图 8 · 表征差异矩阵与选择性指数
原文图注:FIGURE 8 | Representational dissimilarity matrices for different patch sizes, computed for the Stable model. (A-top row) Dissimilarity matrices for face identification task averaged over 15 random runs for different patch sizes. Each matrix shows the dissimilarity between feature vectors of four different identities of a test view of 67.5◦. The matrices are the size of 12∗12 because there were three face images for each angle (here 67.5◦), see Figure 3. …(图注较长,此处截断)
表征差异矩阵全景:上排为人脸任务(四身份、每身份三张 67.5° 视角图,矩阵 12×12,对角线上每 3×3 方块代表一个身份内部的特征差异),下排为物体任务(四类别每类 50 图,矩阵 200×200,对角线上每 50×50 方块为一个类别),均按斑块尺寸逐列铺开并做 15 次随机运行平均;B 小图为据此计算的 selective index(人脸取 22.5° 与 67.5° 两个测试视角)。人脸一排中,中间尺寸下对角方块明显更"蓝"(同身份更相似),物体一排各尺寸差别不大。这是主要结果第 4 条唯一的证据图,也是全文从行为层面(识别率)转向表征层面(特征空间结构)的枢纽。
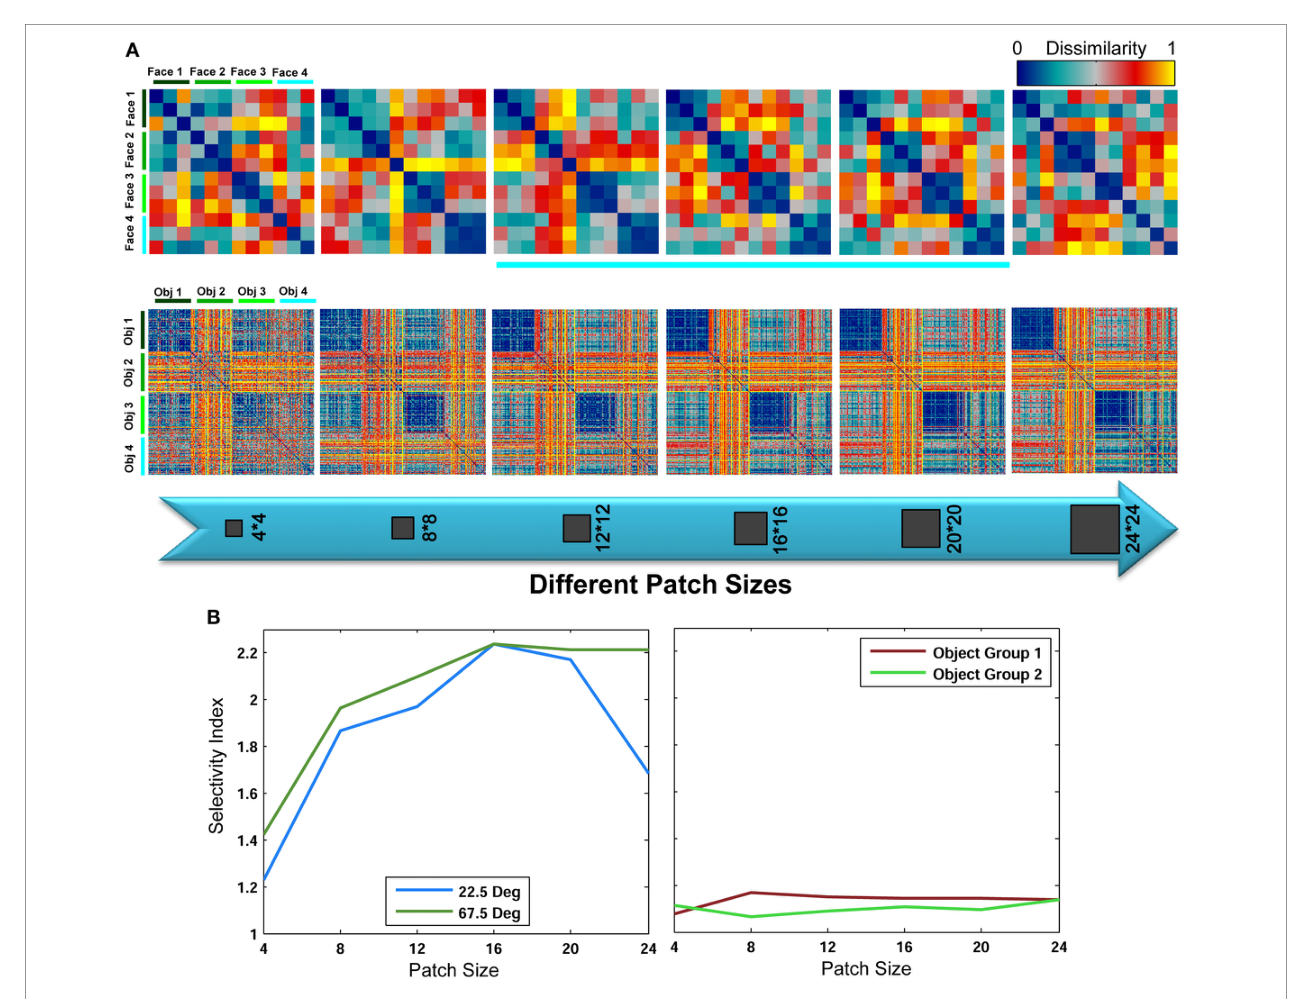
图 9 · 物体识别的性能曲线
原文图注:FIGURE 9 | Performance comparisons between different patch sizes and feature learning strategies in object recognition task. (A) Performance comparison between different patch sizes for the Stable model when uses natural images in feature learning phase. Each curve shows the result of different number of classes that vary from 2 to 40 (specified with different colors). The results are the average of 30 random runs and error bars are standard deviation. …(图注较长,此处截断)
物体识别任务(Caltech-256,每次 30 次随机划分)的四联图:A/B 为 Stable 模型在 Natural 与 Within 策略下的成绩曲线,C/D 为 HMAX 的同型结果。与图 5 对照可读出反差——曲线随斑块尺寸的变化平缓许多,仅 4×4 显著低下;各曲线(类数 2–40)之间的差异主要来自类数而非尺寸。这是主要结果第 5 条的证据主图。
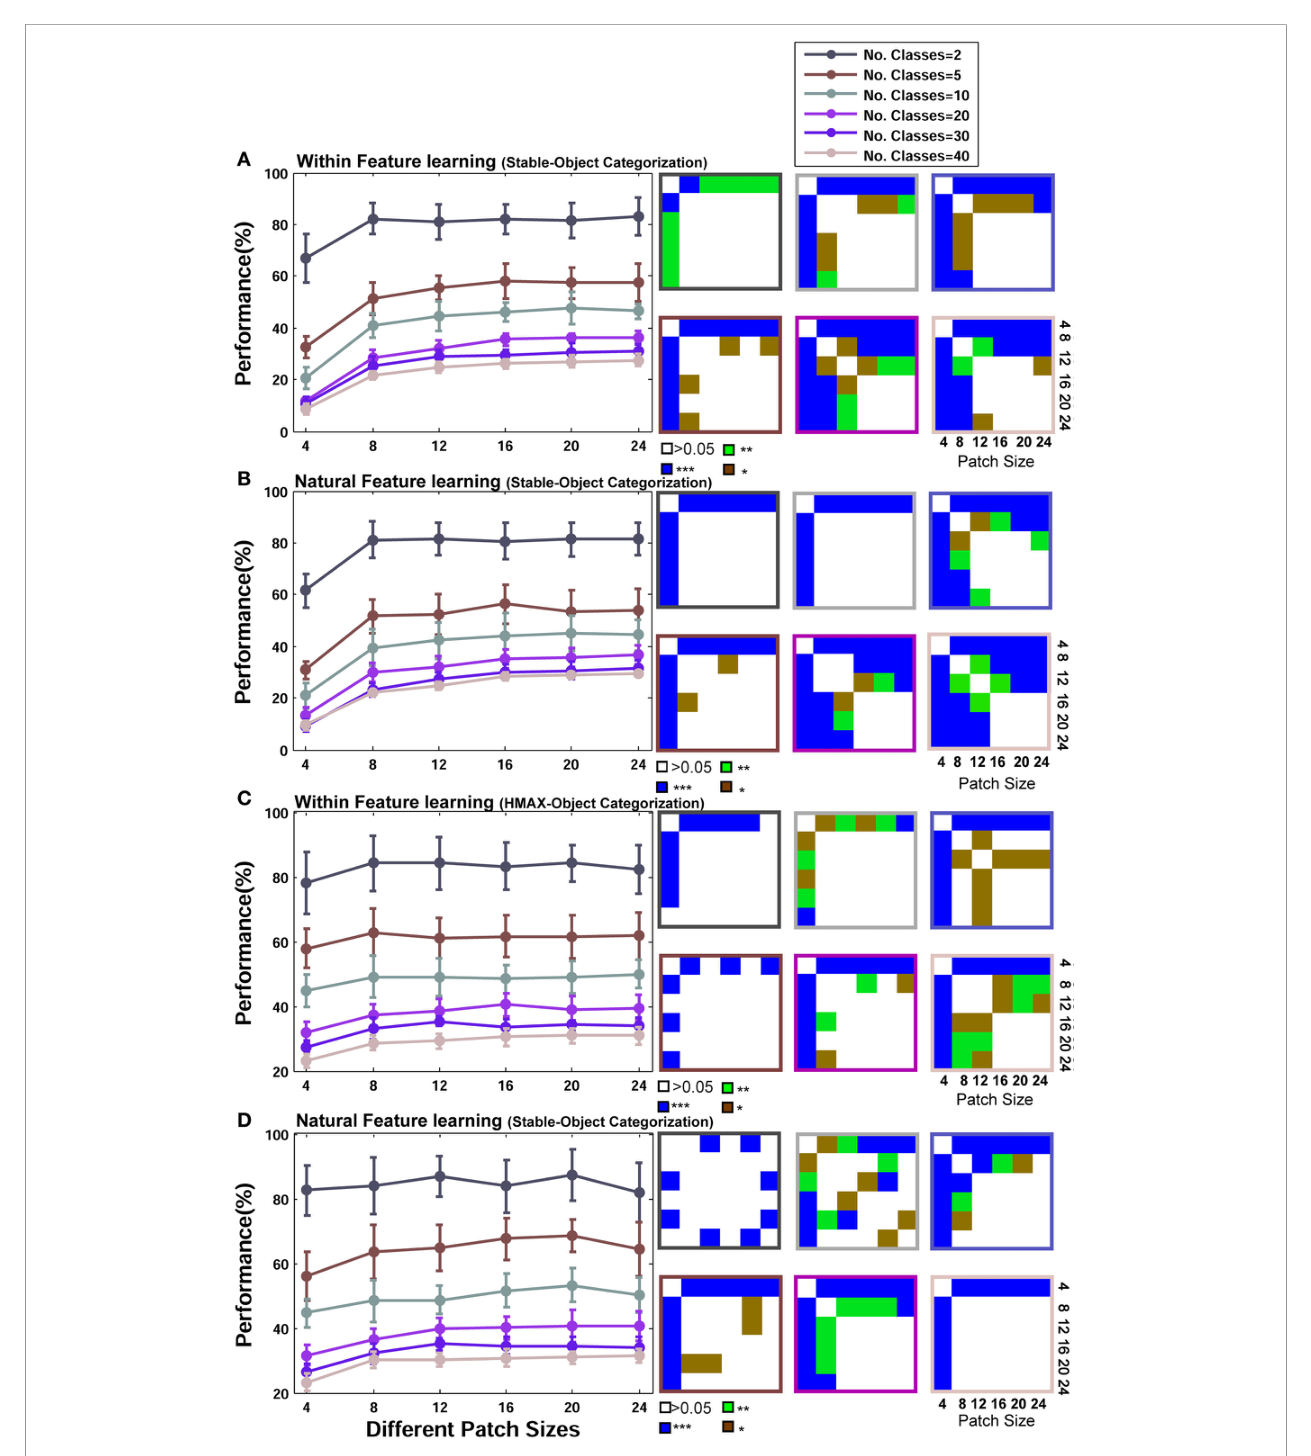
图 10 · 物体识别中学习策略的聚合比较
原文图注:FIGURE 10 | Performance comparisons between different feature learning strategies in object recognition task. (A) The performance of the Stable model when all patches contribute to the overall performance in object recognition task for different number of classes. The cyan boxplot shows the performance of the model when feature are learned from natural images and the gray boxplot demonstrates the performance for within category feature …(图注较长,此处截断)
物体识别下的策略箱线图组:A/C 为全尺寸聚合,B/D 为仅中间尺寸聚合,Stable 与 HMAX 分别成行。要点是青色(自然特征)与灰色(Within 特征)的箱体显著重叠、p 值不显著——与图 7 中人脸任务形成鲜明对照,直接支撑"通用词典对类别间识别足够"的结论(主要结果第 5 条)。
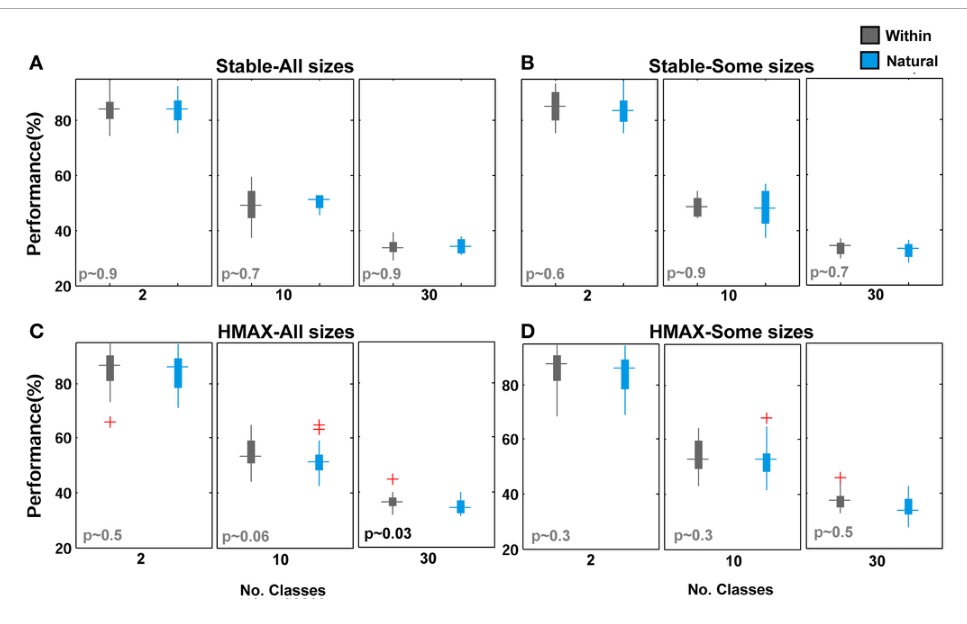
图 11 · 实际学到的特征斑块样例
原文图注:FIGURE 11 | Samples of extracted patches. (A) Extracted patches in different sizes for object categorization task. (B) Extracted patches in different sizes for face identification task.
两列带状图:A 为物体分类任务学到的各尺寸斑块样例,B 为人脸识别任务的对应样例。作为唯一的定性图,它把抽象的"特征词典"具体化:人脸任务的斑块多是覆盖眼睛、嘴唇等部件乃至大半张脸的中间尺寸碎片,而物体任务的斑块取样在尺寸分布上更均匀。它的作用是把前两图描述的统计差异展示成肉眼可见的样子。
讨论
作者的核心论证是"分工论":类别内识别需要有能力辨别高度相似物体间的细微差别,这在模型中只有靠高选择性的单元(放大单元的调谐尺寸,即 patch size)才能实现,恰与面孔在皮层中被整体加工的心理学证据同构;而类别间识别不需要这样的专门单元,一个由真实世界众多物体特征组成的分布式词典让某类物体"调用"词典中的一小部分即可。Stable 模型"自发"把中大型尺寸留给面孔任务这一细节,被用来说明无监督学习的自由运行会自然滑向专家模块式的解。作者还把面孔类比推广到泛化的专家机制:普通人初见两只相似宠物犬未必分得清,养犬者却轻易做到(Tanaka & Taylor 的专长研究,1991),FFA 因而被理解为"专长区"而不仅是"面孔区"。局限方面作者相当坦率:模型是纯前馈的,省去了皮层中大规模自上而下的反馈投射对识别的调节作用,时机与空间的联合动态也未被建模(引 Cichy 等 2014);patch size 只是一个模型参数,"整体加工"这一争议概念不能被一个参数完全支撑;分布式对块状表征、语义表征对形状表征等问题依然存在。作者提议把 FFA 的建模细节与实验研究互补,作为下一步。
一句话总结
该研究将关于皮层是分布式还是模块化表征的讨论转化为特征抽取参数的系统检验:面孔辨别依赖中等尺寸的类特异特征,而类别间通用分类可由尺寸均匀的通用特征词典支持。前馈模型在分类性能上的表现为视觉特征组织的计算优势提供了定量参考,而真实的皮层环路机制仍需结合生理实验进一步验证。