这篇文章用一套针对信号丢失优化的 fMRI 采集方案,第一次在健康人脑中稳定地显示出对视觉阿拉伯数字有选择性的皮层簇——视觉数字字形区(visual number form area, NFA),并证明它在左右两半球都存在。此前 NFA 只能靠颅内脑电(electrocorticography, ECoG)在少数癫痫病人身上确认,常规 fMRI 因岩骨附近的磁化率伪影一直无法可靠定位。因此这篇既有方法学价值(一套对抗信号塌陷的可复用配方),也是"文化上新习得的符号是否拥有专属脑区"这一问题的直接证据。
研究背景
数字加工在日常生活中无处不在,但与阅读一样,这门技能在人类历史上出现得太晚,不太可能由演化塑造出专门的神经机制(Dehaene and Cohen, 2011)。近年的研究却发现,脑内确实出现了针对新习得符号的选择性区域:加工字母的字母字形区(letter form area, LFA;Thesen et al., 2012)、加工词的视觉词形区(Cohen et al., 2000),以及 Shum 等(2013)用 ECoG 在颞下回(inferior temporal gyrus, ITG)发现的、对数字反应强于假数字和字母的 NFA。有趣的是,三重编码模型(triple-code model)早在 1995 年就预测过视觉阿拉伯数字形式的表征应当双侧存在(Dehaene and Cohen, 1995;Cohen and Dehaene, 1995),甚至猜测两个半球可能支持不同的任务。
缺口在于:fMRI 从未能在健康被试中可靠地定位 NFA。原因很可能是 NFA 恰好位于岩骨(petrous bone)气/骨界面附近,磁化率变化导致体素内磁化完全去相位,颞叶尾-腹侧出现强烈的信号塌陷(signal dropout)(Shum et al., 2013)。绕开这个问题的既有做法都有代价:Shum 等只能用侵入性 ECoG,且因左侧植入电极的病人只有 2 名而把分析集中在右半球;Abboud 等(2015)在先天盲被试上做 fMRI 时直接剔除信号最低的体素,虽然右半球 ITG 找到了激活,左侧同源区却没能通过多重比较校正。于是"数字表征是否双侧、健康脑里能否直接看到"仍然悬而未决。
研究思路
作者的策略不是丢弃坏数据,而是在源头把信号做好:用 64 通道头线圈提高信号强度,把体素缩小到 1 mm 各向同性以减少体素内去相位,加 GRAPPA 并行采集与基于 B0 场图的局部匀场(localized shimming),最后用较大的 8 mm 高斯核平滑来拉高时间信噪比(temporal signal-to-noise ratio, tSNR)。逻辑链是:先在群体水平用全脑分析显示 NFA 位置;再在个体水平定义感兴趣区(region of interest, ROI),用"定位 run 与提取 run 分离"的设计避免 double-dipping(循环分析),从而细致刻画 NFA 对每类刺激的反应轮廓;同时拿 LFA 做特异性对照——如果同样的流程只在左侧找到 LFA 却双侧找到 NFA,就说明双侧性不是成像流程的伪结果。实验 3 则系统检验这套配方里哪些环节是必须的。
方法
实验 1 招募 24 名右利手健康志愿者(因技术问题与头动过大各排除 1 名,实际分析 22 名)。刺激分 7 类:阿拉伯数字 N(0–99 之间取 40 个数字、4 种字体)、笔画部件被随机挪位拼成的假数字 FN、对数字做傅里叶随机化的噪声数字 NN,以及对应的字母 L、假字母 FL、噪声字母 NL,外加日常物体照片 O(取自 BOSS 库)。刺激按 20 秒的组块(block)呈现,每块 40 张图、每张 300 ms、刺激间隔 200 ms,被试做 1-back 重复侦测任务,共 3 个 12 分钟 run。扫描用 3 T Prisma fit 加 64 通道线圈,只覆盖枕颞腹侧 29 层,1 mm³ 体素,GRAPPA 加速 3 倍;扫描前依据 B0 场图对 NFA 预期位置做局部匀场(约 5 分钟);SPM12 预处理并做 8 mm FWHM 平滑。ROI 用第一个 run 按"数字 vs 所有其他刺激"(p<0.001 未校正)在个体上定义,双侧定位在 17/22(77.3%)的被试成功;反应轮廓从后两个 run 用有限冲激响应(FIR)模型提取 HRF 平台期,做半球 × 刺激的重复测量方差分析(ANOVA)与 Fisher LSD 事后检验。实验 2(16 人)只用 0–9 的单个数字与 10 个字母及其假/噪声版本,前两个 run 做定位(14/16,即 87.5% 双侧定位成功),后两个 run 只呈现数字、字母、假数字以刻画选择性。实验 3(13 人)在同样的定位范式下,比较高分辨率序列(1 mm、GRAPPA×3、带匀场)与常用的 3 mm 序列(带或不带匀场)在 NFA 峰值体素处的平均 BOLD 信号与 tSNR(平滑前后各算一次),做半球 × 序列 × 平滑的 ANOVA。
主要结果
- 全脑群体分析(图 2):数字 vs 假数字在两侧 ITG 均出现显著激活(右半球 MNI 61, -46, -18,216 个体素;左半球 -61, -54, -18,46 个体素);数字 vs 所有其他刺激同样确认双侧 ITG(右 175、左 3149 个体素),并附加双侧梭状回与早期视觉皮层激活。坐标与 Shum 等(2013)的 ECoG 结果(右半球 51, -54, -24)非常接近。
- 对照方面,LFA 只能在左半球梭状回稳定检出(-49, -59, -21,1033 个体素),与既往字母加工左半球优势一致;字母对比在右 ITG 只有一个未能被第二种对比确认的小簇——说明双侧 NFA 不是成像流程的通病(图 2)。
- ROI 分析(图 3):个体水平上,左右 NFA 对数字的反应都显著高于其余全部刺激类别(右半球 N vs FN p=0.006、N vs L p=0.009 等;左半球各项 p≤0.05);半球主效应与半球 × 刺激交互均不显著(p=0.67、0.47),说明两半球功能相似。值得注意的是,字母在左半球 NFA 中也高于假字母等刺激,右半球则没有这种效应。
- 实验 2(图 4):只用单个数字时结论不变——左右 NFA 对数字的反应仍显著高于假数字与字母(右半球 N vs FN p=0.008、N vs L p=0.007;左半球 p=0.006、0.02),且无半球差异,把数字选择性推广到最简的数字刺激。
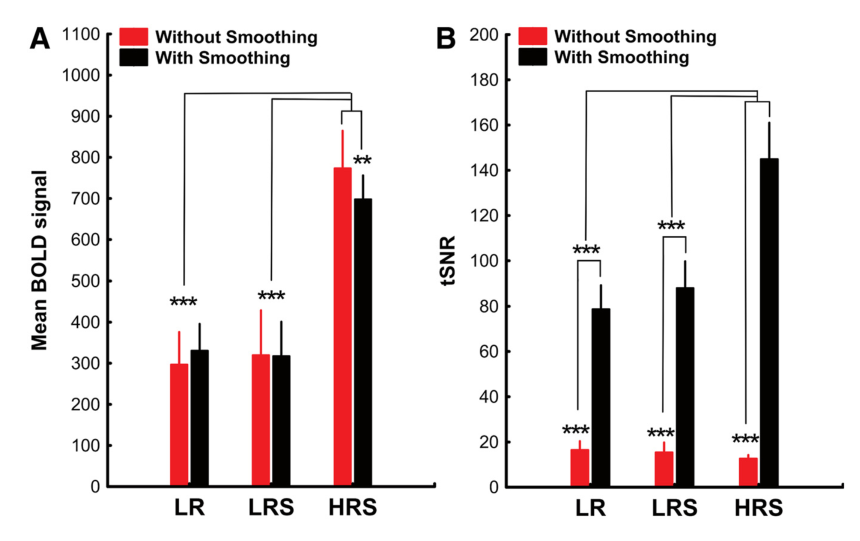
- 方法学检验(图 5、6):NFA 内平均 BOLD 信号在高分辨率序列下最高(对两种低分辨率序列均 p<0.0001),而加不加局部匀场几乎没有差别(p=0.92);tSNR 在平滑之前各序列相近,平滑之后高分辨率序列最高(均 p<0.0001)。真正起作用的是空间分辨率加平滑,而不是匀场。
图注解读
图 1 · 实验 1 使用的七类刺激
原文图注:Figure 1. Stimuli used in Experiment 1. N, L, O, FN, FL, NN, and NL were presented.
解读:这张图是刺激总览。N 为阿拉伯数字,L 为罗马字母,O 为日常物体照片;FN/FL 是把字符的 1–4 个笔画部件随机挪位拼成的"假字符",NN/NL 则是对真字符做傅里叶随机化得到的噪声图。三组对照的设计意图清晰:假字符检验字形结构本身是否关键,噪声图检验低层图像统计的贡献。它们为后文"NFA 对真数字的反应高于假数字与噪声数字"的选择性结论提供了刺激基础。
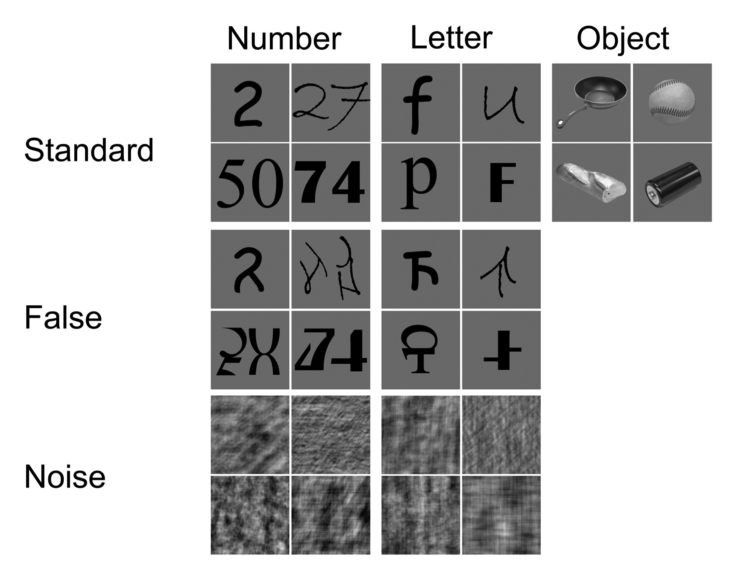
图 2 · 全脑水平上的双侧 NFA 与左侧 LFA
原文图注:Figure 2. Group analysis in Experiment 1. Significant activations were found in the right and left inferior temporal gyri when numbers were contrasted with false numbers and with all other presented stimuli. Further, we found significant activations in the left fusiform gyrus when letters were contrasted with false letters and all other presented stimuli. p < 0.05 (FWE), cluster extend ≥ 20 voxels.
解读:这是实验 1 的群体全脑结果,阈值为 p<0.05(FWE 校正、簇 ≥20 体素)。要点是"左右 ITG 同时出现数字选择性激活",而字母对比只给出左侧梭状回的 LFA。正文给出具体坐标:数字 vs 假数字在右半球 (61, -46, -18)、左半球 (-61, -54, -18)。这张图支撑主要结果第 1、2 条,是"双侧 NFA、单侧 LFA"这一不对称格局的第一层证据。
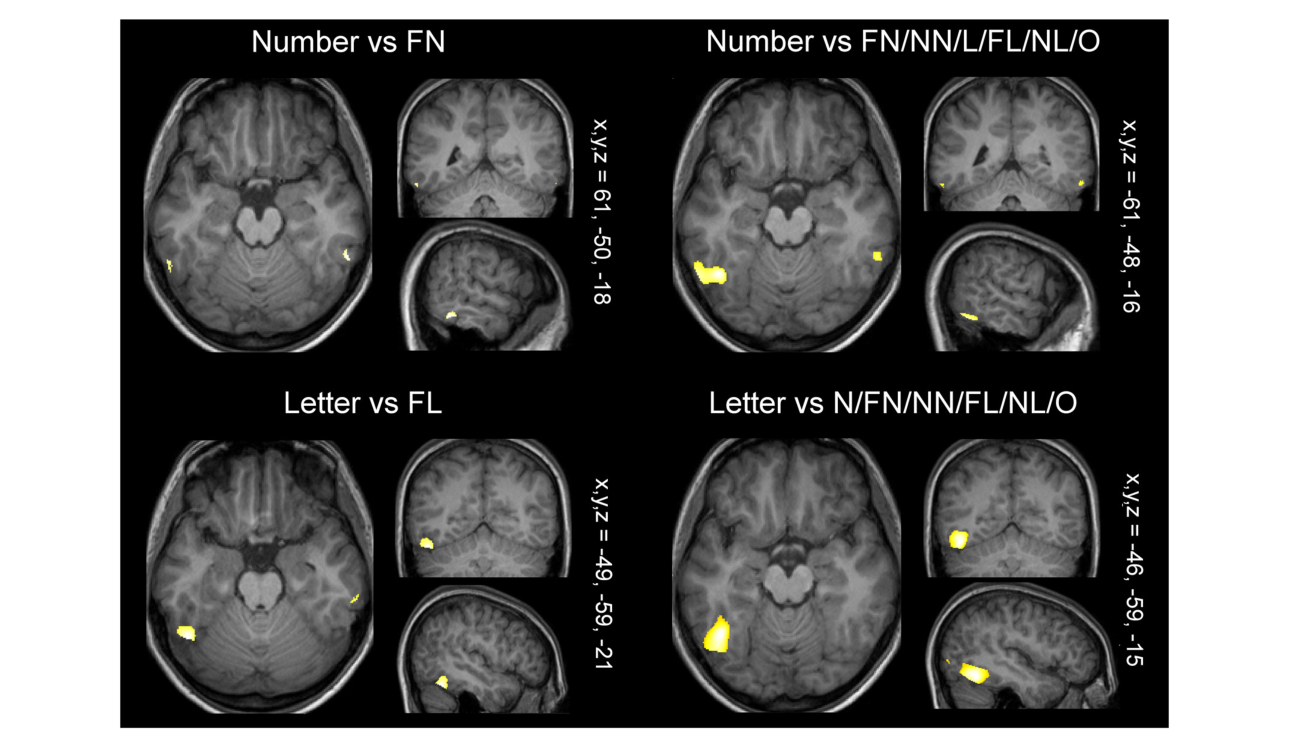
图 3 · 个体水平的 NFA 定位与反应轮廓
原文图注:Figure 3. ROI analysis in Experiment 1. A, Examples of the individual subjects' number-selective responses in the left and the right hemisphere. Results are based on the first run (contrasting numbers with all other stimuli, p < 0.001 (uncorrected)) and presented on the respective individual brain anatomy. B, All of the individual participants' NFA (blue) and LFA (red) clusters superimposed on each other. Purple marks the overlap of the two areas. Images were created using MRIcroGL (http://www.mccauslandcenter.sc.edu/mricrogl/). C, Comparison of the activations (p < 0.005 (uncorrected)) induced when contrasting numbers with all other stimuli between the three experimental runs (first run in blue, second run in yellow, third run in green, overlap in intermediate colors). D, ROI results. The right and left NFA respond stronger to numbers than to all other characters; conversely, the left LFA responds stronger to letters than to all other stimuli. RH, right hemisphere; LH, left hemisphere. p < 0.05; p < 0.01; **p < 0.001 (Fisher LSD).
解读:A、B 展示个体定位——每位被试在自己的解剖像上都能标出数字选择性簇,所有被试叠加后 NFA(蓝)与 LFA(红)位置相当集中,紫色是两区重叠的部分。C 用三个 run 分别做"数字 vs 其他"对比再叠加,验证一个 run 就足以定位 NFA,为"定位 run 与提取 run 分离"的分析设计提供依据。D 是核心柱状图:左右 NFA 中数字的反应显著高于其余所有刺激,左侧 LFA 中字母最高。此图直接支撑主要结果第 3 条(双侧 NFA、无半球差异)。
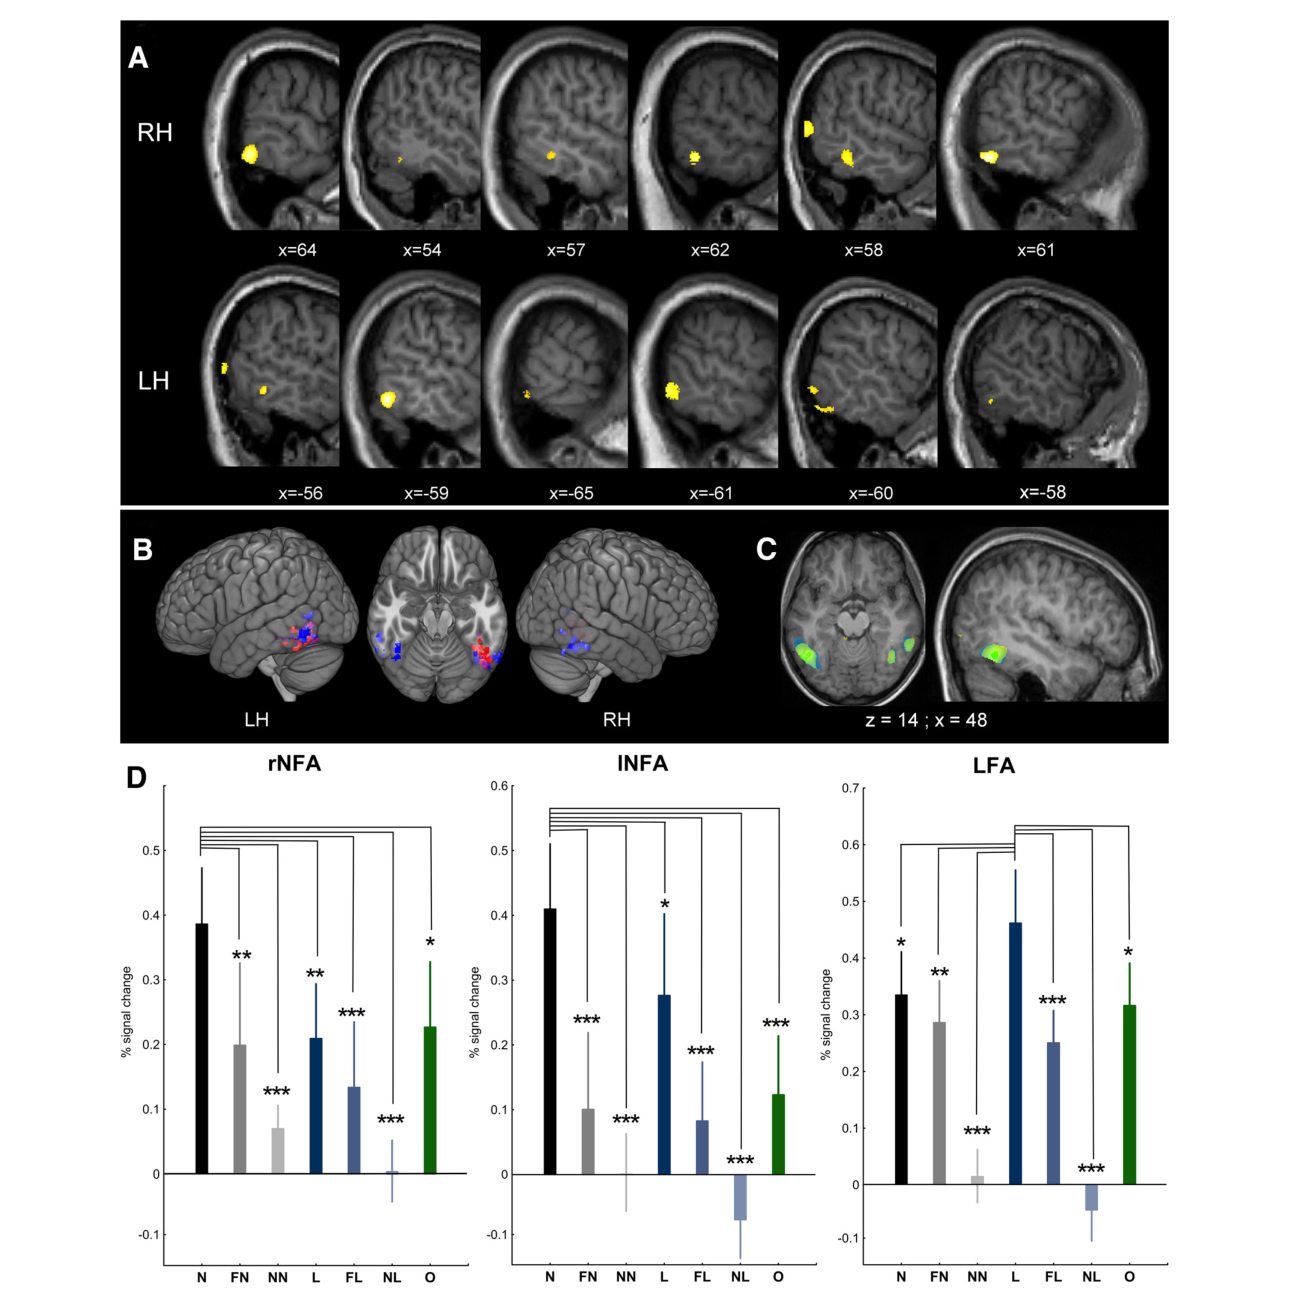
图 4 · 单个数字也足以驱动双侧 NFA
原文图注:Figure 4. ROI analysis in Experiment 2. The right and left NFA respond stronger to single-digit numbers than to false numbers and letters. p < 0.05; p < 0.01; **p < 0.001 (Fisher LSD).
解读:实验 2 排除了一种担忧:实验 1 的数字多为两位数,选择性会不会来自两位数特有的复杂性?这里只呈现 0–9。柱状图显示左右 NFA 对单个数字的反应都显著高于假数字和字母(事后检验标 , , **),且半球之间无差异。它支撑主要结果第 4 条,说明数字选择性不依赖多位数刺激。
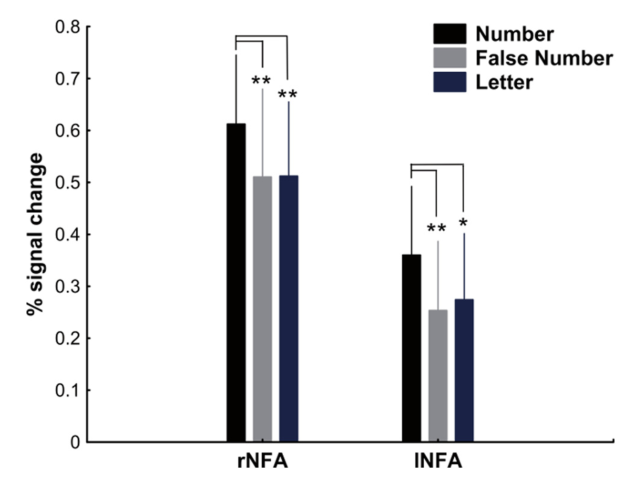
图 5 · 采集参数对全局信号质量的影响
原文图注:Figure 5. A, Visualization of the impact of spatial resolution, localized shimming, and smoothing on the global mean BOLD signal intensity and tSNR. The mean BOLD response is increased in the neighborhood of the NFA (approximate NFA location is marked by black circles) by the higher spatial resolution. The tSNR is generally higher with the lower resolution; however, this effect is not as severe near the NFA. Smoothing increases the tSNR, particularly in the high-resolution images, so that, after preprocessing the tSNR near the NFA is largest in the high-resolution images. Images were created using Caret (Van Essen et al., 2001). B, Example of the position of the recorded volume (yellow box) and of the area where the localized shimming was performed (green box).
解读:A 是全脑范围的平均 BOLD 强度图与 tSNR 图对比,黑圈标出 NFA 大致位置:高分辨率显著抬高了 NFA 邻域的 BOLD 强度;tSNR 在低分辨率下全局更高,但在 NFA 附近这种优势被抵消,平滑之后高分辨率图像在 NFA 附近的 tSNR 反而最大。B 用黄框、绿框标出实际采集的容积范围与局部匀场区域。这张图给实验 3 的方法学结论提供空间直观,支撑主要结果第 5 条。
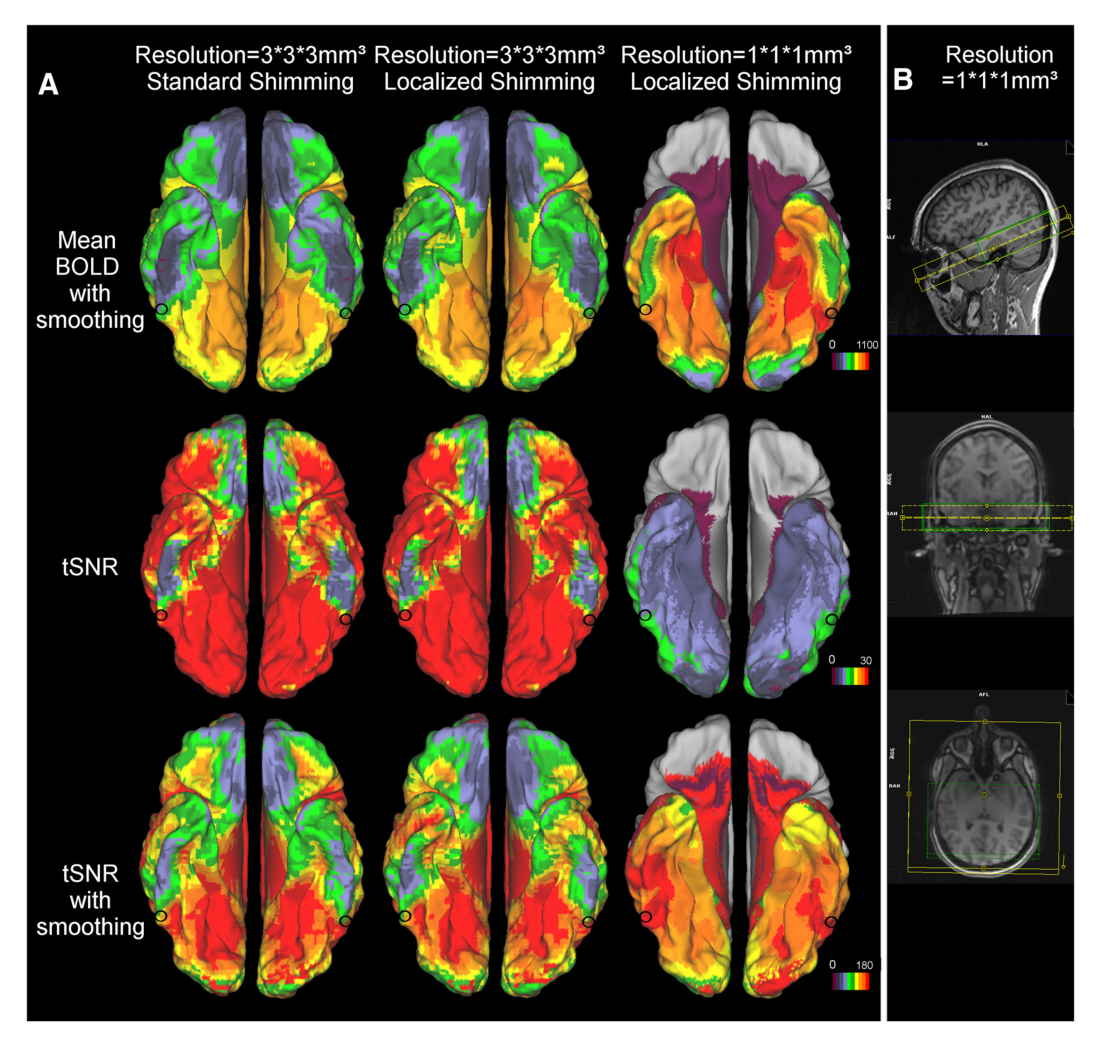
图 6 · NFA 内部:分辨率与平滑起作用,匀场不显著
原文图注:Figure 6. Influence of spatial resolution, localized shimming, and smoothing on the mean BOLD signal intensity (A) and tSNR (B) within the NFA. The mean BOLD signal is largest in the high-resolution images. Before smoothing, the tSNR is similar in the high-resolution and the lower-resolution images with and without localized shimming. After spatial smoothing was applied, the tSNR is largest in the high-resolution images. LR, lower resolution (333 mm3); LRS, lower resolution with localized shimming; HRS, high resolution (111 mm3) with localized shimming. p < 0.05; p < 0.01; **p < 0.001 (Fisher LSD).
解读:A、B 分别是 NFA 内的平均 BOLD 与 tSNR 柱状图,三种序列(LR、LRS、HRS)各分平滑前后两栏。关键读法:A 中 HRS 明显最高,而 LR 与 LRS 几乎一样(说明匀场没有带来增益);B 中平滑前三种序列的 tSNR 相近,平滑后 HRS 显著领先。这张图把"哪些步骤是必须的"讲清楚——真正起作用的是小体素加较大平滑核,支撑主要结果第 5 条,也是作者向神经影像社区推荐这套方法的主要卖点。
讨论
作者把核心发现归结为:健康成人脑中存在双侧的 NFA,坐标与既往病人研究几乎一致。对于先前研究偏右半球化的解释,作者给出多条:Shum 等(2013)只有 2 名左侧植入病人,本来就无力检验左侧;Abboud 等(2015)剔除低信号体素的做法可能把左半球残留的数字选择性体素清掉了,而本文的方法保全了整个枕颞皮层的采样;EEG 研究提示的右半球优势(Park et al., 2014)可能与任务有关——本文用简单的视觉 1-back 任务,测的是自下而上的输入驱动,而盲人的数数任务测到的可能是任务依赖的自上而下影响,两者值得后续对比。作者也坦承局限:为了 1 mm 分辨率牺牲了覆盖范围与时间分辨率(29 层、TR 2.5 s),无法同时采样与数量加工相关的顶内沟(intraparietal sulcus, IPS)。另一个值得注意的观察是:NFA 对"真字符"(无论数字还是字母)的反应都高于假字符与噪声图,作者列举了三种可能——NFA 也许一般性地调谐于"专长刺激"、NFA 与 LFA 空间上部分重叠导致选择性交叠、或真字母比假字母更像真数字——并留待后续研究。最后,作者把 NFA 的存在放进"个体学习重组皮层"的框架:猴子早年接受符号训练也能诱导出位置稳定的字符选择性簇(Srihasam et al., 2012),而 Hannagan 等(2015)提出 NFA/LFA 的位置由两个约束共同决定——IT 皮层本身胜任不变的形状辨别,加上两者不同的功能连接需求(LFA 接阅读网络、NFA 接数量表征网络)。
一句话总结
在我看来,这篇论文一半是方法学示范、一半是实证修正:一套"小体素 + 局部匀场 + 大核平滑"的配方让被磁化率伪影埋没的区域重见天日,而双侧 NFA 的出现恰好接上了三重编码模型二十年前的预测。我特别留意那个未解的细节——NFA 对假字符和噪声也有梯度反应——这提示它未必是纯粹的"数字区",按我的理解更可能是专长调谐皮层里对数字最敏感的部分。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[A, B, C, D] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[A, B] - Fig6: 提取质量
good,对齐度full,识别面板[A, B]
关键事实与局限性声明
- 补充要点: 实验 3 的 tSNR 分析存在显著的半球 × 平滑交互(F(1,11)=8.90, p=0.01):平滑的增益在左半球尤其明显。MD 只报告了主效应,遗漏了这一与『左侧 NFA 更难成像』直接相关的负结果/调节效应。
- 补充要点: 实验 1 的行为学数据未提及:噪声(傅里叶随机化)刺激的 1-back 成绩显著下降、反应时延长,且字母成绩优于假字母与物体——可作为刺激操纵有效性的佐证,属次要遗漏。
- 补充要点: 个体定位成功率的不对称细节:Exp1 中左侧 NFA 在 19/22 被试可定位、右侧 17/22(双侧同时成功 17/22),MD 只给出双侧成功率,未提单侧成功率差异。