一句话定位:针对传统单变量 fMRI 分析在被动观看时缺乏“数字形状区”(Number Form Area, NFA)数字偏好证据的问题,该研究重新分析了三组采用相同注视变色检测范式的数据集(共 88 例)。表征相似性分析(RSA)表明,在无任务相关注意要求下,后下颞回(pITG)多体素分布式反应模式仍能区分数字与其他字符类别;视觉形式模型的拟合失败则表明,该区域的主要编码维度并非单纯的低级字形几何特征。
研究背景
阿拉伯数字是基础的书写符号系统,但大脑如何从视觉输入中表征数字符号长期存在讨论。脑损伤病理研究曾推测腹侧枕颞皮层(ventral occipito-temporal cortex, vOT)存在专门参与数字识别的功能区;fMRI 研究在左侧梭状回定位视觉词形区较为稳定,但在数字偏好区的定位上存在分歧。颅内电生理记录(Daitch、Shum 等)与皮层电刺激研究(Roux 等)多将数字偏好反应定位于后下颞回(posterior inferior temporal gyrus, pITG)外侧;Shum 等(2013)发现该区域对结构相似的字母、打乱数字及语义/语音刺激的反应存在差异,推测其调谐于数字的视觉整体构型。既往常规 fMRI 未能稳定检出该区域,部分归因于 pITG 邻近骨-气界面的磁敏感伪影与信号衰减。
此外,任务需求被认为是调节该区域激活的重要因素。Grotheer 等(2018)发现重复检测任务中双侧 pITG 表现出数字偏好,但在数字、骰子与手指等不同形式的加法任务中未显现数字特异性偏好。Pollack 与 Price(2019)报道左侧 pITG 仅在任务要求检测数字时表现出数字偏好,当数字作为任务无关干扰项时偏好减弱。Price 与 Ansari(2011)在被动注视变色检测任务中,单变量全脑分析未发现 vOT 存在显著的数字偏好激活。因此需要进一步检验:被动观看状态下缺乏数字偏好激活,究竟是因为该区域严格依赖主动任务驱动,还是单变量平均激活分析对分布式信息敏感度不足。
研究思路
作者对三组共享相同被动观看范式与刺激集的既有数据集(Price & Ansari 2011、Price & Ansari 未发表数据、Merkley 等 2019;合计 88 例)进行整合与表征相似性分析(RSA)。其分析设想为:即使局部平均激活幅度在数字、字母与新异伪字间无统计学差异,体素间的分布式空间激活模式仍可能保留字符类别的区分信息。
作者以基于元分析定义的右侧 pITG 及其对侧同源区作为感兴趣区,提取 36 个字符诱发的激活模式构建 36×36 神经相异矩阵(RDM),并与 8 个理论模型 RDM 进行对比——包括 2 个视觉形式模型(像素重叠度、抽象形状距离)、4 个类别模型(熟悉度模型、字母数字 vs 新异模型、三分模型、数字 vs 其他模型)、1 个字母对照模型及 1 个亮度控制模型。若该区域专司数字识别,“数字 vs 其他”模型应表现出最高解释力;若主要处理几何外形,形状模型应更优。统计分析结合固定效应元分析与贝叶斯因子评估,检验正向支持或零假设的证据强度。
方法
实验任务为中央注视点变色检测:被试注视屏幕中央白色“#”,当其变为红色时按键,变为其他字符(数字、字母、打乱数字、打乱字母)时保持注视无需按键;字符呈现时间为 500 ms。数据集 1 包含 19 名右利手成人(女性 6 例,平均年龄 22.2 岁);数据集 2 包含 32 名纵向队列被试(女性 13 例,平均年龄 17.8 岁,包含 3 名左利手);数据集 3 包含 37 名右利手成人(女性 26 例,平均年龄 25.1 岁)。另有 7 例因头动超标剔除。刺激集包括 1–9 九个阿拉伯数字、9 个大写罗马字母,以及对应打乱重组的伪字各 9 个。作者控制并评估了刺激亮度和周边复杂度(perimetric complexity)。
fMRI 预处理采用 BrainVoyager 20.4(包含时间层校正、头动校正、高通滤波、配准及 Talairach 空间归一化,未做空间平滑)。在单被试水平通过 GLM 估计每个字符例证的体素激活 t 值。感兴趣区采用 Yeo 等(2017)元分析确立的右侧 ITG 簇(55 个体素)及左侧同源区。对每个 ROI,计算 36 个例证两两激活模式间的相关距离(1 − Pearson r),生成个体神经 RDM。随后计算神经 RDM 与各模型 RDM 之间的秩相关(Kendall's τa),并通过 Fisher-z 转换进行固定效应加权元分析,配合默认 Cauchy 先验(宽度 0.707)进行贝叶斯因子检验(BF+0>3 视为支持效应存在,BF+0<1/3 视为支持零假设)。
主要结果
- 左侧 ITG 同源区:元分析显示神经 RDM 与 8 个候选模型均无显著相似性,多数模型的 BF+0 低于 1/3(范围 0.09–0.33),支持零假设;相关系数均在 .001–.004 区间(图 4a、表 1)。
- 右侧 ITG:数字类别模型显著拟合,几何形状模型未获支持(图 4b、表 1)。元分析层面,形状距离模型被否定(BF+0=0.26);而三个包含数字与字母区分的类别模型均获得支持:字母数字 vs 新异(r=.0140, 95% CI [.0050, .0229], P=.002, BF+0=11.52)、三分模型(r=.0140, [.0066, .0214], P=.0002, BF+0=51.22)及“数字 vs 其他”模型(r=.0084, [.0026, .0141], P=.005, BF+0=13.64)。
- 数字敏感性与类别比较:元分析中“数字 vs 其他”模型对神经 RDM 的解释度约为“字母 vs 其他”对照模型(BF+0=1.27)的 10 倍。在仅保留真实数字与字母的 18×18 子矩阵分析中,数字与字母的区分效应依然存在。
- 数据集间一致性与差异:数据集 1 与数据集 3 中数字区分模型均达到显著水平(如数据集 3 中 Numbers v. Others 偏相关 τb=.0126, P=.021, BF+0=4.97)。数据集 2 各模型未达到显著判定界限(BF+0 在 1/3 至 3 之间,呈不确定状态),作者分析其可能与每字符仅 2 次重复及较短扫描时间导致的信噪比不足有关,且不排除样本年龄相对较低的影响。
- 解剖特异性:在对比的皮层区域中,仅右侧顶下小叶同样检测到微弱的“数字 vs 其他”模式相似性。多维尺度变换(MDS)直观呈现了右侧 ITG 内数字与其他字符的表征分离趋势(图 5)。
图注解读
图 1 · 刺激集与注视变色检测任务示意
原文图注:Fig. 1. Stimulus sets and a schematic of the fixation color change detection task. The current study analyzed only the trials with these sets of stimuli that were only presented for 500 ms. ITI: Inter-stimulus interval. Letters Set 1 was used in Datasets 1 and 2. Letters Set 2 was used in Dataset 3.
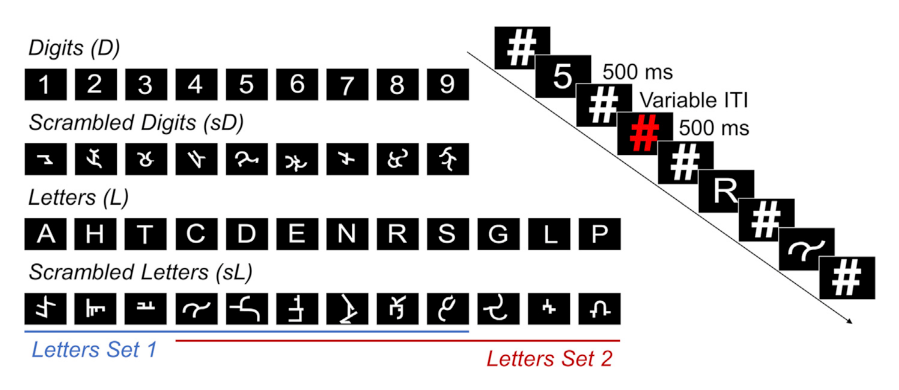
该图左侧呈现四类各 9 个字符刺激(数字、字母、打乱数字、打乱字母),右侧展示试次时间线结构:中央注视点变为红色时按键,呈现白色测试字符时无需反应,字符呈现时间均为 500 ms。图注说明数据集 1、2 与数据集 3 采用了不同的大写字母集。该范式确保字符的识别与分类并非显式行为任务,为检验自动化加工提供了实验基础。
图 2 · ROI 与 RSA 分析框架概览
原文图注:Fig. 2. Regions of interest (ROIs), and neural and candidate representational dissimilarity models (RDMs). (a) Numeral-preferring ROIs from the meta-analysis by Yeo et al (2017), and an example neural RDM (using correlational distance) constructed from the activation patterns evoked by 9 Digits (D), 9 Scrambled Digits (sD), 9 Letters (L), and 9 Scrambled Letters (sL) within the right ITG. IPL: inferior parietal lobule. IPS: intraparietal sulcus. SPL: superior parietal lobule. PMC: premotor cortex. IFG: inferior frontal gyrus. ITG: inferior temporal gyrus. (b) Candidate RDMs (using Letters Set 1 from Datasets 1 and 2; see Inline Supplementary Fig. S4 for Letters Set 2 from Dataset 3). All models presented are rescaled to [0, 1] for comparative visualization. (c) Multidimensional scaling plot of the correlational distance among the candidate models using Letters Set 1……
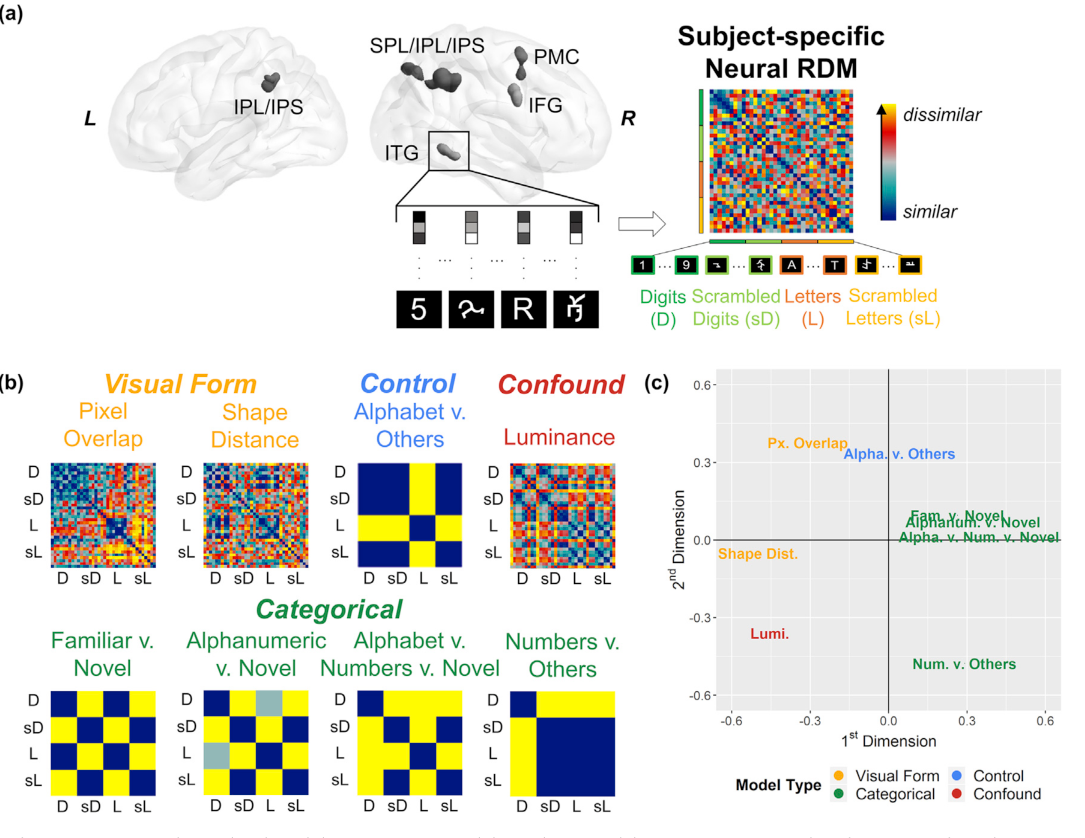
子图 a 展示基于 Yeo 等(2017)元分析确立的右侧 ITG 等感兴趣区位置,以及基于 36 个字符诱发的多体素模式构建的神经 RDM 示例;子图 b 展示 8 个归一化候选模型 RDM 的理论结构;子图 c 通过多维尺度变换(MDS)展示各候选模型间的相关距离。图像呈现了神经相异度与理论假设矩阵进行相似性计算的分析流程。
图 3 · 四个类别模型的编码示意
原文图注:Fig. 3 illustrates these four categorical models. The Familiar v. Novel model and Alphanumeric v. Novel model are based on the hypothesis that a region responds to all familiar characters (digits and letters) in a manner that is different from how it responds to novel characters (scrambled digits and letters). In the Familiar v. Novel model, digits and letters are indistinguishable. In the Alphanumeric v. Novel model, digits and letters are somewhat distinguishable, but are still more similar to one another than to novel characters (here we coded 0 for high similarity, 2 for high dissimilarity, and 1 for in-between). The Alphabet v. Numbers v. Novel model is based on the hypothesis that digits, letters, and novel characters are equally distinguishable……
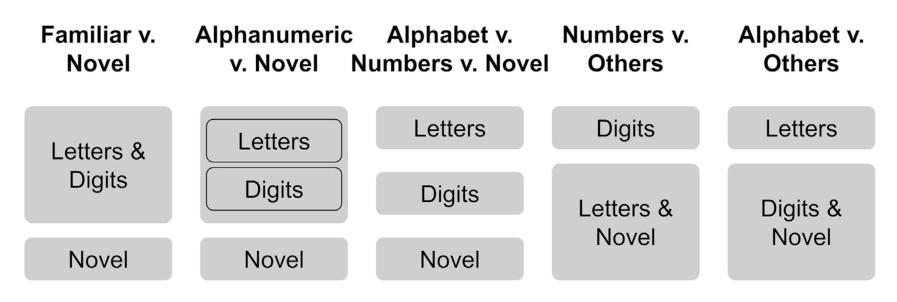
该图展示四种类别假设模型的矩阵结构:熟悉度模型(真实字符与打乱字符二分)、字母数字 vs 新异模型(保留不同层级距离)、三分模型(数字、字母、新异字符等距三分),以及“数字 vs 其他”模型(仅数字独立成类,字母与新异字符归为同类)。矩阵直观展示了不同类别编码假说的理论预期。
图 4 · 左右 ITG 神经-模型相似度的元分析汇总
原文图注:Fig. 4. Similarity between neural and model representational dissimilarity matrices (RDMs) in the candidate numeral-preferring regions in (a) left and (b) right inferior temporal gyrus (ITG). Blue bars indicate the estimated noise ceiling. Group means and standard errors of the similarity are indicated by the bar plots with error bars. Individual data points are shown as grey dots. Evidence of similarity is indicated by black asterisk: p < .05, p < .01, **p < .001, one-sided, uncorrected. Blue asterisks indicated results that remained significant with FDR correction. BF+0 = Bayes Factor [rz > 0 vs. rz = 0]. Lines in meta-analytic plots indicate the 95% confidence interval around the overall weighted r.
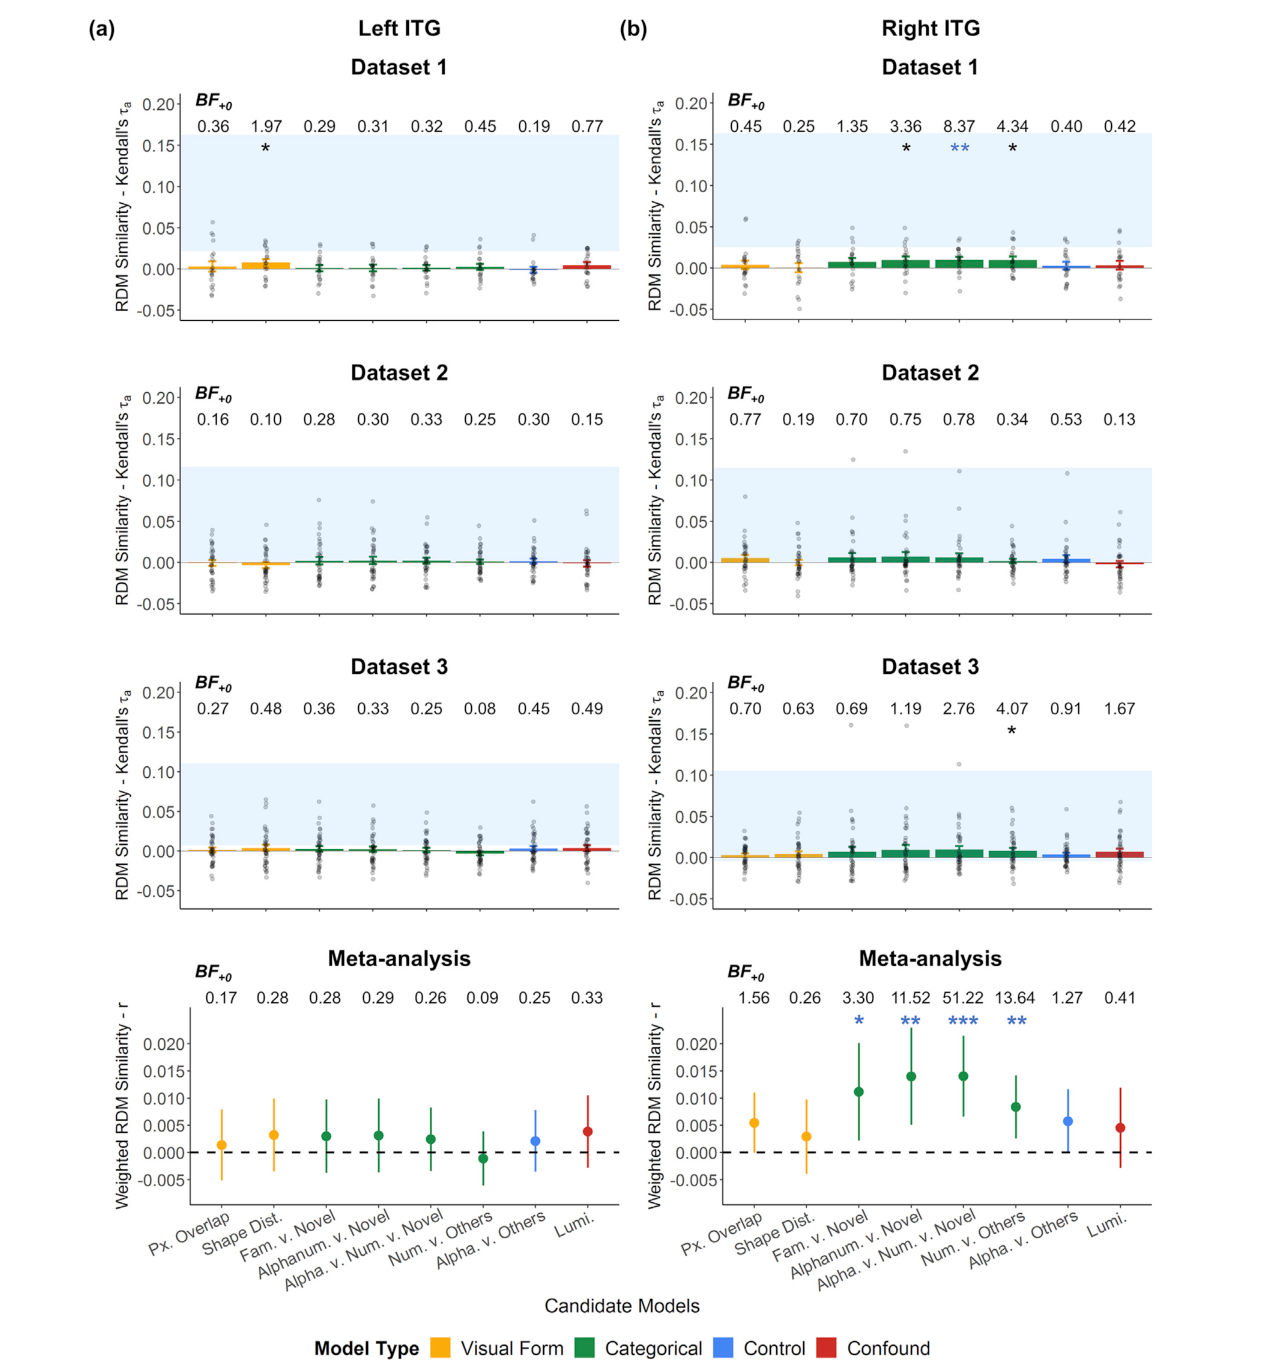
该图汇总左右侧 ITG 神经 RDM 与各候选模型的相似度统计:柱状图表示各数据集的均值与标准误,散点为个体值,标注贝叶斯因子 BF+0 与元分析合并效应量(95% 置信区间)。右侧 ITG(b)中数字类别区分模型显示出正向拟合效应,而形状模型与左侧 ITG(a)各模型均接近零值并支持零假设,反映出双侧半球在表征敏感度上的不对称性。
图 5 · 右 ITG 群体平均 RDM 与二维表征几何
原文图注:Fig. 5 illustrates the group-averaged dissimilarity matrix and representational geometry of the 36 characters in this region for each dataset. To further assess whether the three-way distinction (numerals, letters, and novel characters) observed using a model-driven approach could also be observed using a data-driven approach, we performed a k-mediods clustering analysis (Kaufman and Rousseeuw, 1990) for each dataset. Overall, evidence for a three-cluster structure was not strong in all datasets, but consistent with our findings above, there exists a cluster that showed a slight dominance of numeral representations in both Datasets 1 and 3……
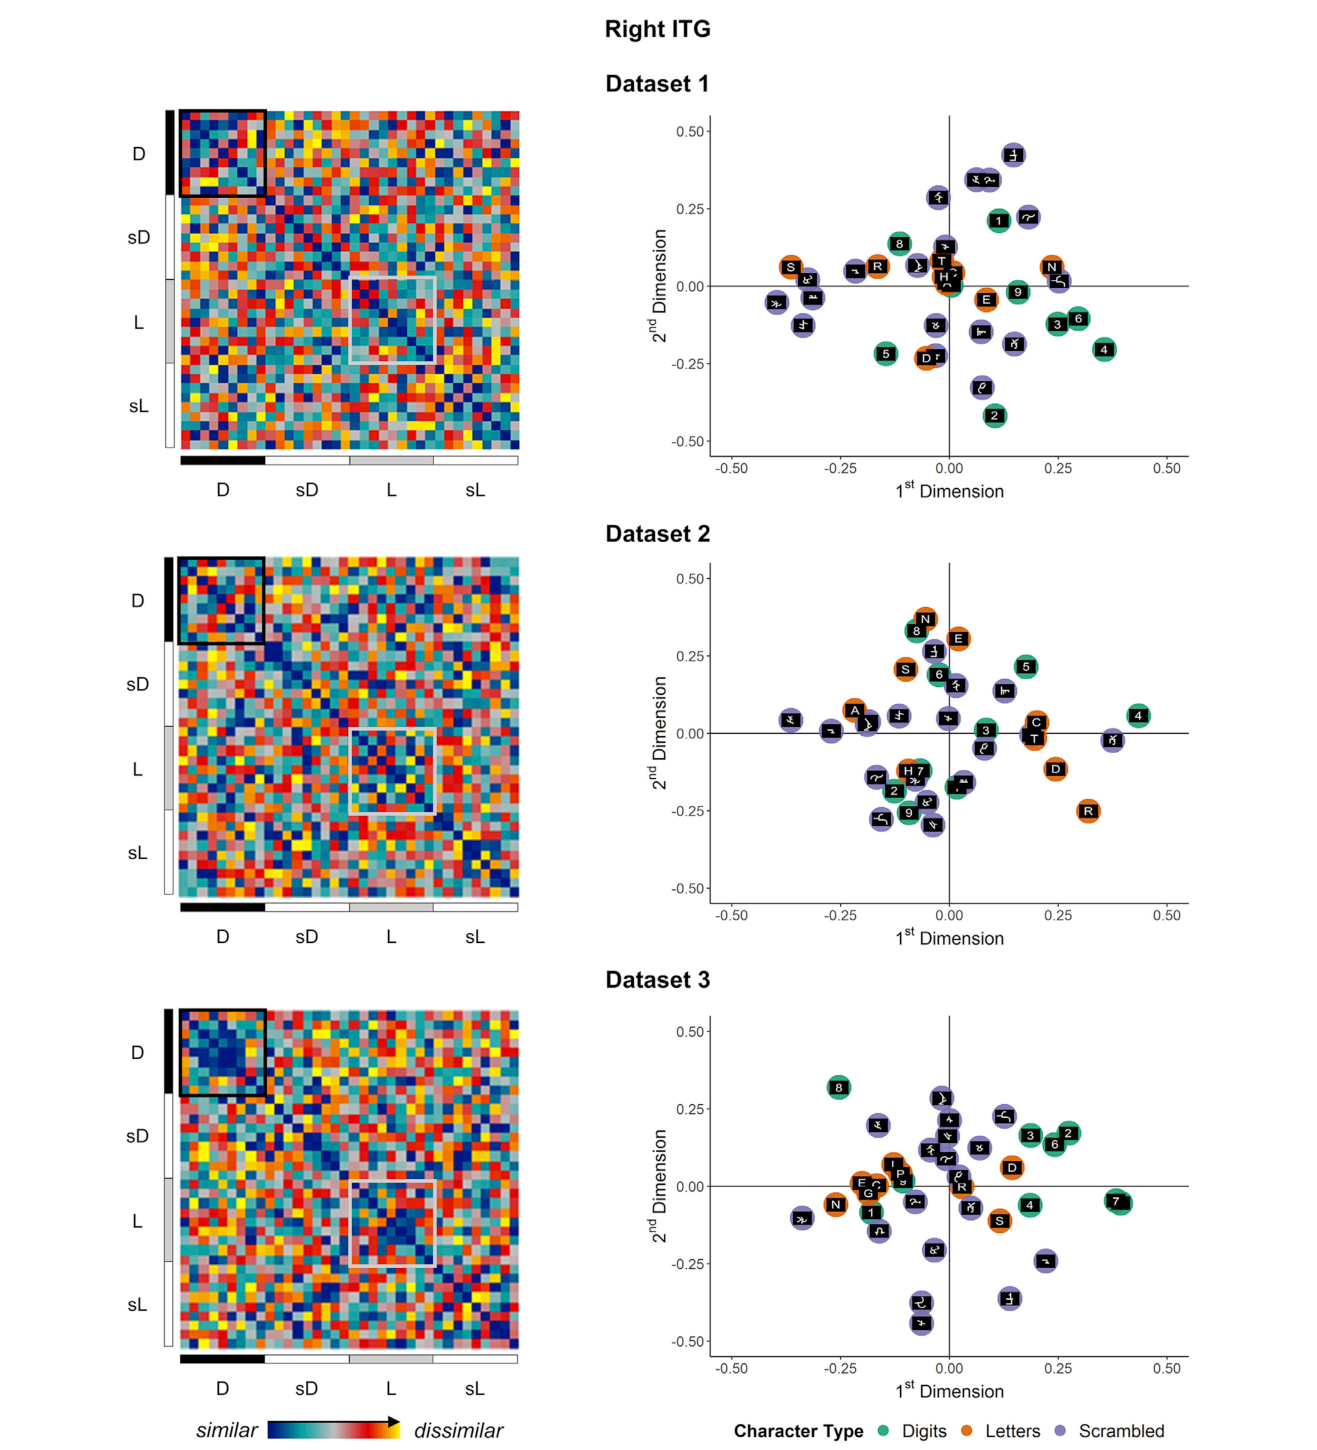
该图按数据集呈现右侧 ITG 内 36 个字符的组平均 RDM 热图,以及投影到二维平面的 MDS 表征几何。在数据集 1 与 3 中,阿拉伯数字在空间分布上表现出一定的聚集趋势,与外部打乱字符形成分离,呈现出数据驱动的类别聚类形态。
讨论
作者结合实验结果探讨了后下颞皮层的功能特性。首先,在字符作为任务无关刺激的被动呈现条件下,右侧 pITG 的分布式激活模式仍表现出对数字类别的统计区分度,表明该区域对数字符号具有一定的自发加工倾向,为理解既往单变量分析的阴性结果提供了方法学层面的补充。其次,视觉形状几何模型未能有效解释该区域的表征结构,表明其编码基础超越了简单的像素轮廓重叠。据此,作者建议将该候选区域称为“下颞数字区”(Inferior Temporal Numeral Area, ITNA),强调其对数字这一特定符号范畴的表征作用。
半球不对称方面,效应主要定位于右侧 pITG,而左侧同源区在被动条件下未表现出对应表征,这与部分关于正字法与算术网络偏侧化发展的报道相符。研究局限性包括:分析基于既有被动观看数据集展开,单字符试次量相对较少,信噪比限制了效应量水平(合并 r 约 .008);数据集 2 受到较短采集时间的限制,未达到明确的统计决断阈值;当前分析主要基于预设的元分析解剖掩模,个体化解剖定位的变异仍待进一步明确。
一句话总结
该研究通过表征相似性分析重新评估了被动观看 fMRI 数据,表明右侧后下颞回的多体素激活模式在无需显式分类任务时仍包含数字符号的类别区分信息,且该编码不受单一字形几何模型的充分解释。