这篇会议综述来自 DiCarlo 实验室,提出并把"腹侧视觉流"研究拆成两个可以分别证伪的数量化模型:编码模型(encoding,视网膜像素 → 神经群体活动模式)与解码模型(decoding,神经群体活动 → 行为选择)。文章报告了截至 2014 年的两条主线进展——基于 IT(inferior temporal cortex,下颞叶皮层)群体活动的简单线性解码足以预测人类在 64 个识别任务上的全部成绩模式,以及用光遗传学与药理学直接压制 IT 亚区可以因果性地验证这一解码模型——同时在编码一端展示了性能优化的层级卷积神经网络(HCNN)预测 V4/IT 神经反应的能力。值得精读之处在于它示范了"生成模型 + 因果扰动 + 行为闭环"这一整套研究范式。
研究背景
视觉物体识别的核心挑战在于:同一物理类别的刺激在视网膜投影中的位置、视角、尺度及背景可能大幅改变,但生物系统依然能稳定辨识其身份。视网膜输入提供的是底层像素明暗变化,而行为决策需要的是对外部物体身份的不变性表征。腹侧视觉流自 V1、V2、V4 至下颞叶皮层(IT)被认为通过逐级非线性重采样,逐步转化此类高维变化,使得层级顶端的群体活动相比于底层像素更容易支持简单分类。在此框架下,产生出两个必须明确区分的科学问题:视觉图像如何转化为 IT 皮层的神经群体响应(编码问题),以及 IT 群体响应如何进一步转化为具体的行为选择(解码问题)。如果仅证实部分 IT 神经元对面孔或特定物体具备调谐选择性,尚不足以证明该放电模式在因果上直接驱动了识别行为。
连接假说的成立需要经受更严格的行为模式约束。简单的类别二分类任务若借助色彩或低级纹理即可达成,便无法有效检验空间变换不变性;唯有将任务难度提高至诱发稳态行为错误,并系统比对跨任务、跨受试者的行为难度分布,方能判别某种神经码是否充分覆盖了核心物体识别行为。另一方面,即使特定神经元群体的离线解码准确率极高,亦可能仅仅反映其与下游运动环路共享了输入信息,而不必然构成行为决策的因果基础。因此,因果干预实验不可或缺:在局灶性失活特定 IT 亚区后,行为损失若能精准预测于其局部神经信息可分性,便能将“信息可读出”与“信息被下游使用”在逻辑上连接起来。在编码端,则可借助性能优化驱动的深层层级卷积神经网络(HCNN)检验:以纯粹机器任务表现为优化目标的计算模型,是否会自然涌现出对生物 V4 及 IT 皮层神经放电的高预测力。
Afraz 的会议综述将上述多条证据线索整合进统一的计算神经科学研究范式中。在解码端,首先系统评估多种候选神经编码方案,探寻能够定量再现人类识别全套难度模式的极简线性读出机制,继而借助光遗传学与药理学微量注射,检验局部 IT 组织失活与行为损伤之间的空间与定量对应关系。在编码端,通过高通量筛选层级卷积网络,检验任务识别性能与神经预测力之间是否普遍正相关。该范式旨在构建自底层像素至 IT、再由 IT 贯通至行为决策的可证伪闭环,同时明确保留了两项理论边界:相关编码模型仅能解释部分神经方差,因果扰动实验亦主要集中于特定亚区与判别任务;而在涉及长时程记忆、自上而下注意力调控及复杂连续交互的视觉行为中,反馈投射与皮层循环动力学依然发挥着不可替代的作用,不可被纯前馈模型完全替代。
研究思路
作者的总体研究逻辑分为两步:首先确立解码机制(“神经群体放电 → 行为选择”),因唯有将该映射关系精确约束后,方能明确应为哪些特定的 IT 神经元亚群与何种表征属性构建底层的编码模型。解码端的研究包含两阶段:第一阶段采用严密的相关性对比筛选工作解码模型——系统比对数十种候选“神经码”(neural codes),检验哪种编码方式能够高保真拟合人类在全部 64 项核心识别测试中的相对难度梯度;第二阶段开展因果生理学检验——利用光遗传学抑制与药理学微量注射局灶性压制 IT 亚区放电,验证行为受损幅度是否严格符合工作解码模型的空间与定量预测。在编码端,则引入层级卷积神经网络(HCNN):仅以纯粹的自然图像物体分类准确率为优化目标,高通量筛选出高性能网络架构,继而评估其内部各隐藏层对灵长类 V4 与 IT 皮层神经放电的拟合预测力。
该实验体系构建了三重视角的方法学约束:心理物理测试经过参数校准以诱发稳态行为错误,从而支持跨条件错误模式的严密比对;神经电生理采集在猕猴被动注视范式下完成(其理论假设为:新任务学习主要发生于下游关联皮层,通过调整下游对腹侧流输入的突触读出权重实现,被动状态下的群体表征已蕴含行为决策所需的充分信息);因果扰动实验则锁定于高难度面孔性别辨别任务,完成定量的行为因果闭环检验。
方法
涉及三组数据。(1) 人类心理物理:用真实世界物体的 3D 模型(面部、汽车等,每类多个范例)经光线追迹渲染、贴在无相关背景上生成测试图像,测人类在一个八类基本水平分类任务(面孔、汽车、飞机、动物、桌子、椅子、船、水果)与两个下位八选项识别(汽车型号 Beetle/BMW z3/Ford 等;面孔 face1/face2 等)上的成绩,共 24 个标签 × 6 档身份保持的视角变化 = 384 个任务的 d′ 热图(图 2B)。(2) 猕猴电生理:两只猕猴在被动注视范式下观看同一套图像,大样本采集 V4 与 IT 的多单元/单点反应(IT 共 168 个位点用于编码分析)。(3) 因果实验:猕猴学会注视报告的性别判别任务后,分别用 200 ms 窗口的光遗传抑制和 muscimol 微量注射压制 IT 各小亚区(约 1 mm 直径)的活动,同时以被动注视下记录的多单元活动训练线性分类器,得到每个亚区的"局部线性分类"成绩作为该区的性别信息可分性。
解码分析中,作者把"神经码"操作化为 IT 平均放电率的不同组合方式(图 2 展示了 14 种候选码),对每种码计算它能预测的行为 d′(neural-predicted d′),与全部 64 个测试的人类心理物理 d′ 模式对齐比对;只有码本身、而非任何其他层面的模拟反应,若能覆盖全部任务的难度格局才算"充分"(图 2C 打星号者)。编码分析则以上一刺激后 70–170 ms 的平均放电率为"反应",在保留出测试集的系统上计算解释方差百分比(neural predictivity)。统计上,因果部分用重复测量 ANOVA 检验同侧/对侧视场与抑制方式的交互,相关部分报告相关系数与线性回归外推。
主要结果
- 解码模型:线性读出 IT 足以解释人类行为。在 14 种候选码中,只有基于 IT 群体平均放电率的简单学习型线性求和通过了"预测全部 64 个测试难度模式"的高门槛(图 2C 打星号的码);所有 V4 神经码、全部 V1 样模型的模拟码都失败。这把"IT 伺候行为"从一个定性联想升级为一个可证伪的全局预测,并直接排除了"行为难度由 V4 编码决定"等备择假说。
- 因果验证一:压制面孔选择亚区损害性别判别,且只在对侧视野。光遗传失活神经 d′ > 1(面孔 vs 其他物体)的 IT 亚区使对侧视野呈现面孔的性别判别成绩小幅而显著下降(中位数 1.8%,均值 2.02%,t(16)=5.99,P < 0.0001);muscimol 失活同类亚区造成 5.5% 的下降,同样仅限对侧,同侧视野成绩不变(交互检验 F(4,20)=7.5,P < 0.001)。非面孔选择亚区失活无此效应。
- 因果验证二:各亚区的行为重要性可由其局部线性可分性预测。把每个约 1 mm 亚区的"局部线性分类"成绩(被动注视记录训练的线性分类器对性别分类的水平)与该区光遗传失活的行为影响对齐,二者高度相关(P = 0.01;相关系数在 PDF 文本层因乱码应约为 0.6),线性回归外推表明失活可分性最高的亚区最多造成约 2.5% 的行为下降(图 3)。作者据此论证:IT 表征已相当接近驱动行为的读出机制,对上游区域(V1、甚至 V4)应不会出现这种对应。
- 编码模型:任务性能优化"捎带"出神经预测力。在评估数千个 HCNN 架构的高通量计算实验中,三种参数筛选规则(随机、性能优化、IT 预测力优化)下架构的任务性能都与 IT 神经预测力显著正相关(图 4A),且仅凭性能优化(完全不使用神经数据)选出的最好模型就能预测 IT 数据,表现与直接针对 IT 优化的模型一样好(图 4C)。
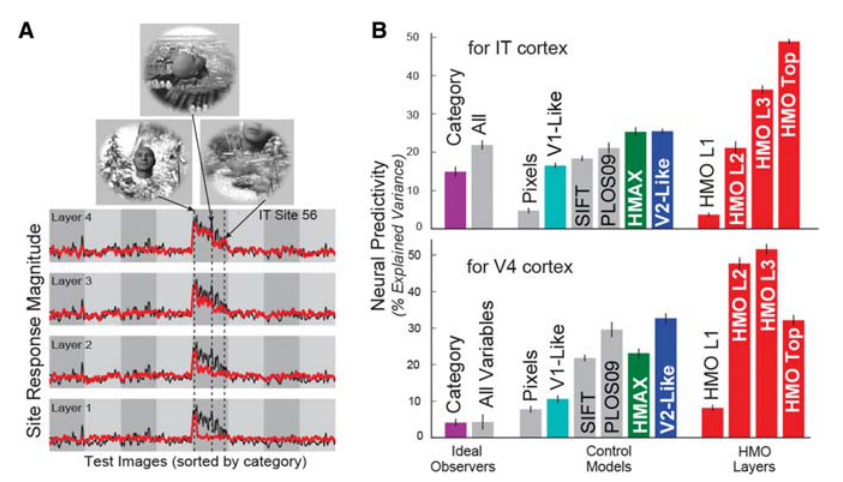
- HMO 模型的层级对位。表现最好的四层 HCNN(Hierarchical Modular Optimization 流程选出,1250 个顶层输出,称 HMO 模型)在含大量图像变化的任务上达到接近人类与 IT 群体的成绩,而 SIFT、V1 样 Gabor 模型、V2 样 Gabor 组合模型、HMAX 等对照在高变化条件下全部大幅落后(图 4B)。其顶层预测可解释 IT 单点反应方差的 48.5±1.3%(168 位点的中位数,图 5B),较此前最好模型有近一倍的提升,也显著高于拥有完美类别标签的理想观察者模型——说明 IT 神经元不是简单"分类器";中间层预测 V4 反应更佳(解释方差 51.7±2.3%,优于其顶/底层,图 5),为"V4 对应层级模型的中间层"提供了定量支持。
图注解读
图 1 · 把问题拆成编码与解码两环
原文图注:Figure 1. Encoding and decoding processes. We divide our efforts to understand visual information processing in the ventral stream into two goals. Goal one, called "encoding," is to model the transformation of the signal from a pixel-based representation in the retina to a high-level neural population representation that can support the demands of behavior in the face of low-level image variations (pose, location, etc.). Goal two, named "decoding," is to model the mechanisms that transform the population state of the neurons at the top of the ventral cortical stream into behavioral decisions.
这张开篇示意图把整篇文章的路线图画了出来:左端是视网膜像素表征,右端是行为报告,中间被切成两个可分别建模、证伪的目标——"图像 → 神经群体状态"(encoding)与"神经群体状态 → 行为"(decoding)。后文所有实验(64 项心理物理测试、被动注视电生理、光遗传/药理失活、HCNN 建模)都挂在这个二分框架的某个环节上。它本身没有数据,但提供了理解图 2–5 的坐标:图 2、图 3 属于解码,图 4、图 5 属于编码。
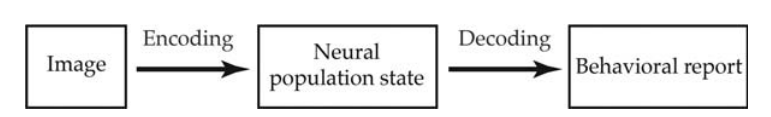
图 2 · 单一群体码解释全部人类识别行为
原文图注:Figure 2. A unified neuronal population code can explain human object recognition behavior. (A) We started with 3D models of real world objects (e.g., faces, cars) with multiple exemplars for each category. Given parameters (size, position, pose), we used ray tracing to render the object and place it on an uncorrelated background producing a test image. (B) We measured human performance for one eight-way basic-level object categorization (face, cars, planes, animals, tables, chairs, boats, fruits), and two subordinate eight-way identifications (cars: Beetle, BMW z3, Ford, etc.; faces: face1, face2, face3, etc.) and determined d0s for 384 tasks (24 labels × 6 levels of identity-preserving view variation). Heat map shows range of performance (high d0 = red). (C) We find that a single linking hypothesis (aka "unified code" or "decoding model") is sufficient to explain human core object recognition behavior, as showed by its statistically perfect consistency with the pattern of human performance. Only codes marked with asterisks are sufficient.
读法上是三段流水线:A 面板讲刺激如何造出来(3D 模型 + 光线追迹渲染 + 无相关背景);B 面板的热图把 384 个任务(24 标签 × 6 档变化的 d′)的红蓝分布铺开——有的任务很轻松、有的逼近机会水平,且难度模式跨被试高度一致;C 面板是判决图,列出各候选神经码的行为预测与实测人类成绩的一致性,只有打星号的码(IT 平均放电率的线性学习求和)达到"统计上完美一致"。这张图支撑主要结果第 1 条,也是全文"解码"主张的核心证据。
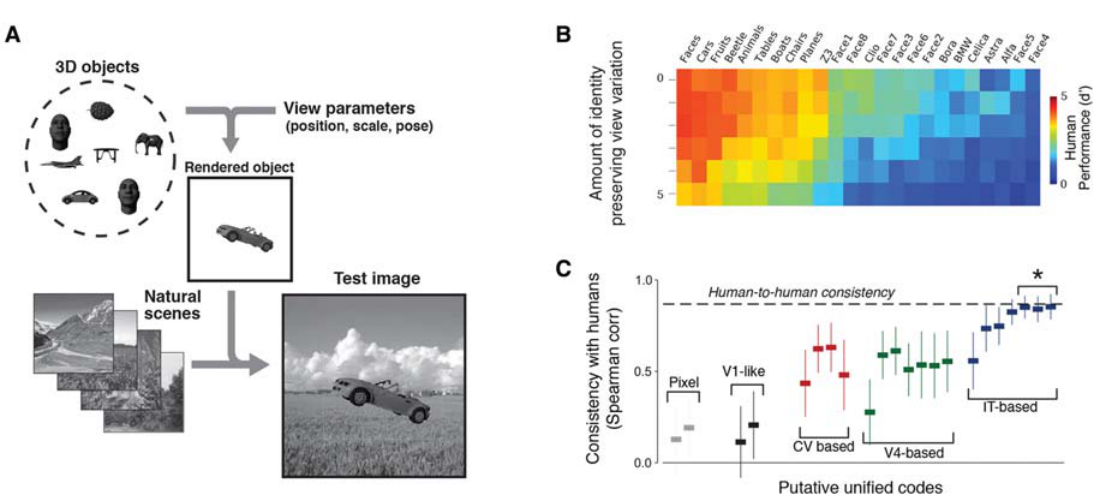
图 3 · 局部线性可分性预测失活的行为代价
原文图注:Figure 3. The effect of inactivation of different IT subregions on a gender discrimination task. Behavioral effect of optogenetic inactivation, averaged for small IT cortical subregions. The abscissa shows gender classification performance of a linear classifier trained and tested by multiunit recording data collected during the animals' passive fixation from each of the various subregions (≈1 mm) sampled from IT cortex. The ordinate shows the average impact of optogenetic inactivation of those same IT subregions on the animals' active behavior (gender discrimination task). (Adapted from Afraz et al. 2015.)
横轴是"被动多单元记录训出的线性分类器在性别分类上的成绩"(即该 1 mm 亚区对性别信息的可分性),纵轴是"同一亚区被光遗传失活后主动行为的平均降幅"。每个点对应一个 IT 小亚区,整体呈正相关:可分性越高,失活造成的行为损失越大;回归外推给出最高可分性亚区约 2.5% 的最大行为影响。这张图是主要结果第 3 条的直接证据,把"IT 表征离读出机制很近"从推理变成了由失活实验支持的因果陈述。
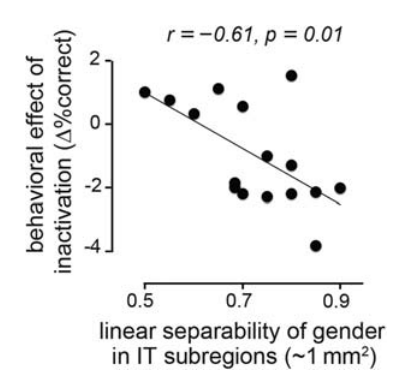
图 4 · 性能优化自动带来神经预测力
原文图注:Figure 4. Behavioral optimization yields neurally predictive models. (A) Object categorization performance versus IT neural explained variance percentage ("IT Predictivity") for hierarchical convolutional neural network (CNN) models in three independent high-throughput computational experiments (each point is a distinct neural network architecture). The x-axis shows performance (balanced accuracy, chance is 0.5) of the model output features on a high-variation categorization task; the y-axis shows the median single site IT explained variance percentage (n = 168 sites) of that model (i.e., the percentage of explainable response variance where response is defined as the mean IT firing rate 70–170 msec after image onset) computed on held-out test images. Each dot corresponds to a distinct model selected from a large family of convolutional neural network architectures (see text). Models were selected by random draws from parameter space (green dots), object categorization performance-optimization (blue dots), or explicit IT predictivity-optimization (red dots). (B) A high-performing neural network was identified that matches human performance on a range of recognition tasks, the hierarchical modular optimization (HMO) model. Object categorization performance results on the test images for eight-way object categorization at three increasing levels of object view variation (y-axis units are eight-way categorization percent correct; chance is 12.5%). IT (green bars) and V4 (hatched green bars) neural responses, and computational models (gray and red bars) were collected on the same image set and used to train support vector machine (SVM) linear classifiers from which population performance accuracy was evaluated. Human subject responses on the same tasks were collected via psychophysics experiments (black bars). (C) The object categorization performance versus IT neural predictivity correlation extends across a variety of models showing a wide range of performance levels.
A 面板散点图的横轴是模型在高变化分类任务上的 balanced accuracy(机会 0.5),纵轴是中位 IT 单点解释方差百分比(168 个位点,保留集上计算);绿/蓝/红点分别代表随机、性能优化、IT 预测力优化三种筛选,三种条件下性能与预测力都显著相关。B 面板换一个轴:同一批测试图像上,八分类正确率随物体视角变化递增的三档变化水平依次排列,HMO 模型(红柱)与人类(黑柱)和 IT 群体(绿柱)几乎重合,而 V4(斜纹绿柱)与其他对照模型(灰柱)明显落败。C 面板证明该相关不限于本次筛出的模型族,可推广到已发表模型。此图支撑主要结果第 4、5 条。
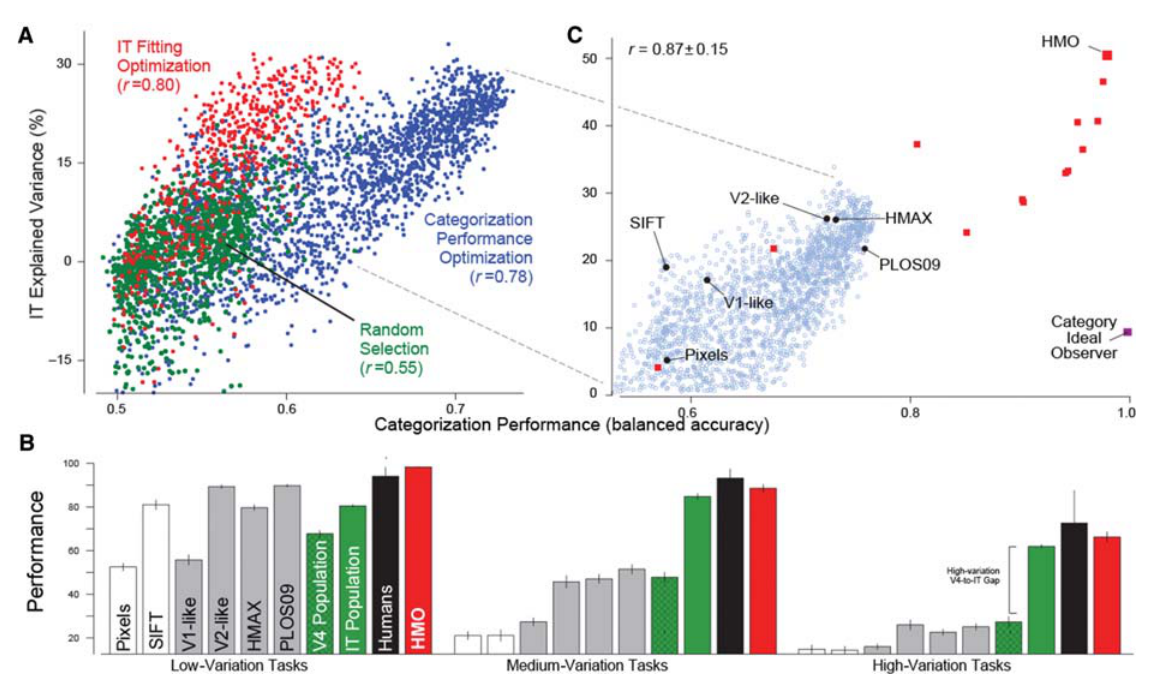
图 5 · 层级对位:顶层对 IT、中层对 V4
原文图注:Figure 5. Per-layer. (A) Actual neural response (black trace) versus model predictions (colored trace) for a face-selective IT neural site. The x-axis in each plot shows 1600 test images sorted first by category identity and then by variation amount, with more drastic image transformations toward the right within each category block. The y-axis represents the prediction/response magnitude of the neural site for each test image (those not used to fit the model). The four rows show neural predictions using the visual feature set (i.e., units sampled) from each of the four layers of the HMO model. (B) Comparison of IT and V4 neural explained variance percentage for various models. Bar height shows median explained variance, taken over all predicted IT units. (Modified from Yamins et al. 2014.)
A 面板逐层检验:对一个面孔选择性的 IT 位点,横轴是 1600 张测试图像(先按类别、再按变化幅度排序,类别块内越靠右变化越剧烈),四行分别是用 HMO 四层中各层的单元去预测该位点的反应,黑线是真实反应、彩线是预测。读图要点是预测随层数加深而逐层变好、且在第 4 层(顶层)能够跟上"类别块内随变化加剧仍维持的响应模式",呈现类别选择性与对变换容忍度逐层涌现。B 面板比较各模型对 IT 与 V4 反应的中位解释方差:顶层对 IT 最高(48.5±1.3%),中间层对 V4 更合适(51.7±2.3%),理想观察者语义模型对 V4 几乎不解释方差。这张图支撑主要结果第 5 条。
讨论
作者将编码端与解码端模型整合为端到端的视觉信息处理图景:编码端构成一个前馈、深层非线性映射网络,负责将隐含于视网膜像素中的高维流形展开并变换为对空间变换具有容忍度的显式表征;解码端则是此类下游读取机制的具体体现——将 IT 皮层的神经群体状态线性加权映射至最终的行为类别选择。二者结合构建了灵长类核心物体识别的一个定量化计算神经模型。该模型的前馈架构亦引申出一项理论推论:在快速分类情境下(数百毫秒内完成中央物体的单次注视识别),视觉识别主要依赖腹侧流的单向级联前馈驱动,其底层特征编码可在很大程度上独立于后继的特定运动决策状态自动进行。
作者对该研究范式的理论与实验局限进行了客观界定:当前编码模型与线性解码模型仅解释了神经与行为方差中的相当一部分,而非全部变异;相关性分析与局部因果干预均局限于选定的特定任务集,不能逻辑排除在其他未测图像集合或更具生态复杂性的任务中模型发生失效的可能;下颞叶皮层内部的解剖异质性(例如特定类别面孔细胞汇聚形成互联柱状斑块的网络成因)以及多层皮层柱微环路的功能分工尚未得到理论解释;中间级视觉皮层(V2、V4)的定性调谐动力学仍需更细致的模型刻画;更关键的理论边界在于,长程反馈回路在涉及工作记忆、自上而下预期引导、长时程跨模态感知运动整合等复杂认知行为中的调控机制,仍无法被现有的纯前馈框架完全概括。作者指出,未来的核心推进方向依赖于多尺度定量理论模型与超大规模神经电生理、高通量行为数据的紧密闭环迭代。
一句话总结
本研究系统论证了“前馈深度层级卷积编码 + 下颞叶线性解码 + 局灶因果电生理扰动”的定量闭环范式,为核心视觉物体识别提供了可证伪的计算神经科学研究范本。