该综述将动物学习理论与微观经济效用理论作为分析框架,系统梳理了中脑多巴胺神经元、眶额叶皮层及纹状体等脑区的单细胞电生理证据。作者提出,奖励缺乏专门的感觉受体,其功能主要通过行为后果体现,因此探索奖励的神经机制需要借助行为理论将奖励操作化为可精确测量的理论变量——包括预测误差、偶然性、期望值与方差,并在单神经元放电模式中检验其生理对应。
研究背景
奖励研究面临的首要问题是如何定义研究对象。光、声音和机械刺激能够用物理属性及相应感受系统来界定,奖励却没有独立的感觉受体:同一种食物的味道可以相近,其吸引力却随饱足、经验和情境变化。日常所说的奖赏还混合了愉悦体验、获得好结果和行为被强化等不同含义。动物学习理论提供了较可操作的起点:巴甫洛夫条件化关注线索如何获得对结果的预测作用,效果律和操作条件作用关注结果怎样改变行为。沿着这一传统,神经实验需要解释的便不只是得到食物时哪里活动,而是预期和学习如何改变同一事件的意义。
单靠线索与奖励先后出现,仍不足以解释所有学习现象。条件概率关系决定线索是否真正提供信息,阻断效应则显示,已被其他线索充分预测的奖励未必让新线索获得联想。预测误差理论因此把学习联系到实际结果与已有预期的差距,为神经反应提出了方向明确的检验。另一条历史线索来自经济学:量值与概率能够组成期望值,但主观效用不必随物理量线性增长,相同期望值的结果分布也可能因风险不同而引发不同选择。学习理论主要解释预期如何更新,效用理论则帮助区分价值与不确定性;若缺少这些概念,奖励相关放电容易被笼统归为愉悦、注意或动作准备。
Schultz 的综述将两套理论作为组织单神经元证据的框架,考察中脑多巴胺、眶额皮层、纹状体及相关结构的活动是否分别对应预测误差、结果预期、量值、概率和不确定性。阻断、奖励取消、交付时刻改变及价值贬值等范式,使理论变量能够通过实验操作彼此区分,而不只依靠放电与奖励同时出现的相关。本文回应的是如何从行为定义走向可检验的生理解释,并非提出一种包办所有奖励功能的神经信号。奖励还会改变注意和运动,预期结果与动作的联合编码也不自动等于目标导向控制;期望值与期望效用的区别还可能被神经噪声遮蔽。因此,理论与放电形式相符是机制研究的依据,却不能直接替代因果检验或说明主观愉悦的来源。
研究思路
全文遵循"行为理论 → 理论变量 → 神经对应物"的逻辑结构展开。第一章先用动物学习理论整理出奖励诱导学习的三个必要条件:接近性(contiguity,条件刺激 CS 或动作与奖励的时间邻近)、偶然性(contingency,奖励在有刺激时比无刺激时出现得更频繁才形成兴奋性条件化,反之则成为条件抑制子)与预测误差(prediction error,源自 Kamin 1969 的阻断效应:被完全预测的奖励不再促进学习,形式化为 Rescorla-Wagner 规则 ΔV ∝ λ–V,学习随预测精化逐步衰减、预测的奖励被取消则消退)。相应地,理论要求神经元也应当区分三类刺激(条件兴奋子、条件抑制子、中性刺激)、其反应获取应当只依赖未预测的奖励、且理想情况下应直接发放双向预测误差信号——这些就是可以被移植到单细胞记录上的"可检验预言"。第二章用微观效用理论把奖励量化为可比的数值:通过选择行为给奖励标定价值,用概率加权得期望值,用凹效用函数把物理价值转成效用并得到风险态度(凹函数意味着风险厌恶),再用负指数效用函数的拉普拉斯变换把期望效用拆成期望值与方差两个可分离成分——于是"量值、概率、期望值、期望效用、方差"都成为可以在神经元上寻找对应物的理论变量。作者把这一框架明确区别于纯行为主义:表述基于可观察行为,但表征与预测等心理状态是必需的;至于愉悦感究竟是行为的因果原因还是副现象(epiphenomenon),本文有意悬置,以便做客观的动物生理学测量。
方法
本文是综述,其证据主体来自清醒行为动物(尤其猕猴)的单神经元胞外放电记录,加上少量大鼠实验。任务范式围绕学习理论设计:Pavlovian 条件化把任意视觉或听觉条件刺激(CS)与延迟 1.5–2.0 秒的液体或食物奖励配对,便于检验接近性;三刺激与抑制子范式(把抑制子与奖励预测 CS 配对同时扣留奖励)用于检验偶然性;阻断(blocking)与条件抑制(conditioned inhibition)范式用于在特定情境中制造预测误差。工具性任务则包含指令线索、记忆延迟、运动执行与奖励交付等多个事件段,便于分离奖励预期、行为反应与结果编码。记录的脑结构包括中脑多巴胺神经元、眶额叶皮层、纹状体(尾核、壳核、腹侧纹状体)、杏仁核、背外侧前额叶、前扣带回与辅助眼区等;奖励常为果汁(可分辨亚毫升量级差异),并以饱足(satiation)操作检验反应反映奖励价值而非味觉本身。分析要点是区分相位反应(phasic,对事件起止的瞬时反应)与持续激活(sustained,任务区间的平台式激活)、把放电对齐到刺激或奖励时刻做逐试次对齐的栅格图与刺激后时间直方图,并把单细胞反应按理论范畴(量值、概率、EV、方差)做参数化比较。文中同时交代了关键的方法学对照思路:用价性相反的强化物(奖励对比厌恶物)剥离注意混淆,用与运动的关联性检验排除运动输出混淆。
主要结果
-
多巴胺神经元完整复制了联想学习的三个条件。 接近性:对新异 CS 与奖励配对数十次后,多巴胺神经元对 CS 获得反应、对奖励本身的反应消失(图 2);偶然性:对奖励预测刺激激活、对预测"无奖励"的条件抑制子抑制活动、对排除反应泛化后的中性刺激几乎不反应(图 3),扣留奖励数十次即可撤销 CS 反应(图 5);预测误差:阻断范式下,只有与未预测奖励结合的 CS 能习得反应,而与已被另一 CS 预测的奖励配对的 CS 不能学习,尽管接近性与偶然性条件均已满足(图 6)——单神经元水平的学习与前馈行为学习遵循相似规则。
-
多巴胺神经元发放双向预测误差信号,其预测包含奖励的精确时刻。 对未预测奖励激活、对如约而至的预测奖励不反应、对预测奖励的取消抑制活动,形式化为"多巴胺反应 = 实际获得的奖励 − 预测的奖励",即 Rescorla-Wagner 规则中 (λ–V) 项的神经等价物、神经可塑性的理想教学信号(图 7);阻断与条件抑制正式范式进一步验证了这一等式在被阻断刺激与抑制子上的所有推论(图 8)。时间上,奖励延迟交付会在原定时刻引出抑制、在新时刻引出激活,提前交付则只在新时刻激活(图 7);当奖励概率随距上次奖励的试次数上升时,正向误差反应逐试次递减、负向误差递增——这一结果实际上与时间差分强化学习模型的一个假设方向相反(图 9)。
-
奖励系统的神经元从多维度刺激中专门提取奖励成分。 眶额叶皮层神经元按 CS 预测的具体饮料种类分辨指令线索(区分石榴-苹果、葡萄-橙汁),而对线索的视觉物体特征不敏感、极少编码空间位置(图 4);杏仁核与纹状体也有类似以奖励特征为主的反应。价性检验显示多巴胺神经元对奖励及其预测物优先激活、对厌恶气吹与盐水极少激活,而纹状体紧张性活跃神经元对奖惩两性强化物都有反应、不区分价性,可能反映一般性注意。饱足会降低眶额叶(含次级味觉区)的奖励反应但不影响岛叶与额岛盖初级味觉区的味觉反应,说明前者编码的是奖励功能而非味道。
-
持续激活揭示奖励预期,其中一部分同时编码行为反应,构成目标导向行为的候选神经机制。 在指令线索后的运动准备期(尾核,图 10a)与奖励交付前(壳核,图 10b)出现只对奖励参数敏感、与具体动作无关的持续激活,分布于纹状体、杏仁核、眶额叶、背外侧前额叶、前扣带回与辅助眼区,且随学习而建立、随期望更新而调整;另一类神经元(背外侧前额叶与尾核,图 11)在编码预期结果的同时分辨左/右目标或运动/不运动,即同时代表"为得到该结果而执行的动作",符合 Dickinson 与 Balleine 对"奖励成为行为目标"的两条判据(行为准备时的结果预期 + 动作-结果偶然性表征)。作者提醒还需用偶然性操作与价值贬值实验将其与"奖励-行为汇聚编码"及习惯机制区分开。
-
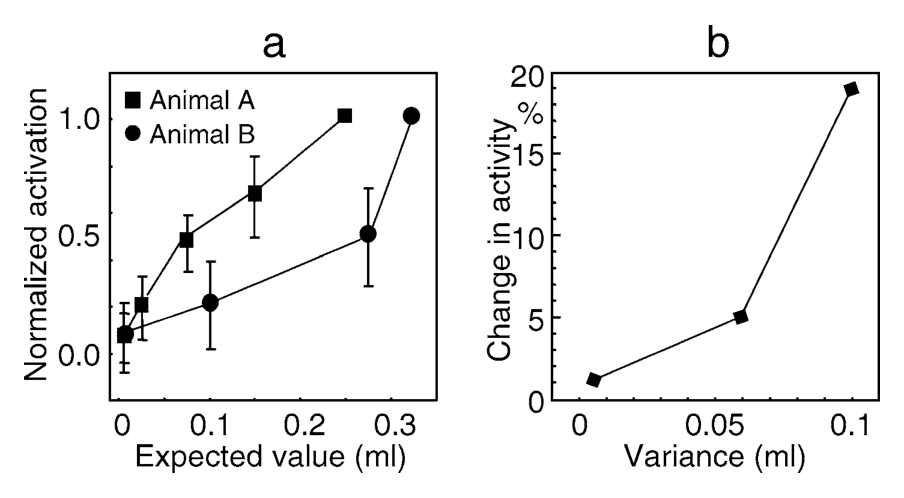
经济变量在神经元上有分离的对应物。 量值:纹状体有随预测奖励量(0.12/0.18/0.24 ml)递增的尾核 CS 反应,也有反向(量值越大反应越小)的腹侧纹状体反应(图 13),并见于前额叶、顶叶、后扣带回;概率:多巴胺神经元的 CS 相位反应随奖励概率递增,顶叶与苍白球亦有类似活动,但纹状体紧张性神经元不编码概率;期望值:多巴胺神经元对 CS 的相位反应随量值×概率之积单调递增而无法分辨两个成分,看似编码 EV(图 14a),但因神经噪声尚难判定是 EV 还是期望效用(EU);不确定性:一部分多巴胺神经元在 CS-奖励区间发放随方差(而非熵——三种概率分布的熵均为 1 bit)单调递增的持续激活,p=0.5 时最大,与 EV 编码的相位反应互不相关(图 14b),后扣带回亦有随方差增大的任务相关激活。这正是凹效用函数图形分析所预言的"价值与不确定性可分离"(图 12)。
图注解读
图 1 · 动物学习理论界定奖励功能的三个基本假设
原文图注:Figure 1 Basic assumptions of animal learning theory defining the behavioral functions of rewards. (a) Contiguity refers to the temporal proximity of a conditioned stimulus (CS), or action, and the reward. (b) Contingency refers to the conditional probability of reward occurring in the presence of a conditioned stimulus as opposed to its absence (modified from Dickinson 1980). (c) Prediction error denotes the discrepancy between an actually received reward and its prediction. Learning (ΔV, associative strength) is proportional to the prediction error (λ–V) and reaches its asymptote when the prediction error approaches zero after several learning trials. All three requirements need to be fulfilled for learning to occur. US, unconditioned stimulus.
这是全文的理论总纲示意图:(a) 说明接近性——CS(或动作)与奖励在时间上须紧邻;(b) 用"有刺激时奖励出现的条件概率 vs 无刺激时"的对比图示偶然性,有刺激后奖励概率更高为兴奋性条件化、更低为条件抑制子、不变则为中性(对角线情形);(c) 画出预测误差 λ–V 与联想强度 ΔV 随学习试次上升、误差趋于零时学习到达渐近线的曲线。读图要点是三个条件各自独立、且缺一不可——后文图 2、3、6 分别用神经数据逐一检验。这张图为全文"理论先行"的写法定调。
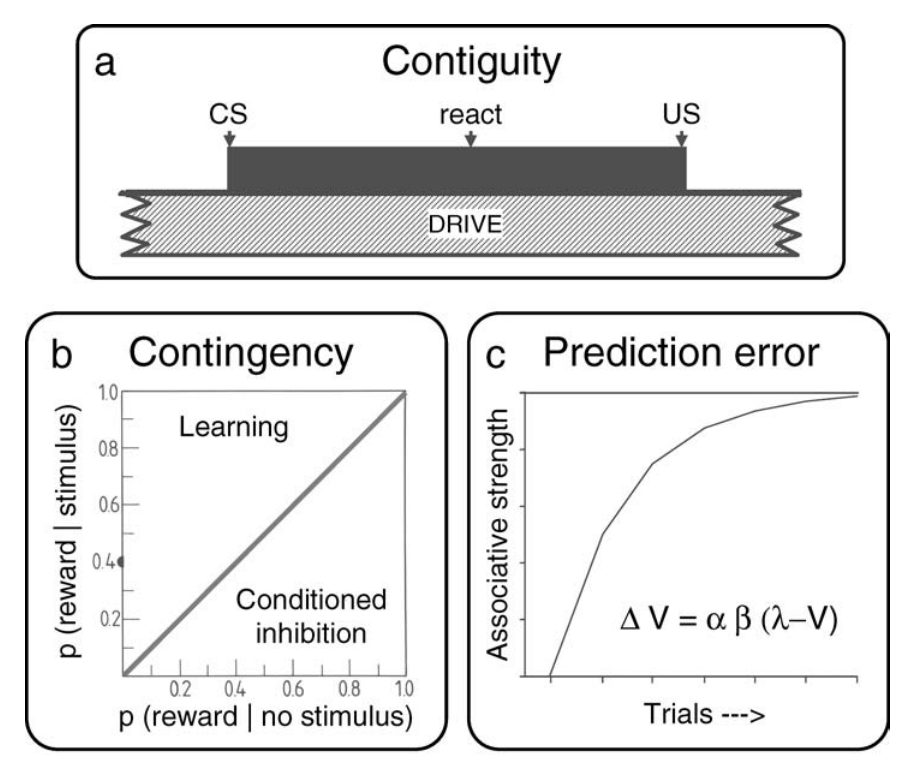
图 2 · 接近性检验:单个多巴胺神经元在一次完整学习过程中的反应获取
原文图注:Figure 2 Testing the contiguity requirement for associative learning: acquisition of neural response in a single dopamine neuron during a full learning episode. Each line of dots represents a trial, each dot represents the time of the discharge of the dopamine neuron, the vertical lines indicate the time of the stimulus and juice reward, and the picture above the raster shows the visual conditioned stimulus presented to the monkey on a computer screen. Chronology of trials is from top to bottom. The top trial shows the activity of the neuron while the animal saw the stimulus for the first time in its life, whereas it had previous experience with the liquid reward. Data from Waelti (2000).
这是一张单细胞逐试次栅格图:每行一个试次、每点一次放电、自上而下按时间排列,两道竖线分别标刺激与果汁奖励的时刻;第一行是该猴子生平第一次看到这个 CS(但此前已熟悉果汁奖励)。图示展现了单神经元放电随学习进程的时序转移:初始阶段放电集中于液体奖励交付时刻,经过数十次配对后放电转移至条件刺激呈现时刻,奖励交付处的放电逐渐衰减,直观呈现了多巴胺神经元在联想建立过程中的时序预测特征(正文指出向 CS 转移在其他脑区并非普遍现象)。它支撑主要结果第 1 条的接近性部分,说明 CS-奖励时间邻近足以让单个神经元把反应从 US 挪到 CS。
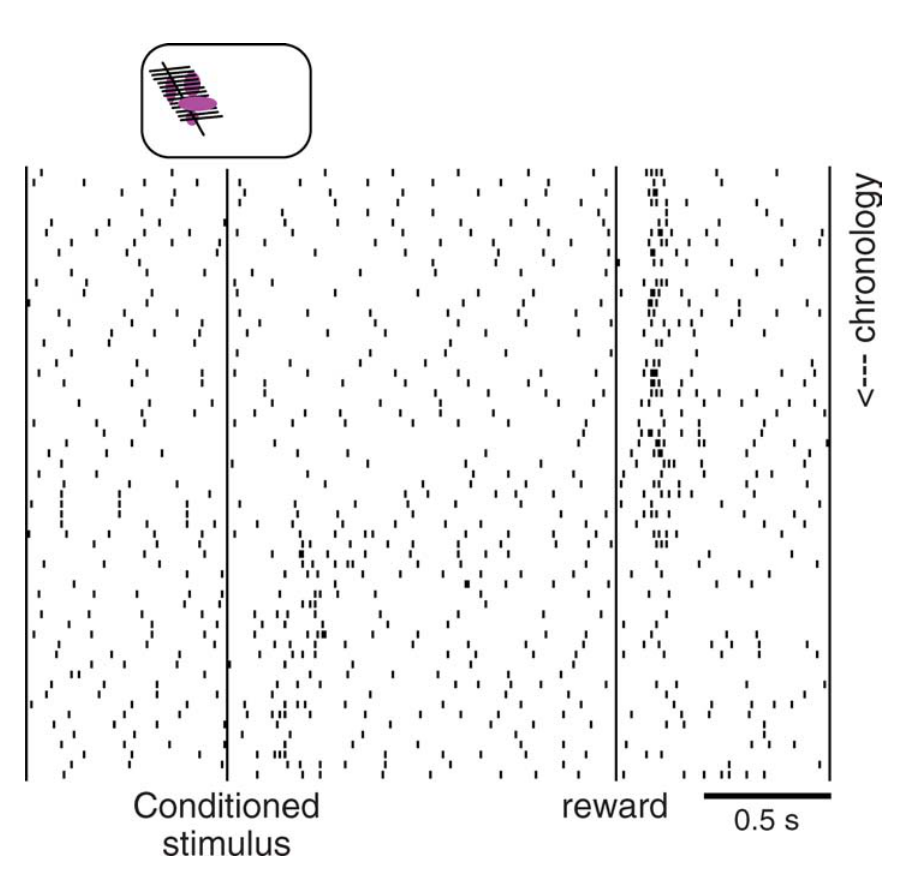
图 3 · 偶然性检验:单个多巴胺神经元对三类刺激的反应
原文图注:Figure 3 Testing the contingency requirement for associative learning: responses of a single dopamine neuron to three types of stimuli. (Top) Activating response to a reward-predicting stimulus (higher occurrence of reward in the presence as opposed to absence of stimulus). (Middle) Depressant response to a different stimulus predicting the absence of reward (lower occurrence of reward in the presence as opposed to absence of stimulus). (Bottom) Neutral stimulus (no change in reward occurrence after stimulus). Vertical line and arrow indicate time of stimulus.
同一个多巴胺神经元对三类统计性质不同的刺激给出三种反应:顶部对"有它之后奖励更常出现"的条件兴奋子产生激活反应,中部对"有它之后奖励更少出现"的条件抑制子产生抑制反应,底部对"有无奖励频率不变"的中性刺激几乎无反应;竖线与箭头标刺激时刻。关键读法在于对照理论预言:偶然性要求神经元恰好按图 1b 的条件概率结构区分三类刺激——图中的激活、抑制、零反应三个方向正是一一对应。这排除了"CS 反应只是感觉或运动反应"的解释,支撑主要结果第 1 条的偶然性部分。
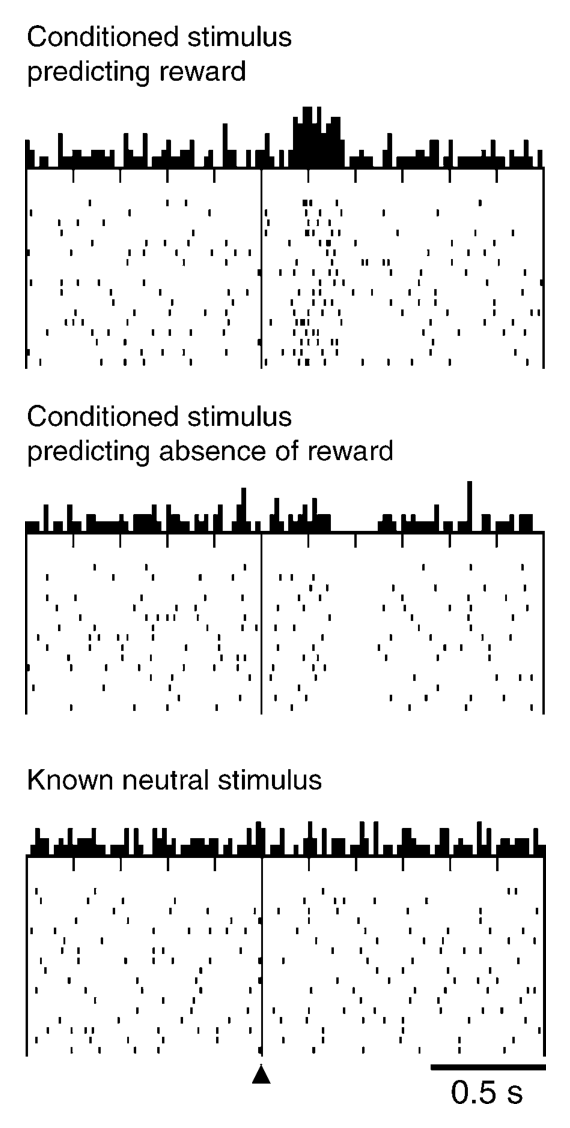
图 4 · 眶额叶皮层的奖励分辨
原文图注:Figure 4 Reward discrimination in orbitofrontal cortex. (a) A neuron responding to the instruction cue predicting grenadine juice (left) but not apple juice (right), irrespective of the left or right position of the cue in front of the animal. (b) A different neuron responding to the cue predicting grape juice (left) but not orange juice (right), irrespective of the picture object predicting the juice. From Tremblay & Schultz 1999, ©Nature MacMillan Publishers.
两个眶额叶神经元各举一例分辨的"不变性":(a) 神经元对预测石榴汁的指令线索有反应、对预测苹果汁的无反应,且无论线索出现在动物面前左位还是右位;(b) 神经元对预测葡萄汁的线索反应、对橙汁的无反应,且无论用哪个图片对象来指代那种饮料。读图时看的是变量替换逻辑:把空间位置换掉(a)或把视觉物体换掉(b),反应都跟着"预测的饮料种类"走——说明这些神经元从多维度刺激中专门提取了奖励这一成分,而把位置与物体特征留给额叶其他区域编码(正文引 Rao 等 1997)。它支撑主要结果第 3 条。
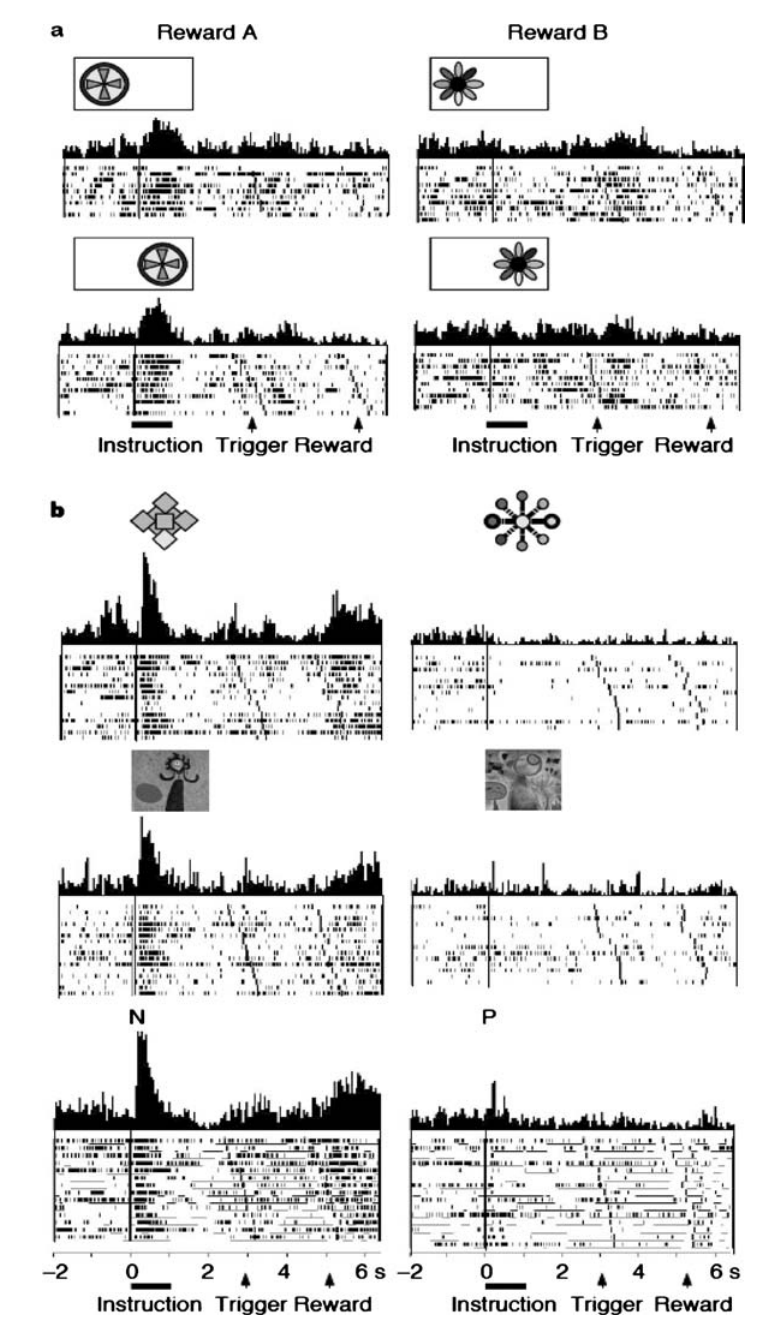
图 5 · 奖励扣留后 CS 反应的消退
原文图注:Figure 5 Loss of response in dopamine neuron to the conditioned stimulus following withholding of reward. This manipulation violates the contiguity requirement (co-occurrence of reward and stimulus) and produces a negative prediction error that brings down the associative strength of the stimulus. The contingency moves toward the neutral situation. Data from Tobler et al. (2003).
与图 2 的获取过程相对,这展示消退:在 CS 之后扣留奖励数十次,多巴胺神经元对该 CS 的反应逐渐丧失。读图要点是把它理解为负向误差的作用:预测的奖励不再出现产生负预测误差,按 Rescorla-Wagner 规则削弱联想强度,偶然性于是从兴奋条件化滑向图中对角线的中性情形。这与行为学习的消退现象互为镜像,支撑主要结果第 1 条(偶然性部分末尾)并可反向佐证预测误差机制。
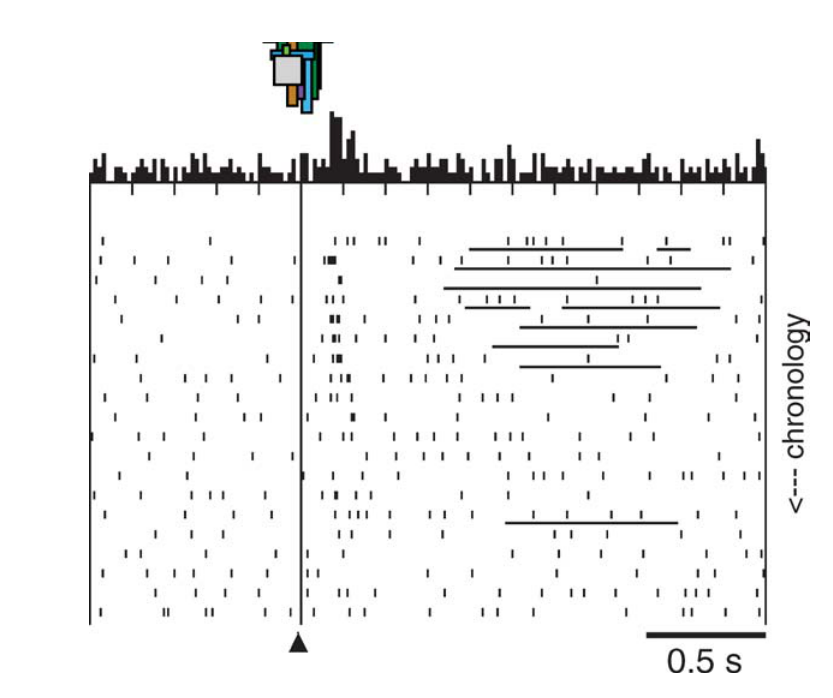
图 6 · 阻断范式:多巴胺 CS 反应的获取受预测误差支配
原文图注:Figure 6 Acquisition of dopamine response to reward-predicting stimulus is governed by prediction error. Neural learning is blocked when the reward is predicted by another stimulus (left) but is intact in the same neuron when reward is unpredicted in control trials with different stimuli (right). The neuron has the capacity to respond to reward-predicting stimuli (top left) and discriminates against unrewarded stimuli (top right). The addition of a second stimulus results in maintenance and acquisition of response, respectively (middle). Testing the added stimulus reveals absence of learning when the reward is already predicted by a previously conditioned stimulus (bottom left). Data from Waelti et al. (2001).
这是学习神经元层面"阻断效应"的关键实验图,左右两列对照:左列中奖励已被一个先前条件化的 CS 预测,再加入第二个 CS 与奖励配对,测试时第二个 CS 完全不习得反应;右列的对照试次中奖励未被预测,同一个神经元照常习得对另一刺激的反应——控制了神经元的"学习能力"本身。读图按上(基线能力)、中(加入第二个刺激)、下(测试第二个刺激)三行推进,看左下试次中反应的缺席。由于此时接近性与偶然性条件均满足而学习仍不发生,这是预测误差必要性的决定性证据,支撑主要结果第 1 条的预测误差部分,也支撑"神经元群体层面的学习可能遵循与行为学习相同的规则"这一重要推论。
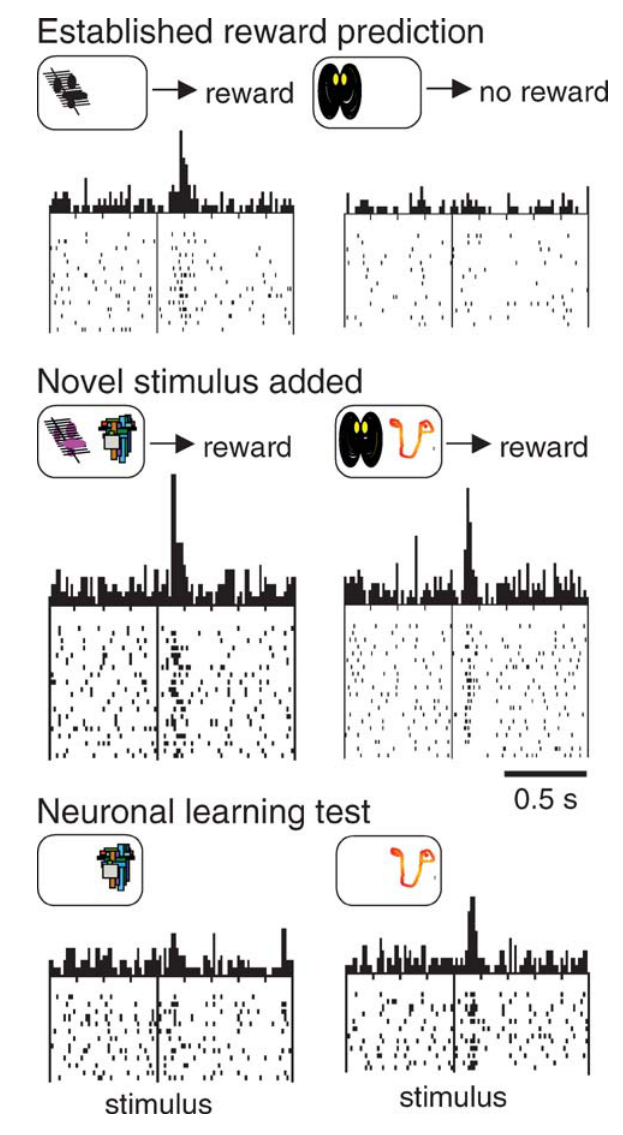
图 7 · 多巴胺反应编码时间性奖励预测误差
原文图注:Figure 7 Dopamine response codes temporal reward prediction error. (a, c, e) No response to reward delivered at habitual time. (b) Delay in reward induces depression at previous time of reward, and activation at new reward time. (d) Precocious reward delivery induces activation at new reward time, but no depression at previous reward time. Trial sequence is from top to bottom. Data from Hollerman & Schultz (1998). CS, conditioned stimulus.
五段试次序列(自上而下)操纵奖励交付时机:(a、c、e) 奖励在惯常时刻到达,多巴胺神经元无反应——因为完全被预测;(b) 奖励延迟:在原定奖励时刻出现抑制(负误差:"该来的没来"),在新时刻出现激活(正误差:"来了");(d) 奖励提前:只在新时刻激活,原定时刻没有抑制——因为提前到达的奖励本身就抵消了误差。读图关键是时间轴上"抑制-激活"的错嵌关系:它证明作用于多巴胺神经元的预测包含奖励的精确时刻,而不只是"会有奖励"这一布尔判断。这支撑主要结果第 2 条,并为实验室动物"明知有奖励仍表现出误差反应"提供了合理解释(不知道何时)。
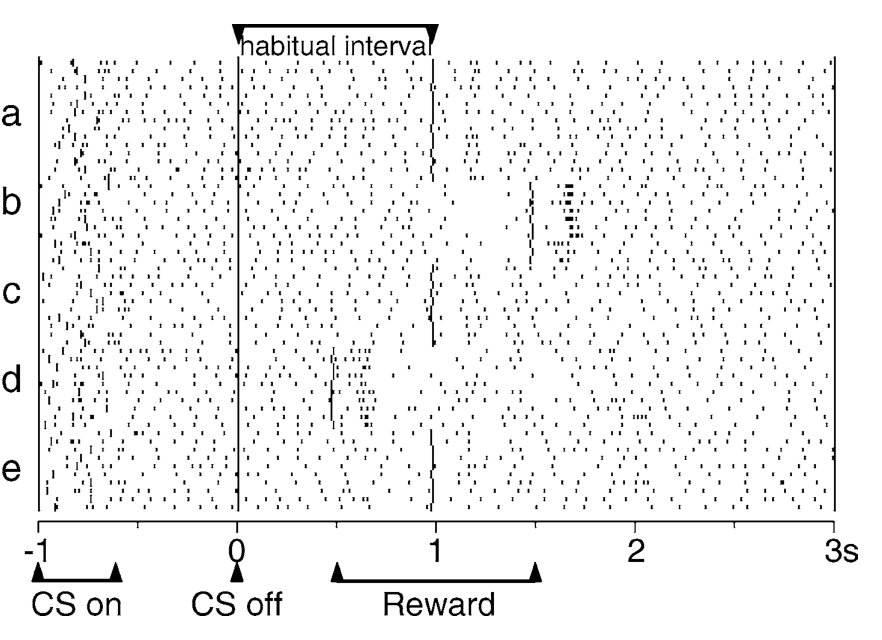
图 8 · 阻断与条件抑制范式中的预测误差编码
原文图注:Figure 8 Coding of prediction errors by dopamine neurons in specific paradigms. (a) Blocking test. Lack of response to absence of reward following the blocked stimulus, but positive signal to delivery of reward (left), in contrast to control trials with a learned stimulus (right). Data from Waelti et al. 2001. (b) Conditioned inhibition task. Lack of response to absence of reward following the stimulus predicting no reward (top), even if the stimulus is paired with an otherwise reward-predicting stimulus (R, middle, summation test), but strong activation to reward following a stimulus predicting no reward (bottom). These responses contrast with those following the neutral control stimulus (right). Data from Tobler et al. (2003).
(a) 阻断检验:在被阻断刺激后取消奖励——该刺激本不预测奖励,故取消不构成误差,神经元无反应;但此时交付奖励反而构成正误差、引发阳性信号。对照列是训练良好的刺激:取消奖励引发抑制反应、交付奖励无反应——两种刺激下反应模式恰好镜像。(b) 条件抑制任务:抑制子后取消奖励无反应(顶部),即使它与一个本预测奖励的刺激叠加(求和检验,中部)也无反应;而抑制子后竟然出现奖励时,误差被"负预测"放大,神经元强激活(底部);右列中性对照刺激的反应作参照。读图要领是把每一格当成"实际奖励 − 预测"求值:两组范式下多巴胺反应与等式的每一项推断严丝合缝。这是主要结果第 2 条的正式学习理论验证,也是"双向误差编码"最完整的展示。
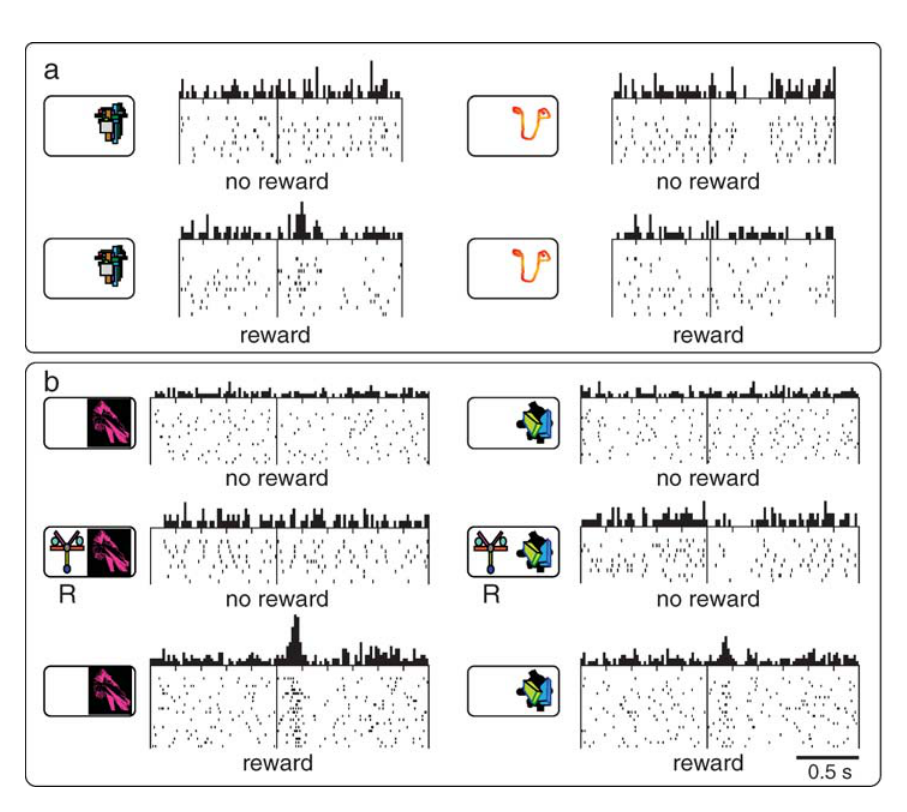
图 9 · 预测中的时间信息:随试次递进变化的误差反应
原文图注:Figure 9 Time information contained in predictions acting on dopamine neurons. In the particular behavioral task, the probability of reward, and thus the reward prediction, increases with increasing numbers of trials after the last reward, reaching p = 1.0 after six unrewarded trials. Accordingly, the positive dopamine error response to a rewarding event decreases over consecutive trials (upper curve), and the negative response to a nonrewarding event becomes more prominent (lower curve). Data are averaged from 32 dopamine neurons studied by Nakahara et al. (2004), © Cell. Press.
任务中距上次奖励越远、奖励概率越高(连续 6 个无奖励试次后达 p=1.0),因此预测本身随试次序号递增:上图显示对奖励事件的正向误差反应随连续试次递减,下图显示对无奖励事件的负向反应渐趋显著(32 个多巴胺神经元平均)。读图重点在两条曲线相反的走向,它们共同说明预测值在逐试次爬升。作者特别指出此结果与时间差分强化学习模型的内含假设方向相反(按该模型前一试次的负误差应降低当前预测、误差反应应增大), 这展示任务的具体时间结构如何塑造神经预测——这是主要结果第 2 条末尾的部分,也展示了"用概念驱动的实验如何揭示编码特性"的方法论主张。
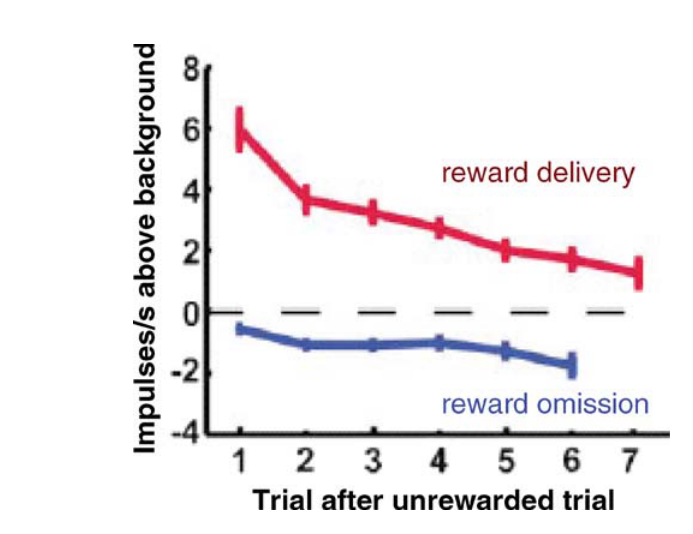
图 10 · 纹状体的奖励预期
原文图注:Figure 10 Reward expectation in the striatum. (a) Activation in a caudate neuron preceding the stimulus that triggers the movement or nonmovement reaction in both rewarded trial types, irrespective of movement, but not in unrewarded movement trials. (b) Activation in a putamen neuron preceding the delivery of liquid reward in both rewarded trial types, but not before the reinforcing sound in unrewarded movement trials. Data from Hollerman et al. (1998).
(a) 尾核神经元在触发运动或"不运动"反应的刺激之前激活,两种有奖励试次类型都激活、与具体动作无关,而无奖励的试次不激活;(b) 壳核神经元在液体奖励交付前激活,同样存在于两种有奖励试次类型,但在无奖励试次的强化音之前不激活。读图要领是"跟奖励走、不跟动作走":激活区分奖励与否、饮料种类与量值,但不同时区分眼动还是肢体动作——这类活动被解释为纯粹的奖励预期表征,分布于纹状体、杏仁核、眶额叶等多个结构,且随任务事件分段(运动准备期、奖励交付前)出现。它支撑主要结果第 4 条的前半部分,并为图 11 的"动作特异性"对比提供基线。
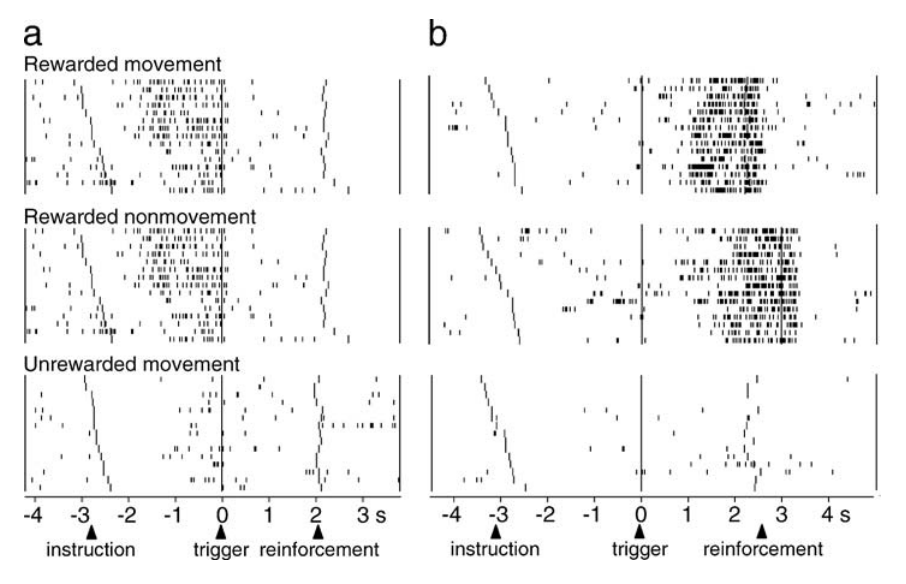
图 11 · 目标导向行为的潜在神经机制
原文图注:Figure 11 Potential neural mechanisms underlying goal-directed behavior. (a) Delay activity of a neuron in primate prefrontal cortex that encodes, while the movement is being prepared, both the behavioral reaction (left versus right targets) and the kind of outcome obtained for performing the action. From Watanabe (1996), ©Nature MacMillan Publishers. (b) Response of a caudate neuron to the movement-triggering stimulus exclusively in unrewarded trials, thus coding both the behavioral reaction being executed and the anticipated outcome of the reaction. Data from Hollerman et al. (1998).
(a) 猕猴前额叶皮层神经元的延迟活动:在运动准备期间同时编码行为反应(左目标 vs 右目标)与执行该动作将获得的结果类型;(b) 尾核神经元只在无奖励试次中对触发运动的刺激反应——同时编码正在执行的行为反应与该反应被预期的结局。读图关键是与图 10 的对照:这些激活不能只用结果预期解释(同一结局下它们还分辨动作),也不能只用运动反应解释(它们还分辨预期结局),只有"动作×结果"的联合表征能同时满足两者。按 Dickinson 与 Balleine 的目标导向行为双判据,这类神经元是迄今最接近目标表征的候选,但作者强调仍需偶然性操作与价值贬值检验来排除"汇聚编码"或习惯机制——这就是标题里"POTENTIAL"(潜在)一词的份量。支撑主要结果第 4 条后半部分。
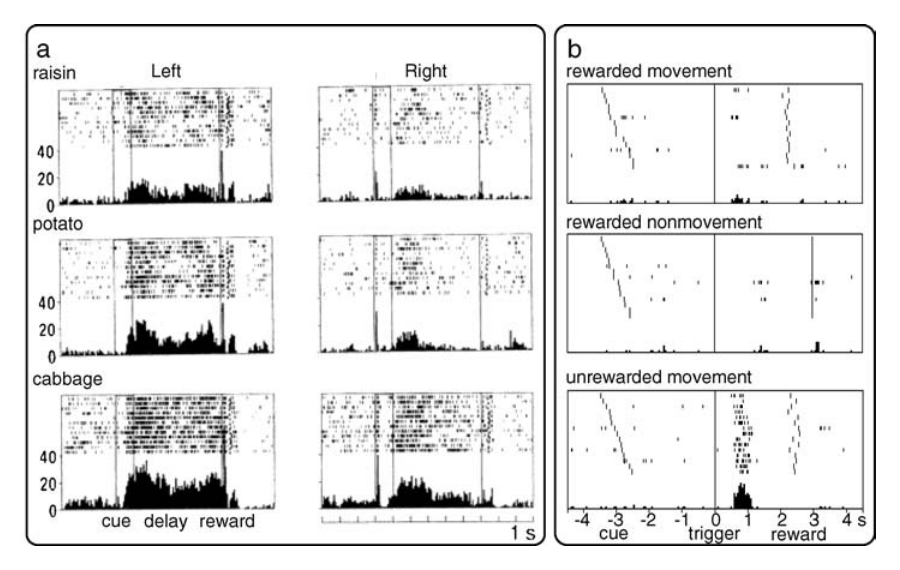
图 12 · 一个假想的凹效用函数
原文图注:Figure 12 A hypothetical concave utility function. EV, expected value (5 in both gambles with outcomes of 1 and 9, and 4 and 6); EU, expected utility. See text for description.
这是把经济学引入神经实验的概念图:横轴为客观价值,纵轴为效用,凹曲线来自 Bernoulli 传统。两个赌局——{1,9} 与 {4,6} 各以 p=0.5 出现——EV 均为 5(垂直虚线),但{1,9}的期望效用 EU(1–9)(u(1) 与 u(9) 的均值)明显低于 5 处的效用值 u(EV),{4,6} 的 EU(4–6) 则更接近 u(EV):结果跨度越大、风险越大、因不确定性损失的效用越多。另一个关键细节是 u(EV) 比 u(1) 与 u(9) 的中点更靠近 u(9)——凹函数下输掉赌局损失的效用大于赢回的效用,这就是风险厌恶的图形来源。读图时应把它当作图 14 的理论前提:价值与不确定性可以在期望效用中作为两个可分离成分出现,为"脑内是否分别编码 EV 与方差"铺路。
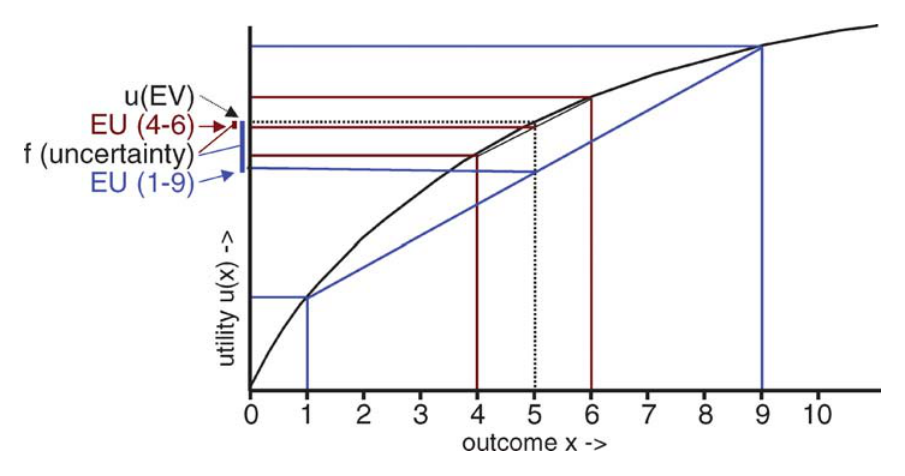
图 13 · 纹状体神经元分辨奖励量值
原文图注:Figure 13 Discrimination of reward magnitude by striatal neurons. (a) Increasing response in a caudate neuron to instruction cues predicting increasing magnitudes of reward (0.12, 0.18, 0.24 ml). (b) Decreasing response in a ventral striatum neuron to rewards with increasing volumes. Data from Cromwell & Schultz 2003.
(a) 尾核神经元对预测越来越大量值果汁(0.12、0.18、0.24 ml)的指令线索给出越来越大的反应;(b) 腹侧纹状体神经元对量值递增的奖励反应反而递减。读图要领在于(b)的意义:如果奖励相关活动只是"奖励诱发的注意",注意应随奖励增大而增强,反应只会单调递增;存在反向编码(量值越大反应越小)说明这是真正的量值分辨、而非注意的副产物。这支撑主要结果第 5 条的量值部分,也是作者在讨论中用来剥离注意混淆的核心论据之一。
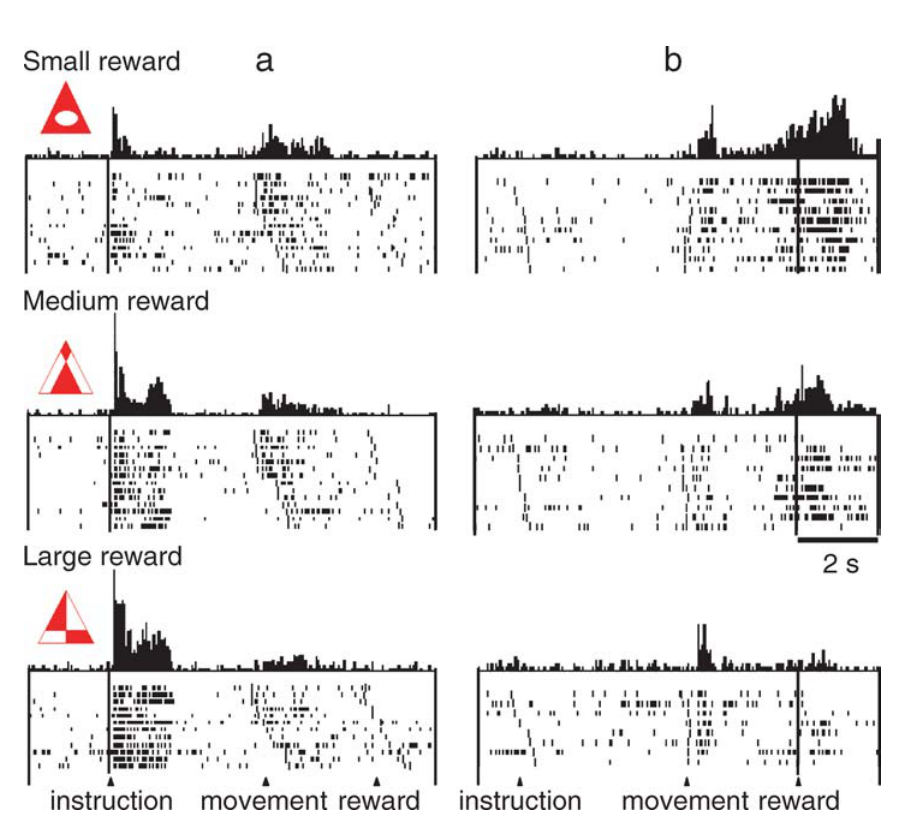
图 14 · 多巴胺神经元的奖励价值与不确定性分离编码
原文图注:Figure 14 Separate coding of reward value and uncertainty in dopamine neurons. (a) Phasic response to conditioned, reward-predicting stimuli scales with increasing expected value (EV, summed magnitude × probability). Data points represent median responses normalized to response to highest EV (animal A, 57 neurons; animal B, 53 neurons). Data from Tobler et al. (2005). (b) Sustained activation during conditioned stimulus–reward interval scales with increasing uncertainty, as measured by variance. Two reward magnitudes are delivered at p = 0.5 each (0.05–0.15, 0.15–0.5 ml, 0.05–0.5 ml). Ordinate shows medians of changes above background activity from 53 neurons. Note that the entropy stays 1 bit for all three probability distributions. Data from Fiorillo et al. (2003).
(a) 相位反应随 EV(量值×概率的加权和)单调增大:动物 A 57 个、动物 B 53 个神经元,数据点为对最高 EV 反应归一化的中位数——当量值与概率两参数分别及联合变化时,反应只跟随乘积走,无法区分两成分。(b) CS-奖励区间的持续激活随方差增大:三种条件都是两个量值各以 p=0.5 出现、量值跨度依次增大(0.05–0.15、0.15–0.5、0.05–0.5 ml),53 个神经元的中位数变化单调上升,而三种分布的熵恒为 1 bit——这说明编码的对象是统计方差而非熵。读图要点是两子图的反应类型不同(相位 vs 持续)、且两种信号的神经元水平互不相关,正好对应图 12 中 EV 与 var 作为 EU 可分离两成分的数学结构。这为主要结果第 5 条中价值与方差的解离提供了关键证据。
讨论
作者在讨论中强调,成熟的行为理论为神经生理实验提供了精确的理论支点:学习理论界定了接近性、偶然性与预测误差,效用理论量化了量值、概率、期望值与风险方差。两套理论描述的是同一类行为后果,因此神经网络活动可同时在不同理论范式中得到一致解释。讨论中的边界意识很清晰:奖励与注意不易剥离,但有可行方案——用强化强度相当、价性相反的强化物检验特异性,且反向编码的神经元(奖励越小活动越强)天然反驳注意解释;量值编码可能被运动混淆污染(大奖励使动物动得更快,前运动区活动的差异可能反映运动速度),作者建议把神经活动分别与运动参数、奖励参数做相关,并指出反向关系(小奖励对应更慢运动时活动更高)可反驳运动起源解释,但同时坦承常用的运动参数可能敏感性不足以在小幅值差下做出区分;EV 与 EU 的区分被神经噪声所限、暂无法判定;时间结构对预测的作用方向与时间差分模型的某项假设相反,作者如实报告并转述原作者把时间条件化归于情境的补救说明。对话对象横跨大类:Kamin 的阻断效应与 Rescorla-Wagner 规则是预测误差信号的理论母体,Dickinson 与 Balleine 的目标行为标准是图 11 解释的框架,Corbetta 式注意-奖励之争与 Maunsell(2004)的提醒构成"奖励还是注意"的辩题,Kahneman 与 Tversky(1984)被引用来说明期望值逻辑在某些决策情境中受到质疑——作者特意说明实验一开场时新起的博弈论神经生理(Barraclough 等 2004,Dorris 与 Glimcher 2004)与人类脑成像(O'Doherty 2004)这两块尚待积累,药物奖励则因其不需要不同的理论背景而排除在外。文中未详述多巴胺特异性机制(如离子通道层面的东西)——综述明确把范围限定在"理论框架与单细胞放电现象的对应"。
一句话总结
该综述建立了行为理论与神经生理学之间的对应映射:学习理论形式化的预测误差与经济理论形式化的期望值、方差,在单神经元放电中找到了具体的生理对应。多巴胺神经元的相位活动编码双向预测误差,持续活动则与风险方差单调相关,展示了如何用量化的行为理论解析多脑区神经信号。