这篇文章做了一件在当年颇具"浇冷水"意味的事:用一套控制严密的模拟检验"群体水平线性解码能否凭空产生不变性"这一流行假设。作者构建由双维高斯调谐的单元组成的小网络,让线性支持向量机从中解码刺激值,然后系统测量解码的辨识力与跨无关维度变化的不变性。结论是:线性读出并不会让不变性自动涌现,群体水平依然存在选择性与容忍度之间的基本权衡——这篇论文因此成为后来"涌现不变性"讨论中被反复引用的负面基线。
研究背景
物体识别的一个标志性特征是"不变性"(invariance):无论物体处于视网膜上的哪个位置、呈现多大、从哪个视角看,我们都能认出它是同一个东西。早期模型与早期神经生理研究都倾向于假定灵长类脑会在下颞叶皮层(inferior temporal cortex, ITC)——物体识别的关键脑区——建立起高度不变的表达,其中被研究最多的是感受野(receptive field)大小:早年报道 ITC 神经元感受野非常大,似乎天然容忍位置变化。但更新的研究发现,当使用较小的刺激时,ITC 神经元的感受野其实相当小,对物体位置传递着相当精确的信息;早期"超大感受野"的估计很可能是大刺激推广出来的产物。除位置之外,ITC 神经元对尺寸、视角等变换同样敏感;Zoccolan 等人(2007)更在单细胞水平揭示了一个权衡——物体选择性越高的神经元,对位置、尺寸、杂物干扰等变换的容忍度反而越低。"高物体选择性 + 高不变性"的理想神经元在真实皮层里几乎找不到。
与此同时,一批群体水平的研究给出了看似乐观的相反信号。Hung 等人(2005)用线性支持向量机(linear support vector machine, SVM)解码猴 ITC 神经群体的反应模式,发现即使在单细胞对位置和尺寸敏感的情况下,训练在某一位置/尺度上的分类器仍能较好地在另一位置/尺度上识别物体(性能从约 76% 降到 70%);人类 fMRI 的多体素分析(Schwarzlose et al., 2008)也得到了类似结论。这自然诱人地引出一个解读:也许群体层面可以比单细胞层面"更不变",从而同时满足选择性与容忍度两个目标。但作者指出这一解读存在三个未被检验的缺口:群体研究没有报告单神经元/单体素水平的不变性程度作为对照;没有研究回答"哪些不不变的单元调谐特性允许、哪些不允许不变读出";更没有人估计群体水平的不变性如何依赖群体本身的特征,如群体规模(pool size)与噪声相关性。这正是本文要填的空。
研究思路
作者的策略是把问题拆到最简、最可控的情境里做"显式检验"。他们在二维刺激空间中训练一个线性分类器去解码某一个特定值:两个维度中只有一个是任务相关的(relevant dimension, RD,可类比为物体身份),另一个与任务无关(irrelevant dimension, ID,可类比为位置或尺寸),训练时 ID 恒定不变,测试时则系统改变 ID 取值,看网络能否泛化。这样,辨识(identification,即任务内表现)与不变性(invariance,即跨 ID 泛化)可以被分别量化,还能考察第三种情形——两个维度任务相关性对调(switching)后网络的表现。选择模拟而非真实数据,是因为在"线性群体读出能否自发产生不变性"这一假设的检验上,一个完全透明、参数可控的环境比复杂度尚未被完全理解的真实识别问题更合适;而选择线性 SVM 是因为它正是当时不变性文献(Hung et al., 2005; Schwarzlose et al., 2008)所用的分类器,且是保持神经可读性前提下最强的线性读出。整个逻辑链于是非常清晰:用 ITC 样的单元(带真实文献报道过的调谐宽度、噪声特征)+ 文献同款读出器,看不变性是否涌现;改为:模拟表明,只有当单元自身对RD高度选择而对ID近乎不敏感时,线性读出才能兼得辨识与不变性;对更接近实测ITC特性的非不变单元,不变性不会仅靠群体线性读出自动产生。
方法
模拟网络由若干"单元"组成,其峰值感受位置随机采自覆盖整个刺激空间的二维均匀分布;每个单元围绕峰值用二维高斯函数调谐(响应 G(x,y) = Rmax × exp(−0.5 × M × COV⁻¹ × Mᵀ),Rmax 设为 40 spikes/s,COV 为协方差矩阵,其对角元素决定两个维度上的调谐宽度 σ,非对角部分规定两维调谐之间的相关性)。为模拟神经噪声,每次试次的响应取自以 G(x,y) 为均值的 Poisson 分布;实验 III 中还加入单元间弱相关的噪声(把一个按响应强度缩放的标准正态随机数加到每个单元响应上,使单元对的响应相关约为 0.15,略抬高标准差,这与 Shadlen 和 Newsome(1998)报道的皮层实测特征一致)。读出器为线性 SVM(基于 LIBSVM/OSU-SVM 实现)。训练方式模仿 Hung 等人(2005):每个训练轮次中,信号刺激保持恒定,干扰刺激从一组 8 个刺激中随机抽取(实验 I 中它们仅在 ID 上变化,使 RD 成为唯一有信息的维度);SVM 学习判别信号与干扰分布。测试阶段给出 30 个训练中未见过的干扰值与信号的组合,每个组合重复 100 次,得到"性能—干扰值"曲线;辨识灵敏度(sensitivity)定义为把性能经 Z 变换后对所有干扰值取平均,即在标准正态尺度上高于猜测水平的标准差数;不变性则用"不变比"(invariance ratio)概括——最远离训练 ID 值的测试点上的灵敏度除以训练 ID 上的灵敏度;切换表现用切换对比(switching contrast)= (Zor − Zsw)/(Zor + Zsw) 概括,取值 −1 到 1。初始实验用 5 个一维单元,实验 I、II 用 49 个二维单元(单元数在 20 以上即达饱和),实验 III 系统改变群体规模(2–200)。
主要结果
- 一维辨识可行且随群体规模提升、约 20 个单元饱和。 5 单元网络就能在 30 个未见干扰值上识别信号值(改为:在图2C所示的一个特定信号—干扰组合中,该示例网络的总分类正确率为68%;图2D另行展示对30个未见干扰值的性能曲线。,性能随干扰到信号的距离呈 U 形),且学到的判别规则平滑泛化到新干扰(图 2)。把群体从 2 个扩到 200 个单元,灵敏度持续上升并在约 20 个单元后趋于饱和(图 3)。
- 辨识与不变性各有最优调谐,但两者在"等宽"情形下冲突。 具体:对 RD 调谐越窄辨识越好,对 ID 调谐越窄辨识略差(窄 ID 调谐使部分单元对训练刺激无效,等效于缩小群体);不变性以"RD 窄 + ID 宽(几乎忽略 ID)"的网络为最佳。而在两个维度调谐宽度相近的网络里出现权衡:两维都窄者辨识好但不变性差,两维都宽者辨识差但不变性好在图上沿对角线方向辨识灵敏度递减而不变比递增(图 5、6)。
- 两维调谐的独立性几乎不影响不变性,只要偏离独立是随机的。 改为:为各单元二维调谐中的RD–ID相关系数引入均值为0的跨单元散布;这不同于实验III的单元间噪声相关。,四个宽度条件的不变比几乎不变(无散布时约 13%、100%、3%、47%,有散布时约 7%、100%、4%、44%,图 8)。但当平均相关性系统偏离 0(设为 0.3,标准差 0.25)时,不变性大幅受损(同序号条件约 13%、99%、−5%、8%),辨识甚至可能低于猜测水平且对信号两侧干扰不对称;平均相关超过约 0.1 后不变比随依赖度明显下滑(图 9)。附带发现:切换对比只由两维平均调谐宽度之差决定,而非其绝对值(图 6C)。
- 相关噪声损害辨识,更损害不变性;增大群体反而降低不变性。 对两维等宽(σ=0.5)的网络,弱相关噪声(r≈0.15)在所有群体规模上都压低 ID-train 处的灵敏度,在最远 ID 测试值处压得更狠(图 10、11、12A)。更反直觉的是,在最远 ID 测试值上 25 单元网络的辨识竟优于 100 单元网络,且无论有无相关噪声都如此;不变比随群体规模增大而下降,在较大群体时接近 0(图 11C/D、12B)。作者的解释是:大群体里 SVM 有足够信息专注于对训练条件最优的单元、可以"忽视"其余单元,于是训练条件下的辨识更好,但对意外变化更脆弱——不变性没有从更大的群体中受益,反而吃了亏。
图注解读
图 1 · 单细胞调谐特性与两种不变性的定义
原文图注:FIGURE 1 | Tuning properties of single neurons and defi nitions of invariance. (A) The tuning of one simulated neuron for retinal stimulus position (horizontal and vertical dimension in the colour matrices) as assessed with two shapes and two different sizes. The position and size sensitivity of this simulated neuron is representative for empirically measured tuning properties in monkey inferior temporal cortex. (B) The 'relative invariance' of tuning for multiple dimensions can be assessed by ranking stimuli that vary on one dimension based on the response strength at one value of a second dimension, and then verifying whether this stimulus preference is the same at another value of this second dimension. Here this phenomenon is illustrated with shape (left panel) or size (right panel) as the first dimension of which the values are being ranked, and retinal position as the second dimension. (C) The 'independence' of tuning for multiple dimensions can be assessed by comparing the joint 2-D tuning with the marginal tuning in which the tuning for one dimension is plotted averaged across all values of the other dimension. The left panel illustrated independence of tuning, the right panel a high degree of dependence.
这张图是全文的概念地基。A 面板用模拟神经元展示了"典型 ITC 单元"的样子:颜色矩阵的两个轴是视网膜位置(水平 × 垂直),三个子阵对应不同形状/尺寸组合——同一个单元对位置、形状、尺寸三者全敏感,矮的感受野配不上"高不变性"的理想。B 面板演示第一种不变性定义——"相对不变性"(relative invariance):在一个位置上按反应强度给形状(或尺寸)排序,看换一个位置后排序是否保持;这是离散维度研究常用的判据。C 面板演示第二种定义——"独立性"(independence):把二维联合调谐与两维边际调谐(对另一维取平均)相比,左图两者可由乘积重构(R=0.00,独立),右图不能(R=0.66,强依赖)。理解这两种判据有助于读懂后文实验 II 对"调谐依赖性"的操作:它操纵的正是 C 意义上的独立性。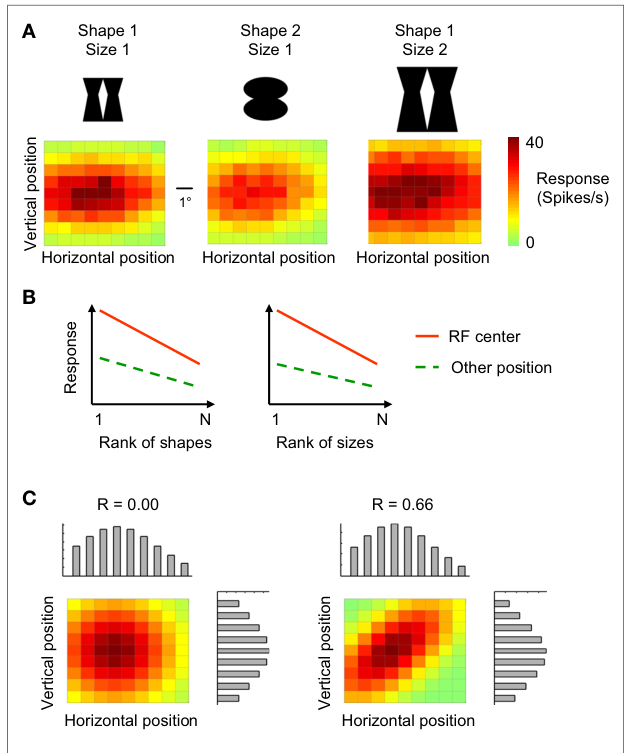
图 2 · 引导实验:一维辨识任务的基本表现
原文图注:FIGURE 2 | The introductory experiment. (A) The network was trained to discriminate a 1-D signal (full black line) from a 1-D distracter, randomly selected from a set of eight distracters (dotted black lines) on each trial. (B) The Gaussian-shaped tuning functions for one particular network. (C) Estimates of the distribution of the decision statistic computed by the SVM for the signal (in red) and one particular distracter (in green) for one network, based on 1,000 trials. The full black line depicts the decision boundary used by the SVM to classify network responses. (D) Classification performance as a function of distracter value in the identification test. Green symbols indicate results for the network shown in Figure 1B, blue symbols results averaged over 100 networks. (E) Normalized average classification performance as a function of distracter value. These data correspond to the blue symbols shown in panel (D). After normalization, performance is expressed in units of standard deviation above (or below) guess rate. Averaging over all 30 distracter values yields the sensitivity statistic used throughout the paper.
这是最简单的热身实验,帮助读者建立对全部流程的直觉。A 是任务设计:信号固定在某一值,干扰每次从 8 个值中随机抽(一半低于信号、一半高于信号)。B 是 5 个示例单元的高斯调谐。C 展示 SVM 内部机制:信号与某干扰的决策统计量各呈近似正态分布(中心极限定理的后果),黑线是分类边界——这个例子里信号几乎总是判对,而离信号近的干扰一半以上判错,总正确率 68%。D 是核心结果:性能对干扰值呈 U 形(离信号越近越难判),曲线平滑说明训练学到的判别规则泛化到了新的干扰值;绿点为单个网络(曲线不对称,取决于单元位置与调谐宽度),蓝点为 100 个网络的平均。E 把蓝色数据经 Z 变换标准化,横轴干扰值、纵轴高于猜测水平的标准差数,对所有 30 个干扰值取平均即得全文贯穿使用的"灵敏度"指标——图 3 及后续所有总结图的读数都由此而来。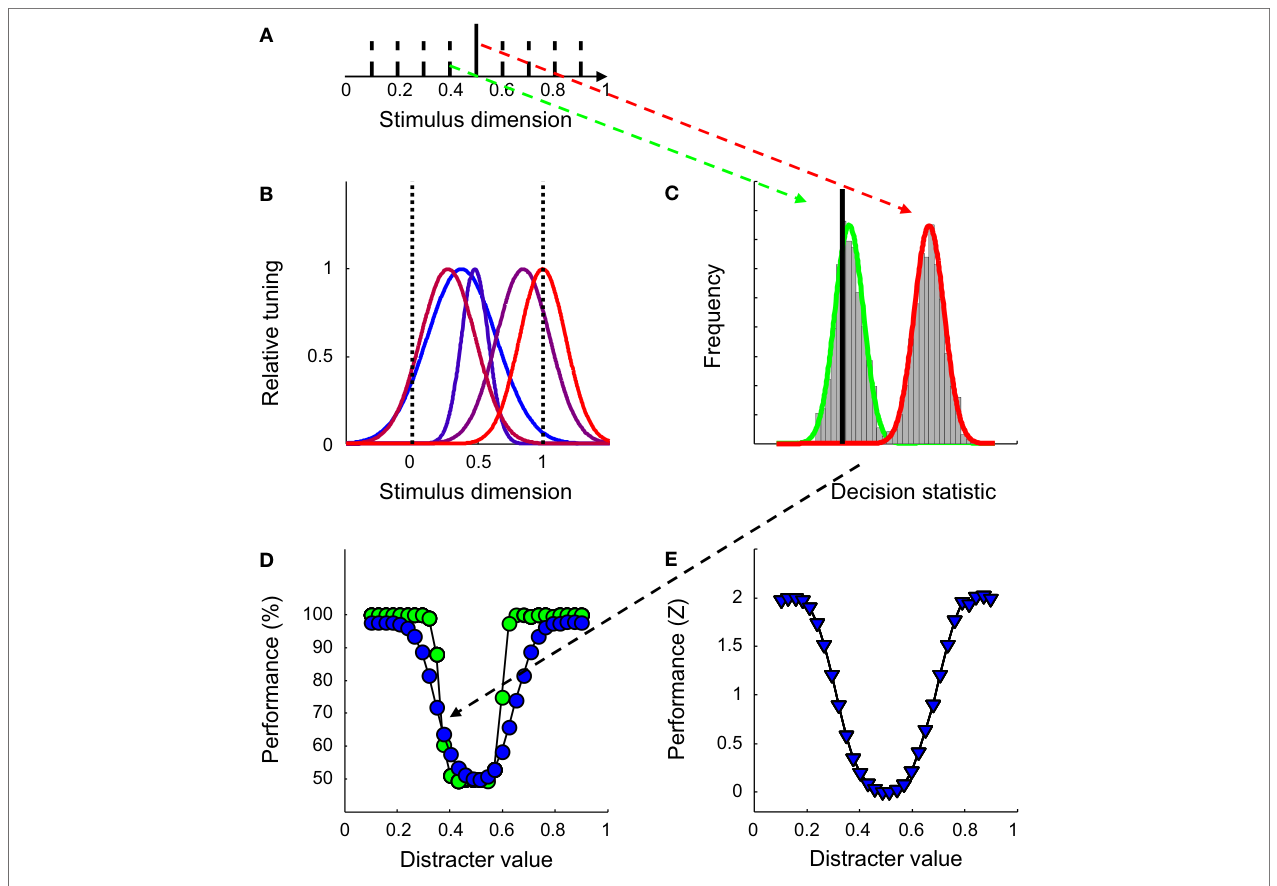
图 3 · 群体规模对分类性能的影响
原文图注:FIGURE 3 | The effect of pool size on classification performance. (A) Classification performance is plotted as a function of distracter value for three different pool sizes. Pool size is indicated by the figure legend. (B) Sensitivity as a function of pool size on semi-logarithmic coordinates. Error bars indicate ± 1 SD.
A 面板横轴为干扰值、纵轴为正确率,三条曲线分别对应 2、4、28 个单元的群体(每个规模 100 个网络平均):曲线整体随群体增大而抬高,即信息量在累积。B 面板把综合表现换成灵敏度(Z 单位),与群体规模画在半对数坐标上:规模越大灵敏度越高,误差棒为 ±1 SD。关键读点在于增长并非无限:从约 20 个单元起,再加单元对表现几乎没有帮助——这在后文给了作者使用 49 单元网络(实验 I、II)的依据,也让"群体规模"在实验 III 中成为一个有独立操作意义(小规模未饱和时可能行为不同)的参数。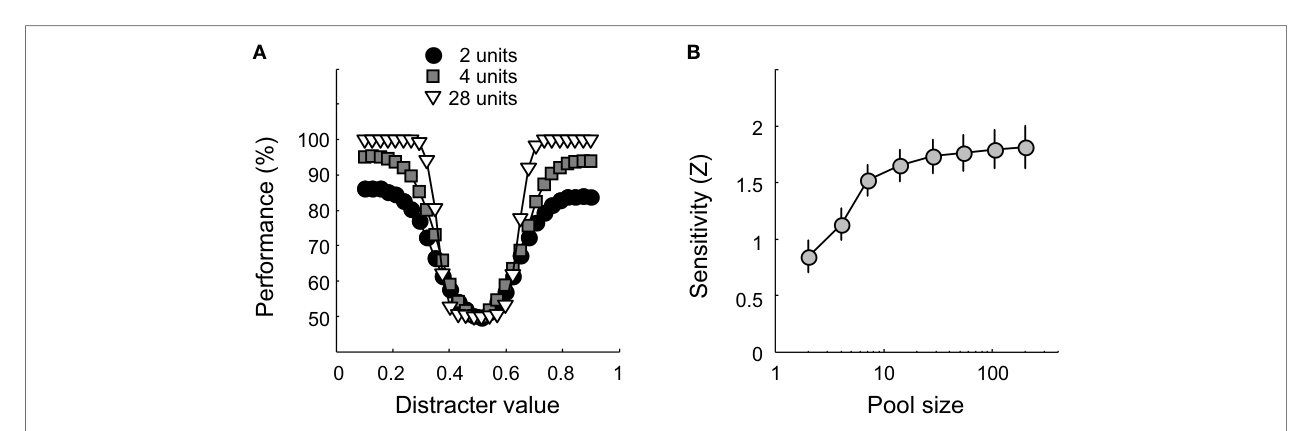
图 4 · 实验 I 的设计
原文图注:FIGURE 4 | The design of experiment I. (A) The network was trained to discriminate a 2-D signal (green symbol) from a 2-D distracter, randomly selected from a set of eight distracters (blue symbols) on each trial. Red arrows indicate the stimulus value on the ID in the five identification tests. (B) The distribution of peak-sensitivities of all units for one particular network. (C) The 2-D Gaussian-shaped tuning function of one network unit. The red square indicates the bivariate uniform distribution from which peak-sensitivities were randomly selected.
A 面板把任务从一维推到二维:绿色符号是信号(2-D),蓝色符号是 8 个干扰——它们只在与信号无关的维度(ID)上散布,因此只有相关维度(RD)携带判别信息;红色箭头标出 5 次辨识测试时 ID 的取值,其中 0.2 与训练一致(ID-train=0.2),其余 0.35、0.50、0.65、0.80 逐渐远离训练值。B 展示一个 49 单元网络的峰值感受位置在二维空间中的随机撒布(红色符号)。C 是单个示例单元的二维高斯调谐曲面(注意该单元对 RD 调谐较窄、对 ID 较宽,且峰值约在 (0,0)),红色方块标出峰值采样的均匀分布范围。这页图说明实验 I 的全部自由度:调谐宽度在两维上各自独立地在 0.125 到 1 之间变动(宽度标准差固定为 0.1),后面图 5–6 的结论都建立在这套设计的输出上。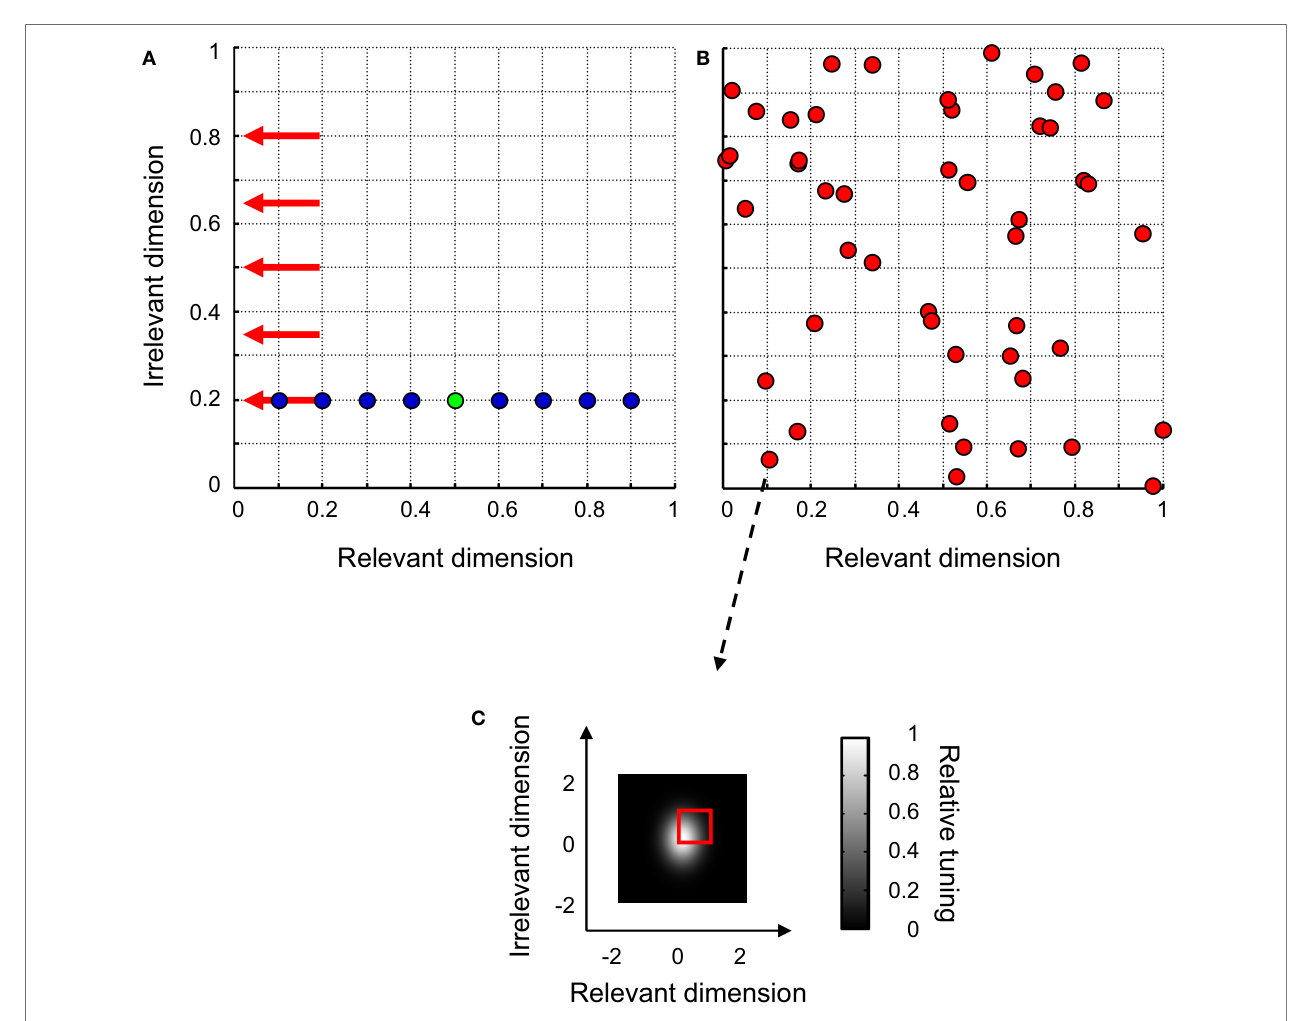
图 5 · 实验 I 四种网络类型的全部结果
原文图注:FIGURE 5 | Results of experiment I for four network-types. The leftward panels illustrate the average bivariate tuning functions of the network units. Conventions are identical to those of Figure 4C. Identification. Classification performance is plotted as a function of distracter value on the RD. The ID value of all test stimuli was identical to the training situation. Invariance. Classification performance is plotted as a function of distracter value for five different ID values of the test stimuli. Symbol colour indicates the ID value (as symbols become lighter, the distance between ID-test and ID-train increases). Switching. Classification performance when the relevance of both dimensions is swapped.
分行四(narrow-narrow、narrow-broad、broad-narrow、broad-broad 四种宽度组合,行首小图是网络单元的平均二维调谐),分列三。辨识列(左):ID 测试值与训练一致时的性能—干扰值曲线,可见 RD 窄调谐带来最高辨识。不变性列(中):同一分析但在 5 个 ID 取值上分别测试,符号颜色越浅表示测试 ID 离训练 ID 越远;如果网络真正不变,五条曲线应重合——只有 narrow-broad 网络(图 5E)做到这一点,其他网络曲线随 ID 偏离而塌陷。切换列(右):把两维的任务相关性对调后重新 Training 的性能(作者未重跑模拟,只是交换 RD/ID 标签),对两维等宽的网络切换后曲线应与不变性列一致。整图是结果第 2 条的直接证据:辨识与不变性在等宽情形下此消彼长。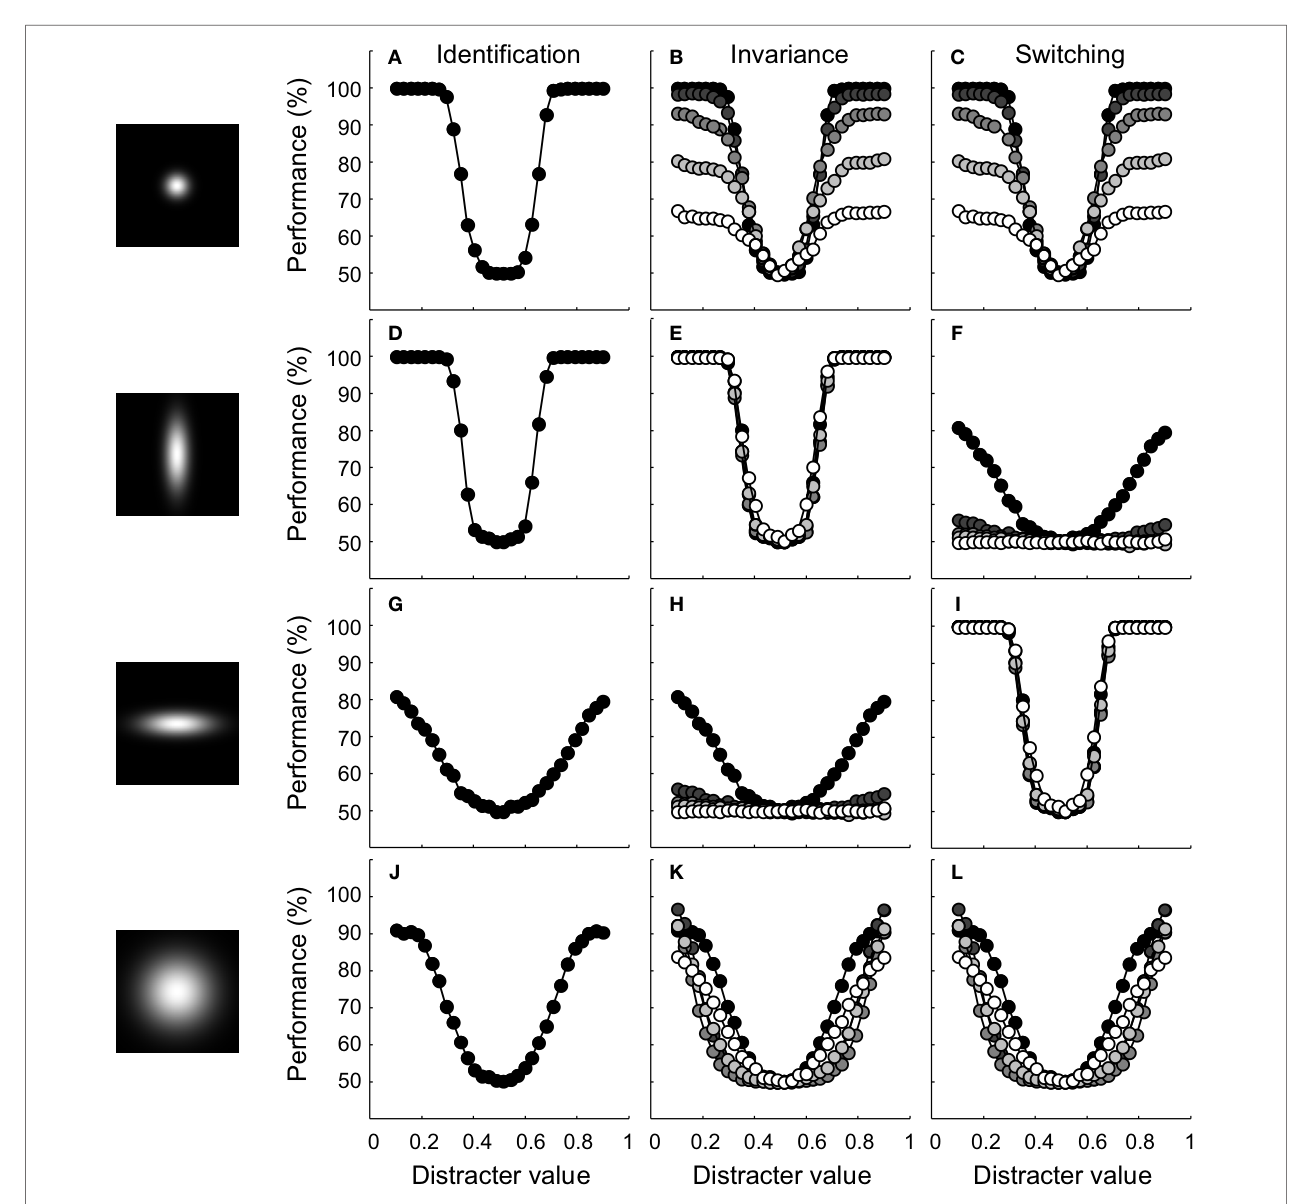
图 6 · 实验 I 结果的汇总矩阵
原文图注:FIGURE 6 | Summary of the results of experiment I. (A) Identification sensitivity as a function of average unit tuning width on the RD and ID. Each cell summarizes results of one network-type. (B) The invariance ratio as a function of average unit tuning width on the RD and ID. (C) Switching contrast as a function of average unit tuning width on the RD and ID.
三个彩色矩阵把实验 I 压缩成三张"地图":横轴均为 RD 平均调谐宽度(0.25–1 σ),纵轴为 ID 调谐宽度,每格一种网络。A(辨识灵敏度,Z 单位):行方向颜色变化剧烈——RD 窄则辨识高;列方向温和变化——ID 宽略有好处(等效于扩大有效群体)。B(不变比,%):RD 窄且 ID 宽的角落最优;关键读点是"上对角线"(两维等宽的一线):A 里沿线辨识递减,B 里沿线不变比递增——同一种调谐变宽的操作让辨识与不变性反向变化,这正是权衡的显影。C(切换对比,−1 到 +1):数值沿右上方向几乎恒定,说明切换损失的相对幅度只由两维宽度之差决定——这个发现看似技术性,实则与"真实视觉中 RD/ID 界限并不分明"的讨论直接相关。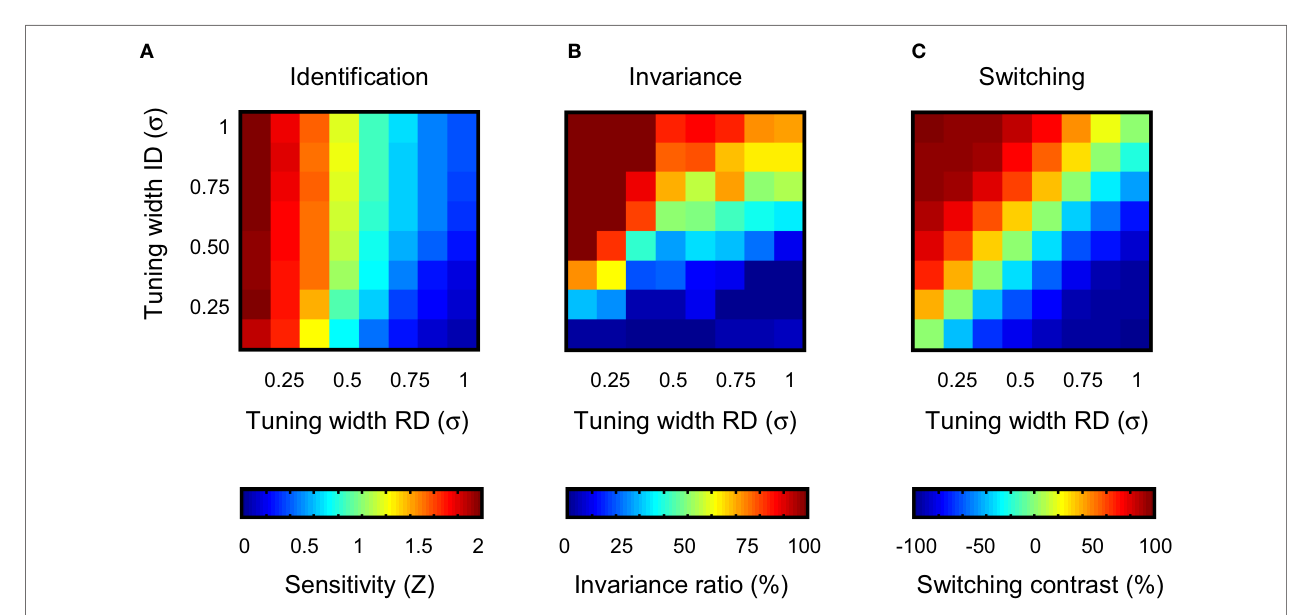
图 7 · 相关调谐(依赖性)的操作方式
原文图注:FIGURE 7 | The effect of dependent tuning. (A) The average 2-D unit tuning function for a particular network. (B) The correlation-distributions used in experiment II. (C) Some example unit tuning functions corresponding to the average tuning width shown in panel (A) and the correlation-distribution depicted by the full line in panel (B).
实验 II 的工具图。A 是所考察网络的平均二维调谐函数:两维选择性相同、调谐宽、且平均独立。B 给出实验 II 用到的"相关性分布":横轴为单元二维调谐间的相关系数,纵轴概率密度;实线是均值 0、有一定散布(scatter)的分布,虚线是均值 0.3(系统依赖)加散布的分布。C 展示在实线分布下抽出的几个单元的实例调谐:多数感受野不再呈水平/垂直的"正交"朝向,而是斜的——即这个单元对一维的敏感性随另一维取值而变,单个单元不再持有任何不变的表达。这张图直观地区分了两件事:单细胞层面的调谐依赖 vs 群体层面的系统性偏倚,为图 8 的对比铺路。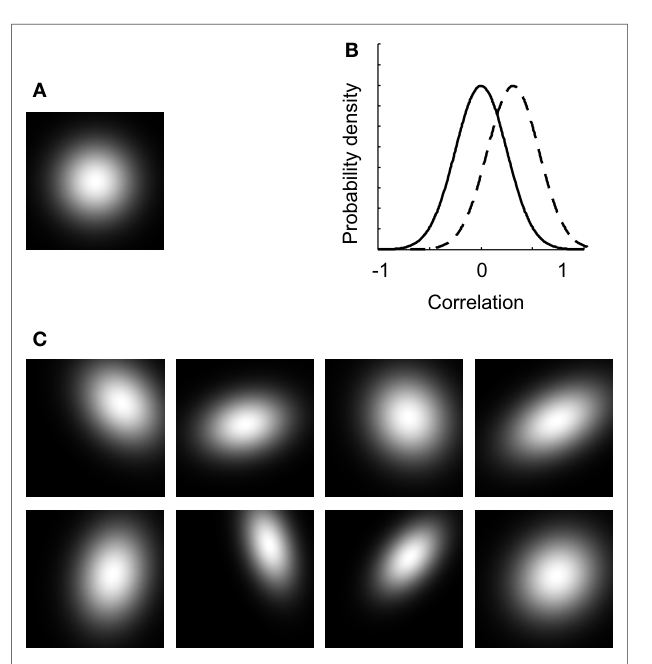
图 8 · 实验 II:散布与偏倚的不同后果
原文图注:FIGURE 8 | Results of experiment II. The leftward panels illustrate the RD and ID selectivity of the average bivariate tuning functions of the network units. Conventions are identical to those of Figure 4C. No scatter. Classification performance is plotted as a function of distracter value for five different ID values of the test stimuli. Conventions are identical to Figure 5. For these networks, unit tuning functions were not correlated. Scatter. For these networks, average dependence was equal to 0. There was some variation in the dependence of the unit tuning functions, however. Bias + scatter. For these networks, average dependence was equal to 0.3. There was also some variation in the correlation of the unit tuning functions.
改为:四行四种调谐宽度组合 × 三列依赖条件的网格。三列分别为:无散布(no scatter,单元完全独立)、散布(scatter,平均相关 0 但单元间有变化)、偏倚 + 散布(bias + scatter,平均相关 0.3、标准差 0.25)。每个小格里是五个 ID 测试值的性能曲线(惯例同图 5)。读法是纵比列、横比行:散布列相对"无散布"列几乎看不出系统性差异(不变比依次约 7%、100%、4%、44%,对照无散布的 13%、100%、3%、47%),说明只要依赖是随机的,群体就把它平均掉了;偏倚 + 散布列则出现清晰退化——例如宽-宽网络的不变比跌到 8%,偏倚 + 散布下辨识可能低于猜测水平、且对信号两侧的干扰表现不对称(图 8L 最明显)。这张图支撑结果第 3 条:真正伤害不变性的是系统性的调谐依赖,而非依赖性的个体差异。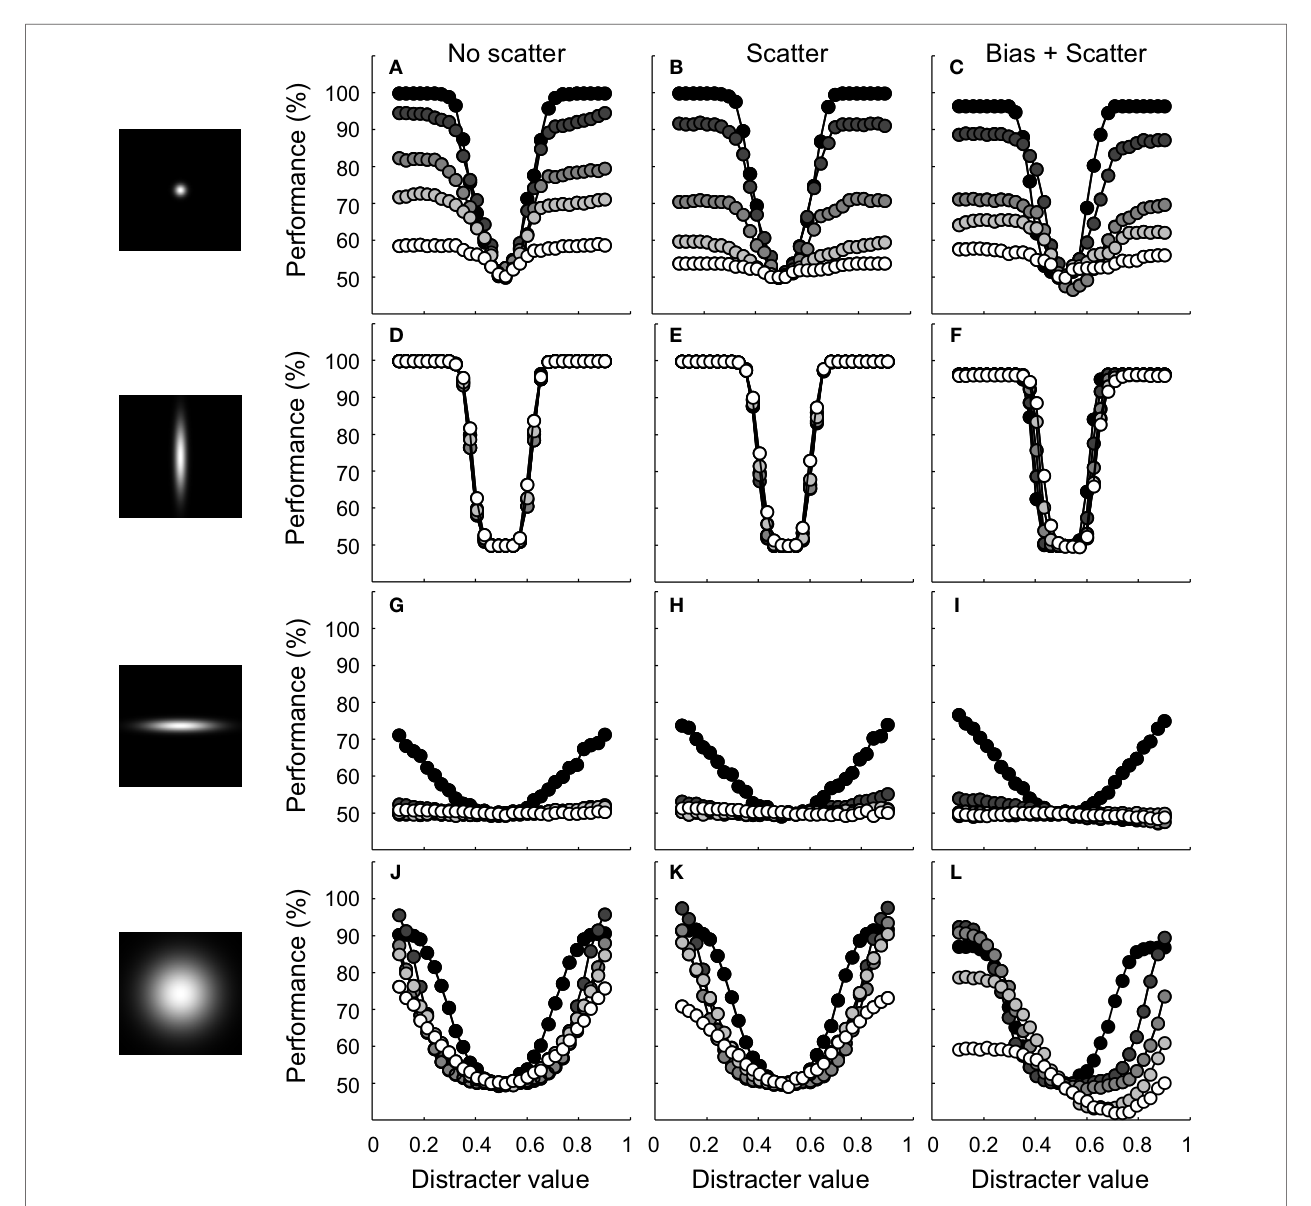
图 9 · 平均依赖度与不变比的关系
原文图注:FIGURE 9 | Correlated neural noise in experiment III. The invariance ratio for the 'broad-broad' network of Figure 8 is plotted as a function of average dependence of the unit tuning functions (the standard deviation in correlation was always equal to 0.25).
横轴是慢慢单元二维调谐间的平均相关(依赖度),纵轴是宽-宽网络的不变比(相关性散布固定为 0.25)。曲线显示:平均相关在 0.1 以下时不变比还大体维持,一旦越过约 0.1 便明显下滑。它给实验 II 的结论划出了定量刻度——不是"有依赖就完蛋",而是"系统性依赖超过一个小阈值后不变性开始被侵蚀"。注意图注虽冠以"实验 III"字样,正文明确说明此图承载的是实验 II 依赖性操作(对调谐相关而非噪声相关)的量化,属于文中图注与正文的轻微错位,阅读时应以正文为准。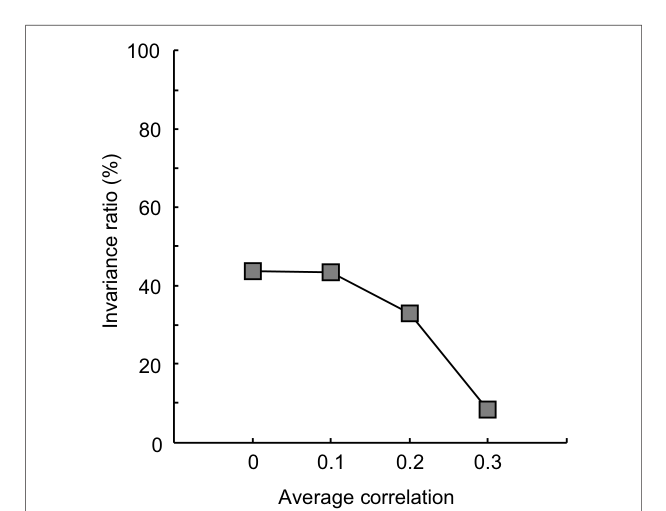
图 10 · 相关噪声在单元层面长什么样
原文图注:FIGURE 10 | The effect of pool size and correlated noise on classification performance in experiment III. (A) Responses of one unit to 100 stimulus presentations are plotted as a function of the responses of another unit to the same stimuli. These neurons share no noise. (B) Same as in panel (A) for units that share weakly correlated noise.
散点图:每个点是把同一刺激重复呈现 100 次时两个单元各自的响应(横轴 x 单元、纵轴 y 单元,单位 Hz)。A 中两点云毫无方向性——两个单元的噪声互不共享;B 中点云在非零响应区域沿对角方向微微拉长——它们的试次间噪声弱相关(平均相关约 0.15)。这张图把"相关噪声"这个抽象参数变成可看的图形,并预先声明其性质:它不改变单元的平均(调谐)反应,只是抬高响应方差、在试次间使单元彼此绑定。这正是图 11、12 中相关噪声杀伤不变性的物理基础。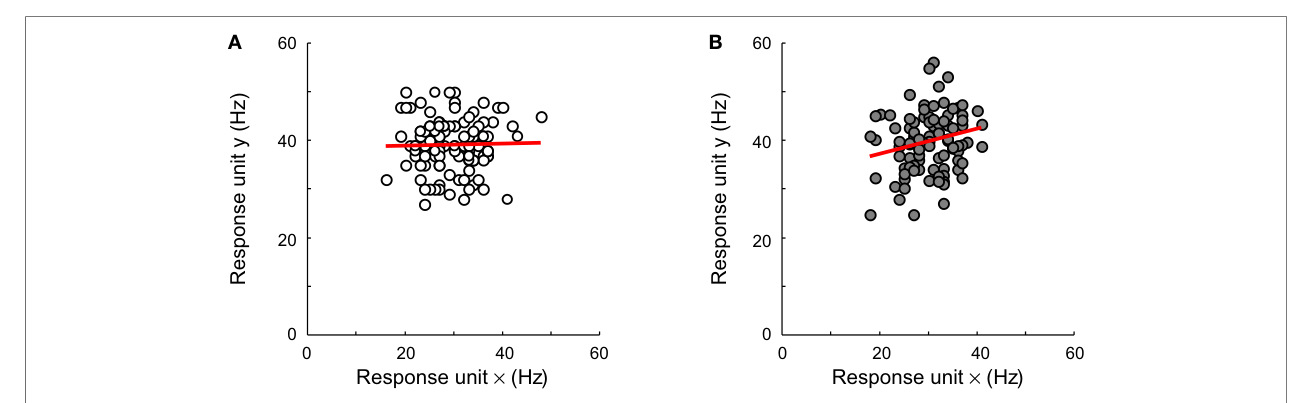
图 11 · 群体规模 × 相关噪声的四组性能曲线
原文图注:FIGURE 11 | The effect of pool size and correlated noise on classification performance. (A) Classification performance at ID-train is plotted as a function of distracter value for three different pool sizes (as indicated by the figure legend). Results in (A) are from networks without correlated noise. (B) Same as in (A) for networks with correlated noise. (C) Classification performance at the most remote ID-test location, results are from networks without correlated noise. (D) Same as in (C) for networks with correlated noise.
四个面板,横轴均为干扰值、纵轴为正确率,图例分 4、25、100 单元三档。上排(A/B)是训练 ID 处的辨识:下排(C/D)是最远 ID 测试值处的辨识。上排直接可见群体规模效应(曲线随规模抬高)与相关噪声的轻微抑制(B 略低于 A);下排是本文最反直觉的发现所在——无论有无相关噪声,25 单元的白色/灰色符号都高于 100 单元的对应符号,即小网络在远离训练 ID 的测试点上反而更宽容。这直接支撑结果第 4 条的后半句:增大群体改善的是训练条件下的辨识,牺牲的恰是跨 ID 的稳健性。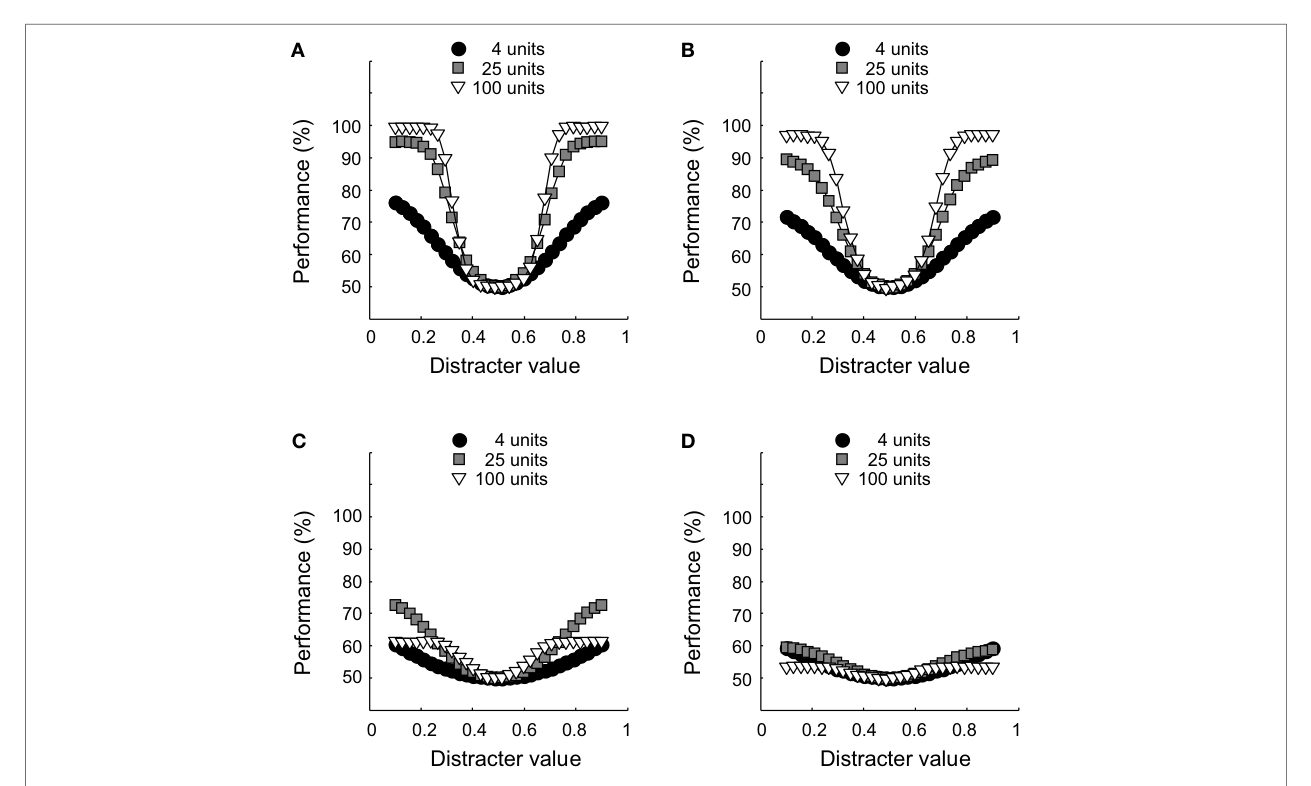
图 12 · 实验 III 的定量汇总
原文图注:FIGURE 12 | Results of experiment III. (A) Identification sensitivity is plotted as a function of pool size for both correlated noise conditions in the two different ID-test conditions on double logarithmic coordinates (circles refer to the sensitivity at ID-train, squares to the sensitivity at the most remote ID-test value; white symbols refer to networks with no inter-unit correlation; grey symbols to networks with correlated noise). (B) The invariance ratio is plotted as a function of pool size for both correlated noise conditions (white symbols refer to networks with no inter-unit correlation; grey symbols to networks with correlated noise).
A:双对数坐标下灵敏度对群体规模。圆点为 ID-train 处的灵敏度——向上爬升(群体越大越灵敏),灰色圆点全体低于白色圆点(相关噪声普遍压低辨识);方块为最远 ID 测试值处的灵敏度——灰色方块比白色方块降得更多,说明相关噪声打击最大的恰是不变性所在的位置;且方块在达到某个规模后反而随规模下降。B:不变比对群体规模。即便无相关噪声,不变比也随群体增大而走低;叠加相关噪声后下降更陡,较大群体时不变比接近 0。这与"群体越大应该越不变"的直觉完全相反,是权衡论证在实验 III 的最终显影。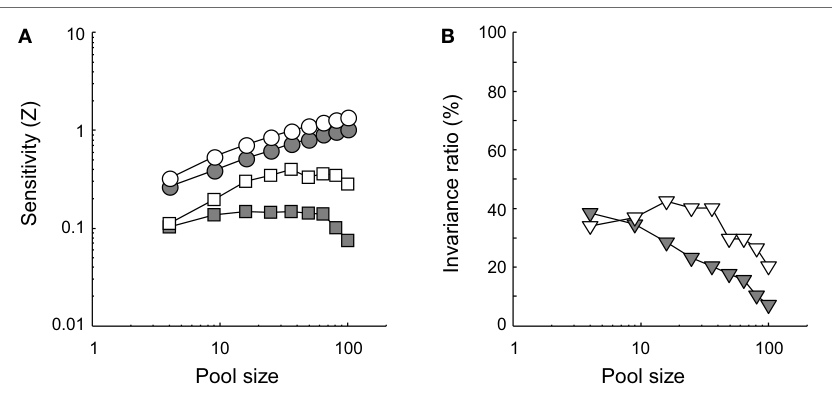
讨论
作者把核心结论压缩成一句话:由非不变单元组成的群体,其线性读出本身就是非不变的。调谐相关(依赖性)的作用是分岔的——平均相关偏离 0 会强烈且不对称地伤害不变性,但这种系统性偏倚在实际数据里若被观察到,多半说明实验者定义的维度与单元真实的调谐维度不匹配(作者引 Ashby 与 Townsend 1986);而围绕均值的随机散布几乎无碍,只是与调谐宽度交互、在低不变性的网络里略有落井下石的效果。据此作者重估了 Hung 等人(2005)从 76% 到 70% 的"跨越位置识别":并不需要把它解释为群体层面的额外不变性——该研究用的位置变化只有约 4 视角的小幅度,而 ITC 神经元的平均感受野大到足以把它们一并覆盖;且 Hung 等人的"群体"由不同时记录的神经元拼成,不含相关噪声,按本文结果这还会高估不变性。作者由此提出一个锐利的表述:若平均单细胞对某个图像变换敏感,群体水平的分类也将敏感,有时甚至更敏感——平均单细胞选择性可能构成网络不变性的上限。Zoccolan 等人(2007)的单细胞权衡使系统无法同时拥有对两维差异极大的选择性,于是读出层面又叠加一层辨识—不变性权衡;两重权衡共同预测 ITC 神经元不应过度选择物体。
局限方面作者自己列了三条:其一,模拟只用高斯调谐,这是文献中最常用、也是最大熵意义上的"默认分布",但最优调谐形态可能依赖噪声特征与读出约束,换其他分布结论未必全同;其二,对相关噪声与群体规模只是初步涉及,诸如"高选择性与低选择性单元噪声相关性不同"等情形未考察;其三,只测了线性 SVM 这一族读出,真实脑的读出可能更强——例如可以基于既往经验预先挑选"有用"的神经元子类,而本模拟中没有对单元做任何先验标注,真实大脑并非学习新任务时不带任何先前连线的白板。作者还特别指出有限的适用范围:结论针对的是"训练时只见过一个 ID 值"的情形;若在足够多 ID 值上训练(如既往工作用三个差别很大的视角训练),网络完全可以获得不变性。作为行为层面的呼应,他们提到面孔与文字这类"过度学习"的刺激:我们对微小差异极敏感,却在倒置或异常尺寸下表现骤降(McKone、Pelli、Robbins 与 McKone 等人的工作)——人脑在特定刺激类上正是"高选择、低容忍",但作者谨慎地声明这只是类比,并非证明同一机制在起作用。
一句话总结
在我看来,这篇论文的价值不在于发现了什么新机制,而在于干净利落地证伪了一个当时很诱人的想象——"线性解码一群不那么不变的神经元,不变性会自然长出来";它的回答是:不会,垃圾进垃圾出,平均单元的不变性上限就是群体的上限,而且群体越大、读出越"精明",反而越容易固化在训练条件上。当然,这只对线性读出成立,而真实视觉系统的读出未必只有线性这一种——不过正因如此,它给后来"非线性读出、训练多样性带来不变性"的研究留了一块明确的垫脚石。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A, B] - Fig10: 提取质量
good,对齐度full,识别面板[A, B] - Fig11: 提取质量
good,对齐度full,识别面板[A] - Fig12: 提取质量
good,对齐度full,识别面板[A] - Fig2: 提取质量
good,对齐度full,识别面板[A, B, C, D] - Fig3: 提取质量
good,对齐度full,识别面板[A, B] - Fig4: 提取质量
good,对齐度full,识别面板[A, B, D] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig7: 提取质量
good,对齐度full,识别面板[A, B, C, D] - Fig8: 提取质量
good,对齐度full,识别面板[] - Fig9: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'md_section': '一句话总结', 'current_text': '干净利落地证伪了一个当时很诱人的想象', 'classification': 'OVERCLAIM', 'problem': '模拟只检验了二维高斯调谐、线性SVM及训练阶段仅出现一个ID值等限定条件。作者使用的是“found little support”和“不自动产生”,并非对所有群体读出或不变性机制的普遍证伪。', 'recommended_fix': '改为:在本文检验的高斯调谐、单一ID训练和线性SVM条件下,结果不支持不变性仅由非不变单元的群体线性读出自动涌现。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'md_section': '一句话总结', 'current_text': '平均单元的不变性上限就是群体的上限', 'classification': 'OVERCLAIM', 'problem': '原文措辞是平均单细胞选择性“可能”为网络可达不变性提供上限。V0把作者的条件性推论改写成了确定事实。', 'recommended_fix': '改为:在这些模拟条件下,平均单元的调谐特性可能限制线性群体读出可达到的不变性。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'md_section': '一句话总结', 'current_text': '群体越大、读出越‘精明’,反而越容易固化在训练条件上', 'classification': 'OVERCLAIM', 'problem': '群体增大导致远端ID表现下降是在实验III特定网络中观察到的:两维平均调谐宽度均为σ=0.5、单一ID训练、线性SVM,并非已证明适用于所有群体编码。', 'recommended_fix': '改为:在实验III所测试的等宽调谐网络中,群体超过一定规模后,SVM对训练条件的优化伴随远端ID泛化下降。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_004', 'md_section': '讨论', 'current_text': 'Hung 等人的‘群体’由不同时记录的神经元拼成,不含相关噪声,按本文结果这还会高估不变性', 'classification': 'INTERPRETATION_PRESENTED_TOO_CERTAINLY', 'problem': '原文称这种做法“might be an over-estimation”;由于本文相关噪声模型高度简化,不能确定Hung等人的结果必然被高估。', 'recommended_fix': '改为:Hung等人的非同时记录群体不包含试次间相关噪声;本文模拟提示,这可能使其不变性估计偏高。'} -> 评注:
- 补充要点: : (第 8 页)
- 补充要点: : (第 4 页)
- 补充要点: : (第 7 页)
- 补充要点: : (第 11 页)