一句话定位:这是 Cathy Price 对 2009 年发表的 100 余篇语言 fMRI 研究做的"年度解剖学综述"。它把散落在不同实验范式里的激活焦点按"前词汇—词汇—句子"的层级归拢到同一套解剖术语之下,画出一张统一的Language解剖地图,并给出"自上而下预测决定左侧化"的核心假说。对任何想快速建立语言脑区功能归属框架的读者来说,这是极好的"总纲"式文献。
研究背景
到 2009 年为止,语言功能的 fMRI 研究已经积累成海量文献,但存在一个明显问题:不同研究对同一脑区使用不同术语——同一个额下回区域有人叫 Broca 区、有人叫 BA44、有人叫盖部(pars opercularis);同一个左颞顶区域被分别称为缘上回(supramarginal gyrus, SMG)、planum temporale、Spt 或下顶叶。更重要的是,各研究的比较基准五花八门,读者很难把"听句子—听觉词—口部动作"这些结果拼成一个连贯的功能解剖图景。经典的 Wernicke–Lichtheim 类模型把理解与产生当作流水线上分离的阶段,而近年文献反复出现"理解任务激活了运动/产生区"的现象,需要重新解释。
当时已知的是:听觉通路上存在从前向后的层级加工(从 Heschl 回向颞极方向逐步提取复杂声学特征);词义通达涉及广泛分布的颞叶—额叶—顶叶网络;句法加工与额下回(Broca 区)相关。缺口在于:这些结果没有被统一术语、统一坐标地整合过;"语言理解为何在难的时候招募产出一侧脑区""左颞侧化到底是自下而上声学特异性还是自上而下预测所致"这类机制问题悬而未决。
研究思路
作者的策略是"归类 + 求同":只取 2009 年 1 月至 10 月在线发表的 fMRI 论文(排除 MEG/EEG/TMS/光学成像、阅读文字、手语、双语、病人群体),按理解/产生两大类、再按前词汇、单词、句子三级刺激层级逐一归类,然后提取每篇报告的 MNI/Talairach 坐标,用一套自己统一修订的解剖术语(如把额下回分为 pTr、pOr、背侧盖部 dpOp、腹侧盖部 vpOp 四区;把外侧裂后端统一标为 pPT/vSMG 以强调其包含两个可能功能不同的区)重新标注。作者刻意用低分辨率的卡通脑图汇总(图 1、图 2),因为各研究间坐标的"跨被试/跨模板"精度本来就低,宁可用相对分布的一致性说话。这个设计逻辑是:跨研究一致性本身是一种证据,但结论必须交由未来被试内(within-subject)设计去精确化。
方法
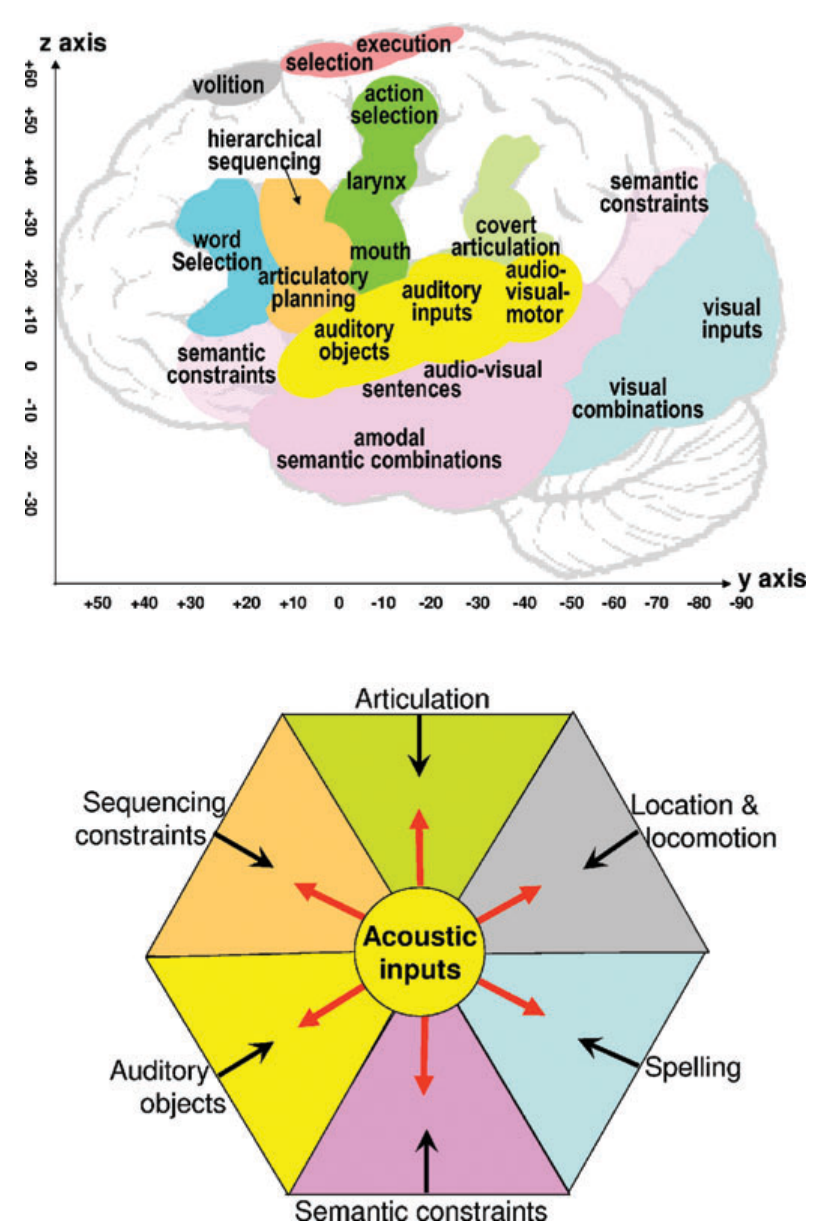
本文没有自己的新数据:材料是 100 余篇 2009 年 fMRI 论文的激活坐标与结论(作者按摘要逐篇归类,正文引用了约 130 余篇参考文献)。整合手段有三:一是术语统一与坐标重定位(用 MNI 与 Talairach 两套模板核对每个焦点落在哪个区);二是把同方向的结果画到二维卡通半球上做分布比较(图 2 分六个小面板:前词汇、假词、词、句子、语义/句法冲突、词提取与构音);三是把典型比较(如"有意义句 vs 无意义句""听词 vs 听伪词")在各研究间的共同激活区提炼为功能归属(图 3)。被试对象为健康成人;分析的"自变量"是各研究使用的对照条件(如频谱旋转言语、伪词、不可压缩句等),作者在其间做定性 meta 整合,而非定量元分析。
主要结果
- 前词汇听知觉在双侧颞上回(Heschl 回附近及前外侧方向)增强;但"言语选择性"反应出现在�侧、腹侧与后方多个方向(如噪声渐变为言语 vs 音乐的形态法范式),且更倾向在"违反预期"(预测误差)时出现左侧化激活(图 2 左上面板)。
- 听觉词的语义加工形成一个环绕围巾状核心区的外环:词相对伪词激活扩展到双侧前中颞、后颞顶、楔前叶及左侧颞极、后中颞、前梭状回、额下回眶部、中额回等;而伪词相对词则加压于前词汇的颞上区——形成清晰的双分离(Davis & Gaskell 的元分析;图 2 左中面板)。
- 句子理解(语义通顺 vs 不通顺,语法均正确)激活反而比单词语义更"收敛",集中在颞上沟腹侧壁的前、后两团(左前中颞 [−46 −6 −10] 等、左后中颞 [−54 −41 −1] 等)、双侧颞极、左角回与后扣带/楔前叶;作者解释为多个词义在句子层面被"整合成更少的概念"(图 2 右中面板)。
- 难句子(语义/句法困难、不可理解)增加激活于 left pars opercularis 的背侧与腹侧、额下回眶部、后 planum temporale/腹侧缘上回(pPT/vSMG)及运动皮层;作者把这些统一解释为"利用语义关联、词序与构音先验来预测句子内容"的自上而下加工——pPT/vSMG 与运动区在理解变难时才一致出现,正符合默声构音(subvocal articulation)假说(图 2 下面板、图 3)。
- 言语产生在理解区的集合之上额外增加:左中额回(词提取)、左前岛叶(构音计划,而非执行)、左壳核/前 SMA/SMA/运动皮层(发起与执行)、前扣带与双侧尾状核头(抑制非目标反应,言语 vs 非言语口喉动作的对照所示);声学自我监测困难时 pPT/vSMG 再度激活(如反馈被掩蔽时 [−66 −45 15] 达峰)(图 2 右下面板)。
图注解读
图 1 · 全图的解剖术语版图
原文图注:Figure 1. Anatomical terms. The names and location of the regions referred to in the text are illustrated on a cartoon sketch of the left hemisphere. This low-resolution sketch was deliberately chosen for all figures because it had minimal anatomical details, which were not appropriate in the context of the poor spatial precision of the activation loci illustrated in Figure 2, see introductory text for further explanation.
这张图给出全文使用的区名与位置(额下回四个亚区、颞上回前后部、pPT/vSMG 等)。作者特意选低细节卡通图,是为了与图 2 中跨研究及不同空间标准化模板带来的定位误差。相称——提醒读者:这张综述里的解剖归属是"区域级"而非"微结构级"的。读后续各结果面板时,应先回这张图对学一遍每个名词的位置。
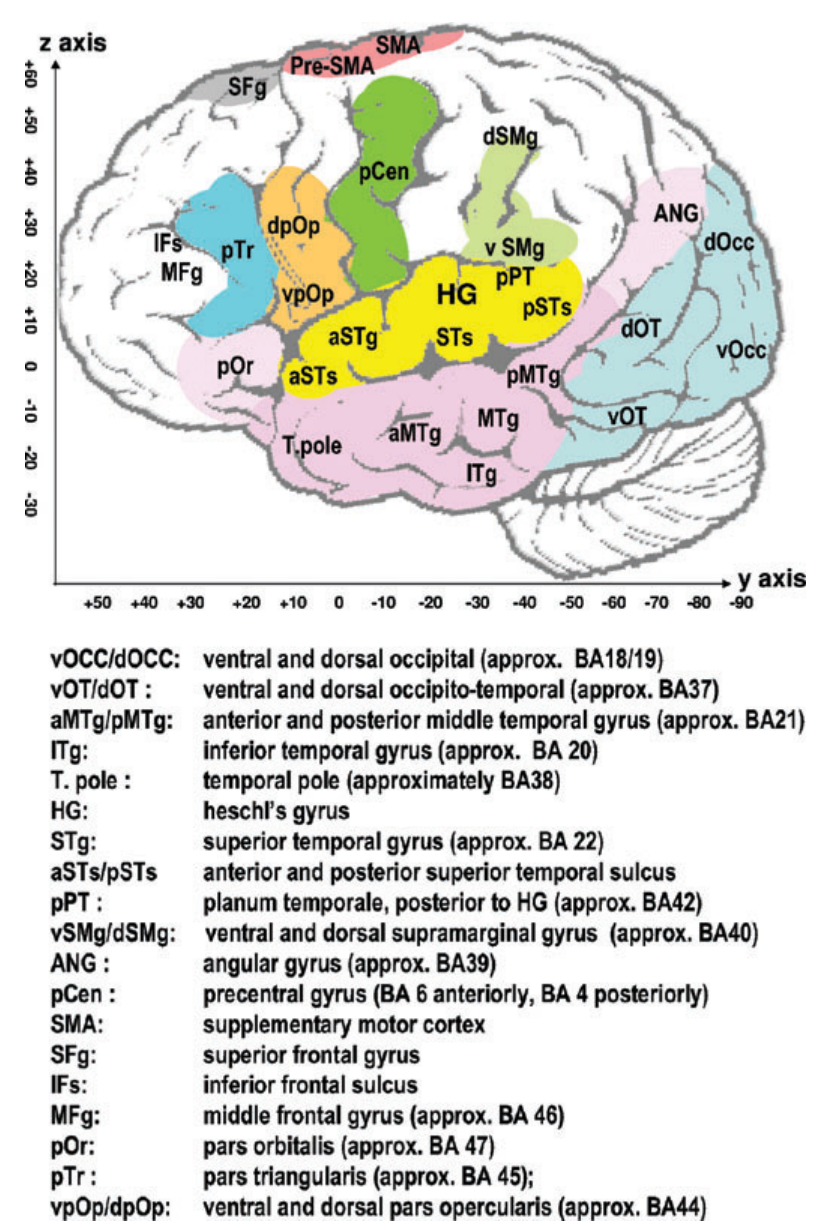
图 2 · 左半球激活焦点总览
原文图注:Figure 2. Summary of left hemisphere activation foci. The approximate location of the left hemisphere activation foci reported in the text. Right hemisphere foci were less consistent and not summarized here. Despite the poor spatial precision, the relative distributions of the different types of effects are valid and informative. Top left panel: prelexical processing; top right panel: pseudowords; middle left panel: black circles = words relative to pseudowords, white circles = words relative to rotated words, open circles = effect of familiarity with auditory objects; middle right panel: black circles = comprehension versus incomprehensible sentences, open circles = sentences with versus without visual gestures. Lower left panel: black circles = semantic ambiguity, white circles = syntactic ambiguity; lower right panel: black circles = word retrieval, open circles = overt articulation, white circles = covert articulation.
六个面板对应正文六类比较:前词汇、伪词、听觉词、句子、语义/句法歧义、词提取与构音。读法是比较面板之间的相对分布:前词汇激活紧贴颞上回;词的语义激活向外发散成环;句子语义反而收束在颞上沟腹侧壁;难句子(歧义)与构音相关激活则分别落在盖部与 pPT/vSMG。支持上文结果 1–3 的空间关系陈述。
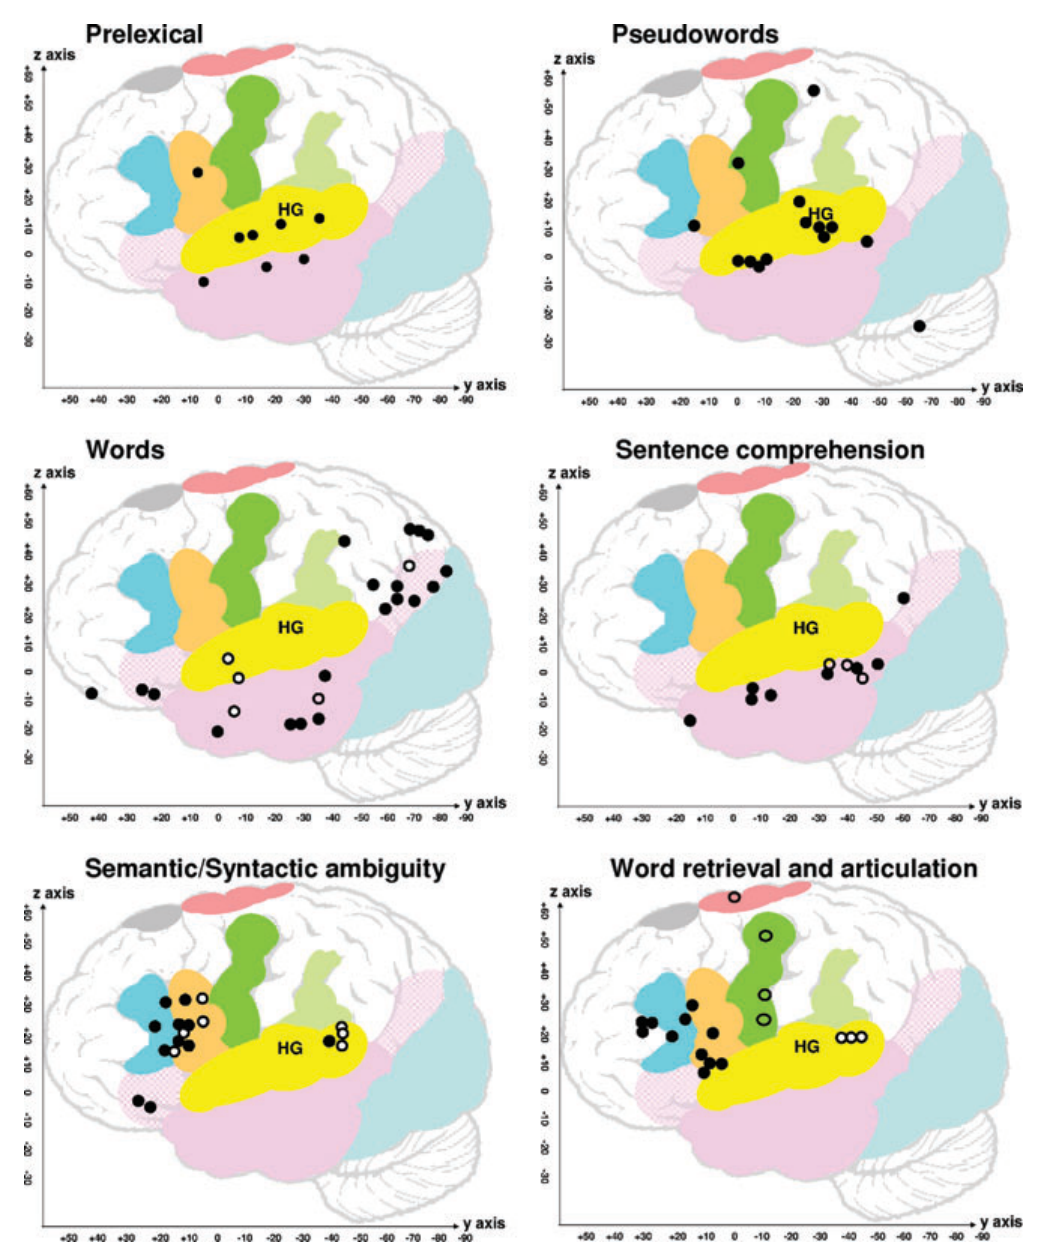
图 3 · 功能归属与自上而下加工示意图
原文图注:Figure 3. Functional attributions. Top panel: Summary of functions attributed to language areas, see text for rationale. Future reviews are required to postulate and illustrate the multiple pathways that connect these areas. Below panel: a schematic summary of the balance between bottom-up and top-down processing during speech comprehension. The hypothesis is that top-down constraints from frontal, motor, and parietal areas influence the location of activation foci for bottom-up prelexical processing of auditory inputs.
上方面板是全文的功能归属总表(各区"做什么"),下方面板是理解加工的自上而下—自下而上平衡示意。它支持上文结果 4、5 的解释框架:额叶(语义、词序)、运动区与顶叶(构音)的先验约束决定自下而上前词汇加工在颞叶的位置,这也正是"左侧化由额叶驱动"假说的图形表达。作者同时明确:连接这些区的通路由未来工作补足。
讨论
作者把理解与产生合到一张图后的核心立场是:语言网络是动态、多通路的——同一声学输入在自上而下语义先验(眶部/腹侧盖部)、词序先验(背侧盖部)或构音先验(运动区、pPT/vSMG)的拉扯下,激活的分布会改变;因此"言语选择性"不必是单一梯度,而是任务与情境决定的。左侧化问题也被改成自上而下假说:额区更一致地左侧化,颞叶的左侧化可能是额叶预测的产物,这能顺带解释左颞损伤比右颞更重地损害语言。作者坦承的局限很实在:结论依赖审阅者主观归类、跨研究比较的空间精度差、还有不少区域(如小脑)被文献长期忽视;更进一步,需要被试内设计、功能连接分析与高时间分辨率手段来走通"区域连接成通路"这最后一步。
一句话总结
在我看来这篇综述最有价值的地方不是"哪个脑区管哪个功能"的清单,而是它把激活位置改成预测证据:理解困难招募产生区,不是泄漏,而是用生成系统给感知锚定先验。读它时应当带着"归属可以商量、通路还没画完"的心态——作者自己也是这么交代的。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'claim': '自上而下预测决定语言左侧化。', 'classification': 'OVERCLAIM', 'reason': '原文仅提出可能由左额叶自上而下加工驱动的待检验假说,没有方向性连接或因果操纵证据。'} -> 评注:
- 审校纠偏: {'claim': '困难理解时pPT/vSMG与运动区一致出现并证明默声构音。', 'classification': 'OVERCLAIM', 'reason': '这些区域只在少数困难条件研究中出现,作者明确报告大量未激活结果,并将默声构音表述为可能解释。'} -> 评注:
- 审校纠偏: {'claim': '句子语义激活收敛是因为多个词义被整合成较少概念。', 'classification': 'INTERPRETATION', 'reason': '激活分布差异属于观察,但概念整合是假说,且任务混淆仍未排除。'} -> 评注:
- 审校纠偏: {'claim': 'ACC和双侧尾状核激活表示抑制非目标反应。', 'classification': 'INTERPRETATION', 'reason': '对照直接显示激活差异;抑制和序列控制是根据其他研究提出的候选功能。'} -> 评注:
- 审校纠偏: {'claim': '跨研究一致性本身构成精确的功能归属证据。', 'classification': 'INTERPRETATION', 'reason': '作者认为相对分布有信息价值,但同时强调选择性综述、空间精度差、任务差异和审阅者主观整合限制,不能据此确定精细功能分工。'} -> 评注:
- 补充要点: : (第 74 页)
- 补充要点: : (第 70 页)
- 补充要点: : (第 69 页)
- 补充要点: : (第 74 页)
- 补充要点: : (第 79 页)
- 补充要点: : (第 81 页)
- 补充要点: : (第 65 页)