一句话定位:这是第一篇把"书写字"(handwriting)的脑成像文献系统整合起来的元分析(meta-analysis)。作者用激活似然估计(Activation Likelihood Estimate, ALE)方法梳理了 18 项研究的激活坐标,划出了一个以左半球为主的 12 区书写网络,并通过两次二级元分析区分出哪些脑区是"书写特异"的、哪些只是搭上非特异运动或语言的便车。对想了解"书写脑"来龙去脉的人来说,这篇既是结果索引,也是一份很好的实验设计方法论检讨。
研究背景
书写的神经解剖知识长期来自失写症(agraphia)病人的损伤研究:中央书写过程(central processes,指抽象正字法词形的提取与音素-字素转换)与外周过程(peripheral processes,指字母形状选择、笔画排序与动作执行)的分立由神经心理模型(Ellis, 1982; Rapp et al., 2002)奠定,损伤研究提示词汇性成分与角回(angular gyrus, AG)或中央前回有关,将“语音成分与左围嗅区(perisylvian)皮层有关”替换为“语音成分与左侧外侧裂周围(perisylvian)皮层有关”。,运动成分则关联左侧上顶叶或前运动区。但损伤研究有固有限制:自发损伤位置不定、边界难划,还受神经可塑性与恢复干扰。与此同时,健康人的书写功能成像长期被冷落,单个研究之间结果彼此分歧,难以拼出一幅与失写症文献对话的"正常书写"功能解剖图。
由于书写任务牵涉感觉输入分析、语义与正字法提取、字素缓冲器(graphemic buffer,书写时的临时字素存储)以及抓笔与移动关节等大量非特异成分,单个成像研究的结果高度依赖其对照任务的选择:用画圆圈可以控运动,用口头命名可以控语言输入,但没有任何单一设计能同时剥离所有共享过程。此前的元分析(Purcell et al., 2011b)只针对"中央拼写"过程,纳入的任务甚至不必真的写出字来;本文的缺口正在于此——聚焦真实书写产出的研究,并系统考察不同对照策略对结果网络的影响。
研究思路
作者的整体策略是"先求全、再剥离"。第一步,收集所有报告了书写相关对比(contrasts)激活坐标的成像研究,用 ALE 方法求出全部研究间收敛激活的全脑网络,让每个任务范式都能发声。第二步,把各对比按对照任务的性质分为"运动输出控制"(motor output control,实验任务与画圈、手指敲击等非语言运动对照)和"语言/输入控制"(linguistic/input control,与口头命名、被动听词等对照)两类,分别做两次二级 ALE 分析。逻辑在于:只有同时经受住两类对照考验、在两次二级分析中都活下来的脑区,才可能承载真正"书写特异"的过程,即正字法向运动模式的转换。这个设计把"方法学选择如何塑造结果"从一句泛泛的批评,变成可以直接量化比较的分析。
方法
研究入选标准为:1995–2012 年间发表的 fMRI(功能磁共振成像)或 PET(正电子发射断层扫描)研究,只含健康被试,且至少报告一个涉及书写产出的对比;书写方式不限,含笔纸、数字化板、手指空书("writing in the air")、键盘打字乃至想象书写,文字系统涵盖拼音文字与日语假名/汉字语素文字。最终 18 项研究(另有 Roux et al., 2009 的未发表数据)、36 个对比、462 个激活焦点(foci)、共 229 名被试纳入(研究清单见原文 Table 1)。每个对比不做先验筛选,全部按报告的峰值坐标进入分析;焦点数在每研究 3–29 个之间。
分析使用 GingerALE 2.1 软件的 ALE 算法:对每个峰值按研究被试数设定高斯核,估计各体素出现激活的似然,用 FDR(false discovery rate,错误发现率)校正,阈值 p = .001,最小簇体积 100 mm³;Talairach 坐标必要时用标准变换转到 MNI 空间。由于主分析的簇可能过大而混杂多个功能区(如一个巨大的额顶簇),作者结合解剖标志(如中央沟)把簇拆解为值得归属的"兴趣区"。二级分析分别纳入运动输出控制的 17 个对比(218 焦点)与语言/输入控制的 23 个对比(238 焦点),两者共有的对比同时进入两套分析——作者提醒这会加强书写特异区在两边的影响,比较时须谨慎。
主要结果
-
12 区构成、以左半球为主的书写网络。主 ALE 分析得到 12 个功能区、10 个簇、21 个峰值:最大簇(7944 mm³,加权中心 −29, −21, 56)是一个覆盖左侧额上沟/中额回(L-SFS/MFG)、左侧顶下小叶/上顶小叶/顶内沟(IPS/SPL)与初级运动/感觉运动皮层(M1/SM1)的大簇,其后依次为 SMA/pre-SMA(1784 mm³)、右侧小脑前叶(antCB,1288 mm³)、左丘脑枕(pulvinar,1248 mm³)、左中央前回/额下回(1144 mm³)、右小脑后叶(816 mm³)、右额上区(376 mm³)、右顶下小叶(160 mm³)、左梭状回后部(PITC,128 mm³)与左壳核(Put,104 mm³)。(Fig. 3,完整峰值见原文 Table 2)
-
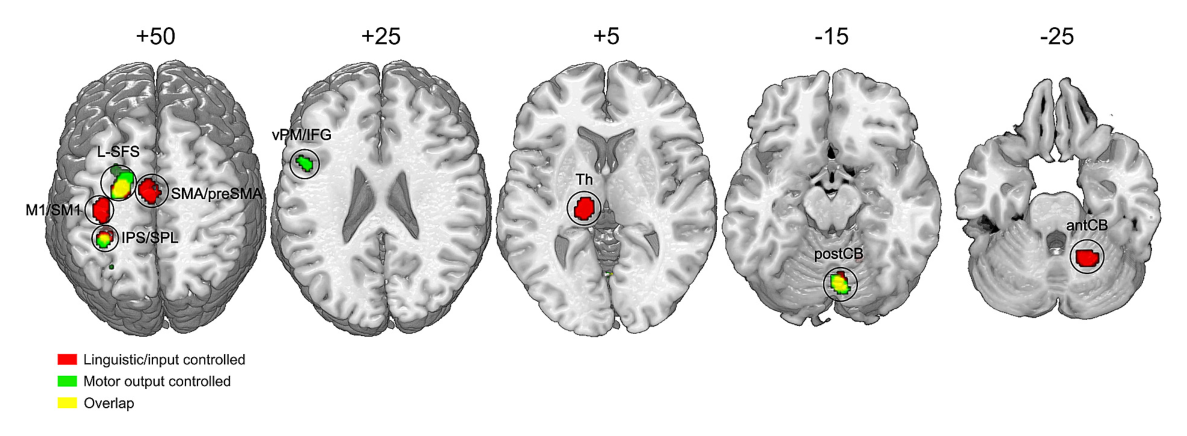
三个脑区经受住全部对照考验,被判定为"主要书写特异"。左 SFS/MFG 区、左 IPS/上顶区、右前小脑同时出现在两次二级分析中(Fig. 4 中红色与绿色重叠的黄色部分)。将相关分句替换为“其中左 SFS/MFG 峰值(MNI 坐标 −22, −8, 54)的 ALE 值为 38.0×10⁻³,是主分析中大脑皮层峰值的最高值,该区域也在两次二级分析中达到显著。原文讨论据此将其描述为活动最强、最可靠的区域,但‘全脑 ALE 值最高’的文字表述与 Table 2 不一致:右前小脑和左丘脑枕分别为 38.7×10⁻³ 和 38.4×10⁻³,均略高于该峰值”。,即传统所谓 Exner 区,作者倾向按 Roux 等人的叫法视作"字素/运动额区"(GMFA)——正字法抽象表征与运动命令生成之间的接口。
-
运动相关与语言相关脑区各有归属。将相关首句及解释替换为“M1/SM1、SMA 和左丘脑枕在语言/输入控制二级分析中达到显著,但在运动输出控制二级分析中未达显著收敛;左壳核仅在主分析中达到显著,两次二级分析均未出现显著峰值。作者据此并结合既有研究,将这些区域主要解释为与非特异运动过程有关(Tables 2、3a、3b;Fig. 4)”。,说明这些激活反映非特异的手部动作执行与运动通路(Fig. 4 中绿色缺失区);左腹侧前运动区/额下回(vPM/IFG,中心 −50, 6, 26,对应 Omura 等定位的音-字素转换区)与左后部下颞层(PITC,靠近视觉词形区 VWFA 所在的梭状回 BA37)在语言/输入控制分析中消失,说明它们承载的是与口头语言共享的输入或词汇过程,而非书写的独特通道。
-
一些此前被认为关键的脑区未能收敛。左缘上回(SMG,6 项研究报告)未达显著,作者归因于该区解剖变异性大;而角回(AG,词汇失写的经典病灶)在全部结果中没有一个峰值,作者引 Brownsett 与 Wise 的观点推测 AG 的功能可能与概念提取等更高层过程有关,在简单书写任务中未被充分调动。右额上区(R-SFS,中心 26, 0, 53)的持续出现则被留作待解问题:它可能是左侧书写区的镜像同源活动,也可能反映跨胼胝体抑制的副作用(fMRI 信号无法区分兴奋与抑制)。
图注解读
图 1 · 462 个焦点的"玻璃脑"总览
原文图注:Fig. 1 e Overview of the 462 foci used to conduct the main ALE analysis projected on a "glass brain" rendered template; from the left to the right: top, lateral left and back view.
数据集全景图:把进入主 ALE 分析的 462 个激活焦点投影到半透明脑模板上,从顶部、左侧与背面三个视角看。焦点以左半球额叶与顶叶最为密集,直观展示了"纳入数据的分布"而非分析结果本身。它支撑的是方法部分——462 焦点、36 对比、18 研究构成的主数据集。
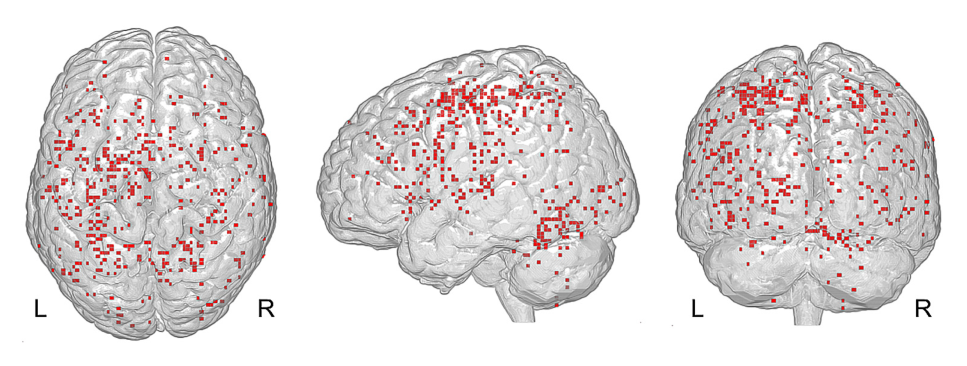
图 2 · 书写任务的认知流程示意
原文图注:Fig. 2 e Schematic representation of the different cognitive processes involved in handwritten tasks used in neuroimaging.
一张流程示意图,把书写任务拆为输入分析(视觉或听觉)→ 正字法提取 → 字素缓冲器 → 字形选择与运动执行等环节。结合正文可以读懂:不同对照任务各自"摘掉"流程中的某一环节,例如口头命名对照剥离语义与词汇输入,画圈对照剥离手部运动输出。这张图是全文分类逻辑的图解,对应"研究思路"一节。
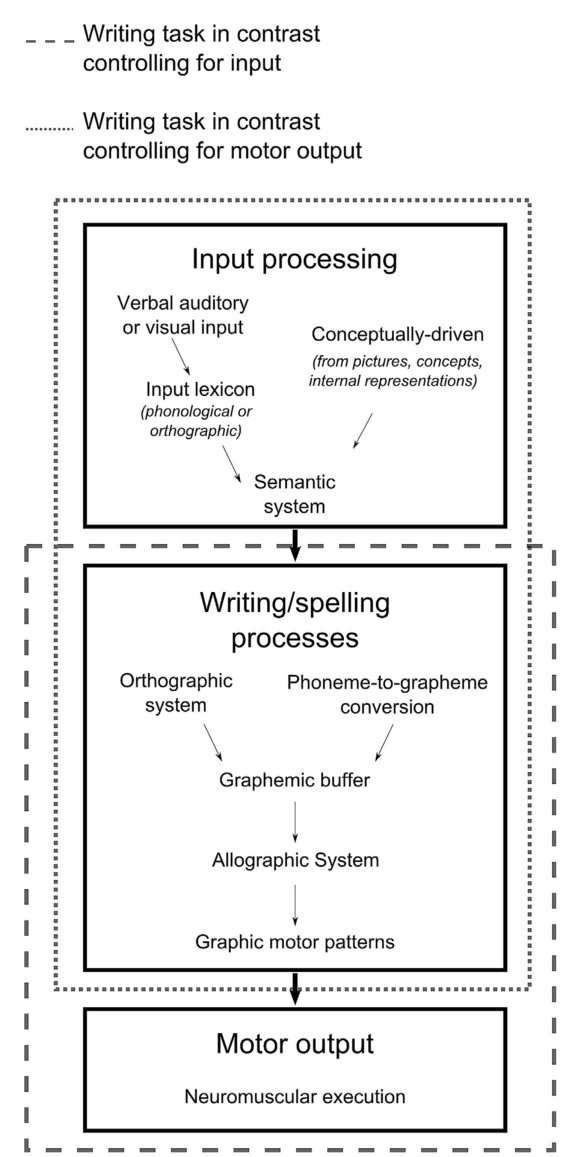
图 3 · 主 ALE 分析的 12 个功能区
原文图注:Fig. 3 e Results of the ALE meta-analysis conducted with all the contrasts cited in Table 1, projected on a standard rendered template. Areas of interest are numbered according to their rank in the meta-analysis results (cluster size and ALE value). 1. left frontal superior sulcus area (L-SFS); 2. primary motor/sensorimotor area (M1/SM1); 3. left superior parietal area (IPS; SPL); 4. SMA, pre-SMA; 5. antCB; 6. thalamus (Th); 7. left inferior frontal/premotor area (vPM; IFG); 8. postCB; 9. right superior frontal area (R-SFS, right SFS); 10. right IPL (R-IPL); 11. posterior inferior temporal cortex (PITC); 12. putamen (Put).
主分析结果的 3D 渲染图:12 个兴趣区按簇体积与 ALE 值排序编号(1 号即 ALE 值最高的左额上沟区)。图中可读出网络的空间全貌——左侧额顶链(1、2、3、7)加中线运动区(4)、皮层下结构(6、12)、双侧小脑(5、8)与腹侧颞区(11)。这是主要结果第 1 条的空间底图。
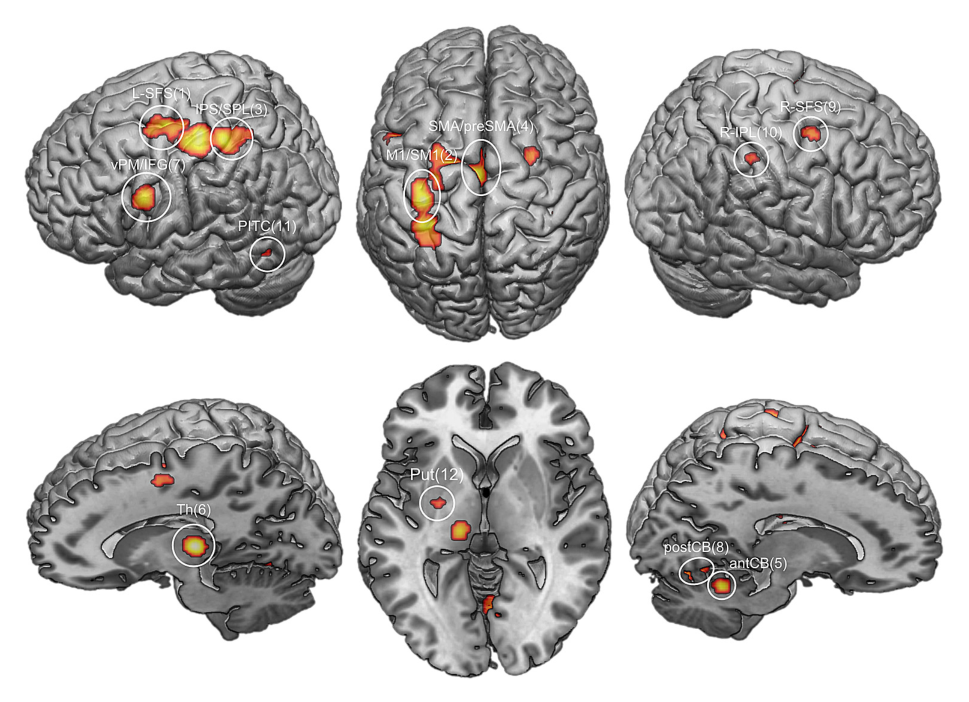
图 4 · 两套二级分析的红绿对照
原文图注:Fig. 4 e Selected axial slices illustrating the differences between ALE secondary analyses performed with contrasts having controlled for verbal or linguistic input (red) and motor output (green). Overlap is shown in yellow.
本文最关键的比较图:选定的轴位切片上合并展示两次二级 ALE 分析——红色为语言/输入控制的收敛区(7 个峰值区),绿色为运动输出控制的收敛区(5 个峰值区),黄色重叠即同时通过两类对照考验的区域,仅三处:左 SFS/MFG、左 IPS/上顶区、右前小脑。横向上还能读出方向性差异:红色独有的丘脑、M1/SM1、SMA 说明"控了输入"不等于"控了运动";绿色独有的右后小脑与腹侧前运动区则代表被运动对照解析出来的成分。全文核心结论"哪些区是书写特异的"主要依靠这张图支撑。
讨论
作者把结果组织成"书写特异"与"扩展网络"两部分:前者中,上顶区被解释为字形的选择、表征与序列产出之所,并借助 Segal 与 Petrides 的功能连接证据把它定位为运动区与语言区之间的高层接口;左额上区则从 Exner 原初的"字素加工所"重新定义为正字法表征到运动命令的转换接口,同时其敏感性(对词长敏感的发现来自 Rapp and Dufor, 2011)与字素缓冲器/正字法工作记忆的构想相容;小脑被坦率地标注为"数据尚不足以做特异/非特异的判定",右小脑灰质体积异常与阅读障碍(dyslexia)的关联被引作旁证而非定论。扩展网络中,M1/SM1、SMA、丘脑、壳核归于运动执行,vPM/IFG 与 Broca 区的重合及阅读/拼写共享激活提示其语言属性,PITC 则与 VWFA 对话,被赋予长期记忆中正字法词形提取的角色。
局限被逐一承认:纳入研究数量有限、各对比对照强度不一("运动控制"从手指敲击到真画圈跨度很大)、二级分析共享数据源导致比较需谨慎、眼动几乎从未被监控,额叶眼区(FEF,位于 −32, 3, 47)距书写中心(−22, −8, 54)仅约 16 mm,是潜伏的混淆源。与损伤文献的关系也被反复校对:AG 的缺席、SMG 的不收敛都被拿来与失写症病灶证据对照,作者呼吁未来设计出针对特定认知过程的控制任务,而不是继续依赖单一基准。
一句话总结
在我看来,这篇元分析最大的贡献不是给出"三个书写区"这个略显教条的清单,而是把"你的对照任务决定了你的书写网络"这一方法学真相摆上了台面——同一笔书写数据,配不同的对照就能洗出不同的脑区。读完最深的印象是:所谓"书写特异"其实是一个层层逼近的极限概念,黄色重叠区只是当前证据下的交集,未必是终点。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'md_section': '一句话定位', 'current_text': "这是第一篇把'书写字'(handwriting)的脑成像文献系统整合起来的元分析", 'problem': "原文明确承认 Purcell et al. (2011b) 是先前的元分析;本文的原创点在于聚焦真实书写产出(含字母表与语素文字)并按对照任务分层,而非'第一篇'。笔记后文其实也交代了 Purcell 的局限,故此处属轻度措辞夸大、且与自身背景节存在张力。", 'classification': 'OVERCLAIM (minor)', 'recommended_fix': "改为'第一篇以真实书写产出为核心、并按对照任务性质分层剥离书写特异过程的元分析'。"} -> 评注:
- 补充要点: 原文讨论指出左 SFS/MFG 存在两个峰,其中一个在语言/输入控制分析中消失,作者明确提示这可能是两个不同功能或仅为变异——笔记将左 SFS/MFG 作为单一稳健区域呈现,遗漏了原文自己保留的这一不确定性。
- 补充要点: 原文关于'右手书写时丘脑左偏、左手书写时右偏'(Sugihara et al., 2006)及 Sugihara 左手书写时双侧小脑激活的论证,是区分小脑运动/语言贡献的关键对照证据,笔记未提及。
- 补充要点: 原文强调两个二级分析共享'双重控制'的对比数据、直接比较需谨慎这一方法学警示,笔记方法部分已提及,但在解读红绿图差异(主要结果第3条与图4解读)时未再次提示该比较偏差。