这篇立场性综述对“腹侧颞叶皮层(VTC)的类别选择性组织仅是视觉物体识别系统产物”的传统假设提出质疑,提出这些区域锚定在导航、社会认知、工具使用与阅读等领域特异任务网络中。文章基于无视觉输入时的类别选择活动以及类别响应与视觉形状特征的解耦两类证据,探讨了类别选择区的计算目标与表征需求。
研究背景
腹侧颞叶的类别选择性通常被放在视觉物体识别框架中理解:从图像中提取特征,逐步形成对视角等变化具有容忍性的描述,再据此识别物体身份。面孔、身体、场景、工具和文字等类别的规律分布,使研究者进一步追问,这些区域是否源于类别共享的形状特征、不同的不变性计算要求,或方便下游系统读取信息的空间聚集。以物体标签为目标训练的深层网络能够在一定程度上对应腹侧通路的表征变化,又增强了这种解释的吸引力。但识别模型与脑表征相关,仍不能单独说明所有类别区的功能目标都只是为物体赋予身份标签。
这里存在一个容易被忽略的区别:看清某个对象是什么,与利用它完成导航、动作判断、工具使用或阅读,并不要求保留同样的信息。对身份无关的姿势变化,可能正是动作理解所需要的内容;对某些识别任务无关的空间布局,则可能决定导航。既往训练与任务操纵还显示,在图像相同或相近时,物体被如何使用、被要求判断什么,也会改变类别相关响应。先天失明者在听觉或触觉任务中呈现部分对应的类别组织,则进一步限制了纯视觉经验解释。这些证据不意味着视觉特征可以忽略,而是提出了尚未被识别中心框架充分回答的问题:类别区究竟为哪些行为目标服务,这些目标如何约束其表征和连接?
本文作为立场性综述,将形状与类别的解耦、工具学习、非视觉输入以及连接预测等证据放在一起,主张从更大的领域相关网络理解腹侧皮层组织。在这个视角下,类别区的形态分析服务于不同系统,区域间差别不仅是偏好图片不同,也可能是编码维度和读出需求不同。文章的回应主要是重新界定计算目标,并为任务驱动的建模和实验提供方向。不过,先天盲者的对应并非遍及所有区域,连接与选择性的关系也不能概括成单一因果方向;不同类别的形状控制和行为证据强度并不相同。因此,综述对单纯物体识别解释的挑战,不等于否定识别模型已有的解释力,也不意味着网络功能假说已经为每个区域给出了可定量验证的完整机制。
研究思路
文章梳理了针对“物体识别中心假说”的多重证据,并提出以领域特异任务网络为导向的解释框架: 1. 理论出发点:借用 Marr(1982)关于计算目标的观点,主张理解特定脑区的表征内容需首先明确其所在系统的功能目标。VTC 各区域的计算目标不应局限于通用的物体身份识别,而应从其所属的领域特异网络(如导航、工具操作、社会认知网络)的功能需求中推导。 2. 表征重构:作者将类别选择区视为各领域特异网络中的知觉接口:场景区表征与导航相关的空间布局(Epstein, 2008);身体区表征支持动作与社会判断的姿态构型(Downing & Peelen, 2011);面孔区表征用于个体识别的面部特征与结构(Freiwald 等, 2016);工具区表征与操作动作相关的形状特征(Beauchamp 等, 2002; Bracci & Peelen, 2013; Perini 等, 2014)。 3. 共享与特异:这些区域共享腹侧通路的稳健性与不变性计算机制(Taylor & Downing, 2011),但在编码维度和信息读出需求上高度特异,且部分表征不完全局限于视觉通道。
方法
作为理论综述,文章系统梳理并整合了四类实验证据: 1. 训练与任务操纵研究:考察被试在学习操作新异工具(Weisberg 等, 2007)或改变对同一物体的判断任务(如判断操作方式 vs 存放地点;Perini 等, 2014)时,左侧外侧枕颞皮层(LOTC)等工具选择区在视觉刺激保持不变条件下的响应调制。 2. 形状与类别解耦设计:采用控制视觉低级特征的配对刺激(如外形匹配但类别不同的刺激对),利用 fMRI 与 MEG 多变量解码检验类别选择性在剥离形状贡献后是否依然存在(Bracci & Op de Beeck, 2016; Proklova 等, 2016; Kaiser 等, 2016)。 3. 先天盲人跨模态研究:考察缺乏视觉经验的个体在听觉或触觉刺激下,VTC 各区域(如 PPA、EBA、VWFA 及工具区)是否呈现出与明眼人对应的类别选择性活动(Mahon 等, 2009; He 等, 2013; Peelen 等, 2013; Wolbers 等, 2011; Kitada 等, 2014; Striem-Amit 等, 2012)。 4. 连接组学与解剖约束研究:利用静息态功能连接与白质结构连接模式(连接指纹)预测 VTC 局部的类别偏好与功能发育定位(Osher 等, 2016; Saygin 等, 2011, 2016; Wang 等, 2015)。 这些证据旨在将低级视觉特征加工与更高层级的领域任务需求进行实验分离。
主要结果
-
类别选择反应可以与视觉特征加工解耦。同一批新异物体在动手训练前被动观看时不激活工具选择区,经训练作为工具使用后才激活左侧 LOTC 及顶叶、运动前区的工具使用网络(Weisberg 等, 2007;图 2a);在相同任务难度下,判断工具的动作类型(拧、捏)比判断物体常见位置更大程度激活 LOTC 反应(Perini 等, 2014);简单几何图形若被解读为社会主体(如几何图形互动动画),同样诱发右侧梭状回的类社会反应(Castelli 等, 2000; Martin & Weisberg, 2003)。采用形状匹配刺激对(如蛇与绳)的研究直接证实,扣除低级形状贡献后 VTC 的类别选择性依然显著(Proklova 等, 2016; Bracci & Op de Beeck, 2016;图 2b)。
-
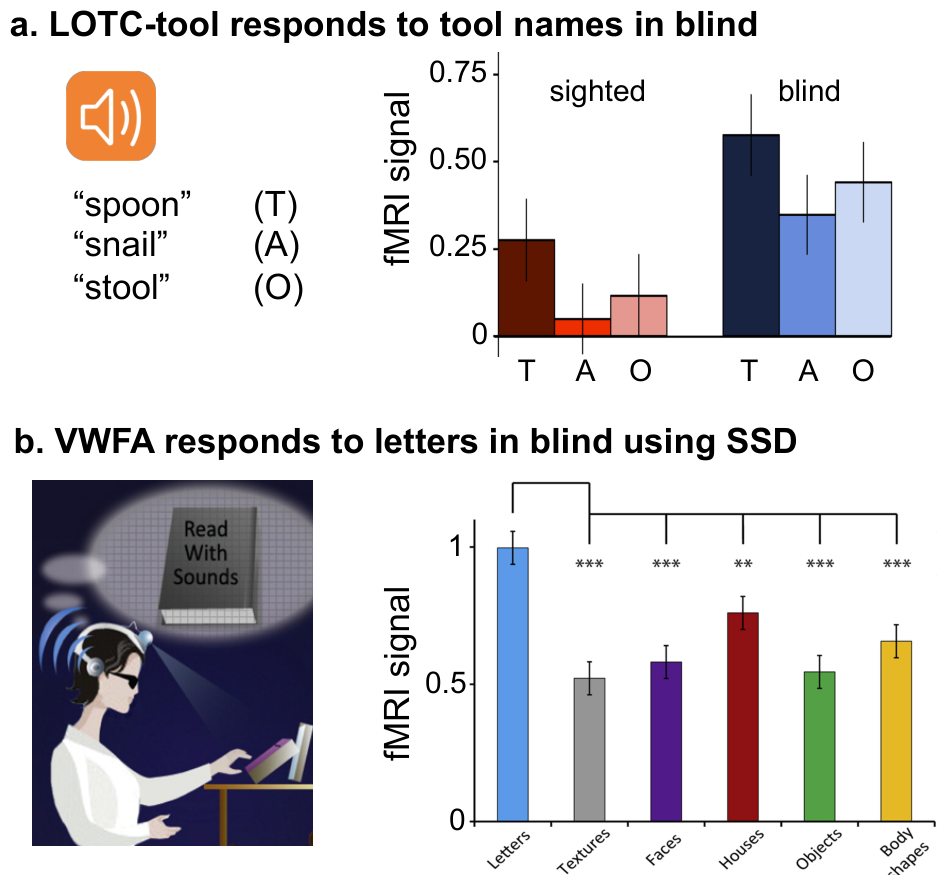
视觉输入与视觉经验并非多数类别选择反应的必要条件。先天盲人听取地标建筑物与工具词语时,VTC 出现与明眼人相似的选择性激活(He 等, 2013; Mahon 等, 2009; Peelen 等, 2013;图 3a);盲人通过触觉探索微缩场景激活 PPA(Wolbers 等, 2011),触觉感知身体激活 EBA(Kitada 等, 2014),使用盲文或感官替代装置(SSD,将图像转为声音)辨读文字激活 VWFA(Reich 等, 2011; Striem-Amit 等, 2012;图 3b)。
-
经验无关性存在区域与层级特异性。He 等(2013)在同一批盲人中发现 PPA 的地标选择性依然存在,而后部梭状回的动物选择性则缺失;Wang 等(2015)对比盲人与明眼人的功能与连接模式发现:工具、身体与场景选择区在两组间高度相似,而后部梭状回对动物的选择性则随视觉经验发生分化。这提示后部梭状回可能主要表征高度依赖视觉获取的属性,而其他区域编码了可跨模态获取的对象属性(如空间几何、姿态与抽象形状;Peelen 等, 2014)。盲人的选择性区域与明眼人保持相似的全脑连接模式,表明其保留了原有的功能网络拓扑结构,而非全皮层的泛化重组(Pascual-Leone & Hamilton, 2001)。
-
类别选择区与领域网络的连接结构先于并预测其选择性。VTC 类别区与其他皮层系统存在特异性连接(如朝向表征区、工具使用区、心理理论网络),且个体白质连接特征能够可靠预测类别选择性的解剖位置(Saygin 等, 2011, 2016; Osher 等, 2016),表明连接结构可能是皮层类别选择性功能发育的先导约束。
-
各类别服务于不同的计算目标与表征维度。数字与字母需要跨字体识别,空间导航主要依赖环境边界而对颜色纹理不敏感,身份识别要求对姿势变化保持不变性,而动作理解则依赖具体的姿态构型,工具表征则必须区分把手与效应器端。各类别区在编码维度与读出需求上具有根本差异,不宜将它们统一视作同质的视觉物体识别层级节点。
图注解读
图 1 · 视觉不止于物体识别:同一场景的四条加工路径
原文图注:Figure 1. Vision beyond object recognition. This figure illustrates several important functions that are supported by visual perception. These different functions (object recognition, object use, social cognition, navigation) each require a specific way of processing the contents of a scene. For example, perceiving objects with the goal to use these as tools ("object use") may require representing those objects in terms of their associated hand postures. In general, carrying out these diverse functions demands idiosyncratic representations of the kinds of visual stimuli that they typically involve. We argue that the need for these diverse kinds of representation -- that go beyond the need to encode object form in a view-, size- and location-invariant fashion -- offers an account of the presence and properties of numerous category-selective regions in the ventral temporal cortex.
图 1 阐述了综述的核心立论:以包含人物、家具和餐具的同一场景为例,说明不同行为任务对视觉信息提取的不同需求——物体识别需要视角、尺寸与位置不变的形状描述;工具使用依赖抓握方式与效应器关系;社会认知关注人物的姿势、动作与意图;空间导航则需要解析环境边界与几何布局。该示意图表明同一物体在不同任务中被赋予不同的表征维度,支撑了“多样的任务性表征需求驱动了腹侧颞叶类别选择性分布”的理论前提。
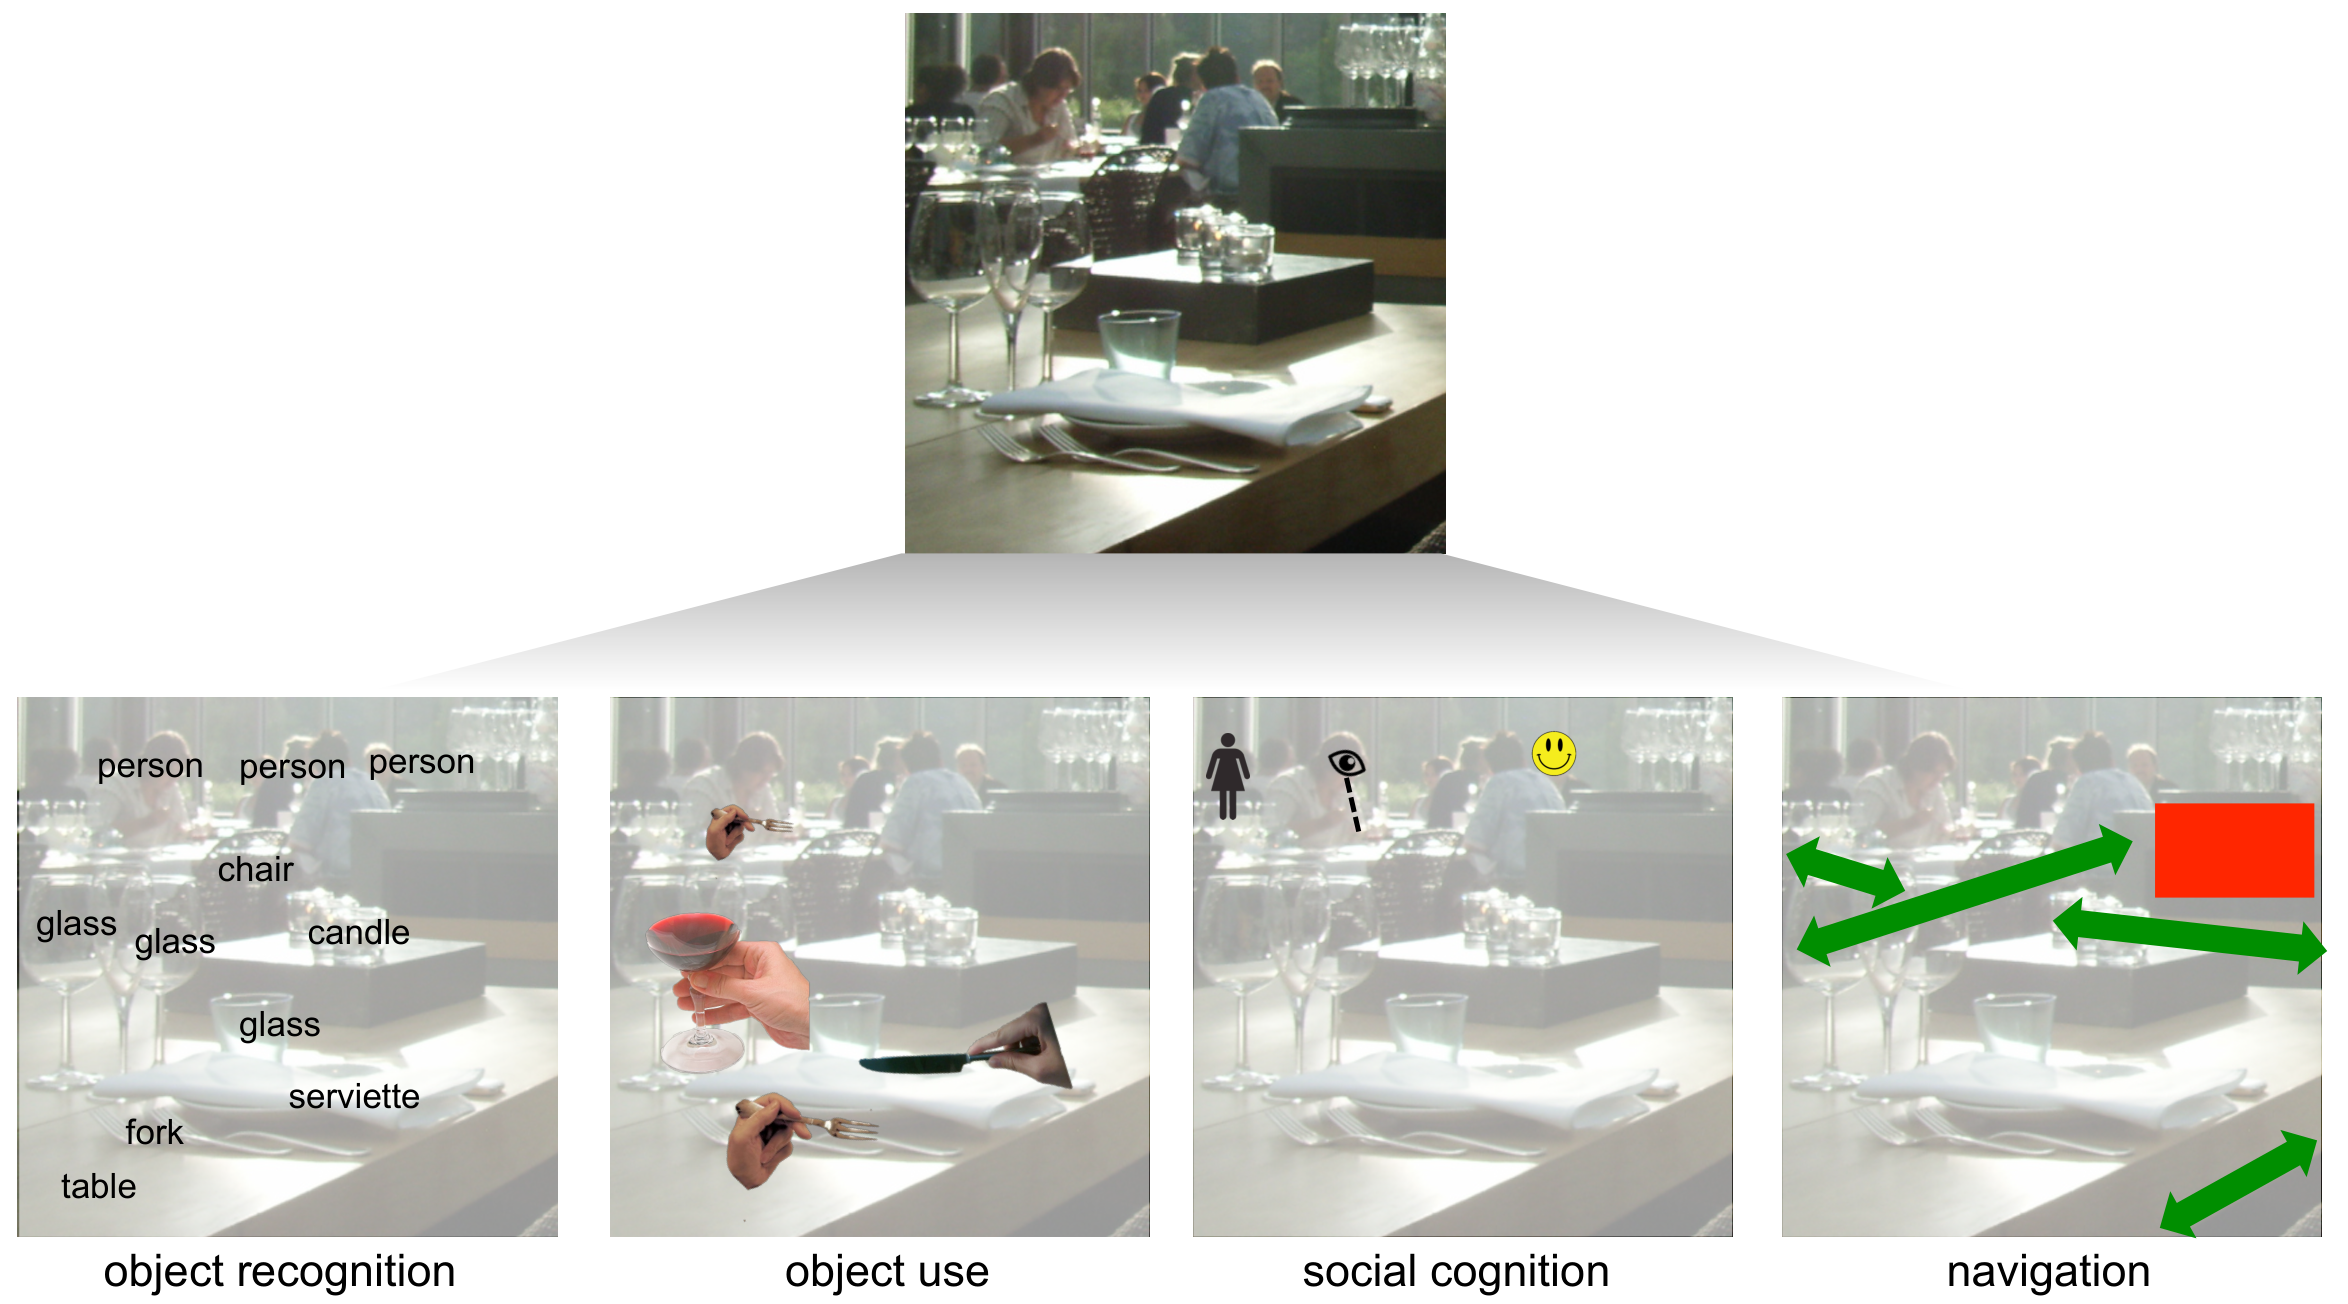
图 2 · 类别选择与视觉特征加工的两条解耦证据
原文图注:Figure 2. Category selectivity can be dissociated from visual feature processing. a. Response in tool-selective LOTC increased for objects that were perceived as tools after hands-on training to use these objects to perform tool-like tasks (Weisberg et al., 2007). T = Trained objects, NT = Not-trained objects. b. Selectivity for animals in ventral temporal cortex was preserved for visually matched object pairs, indicating that this selectivity is not fully driven by shape features (Proklova et al., 2016).
面板 a 展示 Weisberg 等(2007)的研究数据:纵轴为工具选择区 LOTC 的 fMRI 信号变化,显示训练前与训练后对目标物体(T,接受工具操作训练)与非目标物体(NT,未训练)的反应;结果呈现显著的训练与物体交互效应,即动手训练后 LOTC 对 T 物体的反应显著增强,而在被动观看下 T 与 NT 在视觉上并无差异,排除了即时任务操作的混淆。面板 b 根据 Proklova 等(2016)的研究展示视觉匹配刺激对下的类别响应:在严格控制低级视觉形状特征后,偏好类别的反应依然显著高于非偏好类别。两面板共同支撑结果 1,证实类别选择性可与纯粹的视觉特征加工相解耦。
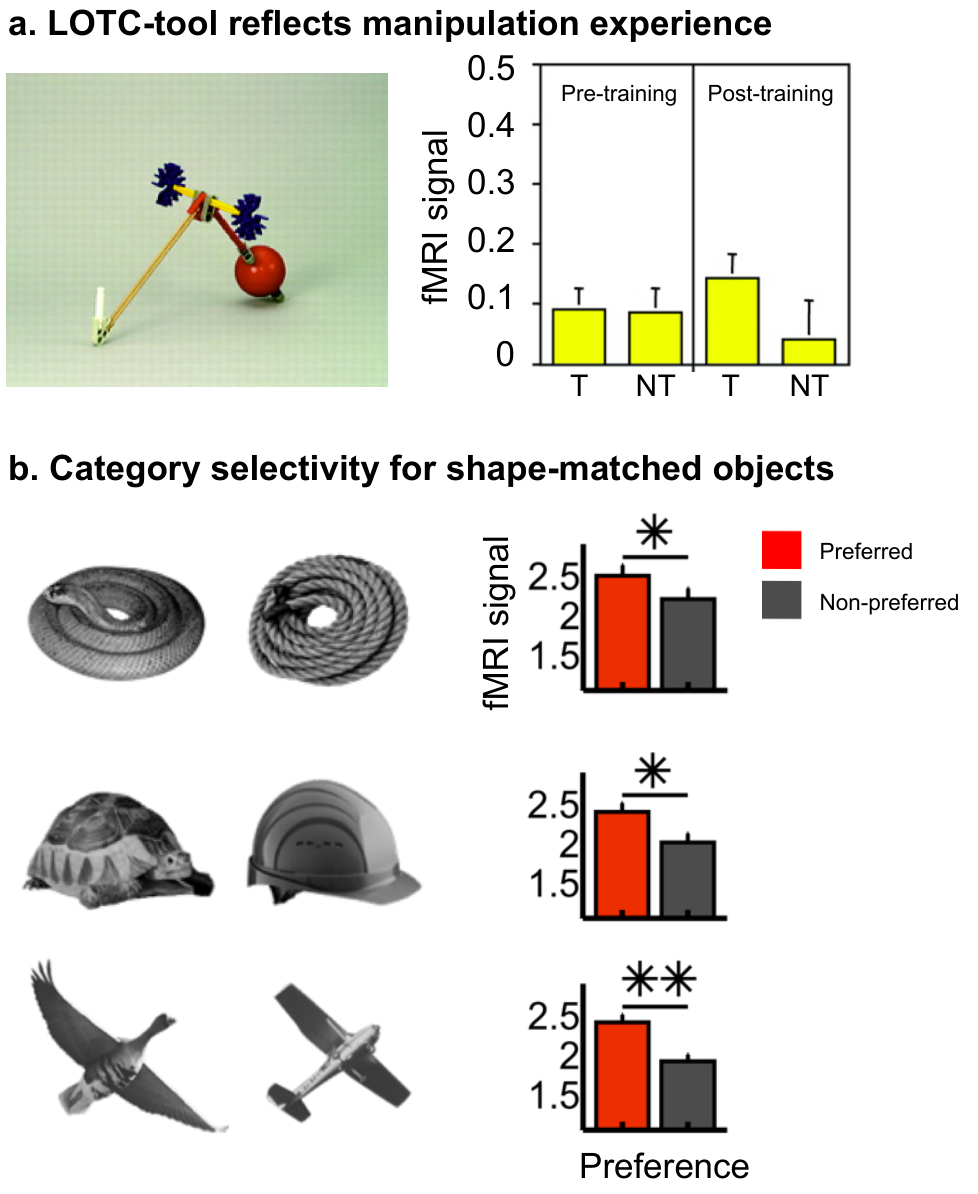
图 3 · 先天盲人的类别选择活动
原文图注:Figure 3. Category-selective activity in congenitally blind individuals. a. Tool-selective LOTC-tool (defined in sighted participants using a standard visual localizer) responds more strongly to aurally presented names of tools (T) than to names of animals (A) and objects (O) (Peelen et al., 2013). b. Letter-selective VWFA (defined in sighted participants using a standard visual localizer) responds selectively when blind participants read letters using a sensory-substitution device that converts images to soundscapes (Striem-Amit et al., 2012).
面板 a 为盲人听觉词实验结果(Peelen 等, 2013):在以明眼人视觉定位器定义的 LOTC 工具选择区中,对比盲人与明眼人听取工具名称(T)、动物名称(A)及一般无生命物体名称(O)时的反应;结果显示两组均表现出显著的 T > A/O 偏好模式,且盲人组的反应强度与明眼人相当,表明缺乏视觉经验的个体在听觉条件下依然具有工具类别选择性。面板 b 为感官替代装置(SSD)实验结果(Striem-Amit 等, 2012):盲人被试利用将视觉图像转译为声音景观的装置辨读字母时,以视觉定位器定义的文字选择区(VWFA)对字母声音呈现出特异性响应。两项研究共同支撑结果 2,表明自下而上的视觉输入并非类别选择性皮层反应的必要前提。
讨论
讨论部分聚焦于高级视觉皮层研究视角的转变:如果各类别选择区的表征格式高度特化(导航表征几何布局,社会认知表征表情与动作姿态,阅读表征字形与正字法),则将所有区域均归入“视角不变的物体身份识别”框架可能忽略了表征维度的特异性,并对计算建模产生局限。例如,单纯以物体分类为目标训练的深层神经网络,即便在表征相似性上与腹侧通路产生一定相关,其内部特征表征也未见得反映各功能区的实际计算维度。作者结合 Marr 的计算目标层次理论,提出应根据不同领域网络的实际行为目标进行计算建模,例如训练面向导航、阅读或社会交互的网络结构。
该综述的局限与待解决问题主要表现在:第一,目前的形状-类别解耦证据主要集中于工具与动物类别,面孔、字词及数字等其他类别的严格形状控制解耦仍需进一步验证;第二,先天盲人研究虽证实自下而上的视觉输入并非充要条件,但非视觉通道表征的具体形式(是由于失明诱发的皮层功能重构,还是存在先天的多模态/非模态表征架构)尚无定论;第三,文章对物体识别框架内的其他计算模型(如基于变换不变性流形展开的理论)尚未展开逐一的形式化对比检验。该文整合了 Mahon 与 Caramazza(2011)的领域特异性知识假说、Martin(2007)的分布式语义网络模型以及 Price 与 Devlin(2011)的交互式阅读假说,系统阐述了任务网络驱动的高级视觉皮层组织观。
一句话总结
文章通过整合跨模态与形状解耦证据,指出腹侧颞叶的类别选择性皮层并非单纯服务于通用的视觉物体识别,而是作为外周知觉接口嵌入在导航、工具使用、社会认知等领域特异的任务网络之中。