一句话定位:本研究未局限于“命名正确率总分”,而是将原发性进行性失语(PPA)患者在波士顿命名测验中的具体错误类型(漏答、语义错误、上位错误、迂回说法)与脑萎缩模式关联。采用多变量分析发现,语义错误主要对应左梭状回中后部与左后中/下颞回萎缩,而漏答对应双侧内侧前颞叶萎缩,两者在解剖通路上呈现明确分离,且语义错误的神经关联在各 PPA 亚型间具有共享性。
研究背景
原发性进行性失语患者的命名障碍涉及视觉物体识别、语义概念通达、词汇提取及言语产出等多个处理环节。仅依据命名正确率难以厘清具体的受损环节。前颞叶(ATL)作为语义枢纽的研究多集中于语义变体(SV),但其他 PPA 亚型同样普遍存在命名障碍。对错误类型进行细分,有助于揭示不同的解剖损伤通路:漏答反映词汇或概念无法提取,语义错误反映概念或视觉-语义整合异常,迂回说法、上位错误及发音错误则对应其他认知加工瓶颈。细分错误类型能提供比总分更为具体的定位信息。
现有研究仍存在两项待解决的方法学问题:其一,语义错误的神经解剖关联是语义变体特有,还是跨所有 PPA 亚型普遍存在,尚缺乏直接横向比较;其二,传统的逐体素单变量分析在样本量有限时检验效能较低,且病灶的范围与空间模式同样关键。多变量方法能够将数据驱动的解剖区域作为整体进行检验,并利用独立测试集进行泛化验证,有助于降低仅拟合个别患者或特定亚型的过拟合风险。
Bruffaerts 等在 43 名不同亚型的 PPA 患者中应用稀疏典型相关分析(SCCAN),将漏答、语义错误、上位错误及迂回说法与脑萎缩图谱进行关联,并以基于体素的形态学测量(VBM)作为对照。研究旨在探讨:语义错误与漏答是否存在可分离的解剖学基础,以及这些关联是否跨亚型成立。结果显示,语义错误主要对应左梭状回中后部与左后 MTG/ITG 萎缩,漏答对应双侧内侧前颞叶及右角回萎缩,两条通路在空间上未见重叠。该研究表明错误类型比正确率总分具有更具体的病理定位价值,但样本量依然有限,其他错误类型的统计效能以及健康对照组的天花板效应也构成了证据边界。
研究思路
研究总体采取“行为细分 + 多变量影像”的技术路线。命名的失败可源于视觉感知、语义理解、词汇调取或动作执行等任一环节,各环节受损会表现为不同的错误形式(如将犀牛命名为河马属于语义错误,回答“不知道”属于漏答)。将错误类型作为行为指标、萎缩图谱作为影像指标开展关联分析,比总分更有助于解析认知机制。研究选用 60 项版本的波士顿命名测验(BNT),该量表具备常模并便于跨被试标准化评估。
在影像分析方法上,为避免逐体素单变量检验的多重比较校正惩罚,研究采用稀疏典型相关分析(SCCAN):首先在训练集上以数据驱动方式确定一个使脑萎缩图谱与错误百分比相关性最大化的稀疏特征向量(对数据界定的区域实施加权平均),随后将该特征向量直接迁移至独立的测试集以检验预测表现。解剖区域范围完全由数据驱动确定而非依赖先验 ROI 假设,契合了“病灶范围影响命名能力”的临床病理规律。同时,研究并行开展常规体素形态学测量(VBM)单变量分析作为对照验证。
方法
研究纳入 43 名符合国际共识诊断标准的 PPA 患者(语义变体 SV 13 例、非流利变体 NFV 11 例、混合变体 MV 10 例、少词变体 LV 9 例),以及 24 名在年龄、性别和教育程度上匹配的健康对照,于 2010 至 2019 年间在鲁汶大学医院完成招募。患者完成 60 项 BNT 测验并进行录音,43 人中有 36 人(83.7%)完成全部测试条目,其余 7 人完成 15–49 项;当患者提出终止或连续 8 个试次无反应时测试中止。录音记录依据既有标准对错误类型进行分类:漏答、语义错误(如犀牛误称为“河马”)、上位错误(如仙人掌误称为“植物”)、迂回说法(如衣架表述为“用来挂衣服的工具”)等;同时记录新语症、语音错误、言语产出错误、视觉错误与无关错误。每个试次仅记录首次反应,自我纠错不计入正确。行为学分析采用错误百分比(错误频次除以实际完成试次总数)以平衡测试条目数量差异,并评估词频(SUBTLEX-NL)、习得年龄及词长等心理语言学变量的影响。配套评估包含 MMSE、PALPA 词-图匹配与复述、伯明翰物体认知成套测验、联想语义测试及动物言语流畅性等。
所有被试均采集高分辨率 T1 加权结构相(29 名患者及全体对照在 3T Philips Intera 扫描仪完成,14 名患者在 3T Philips Achieva 扫描仪完成,采用相同 3D TFE 序列),使用 CAT12 工具箱完成分割,经由 DARTEL 算法配准至 MNI 空间,重采样体素尺寸为 1.5 mm,采用 8 mm 全宽半高高斯核平滑。SCCAN 分析中,43 名患者被随机划分为训练集(n=22)与测试集(n=21),24 名健康对照作为第二测试集;全脑灰质掩膜包含 272,705 个体素,设定最小聚类阈值为 200 体素;对四类主要错误分别在 0.001 至 0.1 范围内网格搜索稀疏度参数,选取训练集内相关性最高者;所得权重向量应用于测试集计算预测得分,并与实际错误率进行单尾 Pearson 相关检验(显著性水平设为 p<0.05)。年龄、扫描仪型号及颅内总体积(TIV)作为协变量纳入所有统计模型。随后通过单因素方差分析及双样本 t 检验对比各亚型在特征区域内的灰质体积。单变量 VBM 设定体素水平未校正 p<0.001,聚类水平经 FWE 校正 p<0.05。
主要结果
-
行为学特征:命名总分组间无统计学显著差异,但错误类型呈现亚型特异性分布(图 1)。准确率以 LV 组最高(69.3%,SD 18.1%),其后依次为 NFV(63.0%)、MV(56.2%),SV 组最低(47.4%,SD 17.2%),组间差异未达显著水平(F(3,39)=2.34, p=0.089)。漏答(F(3,39)=2.95, p=0.044)、迂回说法(F=4.56, p=0.008)及上位错误(F=3.17, p=0.035)在 SV 组中显著多于 LV、NFV 与 MV 组;言语产出错误在 NFV 组显著多于 SV 组(F=4.14, p=0.012)。关键发现是,语义错误在各亚型间无显著差异(F=1.27, p=0.298),四个亚型均有发生。病程与准确率呈负相关(r=-0.455, p=0.002),与漏答百分比呈正相关(r=0.432, p=0.004)。词频与习得年龄在所有亚型中均能预测命名表现,而词长效应存在于 LV、NFV 和 MV 组,在 SV 组中缺失。
-
SCCAN 多变量分析:语义错误对应左梭状回中后部与左后 MTG/ITG 萎缩(图 2A–C,图 3A、C、E)。语义错误百分比与左梭状回中后部灰质萎缩显著相关(主要累及 BA20),同时涉及左后中/下颞回(主要为 BA37)、枕中回与顶枕裂、左额中回及双侧前扣带皮层(稀疏度 0.041,占全脑灰质体素的 4.1%,共 11,181 体素)。该相关性在训练集与 PPA 测试集中均得到验证,所有亚型均对该相关性有贡献;各亚型在该特征区域内的萎缩程度未见组间差异(F(3,39)=0.14, p=0.935),且每个亚型均显著低于健康对照组;健康老年对照组内未观察到上述相关。
-
SCCAN 多变量分析:漏答对应双侧内侧前颞叶及右侧角回萎缩,与语义错误通路呈解剖分离(图 2D–F,图 3B、D、F)。漏答百分比与双侧内侧 ATL 萎缩显著相关(延伸至嗅周皮层及海马旁回,主要位于 BA36/BA30),并包含右侧角回(稀疏度 0.021,共 5,727 体素)。该区域的灰质萎缩存在亚型差异(F(3,39)=7.55, p<0.001),事后检验显示 SV 组萎缩程度重于 LV 组;SV 组与 MV 组灰质体积显著低于健康对照。两类错误在解剖结构上无重叠。针对迂回说法与上位错误,SCCAN 未检出显著的神经解剖关联;排除完成率不足 60% 的被试后,语义错误的结果保持稳定,漏答在测试集中的相关性趋弱(p=0.09)。
-
单变量 VBM 分析验证了漏答的解剖定位,并提示上位错误与左侧颞上回相关(图 4、图 5)。VBM 显示漏答与左侧内侧 ATL(MNI -23,-33,-14,kE=6429,Z=4.30,聚类水平 PFWE-corr<0.001)及右侧内侧 ATL(MNI 21,-12,-36,kE=1222,Z=4.05,PFWE-corr=0.022)萎缩显著相关,与多变量分析一致;上位错误与左侧颞上回背侧及内侧部分(紧邻脑岛,MNI -44,-11,-12,kE=1125,Z=3.86,PFWE-corr=0.029,BA48)萎缩相关,但该相关高度受 2 名上位错误发生率极高的 SV 患者影响,剔除后相关性减弱(r=0.325, p=0.038)。VBM 在校正阈值下未检出与语义错误及迂回说法显著相关的脑区(图 5 中健康对照组亦无显著相关)。
-
放宽阈值下的 VBM 与 SCCAN 结果相互印证(图 6)。当将语义错误的 VBM 阈值放宽至体素水平未校正 p<0.05(聚类阈值 200 体素)时,所呈现的解剖区域与 SCCAN 特征向量分布高度吻合(主要累及左梭状回中后部及左后 MTG/ITG),并额外包含部分右侧同源皮层。这表明两类分析方法在解剖定位上具有一致性,单变量检验在严格多重比较校正下检出效能有限。
图注解读
图 1 · 各 PPA 亚型的错误分布
原文图注:Fig. 1. Errors across PPA variants. (A) Absolute number of errors per error type. (B) Percent errors per error type. Boxplot shows median and interquartile range. *Between-subtype difference using a post hoc Tukey-Kramer pairwise comparison (p < 0.05). Abbreviations: HC, healthy control; LV, logopenic variant; NFV, nonfluent variant; PPA, primary progressive aphasia; SV, semantic variant.
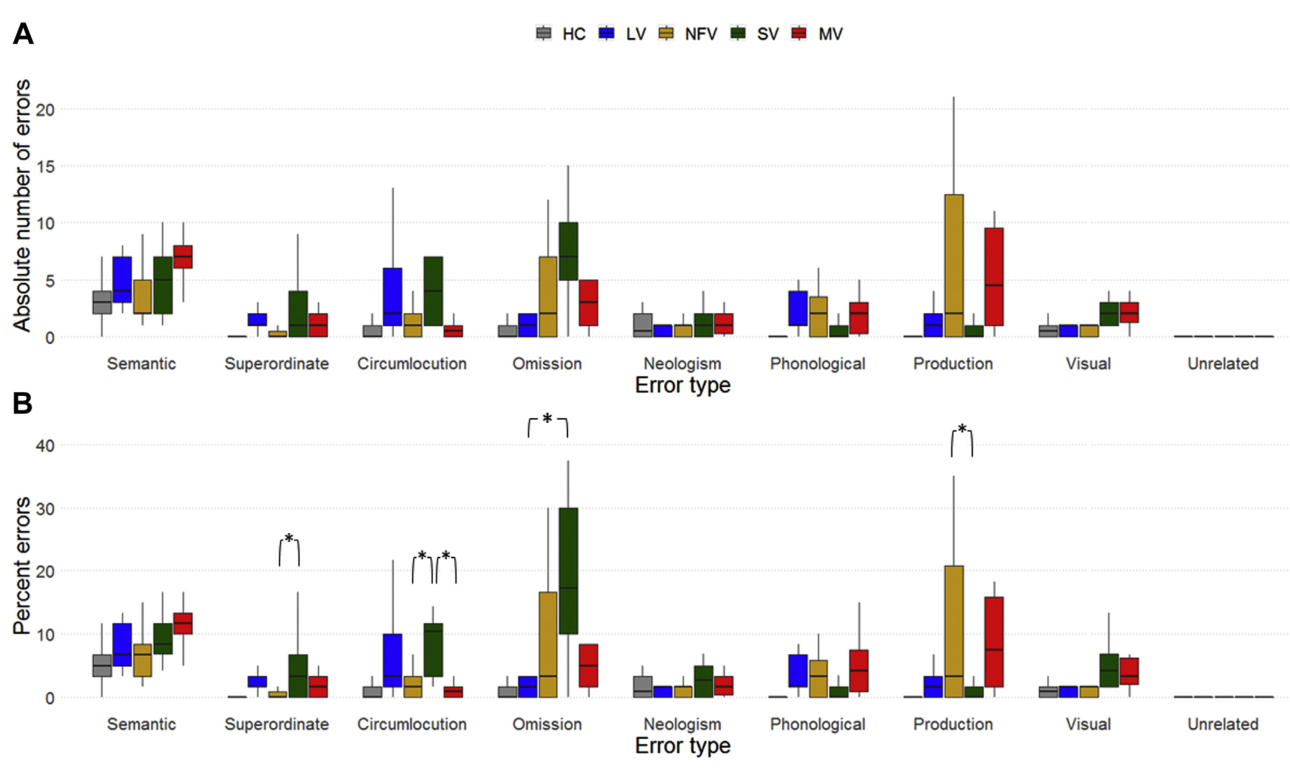
读图说明:横坐标表示错误分类与受试分组,纵坐标分别表示错误的绝对发生频次(A)或错误百分比(B),箱线图呈现中位数与四分位距,星号标示 Tukey-Kramer 事后检验具有统计学显著性的亚型间差异(p<0.05)。图表展示了后续神经影像分析的行为学表型:漏答、迂回说法和上位错误主要集中在 SV 组,言语产出错误主要出现在 NFV 组,而语义错误在各亚型间的发生水平相当。语义错误在亚型间的无差异分布为结果第 2 条提供了行为学依据。无关错误因仅在一名晚期患者中出现 2 例而被剔除出后续统计。
图 2 · SCCAN 特征向量:语义错误与漏答的萎缩图谱
原文图注:Fig. 2. Eigenvectors determined in the training data set for semantic errors and omissions. (A and D) Axial slices at selected MNI z-coordinates. (B and E) Renderings are partly translucent to visualize medial regions. The color bar displays the normalized vector weights. (C and F) Boxplot of average gray matter volume, corrected for TIV, scanner type, and age, in the region defined by the eigenvector. *Indicating gray matter volume in the PPA subtype group is lower compared to the control group (p < 0.05).……
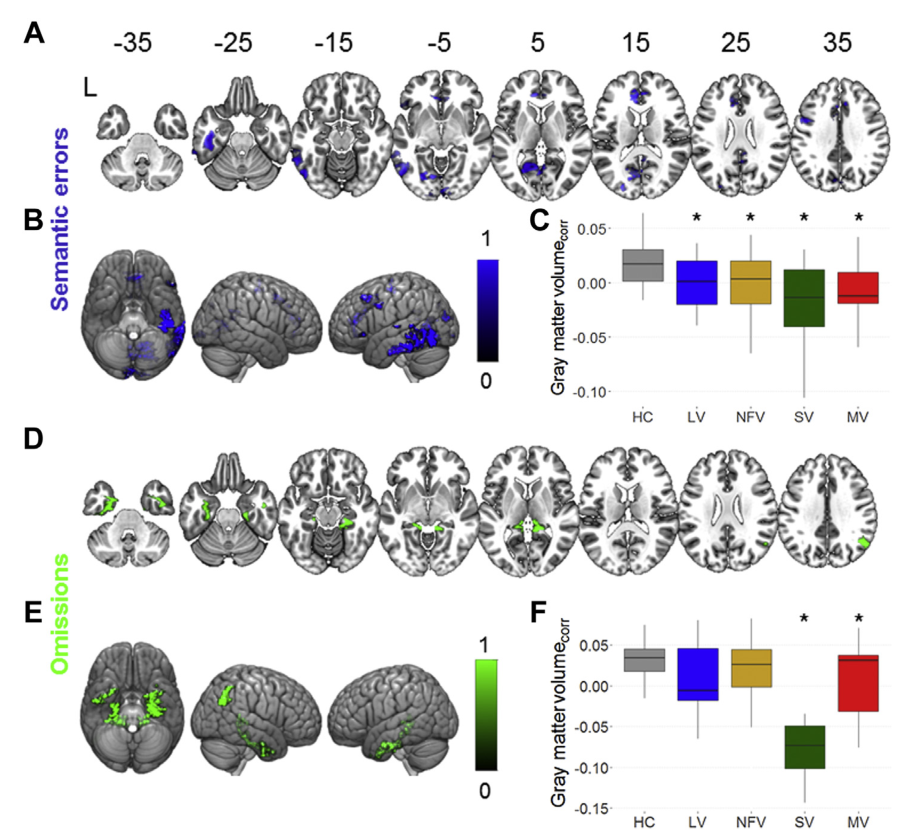
读图说明:A–C 对应语义错误,D–F 对应漏答。A 与 D 展示选定 MNI z 坐标的轴位解剖截面,B 与 E 为半透明三维脑表面渲染图(以展示内侧深部脑结构),色条代表归一化后的特征向量权重,亮度反映该体素对行为变量的相对贡献权重。C 与 F 呈现特征向量限定区域内的校正平均灰质体积(控制 TIV、扫描仪型号及年龄)在各亚型中的箱线图:在语义错误网络(C)中,四个 PPA 亚型的灰质体积均显著低于健康对照,且亚型间无统计学差异;在漏答网络(F)中,仅 SV 组与 MV 组显著低于对照组。该图直观反映了两类错误解剖通路的解离:语义错误主要累及左侧外侧枕颞皮层,漏答主要累及双侧内侧前颞叶及右角回。
图 3 · 训练集与测试集的预测相关
原文图注:Fig. 3. Correlation between percentage error scores and the predicted scores based on cortical atrophy (Fig. 2) in the training PPA data set (A and B), test PPA data set (C and D), and test elderly control data set (E and F) for semantic errors (A, C, and E) and omissions (B, D, and F).……
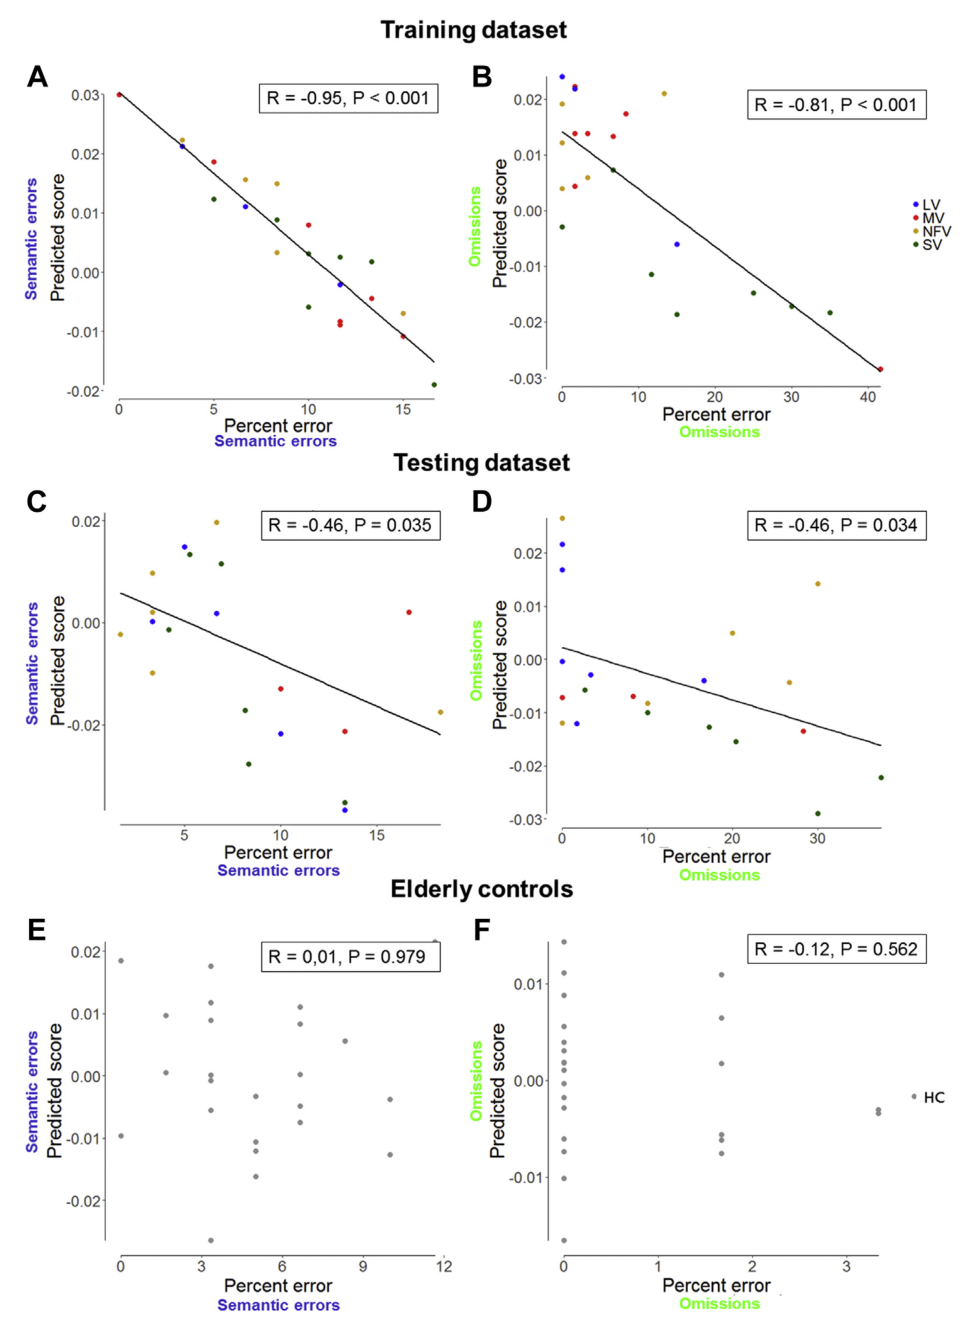
读图说明:该图包含六幅散点分布图,横坐标表示利用特征向量从灰质图谱计算得出的预测评分,纵坐标为实际错误百分比,散点样式按疾病亚型区分。A 与 C(语义错误)在训练集和独立 PPA 测试集中均呈现显著正相关,且各亚型数据点分布均匀,表明相关性并非由单一亚型驱动;B 与 D(漏答)同样存在显著相关,其中 SV 亚型分布更为离散;E 与 F 显示在健康老年对照组中不存在上述相关性。该图验证了 SCCAN 模型的泛化能力:特征向量在未经训练的独立数据上仍能稳定预测错误发生率,而对照组无相关性排除了正常生理性老化的干扰。
图 4 · VBM 定位漏答与上位错误
原文图注:Fig. 4. VBM at a threshold of voxel-level uncorrected p < 0.001 and cluster-level FWE-corrected p < 0.05 (Poline et al., 1997) for omissions and superordinate errors. (A and D) Axial slices at selected MNI z-coordinates. (B and E) Renderings. Color bars display t-scores. (C and F) Boxplot of average gray matter volume, corrected for scanner type, TIV, and age, in the regions defined by the VBM analysis. *Indicating gray matter volume in the PPA subtype group is lower compared to the control group (p < 0.05).……
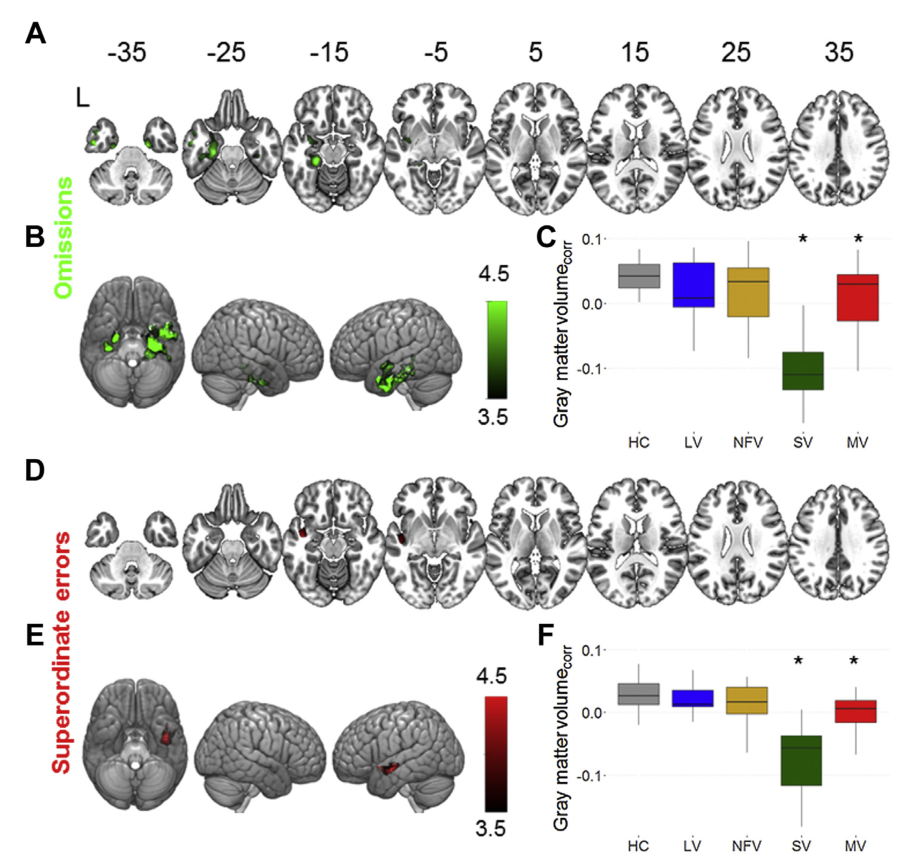
读图说明:该图展示了与图 2 对应的单变量 VBM 分析结果,色条表示统计 t 分数。A–C 对应漏答:显著萎缩聚类位于左侧与右侧内侧前颞叶(Z 峰值分别为 4.30 与 4.05),箱线图 C 显示 SV 组萎缩明显重于 LV 组。D–F 对应上位错误:唯一显著聚类位于左侧颞上回背内侧区(邻近脑岛,Z=3.86),箱线图 F 同样显示 SV 组萎缩较为突出。该图支撑了结果第 4 条:多变量检测到的漏答脑区在严格单变量统计中得以复现,而上位错误仅在单变量分析中检出,且该效应受极个别高上位错误率的 SV 患者影响较大。
图 5 · VBM 区域内的行为相关
原文图注:Fig. 5. Correlation between percentage error scores and mean gray matter volume in the regions of interest calculated from VBM (Fig. 4) for omissions (A and C) and superordinate errors (B and D) in PPA (A and B) and healthy elderly controls (C and D).……
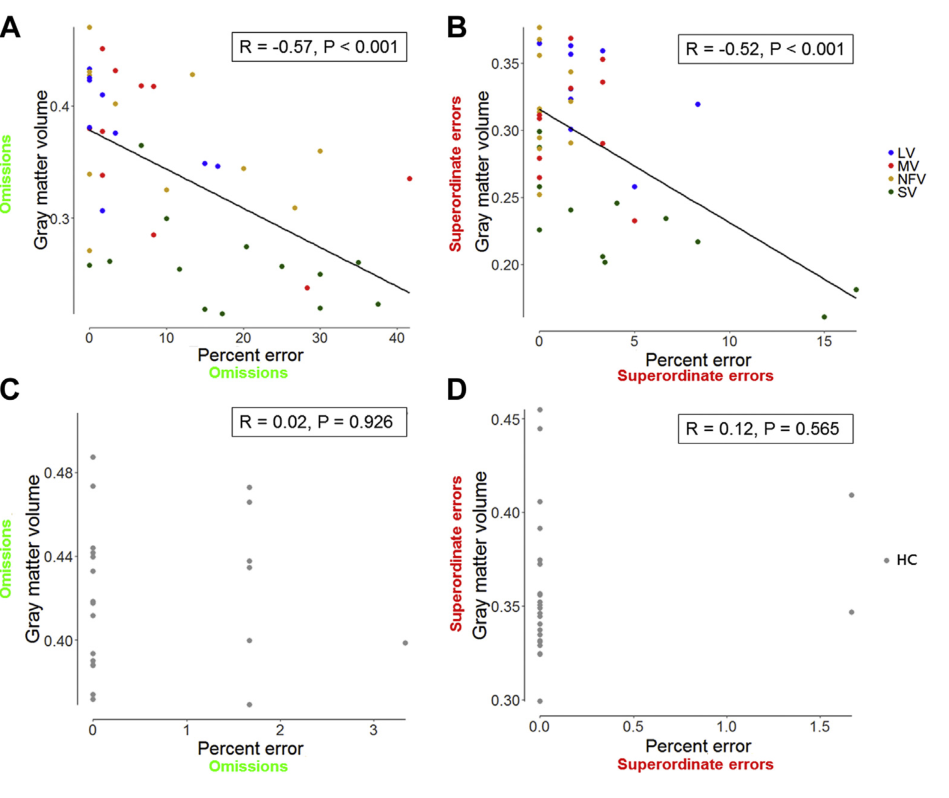
读图说明:该散点图展示 VBM 检出区域内的平均灰质体积(横坐标)与对应错误百分比(纵坐标)的相关性。A 与 B 为 PPA 患者组,C 与 D 为健康对照组。患者组内呈现负相关(局部灰质萎缩程度越高,错误发生率越高),其中上位错误的相关性在排除 2 名高错误率 SV 患者后有所减弱(r=0.325, p=0.038);对照组未出现统计学相关。该图补充了单变量分析在解释行为变异方面的定量关联。
图 6 · 语义错误 VBM 的放宽阈值对照
原文图注:Fig. 6. VBM for semantic errors at a threshold of voxel-level uncorrected p < 0.05 for comparison to Fig. 2B. Color bar displays t-scores. Abbreviation: VBM, voxel-based morphometry.
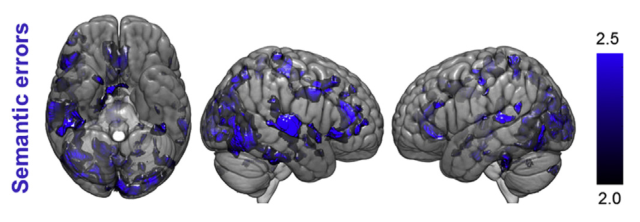
读图说明:该图为单变量 VBM 脑表面渲染图,色条表示 t 分数。统计阈值放宽至体素水平未校正 p<0.05(聚类阈值 200 体素),用于同图 2B 的 SCCAN 语义错误特征图谱进行空间对比。在放宽阈值后,单变量分析呈现的脑区(左梭状回中后部、左后 MTG/ITG 及部分右侧同源区)与 SCCAN 特征向量分布高度重合。该对比表明,语义错误在严格多重比较下未能在单变量分析中检出,主要源于单变量模型在中等样本量下的统计效能限制,而多变量模型具有更高的检测灵敏度。
讨论
作者从认知与解剖机制两个层面展开讨论。在语义错误的神经机制方面:左后中/下颞回(MTG/ITG)被认为是跨模态概念表征的重要候选脑区(Devereux 等;Fairhall 和 Caramazza),脑卒中、癫痫及功能磁共振研究亦证实该脑区参与词汇提取;左梭状回中后部则在视觉客体表征中起关键作用——在命名任务中负责表征视觉与语义特征,且中梭状回电刺激仅特异性干扰语义通达而不影响复述功能(Forseth 等)。语义错误可由命名通路中任一环节受损所致,即使概念表征本身完好,视觉向语义的通达障碍同样会引发语义替换错误。该研究表明 ATL 以外的皮层萎缩(左梭状回、左后 MTG/ITG)与语义错误密切相关,且该关联在各 PPA 亚型中普遍成立,亚型间萎缩程度无显著差异,这支持了部分介导语义错误的神经机制跨 PPA 疾病谱共享的观点(与 Grossman 2004、Ding 2016 及 Mummery 1999 的研究相符)。在漏答机制方面:双侧内侧前颞叶(含嗅周皮层)的萎缩与漏答直接相关,符合 ATL 作为语义中枢的理论框架,右侧 ATL 参与视觉客体识别,且右角回与 ATL 在静息态功能连接上同属一个大尺度脑网络。作者指出研究的局限性包括:健康老年对照组未呈现相关性,可能与行为表现的天花板效应有关;正常老化引起的枕颞皮层活性减弱及找词困难可能依赖于其他解剖通路(如脑岛);43 名患者的样本规模限制了对迂回说法与上位错误的检出效能;测试仅计入首次反应可能在一定程度上高估错误率;语言学参数与错误类型的交互作用在不同亚型中是否存在特异性差异,仍需依托更大规模的多中心队列加以深入研究。
一句话总结
本研究通过对命名错误类型进行细分,揭示了原发性进行性失语中不同解剖通路的受损模式:漏答主要关联于双侧内侧前颞叶语义枢纽的萎缩,而语义错误主要关联于左侧梭状回中后部及后中/下颞回等视觉-语义整合通路的萎缩,且语义错误对应的解剖通路在各 PPA 亚型间具有共享性。这一发现表明错误类型分析比单一的正确率评分具有更精细的神经病理定位价值。