这是一篇"假设与理论"类的计算神经科学文章,由 UC Berkeley 的整合生物学作者与普林斯顿的电气工程学者(信息论名家 H. Vincent Poor)合作提出。作者主张:下颞叶皮层(IT,inferior temporal cortex)在物体识别中做的事情不像神经网络,而更像通信系统里的"解码器"——用维特比算法(Viterbi algorithm)做动态最大后验概率(MAP,maximum a posteriori)序列估计,把早期视觉阶段"缠结"(tangled)了的目标表示解缠(untangle)出来。这是把 DiCarlo 等人的"解缠"概念翻译成一套可仿真、可检验的工程化假说的尝试,思路新颖但离实证还有距离。
研究背景
视觉物体识别的主流假设是:看到的目标身份以神经元群体活动模式来表征,沿腹侧视觉通路(VVS,ventral visual stream)从视网膜、外侧膝状体(LGN)、V1、V2、V4 一路到 IT,计算越来越复杂——V1 神经元感受野小、只响应边缘朝向这类简单特征,V4 感受野平均是 V1 的 4-7 倍、对中等复杂度特征敏感,IT 神经元则对面孔等复杂刺激有选择性,其树突形态的复杂度也沿等级递增。DiCarlo 等人 2012 年提出的"解缠"(untangling)概念是关键背景:目标身份的表示在视网膜和 LGN 阶段与像素表示一样高度缠结,到 V1 时表示维度增加了约 30 倍(引 Stevens 2001)但仍然缠结严重,越往上处理越把不同目标"流形"分离拉开。另有 recognition-by-components(RBC,成分识别)理论主张大脑把目标解析成部件再部分匹配,以及特征整合理论把注意与特征维度联系起来。
缺口在于:现有模型——无论 HMAX 式的层级模型、带 max-pooling 的神经网络,还是只关心目标类别(categorization)而非目标属性分类(identification/classification of attributes)的机器学习方法——都难以同时满足一个生物合理性模型应有的属性。作者列了六条:选择性(selectivity,区分不同目标且区分"识别"与"归类")、不变性(invariance,对尺度/位置变换鲁棒)、稳健性(robustness,光照杂乱等降低神经信号信噪比时仍能识别)、处理速度(processing speed)、注意门控(attentional gating,注意决定如何解析特征及识别后保留什么)、动态递归(dynamic recurrence,反馈与多脑区交互不可或缺)。已有的机器视觉算法在大类别数下受不变性问题困扰,作者据此认为需要一种更贴近大脑运行方式的框架。
研究思路
作者的核心类比来自 Shannon 以降的通信理论:信息经带噪信道传输时,靠发送端注入"结构化冗余"(编码)、接收端做序列推断(解码)来对抗噪声。把这套"编码器-信道-解码器"结构映射到 VVS:目标 b(用 KM 个比特表示,即目标在 IT 处应诱发的表征)由视网膜+LGN+V1 组成的"编码器"缠结成 N≥M 长的码字 s(比率 M/N 称为码率,编码器具有移位寄存器结构、约束长度 L);视觉场景遮挡、神经噪声、注意状态等所有扰动被抽象为"信道"(条件分布 P[r|s],连续时用信噪比 SNR、离散时用条件熵 H(r|s) 刻画);IT 则是"解码器",用 MAP 序列估计(等价于在有 2^L 个状态的图状态机上找最可能路径)从受扰序列 r 恢复目标身份。解码之后还有"交织器"(interleaver)把解码消息按重要性切成 F 个特征簇,一个线性分类器 f(b̂)=w^T b̂ 宣布目标类别;海马与杏仁核负责压缩表征并存储,同时把先验概率 P[b_k+1|b_k] 经反馈送给 IT,使解码成为贝叶斯式的。前额叶(PFC)、LIP、FEF 构成注意模块,自上而下调制编码器发放率(乘性因子 G_i(t))、信道质量、特征比特分配与压缩程度。
这样设计的逻辑是:用一个"每个组件都有明确数学定义"的架构,同时把六条生物属性装进去——选择性与不变性体现在 MAP 解码对汉明距离(Hamming distance)相近表示的判别与容错,稳健性由信道质量指标刻画,处理速度与"擦除"(erasure)声明对应反应时,注意门控与动态递归由 PFC/LIP/FEF 与海马-杏仁核的反馈显式建模。作者强调这不是神经网络替代品,而是一个可以用合成数据初步验证、再用多脑区神经记录检验的假设框架;他们特意把比特、状态等元素保持抽象(可对应单神经元放电、群体 PCA 输出或阈值化电路输出),以便日后拟合各类数据集。
方法
文章方法分建模与仿真两部分,无任何被试或动物实验数据。建模部分如上所述,具体参数化为:目标表示 b 含 K 个 M 比特单元(示例取 M=1);编码器为卷积码式移位寄存器,最简单例子(simple-encoder)码率 1/3、生成序列 G(D)=(1+D, 1+D², 1+D+D²)、L=2(4 个状态),复杂编码器(complex-encoder)码率仍 1/3 但 L=8(256 状态);离散无记忆信道把码字每一比特随机变为 A/B/C/D 四种神经活动水平之一("更弥散"信道 (10):P[r=A|s=0]=0.4 等,条件熵 1.846 比特;"较少弥散"信道 (21):条件熵 1.416 比特);解码器按转移长度 λ(b_k+1,b_k)=−ln P[b_k+1|b_k]−ln P[r_k|b_k+1,b_k] 在格图(trellis)上累积路径度量、回溯幸存路径输出 b̂;性能用四个指标评估:比特正确率 BCR(机会水平 0.5)、符号正确率 SCR(整串完全恢复才算对,机会水平 1/2^KM)、类别正确率 CCR 与近似类别正确率 ACCR(容许汉明距离差 c1=1)。交织示例中 F=2 个特征(M1=身份比特、M2=尺寸比特)按重要性重排,压缩示例把四帧 16 比特输入压缩成 8 比特记忆表征,并用计数转移频率的方式从压缩序列估计先验(如 P(S1|S3)=2/3)。
仿真部分对每个目标做 T=10^6 次蒙特卡洛迭代(Fig.10 的对比实验用 T=10^3),目标表示取 K=6、12、24、36、48、60 比特的 1-0 交替序列。simple-encoder 的解码用 MATLAB 自写代码实现完整维特比算法;complex-encoder 因格图有 256 状态,改用 MATLAB 的 vitdec(·) 函数做 4 电平软判决解码。除均匀先验(此时 MAP 退化为最大似然估计 MLE)外,还专门比较了非均匀先验下 MLE 与 MAP 的解码表现。
主要结果
- 架构层面:CTOR 全流程可以在玩具示例中跑通——K=4、码率 1/3 的 simple-encoder 把 b=1100 编码为 s=111 010 110 011,经四符号信道扰动为 r=(DCA, DDB, DDA, DDD) 后,维特比解码沿最小路径度量回溯,精确恢复 b̂=1100,实现完美识别;当信道极度弥散(四符号等概率、条件熵 2 比特)时转移度量全部相等,解码器只能任意宣布一个序列,模型由此给出"识别失败"的机理刻画,并引出擦除声明对应更高反应时的预测(正文第 5 节,Fig.3、Fig.8 示意)。
- 目标复杂度效应:用 simple-encoder 分别在两种信道下仿真(Fig.9A、B),BCR、SCR、CCR、ACCR 四个指标都随 K 增大(6→60 比特)而退化;SCR 退化最陡,说明完整恢复整串表征比部分恢复或仅归类更难——这对应"目标越复杂越难识别"的日常经验;较少弥散信道 (21) 下所有指标都优于更弥散信道 (10),直接量化了信道质量(SNR/条件熵)对识别的影响。
- 编码器复杂度的作用:码率不变而约束长度从 L=2 提到 L=8 的 complex-encoder(Fig.9C、D),在较少弥散信道下所有指标明显优于 simple-encoder,将争议分句替换为:说明在这些仿真条件下,增加编码器的约束长度 L(最大记忆阶数)并采用相应解码器,可在较少弥散信道下提高表征恢复性能。若将这一计算结构与 IT 锥体神经元的树突整合能力联系起来,应明确标注为解读者的类比,原文未建立两者的直接映射;但在高度弥散信道下两种编码器表现趋同——再强的解码也救不了太差的信道。作者据此推测真实 VVS 会采用大的 L 值并靠 IT 解码电路处理海量状态。
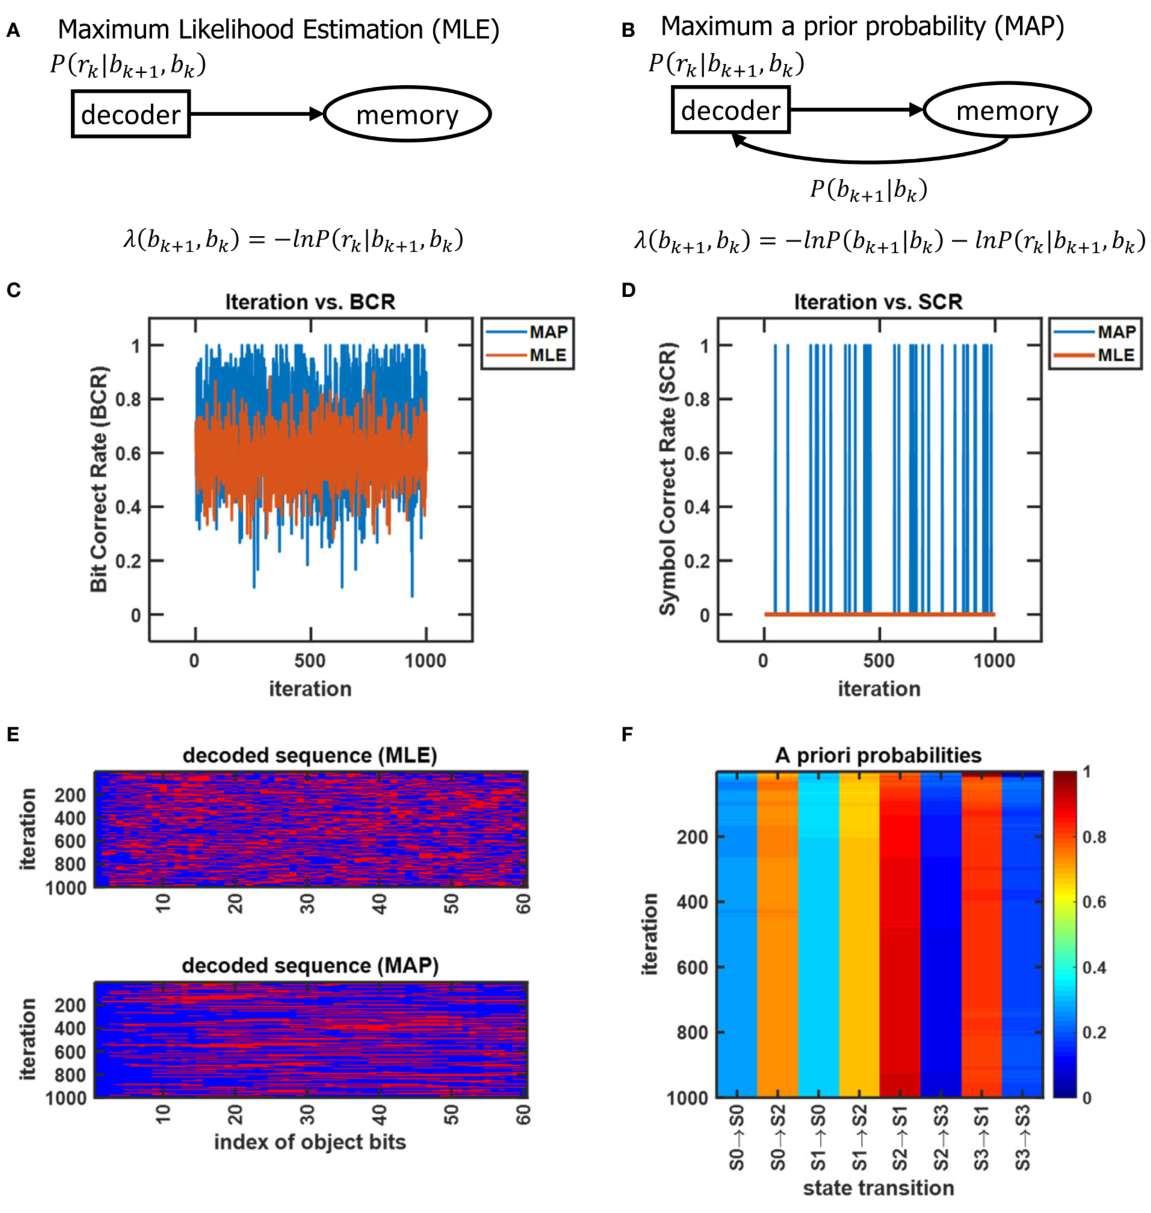
- 记忆先验的价值:在 K=60 比特、更弥散信道、T=10^3 迭代下比较 MLE 与 MAP(Fig.10):MLE 的 BCR 在 0.4-0.8 间波动(均值 0.581),MAP 平均 BCR 达 0.695 且在若干次迭代中 BCR=1;SCR 上 MLE 无一次整串正确(均值 0),MAP 均值 0.032;瞬图(kymograph)显示 MAP 解出的正确比特在时间上更成簇,且解码得到的先验概率在迭代间相当稳定、状态转移 S2→S1 与 S3→S1 先验最高(与输入流统计一致)。这直接验证了"海马-IT 前馈-反馈交互"对识别的增益。
- 识别与归类的分离:模型给出了四个分级指标,使目标识别(identity)与归类(category)的准确率可分别量化——作者指出此前工作从未做过这种定量区分,是 CTOR 填补的一个空白(正文第 6 节)。
图注解读
图 1 · CTOR 总体架构图
原文图注:FIGURE 1 | The communication-theoretic object recognition (CTOR) model. The structure of CTOR consists of feedforward processing with memory and attention providing feedback to the decoder portion of the IT. (a) The communication of T, {αi}, and {Gi(t)} of equations (1) and (2) from the PFC, LIP, and FEF regions to V1, V2, and V4. (b) Attention modulating the channel properties. (c,g) The communication of the transition probabilities {P[rk|bk+1, bk]} and the priors {P[bk+1|bk]} to the IT from the attention and memory circuitry, respectively. (d) The conveying of the number of features F and the number of bits allocated to each feature {Mi} by attention to the interleaver. (e) Conveyance of the degree of compression from attention. (f) Attention gating memory as far as the object features that are retained following recognition. (h) The contribution of the retinal, LGN, and V1 stages to the neural noise process constituting the channel.
这是全文的地图:一张图把编码器(视网膜/LGN/V1)、信道、解码器(IT)、交织器、分类器、压缩与记忆(海马 HPC、杏仁核 AM)以及注意模块(PFC、LIP、FEF)的连接全部铺开,(a)-(h) 标注了各条信号通路——注意经 (a) 乘性调节 V1 放电率、经 (d) 给交织器分配特征比特数、经 (e) 定压缩程度、经 (f) 门控记忆保留内容;记忆经 (g) 向 IT 送先验概率。实线框代表用算法操作建模的单元,实心区域为脑表面区域、阴影区域为脑内部区域。读这张图要抓住"前馈主干+两条自上而下反馈(注意、记忆)"的拓扑,它支撑研究思路部分的整个架构设计。图注未给出任何数值,属定性示意图。
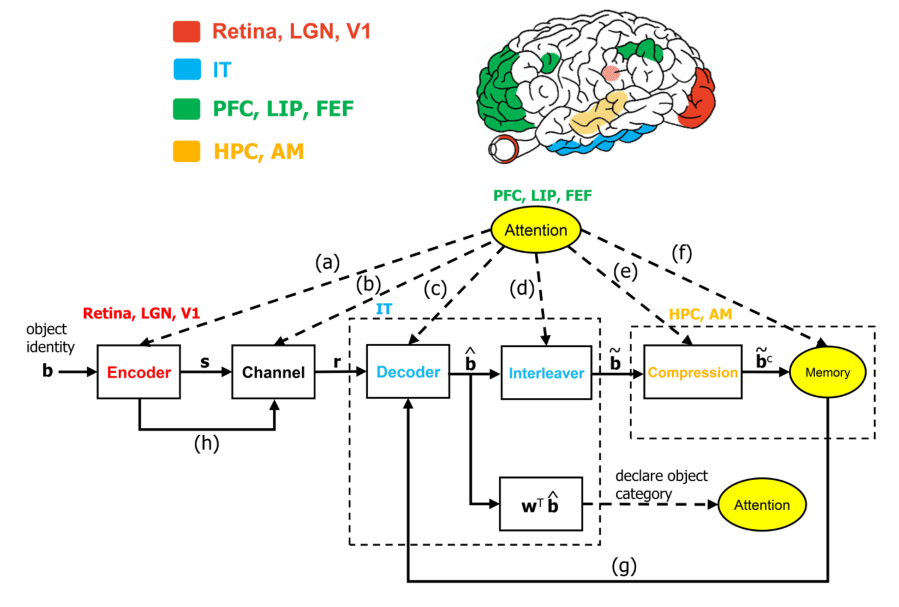
图 2 · 从输入到交织器的信号流示例
原文图注:FIGURE 2 | The interaction of the input, encoder, channel, decoder, and interleaver in the CTOR model. The top row depicts the brain regions implicated for the encoding, decoding, and interleaving operations. The middle row provides an illustration of CTOR operations with the viewed object being a brown bear. The bottom row illustrates the progression of the dimensions of the neural signals that are subject to the CTOR operations.
这张图用"棕熊"这个具体例子串起前馈流水线:顶行标注各操作对应的脑区,中行展示目标表征 b 如何被编码(缠结)成码字 s、经信道扰动为 r、被 IT 解码为 b̂、再被交织器按重要性重排;底行给出每一步神经信号的维度变化——关键维度关系是输入 M 比特被编成 N≥M 比特(码率 M/N≤1),N≫M 意味着解码器有更多含信息的信号可供判决。读图时对照底行维度即可理解"编码增加冗余、解码收缩回消息"的全程。它支撑研究思路与编码器/解码器部分的形式化定义。
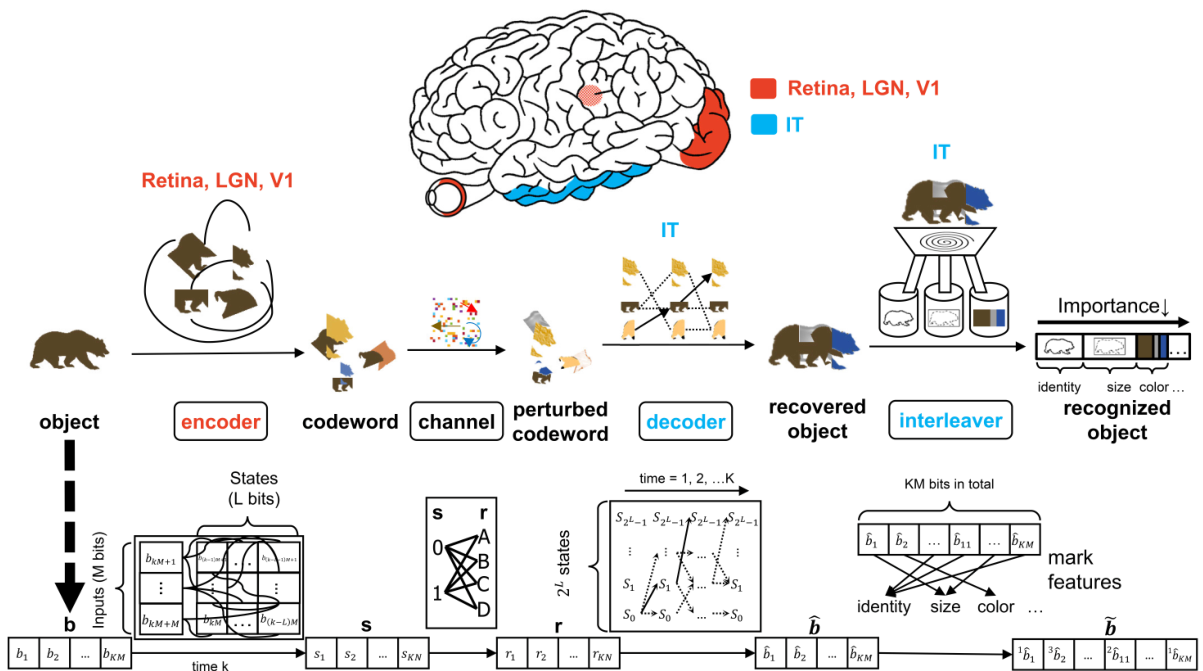
图 3 · 简单编码器的结构与状态图
原文图注:FIGURE 3 | The structure and state diagram of a simple encoder. (A) The so-called simple-encoder considered as performing the tangling operation at the retina and LGN in Figure 1. The "D" elements denote a unit delay inherent in the encoder's processing. The above is a definite simplification of encoding performed by the neural circuitry, but will serve to illustrate an instance of CTOR's encoding operation when the early visual stages are presented with an object. (B) A state diagram representation depicting the dynamics of the encoder in (A). The grouping 100, 1 above the state transition S1→S2 indicates that when the neural circuits representing the retinal and V1 stages (i.e., the encoder) are in a state of S1, a stimulus value of 1 would result in a transition to state S2 as well as the encoder output of 100.
(A) 是由单位延迟元件 D 构成的移位寄存器电路(即 simple-encoder,生成序列 G(D)=(1+D, 1+D², 1+D+D²)、L=2、每时刻 2^L=4 个状态),(B) 是它的状态转移图,每条转移上标注"输出码字, 输入比特"(如 S1→S2 上方的 100, 1 表示状态 S1 时输入 1 会输出 100 并跳到 S2)。读法:任意时刻输出由当前输入比特与此前 L=2 个输入共同决定,因此视网膜/LGN/V1 的输出不是无记忆序列,而是有结构依赖的模式——这解释了为什么 IT 端的解缠必须用序列估计而非逐比特判决。此图是玩具示例(主要结果第 1 条)与性能仿真(第 2、4 条)的编码器基础,作者明言这是对神经编码的刻意简化。
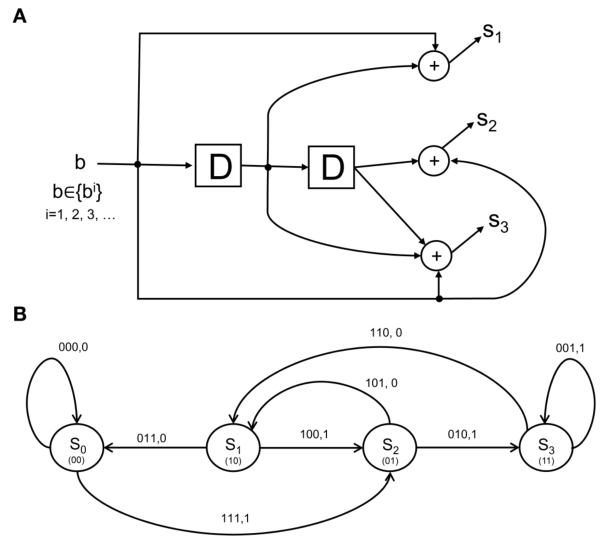
图 4 · IT 解码器的决策空间
原文图注:FIGURE 4 | An example of the decision regions at the IT's decoder at a specific time instant. Suppose KM = 15 with 2KM = 32, 768 possible representations that the decoder can declare as having been the viewed object. The circle denotes the possible space of received r sequences with r ∈RKN. The red dots denote the representation of such objects in a decision space. The closed region that surrounds a dot represents the region where the VVS would declare b̂ = bi if r were to lie in that region. The sequences b1, b2, and b3 are three prototypical objects.
这张示意图把解码写成"决策空间划分":圆域是收到的含扰序列 r 的可能取值空间,红点是各候选目标表征所在位置,围绕每个红点的封闭区域即决策域——只要 r 落进某区域,IT 就宣布对应目标。关键读点是点的疏密:相似目标(棕熊与幼象)的表征在汉明距离上更近、红点靠得近、决策域互相挤压,构成"存储于记忆中的候选目标之间的竞争",而竞争的胜负就是解码时把其余消息全部丢弃。它支撑解码器部分关于选择性、目标竞争与相似目标表征重叠的论述,也呼应 Usher 与 Niebur 的竞争抑制模型(CTOR 中"抑制"即淘汰非选中消息)。图中 2^15=32768 这一数量级展示了真实识别问题的组合规模。
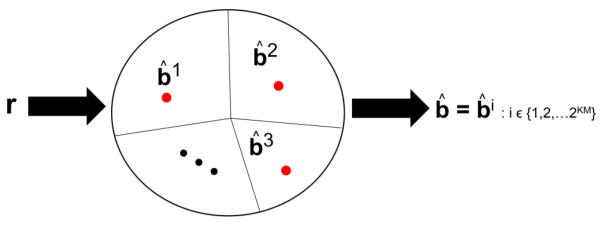
图 5 · 信号结构沿 VVS 的演化与特征分组
原文图注:FIGURE 5 | Depiction of the signal structure as it evolves along the VVS model presented in Figure 1. The KN-component vector r with ri ∈R has been decoded into a message b̂ with KM components, where b̂i ∈{0, 1} and N ≫M. At the output of the interleaver the KM components are partitioned into a message b̃ with F features—or feature dimensions as denoted in works such as Kanwisher and Wojciulik (2000)—of variable bit lengths. In the above example, F = 4 feature groupings are presented.
这张图聚焦解码之后的信号形态:KN 维的接收向量 r 被解码成 KM 维二值消息 b̂,再经交织器输出 b̃——KM 个比特被切成 F 个特征组(图中示例 F=4),每组比特数 M1…MF 可变、且 ΣMi=KM,顺序即特征的重要性排序。横纵方向上读的是"维度逐步收缩+重新打包"的过程,对应正文交织器一节:特征维度对应特征整合理论中的刺激维度,重要性排序由注意动态引导(如棕熊例子中身份比特排在颜色之前)。它支撑交织器与"识别 vs 归类分离"的论述。
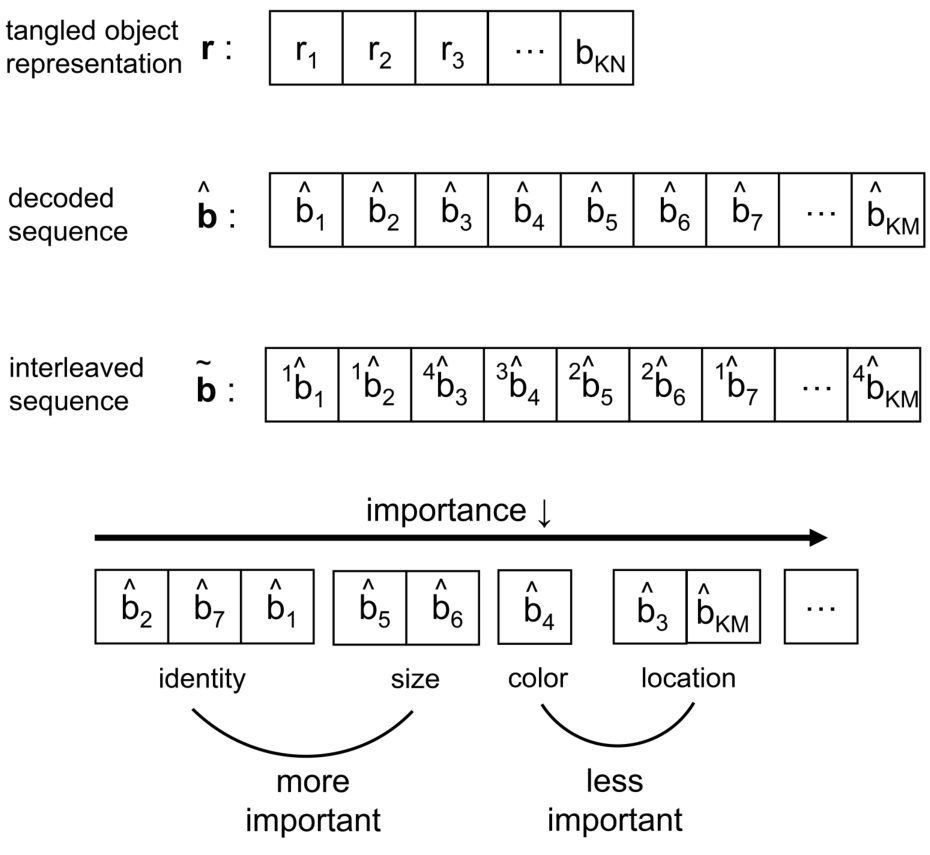
图 6 · 注意与目标类别宣告的交互
原文图注:FIGURE 6 | The interaction of attention and the declaration of object category. The top row depicts PFC, LIP, and FEF regions as they govern attention which is affected by the declared object category. The middle and bottom row provide an example of the CTOR operations and the dimensionality of the associated signals during the declaration of a viewed object's category. The scrolls denote different categories that viewed objects may be classified into prior to affecting attention. Attending to a categorized object is believed to modulate the firing rates of V1 neurons as discussed in Equation (1) and depicted via the projection (a) of Figure 1.
这张图展示模型里的反馈闭环:解码输出经线性分类器 f(b̂)=w^T b̂ 宣布类别后,类别信息又反过来影响 PFC/LIP/FEF 主导的注意,注意再经图 1 的通路 (a) 以乘性因子 G_i(t) 调制 V1 神经元放电率——形成"识别→分类→注意→编码"的动态循环。顶行是脑区,中行是操作示例,底行是各步信号维度;卷轴(scrolls)图标代表目标可被归入的若干类别。读图重点是"类别宣告发生在解码之后、并影响下一轮编码增益"这一时间顺序,支撑注意作为自上而下调制信号一节以及注意门控属性。图注为定性描述,无数值标注。
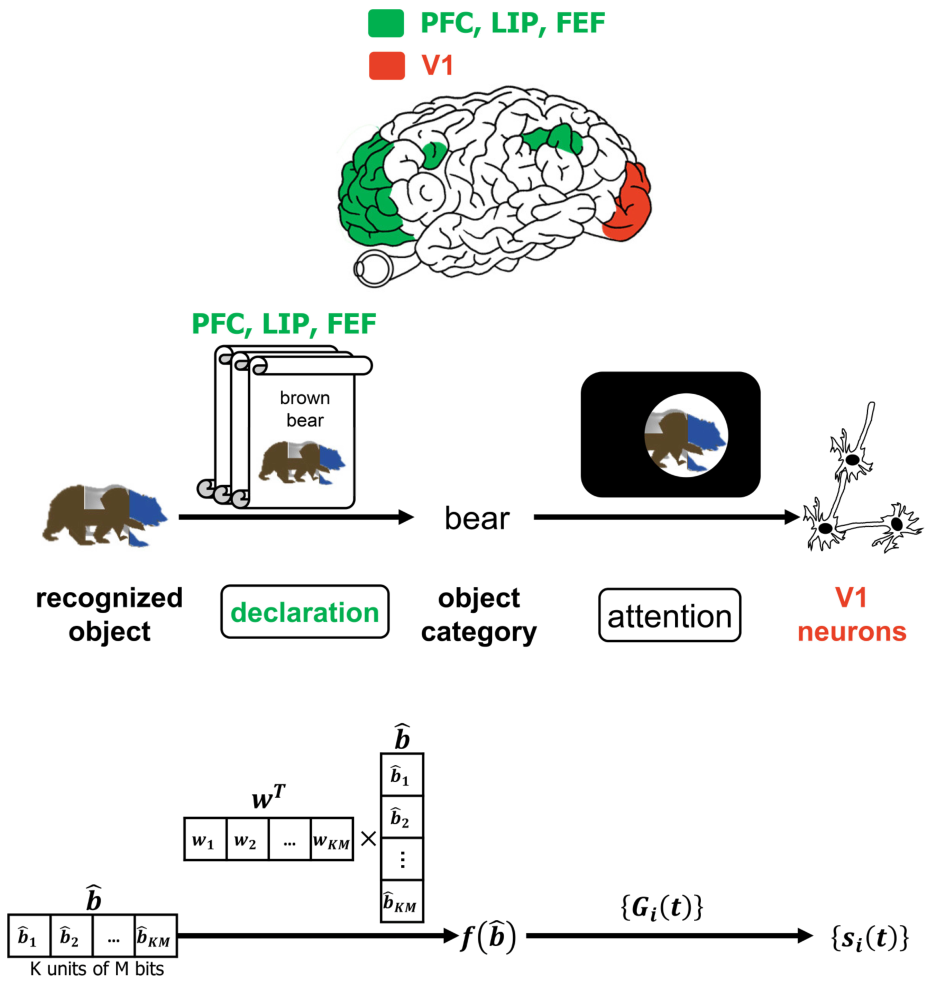
图 7 · 压缩、记忆与反馈操作
原文图注:FIGURE 7 | The operation of compression, memory and feedback in CTOR. The top row illustrates the brain regions (HPC, AM) involved in the memory and the compression operation while the middle row provides an illustrative example of the CTOR operations with brown bear being the viewed object. The middle row provides an illustrative example of the CTOR operations with brown bear being the viewed object. The bottom row depicts the dimensions of the neural signals during the aforementioned operations. The a priori probability P[bk+1|bk] that is fed back to IT is estimated as P[ẽbc_k+1|ẽbc_k] from the compressed sequence ẽbc.
这张图补上前馈主干之外的"存储侧":目标特征(身份、尺寸、颜色等)经交织与压缩后存入海马-杏仁核(HPC、AM)组成的记忆回路,压缩策略是保留高重要性特征、对低重要性特征跨样本合并(如四次观看 16 比特输入压缩成 8 比特);随后记忆回路从压缩序列 ẽbc 出发统计状态转移频率,把估计出的先验概率 P[b_k+1|b_k] 反馈给 IT,让解码器以贝叶斯方式工作。底行同样给出信号维度。它支撑主要结果第 4 条(MAP 优于 MLE 的原因),也呼应 Mishkin 关于识别记忆回路必含海马-杏仁核的经典论断。图中先验如何由计数得到的具体数值在正文压缩示例中给出(如 P(S1|S3)=2/3)。
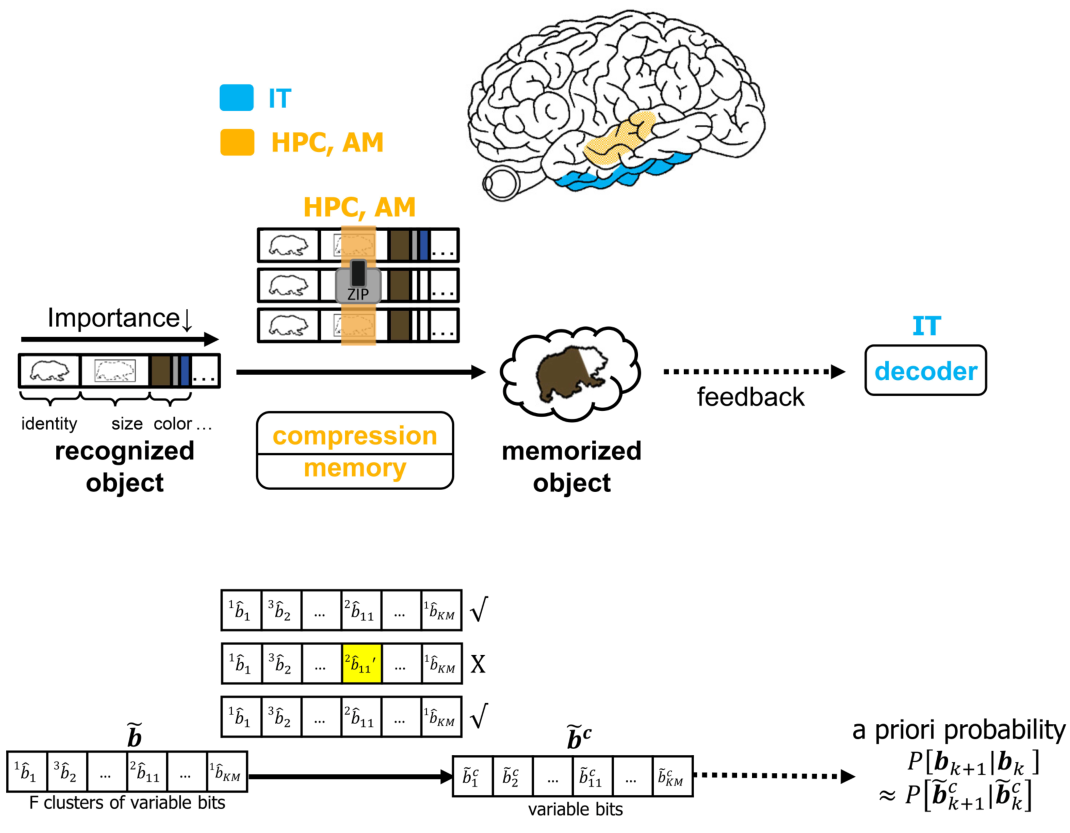
图 8 · 维特比解码的格图示例
原文图注:FIGURE 8 | An example from Lin and Costello (1983) to illustrate the dynamics of Viterbi decoding. The path marked with "O" denotes the final survivor path selected based on the smallest path length which corresponds to the MAP estimate of the sequence that the encoder desired to convey to the decoder. The transitions marked with "X" denote non-survivor transitions, while the unlabeled transitions denote survivors that were not part of the final survivor path.
这张图借自编码理论教科书(Lin & Costello 1983),展示维特比算法的运行:格图横轴为时间、纵轴为 2^L=4 个编码器状态,解码器逐时刻对每条候选转移计算转移长度 λ(式 6,均匀先验下只剩信道项),累积出路径度量;每个时刻每个状态只保留一条最小度量的"幸存路径",被淘汰的转移打上"X",最终沿度量最小的幸存路径(标"O")回溯得到 b̂=1100。这是主要结果第 1 条"玩具示例完美识别"的逐时刻演示,也是理解整个解码机制的核心图——本质上把"解缠"翻译成"在状态图上找最可能路径"。图例中未标转移度量数值,具体计算见正文式 (12)-(13) 与附录 B。
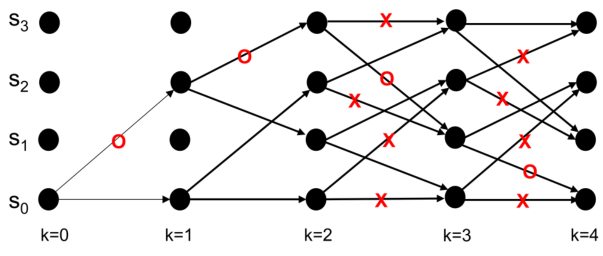
图 9 · CTOR 的四指标性能曲线
原文图注:FIGURE 9 | The performance of CTOR with the encoding, channel, and decoding structures discussed in this work. (A) The performance attained with simple encoder and the more-dispersive channel in (10), and (B) with the less-dispersive channel in (21). The decoding for the simple encoder was implemented with custom code in MATLAB. (C) The performance attained for complex encoder with the more-dispersive channel, and (D) with the less-dispersive channel. The decoding for the complex decoder was implemented using MATLAB's vitdec(·) function with 4 levels specified in the Viterbi soft-decision decoding algorithm.
四个子图都是"性能指标 vs 目标复杂度 K"的曲线族(K=6,12,24,36,48,60 比特,每目标 10^6 次蒙特卡洛迭代),每族含 BCR、SCR、CCR、ACCR 四条曲线。将争议句替换为:除 Fig.9D 中 BCR 外,其余指标随 K 增大呈退化趋势;作者在讨论 Fig.9A、B 时指出 SCR 下降最陡。作者还将 BCR 的范围描述为 [0.5,1],并提醒其在这些仿真中的变化范围较窄,可能不如其他指标提供的信息丰富;(B) 相对 (A)、(D) 相对 (C) 整体上移(信道质量好则性能好);(C)(D) 相对 (A)(B) 在较少弥散信道下显著上移(约束长度 L=8 的复杂编码器更优),但在高度弥散信道下两者趋同。这组图支撑主要结果第 2、3 条,是全文唯一的定量性能证据。图注未给出曲线具体数值,坐标范围需看原图。
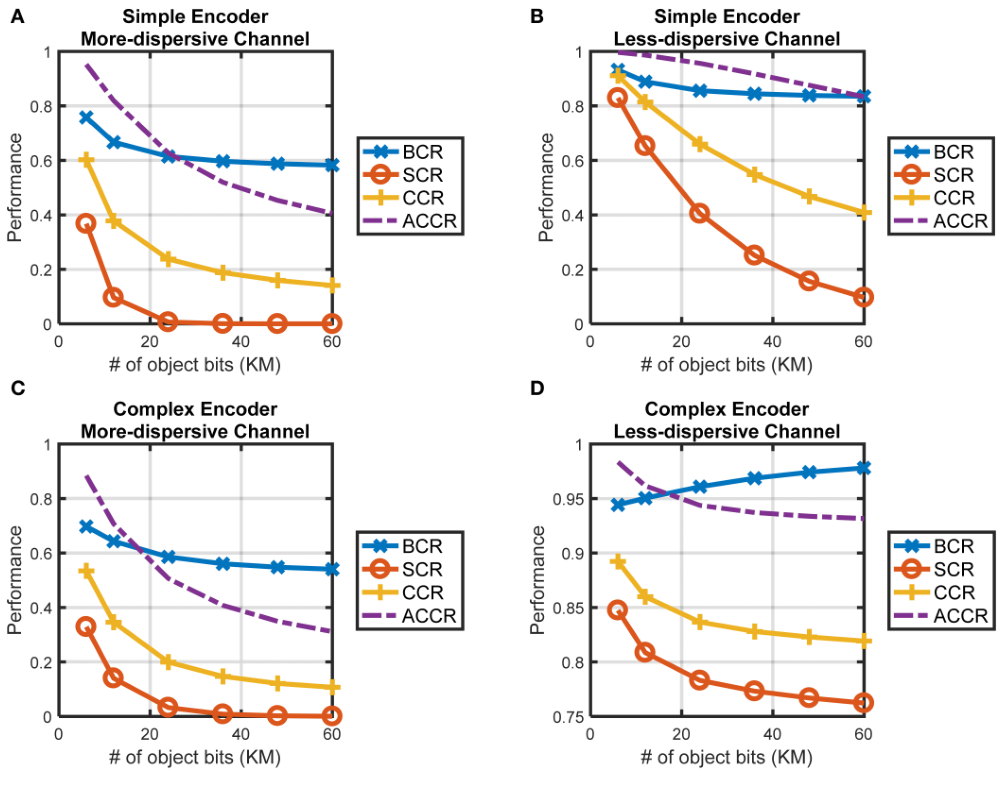
图 10 · MLE 与 MAP 解码的直接对比
原文图注:FIGURE 10 | A comparison of MLE and MAP with a simple encoder, the dispersive channel of (10) and K = 60 bit object identity. (A,B) Algorithmic depictions of the MLE and MAP decoding schemes. The transition length λ(·, ·) is computed for both schemes, and for MAP decoding, includes the a priori probability P[bk+1|bk] in addition to the transition probability P[rk|bk+1, bk]. (C) The progression of the BCR at each iteration of CTOR when considering MLE and MAP for the same viewed object. (D) The progression of the SCR at each iteration of CTOR when considering MLE and MAP for the same viewed object. It should be noted that the SCR can only take on values of {0, 1} at any iteration. (E) A kymograph of the decoded sequence over different viewing intervals (i.e., iterations). Red represents a bit correctly identified by the decoder and blue indicates that the bit was erroneously identified. (F) A kymograph of the a priori probabilities calculated by the attention and memory circuitry over the duration of each viewing interval.
(A)(B) 是两种解码算法的流程示意,差别只在转移长度是否含先验项;(C) 画 BCR 随迭代(每次迭代同一目标重新过信道)的轨迹:MLE 在 0.4-0.8 间波动、均值 0.581,MAP 均值 0.695 且多次达到 1;(D) 的 SCR 只取 0/1 两值:MLE 从未整串恢复(均值 0),MAP 均值 0.032;(E) 的瞬图中红色(正确比特)在 MAP 下更聚簇——先验引导了连续比特的解码保真度;(F) 显示记忆/注意回路算出的先验在 10^3 次迭代间几乎恒定,且 S2→S1、S3→S1 转移先验最高(与输入流中 11→10、01→10 最常见一致)。整张图支撑主要结果第 4 条,是"记忆先验(海马反馈)确实提升识别"这一核心主张最直接的证据。
讨论
作者在结论中把 CTOR 定位为连接神经科学家、计算机视觉学者与视觉心理物理学三个群体的桥梁:此前动态 MAP 序列估计主要用于低级视觉区,本文把它推进到负责物体识别的高级视觉区。模型的立论基础是"解缠"这一在灵长类视觉领域已被广泛接受的概念,注意与记忆则以自上而下信号的方式纳入——先验概率由海马-杏仁核回路估计并反馈给 IT,通道(编码器/信道统计特性)则可解释为脑区间突触可塑性习得:IT 上游群体通过反复交互学习 V4、V1 神经元的转移概率(统计通信理论里"解码器学习信道",类似 Baum-Welch 算法),这也可解释灵长类 IT 神经元对重复暴露刺激集合响应的显著可塑性。作者还坦承当前实现的简化与待补:先验均匀化处理使 MAP 退化为 MLE,先验的更新规则尚待形式化;注意模型只考虑了 V1 放电增益,未处理重叠目标分割等复杂情形;真实 VVS 更可能是多套 CTOR 架构并行再汇聚,而非单一流水线;擦除声明的动态与阈值也是未来课题。关于如何实证检验,作者给出具体路线:利用跨实验室汇集的多脑区神经记录(如 Shinomoto 等 2009 年 15 个皮层区的尖峰数据库),假设并迭代搜索"连接 IT 响应与 V1 响应"的最优码(码率、约束长度、编码器结构),再用同一批目标的 V4 群体响应拟合信道与解码器参数;或像 Lehky 等(674 个 IT 神经元 × 806 个目标)与 Dong 等的模拟那样,按附录 D 的参数仿真神经群体响应来检验 CTOR 的假设。源代码公开在 GitHub 上。
一句话总结
这篇文章的胆量在于把 IT 直接当成一台维特比解码器来建模——用通信理论的语言把"解缠"从一句口号变成了带码率、约束长度、信道条件熵和四个分级指标的完整假说,仿真也确实演示了记忆先验(MAP vs MLE)的增益;但按我自己的判断,合成 1-0 序列与真实目标表征之间的鸿沟极大(比特究竟对应什么神经事件全文只能说"待定"),所以它现在的价值是提供一套可证伪的词汇表和检验路线,而不是对 IT 计算的解释本身。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[F] - Fig10: 提取质量
good,对齐度full,识别面板[A, B, C, D, E] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[A, B] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[F] - Fig6: 提取质量
good,对齐度full,识别面板[] - Fig7: 提取质量
good,对齐度full,识别面板[] - Fig8: 提取质量
good,对齐度full,识别面板[] - Fig9: 提取质量
good,对齐度full,识别面板[A, B, C, D]
关键事实与局限性声明
- 审校纠偏: {'location': '主要结果 > 第 4 条', 'current_text': "这直接验证了'海马-IT 前馈-反馈交互'对识别的增益", 'problem': "该结论仅来自合成数据上的模型内仿真(且先验由输入流自身统计估计而来,MAP 优于 MLE 在信息论上近乎同义反复),称之为'直接验证'海马-IT 交互对真实识别的增益偏强;原文措辞 'confirming the value of the feedforward-feedback interaction' 本身已是作者的过度延伸,笔记照单全收", 'recommended_fix': "改为'在模型框架内演示了记忆先验对解码的增益(作者据此主张海马-IT 前馈-反馈交互的价值),但这是否对应真实神经机制有待实证'。注:笔记'一句话总结'已恰当地给出这一保留态度,可前后呼应"} -> 评注:
- 补充要点: 原文对 BCR 指标的自我批评(取值限于 [0.5,1]、对刺激复杂度最不敏感、'may not be as insightful of a metric')未被收录,而这恰是评估 Fig.9 四条曲线时的关键限定
- 补充要点: 玩具示例中类别宣告的反例(w 全 1 时三个不同目标 f(b̂)=8 被归入同一类,以及存在可实现完美分类的非平凡 w)未被提及——它是作者论证'识别与归类分离'及分类器 w 需训练获得的直接演示,与主要结果第 5 条直接相关
- 补充要点: simple- vs complex-encoder 对比使用了不同解码实现(完整自写 Viterbi vs vitdec 软判决 4 电平),这一实现层面的混杂因素原文有交代,笔记虽在方法部分提到但结果解读时未提示其对编码器对比结论的潜在影响