一句话定位:该研究针对灵长类能够轻易辨识高度变形字母(CAPTCHA)而传统机器视觉难以处理的现象,在未受过文字训练的猕猴下颞叶皮层(inferior temporal cortex, IT)开展单单位记录,发现神经元处理变形字符串遵循明确的可分离运算规则:单字符内属性调谐呈乘法交互,字符串中多字符调谐呈线性加和。将上述规则集成至人工神经群体模型,能够高精度解码复杂 CAPTCHA 字符串,且该规则在训练文字识别的深度卷积网络中同样涌现。
研究背景
阅读不仅要求认出字母,还要求在字体、位置、旋转和局部变形改变时保持身份,并同时处理一串字符。CAPTCHA 正是利用这类变形增加机器识别难度,因此为检验高级视觉编码提供了清晰问题。传统组合特征观点认为,IT 神经元可对特定部件组合形成选择性,整体反应未必能由单个成分预测;可分离编码则认为,身份与变形等属性以独立调谐组合,整体物体或字符串反应可由成分反应推算。两者都能解释部分既有结果,但若不直接比较函数形式,就很难判断哪种原则主导变形文字加工。
变形字母串具有两个可分别检验的维度。对单个字母,神经元可能把形状、视网膜位置和变形以乘法结合,使各属性偏好保持相对独立;对字符串,反应可能近似各位置字母反应之和,也可能对特定组合产生额外反应。自然物体研究已提供身份与属性乘法混合、整体反应近似部件求和的证据,但扭曲文字包含空间分离的多个成分和强烈风格变形,不能直接外推。还需证明分析确实有能力发现组合编码,否则“未发现”只是敏感度不足。
本文给未受过字母辨别训练的猕猴呈现变形单字母和不同长度字符串,用交叉验证比较加法与乘法模型,并用人工组合神经元检验阴性结果的统计能力。随后把测得的规则放入合成神经群体,评估其是否足以解码大量 CAPTCHA,再检查文字识别深度网络是否出现类似规则。研究关注的是前腹侧 IT 的主导编码趋势和字符读出的充分性,并不排除少量组合细胞,也不证明字母捆绑成词或音节不需要其他运算。它把日常 CAPTCHA 难题转化为对视觉编码原则的定量检验,而非声称猴脑专门进化出文字识别模块。
研究思路
研究设计遵循“刻画编码规则并验证其充分性”的实证逻辑。第一阶段,向未接受过字符训练的猕猴呈现系统参数化的变形单字母及 n-gram 字符串(长度 2–6 字符),分别构建加法与乘法竞争模型拟合单神经元反应:检验单字符放电能否由“形状×位置×形变”的乘积或加和预测,以及字符串放电能否由各位置单字符反应的加和或乘积预测。实验选用未受文字训练的动物,旨在验证此类计算规则源于腹侧视觉流固有的通用表征机制,而非后天字符辨别的特定学习产物。第二阶段,进行分析灵敏度校验:通过模拟构建具备典型不可分离特性的“组合编码”神经元,确认现有测试样本量与实验信噪比具备充分的统计检出力,从而保证阴性结果的可靠性。第三阶段,将测得的可分离规则实例化为人工神经元网络,在更大规模的合成字符串上评估字符解码准确率,并在经过字符识别任务训练的深度卷积神经网络中检验同类计算规则的涌现情况。
方法
实验动物为 2 只成年雄性帽猴(Ka 与 Sa,7 岁),记录其左侧 IT 前腹侧皮层的单单位电生理活动:采用 24 通道层状探针(U-Probe,触点间距 100 µm)以 40 kHz 采集,经离线锋电位聚类分离出 139 个具有视觉反应的单单位,记录范围覆盖前后轴约 4 mm、内外轴约 5 mm。刺激集共包含 432 个视觉图案:8 个印刷字符('a','d','g','s','T','y','7','K',Times New Roman 字体,视角约 0.8°),呈现在 6 个视网膜位置(同侧 3 个、对侧 3 个,间隔 0.8°);由这些字符组合成 10 个 bigram 至 10 个 6-gram 共 50 个非重复 n-gram 字符串;对所有 98 个单字符及字符串位置分别施加无变形及 3 种典型 CAPTCHA 扰动(局部鱼眼畸变、逐字符 ±15° 随机旋转、样条曲线全局弯曲);另包含 8 个包含字符粘连、空心轮廓与背景网格线干扰的困难版 6 字符 CAPTCHA。行为任务仅要求维持中央注视:每试次连续呈现 8 张图片各 200 ms(中间间隔 200 ms 空屏),每个刺激至少重复 4 次,实验全过程未对动物进行任何字符分类强化。
模型拟合采用交叉验证(奇数重复试次训练、偶数重复试次测试),以折半信度相关系数(split-half correlation)作为神经元反应可靠性的理论上限。针对 192 个单字符刺激分别拟合加法与乘法可分离模型(图 2);针对 200 个变形 n-gram 字符串拟合位置加权单字符线性加和模型与对数线性化乘积模型(图 3)。字符串解码时,在各视网膜位置训练 9 分类(8 个字符加 1 个空白类)的线性分类器(随机机会水平约为 11%)。合成网络模拟包含千余个具备锐化、平滑或混合调谐的人工神经元,并在 17,920 个新合成 n-gram 上进行解码测试;深度网络分析比较了 ImageNet 预训练的 VGG-16 以及三种专用文本识别网络(逐字符识别 charnet、n-gram 识别 ngramnet、整词识别 dictnet)的 fc7 层单元,采用与生物神经元相同的分析流程。
主要结果
- 单字符几何变形的编码遵循乘法可分离规则。单神经元对“字符×位置×变形”组合的放电模式可由形状、位置与变形调谐的乘积有效预测(代表性神经元预测相关系数达 r=0.59,p<0.0005,图 2A-B);在群体层面,加法与乘法模型均贴近折半信度上限,但在反应最可靠的神经元子集中,乘法模型表现出微弱但统计显著的优势(r=0.48 ± 0.13 对比加法模型 0.47 ± 0.13,Wilcoxon 符号秩检验 p<0.05,n=19,图 2C-D)。
- 群体解码放大单细胞水平的微小增益。将基于乘法模型与加法模型预测的放电向量分别作为虚拟神经群体训练线性分类器解码字符身份,乘法群体的整体解码准确率相比加法群体高出约 25%(机会水平 12.5%,图 2D 插图),显示出非线性乘积交互在下游群体读取中的放大效应。
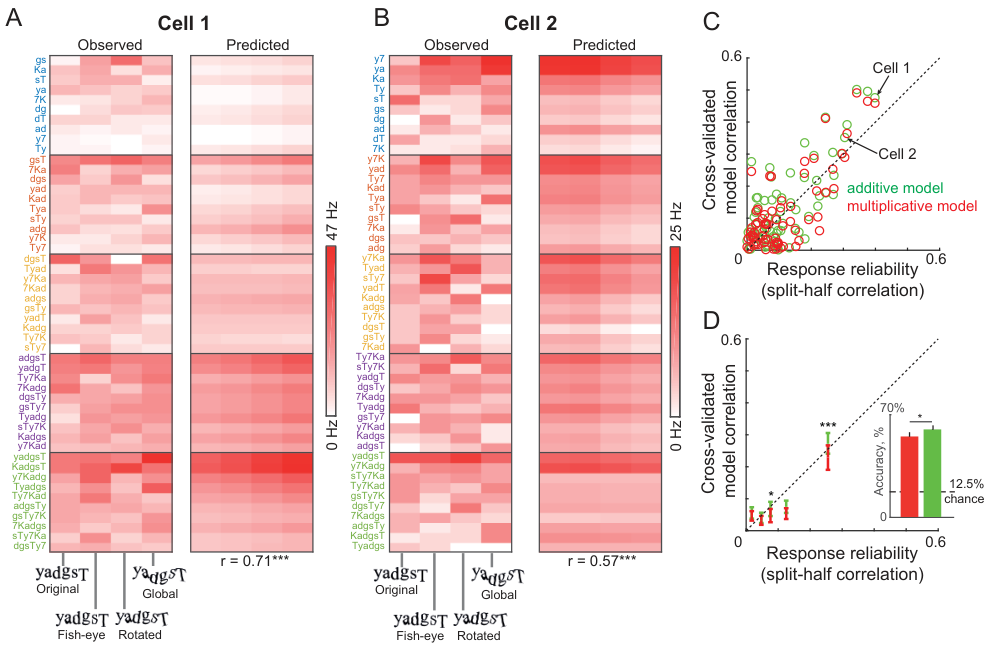
- 多字符构成的字符串编码遵循线性加和规则。字符串的神经反应被各位置单字符反应的加权和更有效地解释:在全部 89 个折半信度为正的神经元中,加法模型的相关系数均值为 0.11 ± 0.13,显著高于乘法模型的 0.08 ± 0.12(p<0.00005);在最可靠神经元组中,加法模型均值达 0.23 ± 0.15,显著高于乘法模型的 0.20 ± 0.16(p<0.005,n=21;典型单细胞拟合 r 达 0.57–0.71,图 3A-D)。加法群体的字母解码准确率比乘法群体高出约 5%(图 3D 插图)。各位置的加权系数呈现中间字符权重低于两端,且总放电随字符数 n 的增加按近似 1/n 衰减,符合局部网络的除法归一化特征。
- 未检出不可分离的组合特征调谐。若神经元对特定字母对(bigram)存在超越单字母预测的特异性组合反应,则包含该字母对的更长字符串应表现出系统性扩大的预测残差;实测中高误差与低误差 bigram 所构成的长串残差无系统性差异(各长度检验 p>0.05,图 4)。而在人工构造的组合神经元控制组中,75% 的样本在相同分析流程下检出显著的组合偏差(图 5),证实实验具备充分检出力,排除了由于测量噪声掩盖组合编码的可能。
- 双重可分离规则支持高精度 CAPTCHA 解码并涌现于深度网络。记录到的 139 个 IT 神经元进行逐位置 9 分类解码达到 29% 准确率(机会水平 11%);利用 1000 个遵循乘法属性结合与加法串联叠加的合成神经元群体,在 17,920 个 n-gram 上实现了接近完美的解码表现(图 6)。经过文字识别训练的三个卷积网络(charnet、ngramnet、dictnet)的 fc7 层单元同样表现出单字符乘法结合与字符串加法叠加的运算结构,且文字网络的可分离度显著高于 ImageNet 预训练网络,全词识别 dictnet 的字符解码率达 95%(图 7)。在具有严重干扰的困难 CAPTCHA 测试中,字符串可分离度出现显著下降(p<0.05),解释了人类与生物神经元在面对此类刺激时性能降低的计算原因(图 8)。
图注解读
图 3 · 字符串反应可由单字母预测:加胜于乘
原文图注:Figure 3C. For Figure 3C, we excluded 50 neurons with high response variability that 221
读法:本图展示了字符串刺激的加法与乘法模型对比(包含四个面板)。A 与 B 面展示两个典型神经元的实测放电与基于单字符加权和预测值的热图,行按刺激诱发放电强度排序,列对应 4 种几何形变条件,预测与实测的相关系数分别达 r=0.71 与 0.57。C 面将信度为正的神经元模型预测相关与折半信度绘制散点图,加法模型点群(绿色)系统性略高于乘法模型点群(红色)。D 面按神经元信度分箱对比,加法模型在各区间均保持优势,插图显示加法表征群体的字符解码准确率显著高于乘法群体(高出约 5%,p<0.05)。该图支持主要结果第 3 条,与单字符属性的乘法结合共同构成了下颞叶表征的双重分离。
讨论
作者将上述两项发现归纳为运算机制上的双重分离:单个字符的神经放电表现为字符身份、视网膜空间位置与几何形变调谐的乘法交互;而多个字符组成的复杂字符串放电则表现为单字符反应的加法线性叠加。这一机制与既往自然物体研究中“物体身份与外在变换属性乘法结合”(Ratan Murty & Arun, 2018)以及“复合图案反应近似离散部件加和”(Zoccolan et al., 2005)的框架相一致,并将其拓展至承受非刚性文字变形的人工符号系统。
针对文献中关于 IT 神经元特异性编码复杂特征组合的主张,作者指出本研究在系统控制下对部件与整体反应进行了严格配对与独立预测;而与部分报道中字符串无法完全线性分解的差异,可能源于记录位点(既往研究偏向 IT 后中部,本研究位于前腹侧)、神经信号类型(MUA 与单单位)以及刺激呈现时程的不同。在认知与应用层面,由于未受训练的猴脑 IT 神经元已具备此类规则,表明视觉系统无需专门的文字进化即可为阅读提供正交特征空间,文字经验可能进一步优化此类表征的分离度;而在计算视觉层面,加法池化与除法归一化的结合有助于抗衡局部遮挡与形变,为设计稳健的字符识别网络提供了生物启发。研究的局限在于,分析主要揭示了群体水平的主导运算趋势,不排除极少数专门组合细胞的存在;此外,当前的可分离读出主要针对“字符辨识”任务,将离散字符整合为音节或正字法整体词汇的高阶认知过程,仍可能需要下游皮层的非线性重构。
一句话总结
该研究阐明了下颞叶编码复杂文字刺激时的规则特征:单字符内多属性(身份、位置、变形)调谐采用乘法结合以支持不变性,字符序列间调谐采用加法叠加以实现多字符并行读出;生物 IT、合成神经群体与深度卷积网络三方证据在运算结构上高度吻合。需要指出的是,在可靠性最高的少数神经元子集中,乘法对加法以及加法对乘法的相关系数差异较小(如 r=0.48 对 0.47、0.23 对 0.20),单细胞水平的微弱优势依赖下游群体线性读出得以有效放大,这在作者的交叉验证与敏感性分析中得到了如实记录与界定。