一句话定位:机器视觉很吃力。或'远比人类困难'。,这篇文章问了"脑是怎么赢的":作者在猕猴下颞叶皮层(inferior temporal cortex, IT)记录发现,神经元用两条非常干净的编码规则处理变形字符串——变形用乘法、组合用加法——并把这两条规则装进人工神经元后即可"完美"解码 CAPTCHA。它把一个日常谜题变成了对高级视觉编码原则的严格检验,结论还能反向落到深度文字识别网络里得到印证,是编码规则类研究的范本。
研究背景
阅读要求我们在字号、位置、视角、书写风格乃至纸张变形面前稳定地认出字母。正因为机器在扭曲字母上如此吃力,网站才拿 CAPTCHA(Completely Automated Public Turing Test to tell Computers and Humans Apart,全自动区分计算机与人类的图灵测试)来拦机器人。对此存在两种对立的脑机制假说。一种是广泛流传的"组合特征"观:高级视觉区神经元对特定字母组合/特征组合具有选择性并对外观变化保持不变,其代价是组合的反应无法由单字母理解(存在涌现特征,emergent features)——这一观点有 IT 神经元特征组合选择性随辨别学习增强等证据支持(如 Tanaka、Connor 等实验室的工作)。另一种是"可分离编码"(separable encoding):神经元把字母、变形、字符串分开编码,使其组合反应可由成分单元的选择性预测;已有证据显示 IT 神经元以乘法方式混合物体身份与不变属性(Ratan Murty & Arun 2018),对物体反应近似各部件之和,且这种可分离性能解释乱序词阅读等现象、并随人类阅读专长提升(Agrawal et al 2019, 2020)。
缺口有两处:此前没有人让 IT 神经元直接面对"扭曲字母串"这类刺激——它们不同于自然物体,组成单元(字母)在空间上分离、且除了保恒等变换外还要承受大量风格化变形;因此"未受训练的猕猴 IT 本身的神经机器究竟能不能解 CAPTCHA"是悬而未决的。此外,两种假说在单细胞水平的具体函数形式(和还是积、能否检测到偏离)也没有被正面比较。
研究思路
作者的总体策略是"先描写编码规则、再证明规则充分性"的三段论。第一步,给猕猴看系统构造的变形字母与 n-gram 字符串(2–6 个字母),用两个竞争模型(加法 vs 乘法)拟合单细胞反应:变形字母的反应能否写成"形状×位置×变形"调谐的乘积/和;字符串的反应能否写成单字母反应的和/积。关键设计是 IT 神经元从未受过字母辨别训练——如果可分离编码在这个"天真的"系统里仍然成立,就说明它是先置 machinery 而非任务学习的产物。第二步,做敏感性检查:人为构造真正不可分离的"组合编码"(conjunction coding)人工神经元,证明现有实验设计与噪声水平足以把它们检出来,从而让"没检到"成为有意义的阴性结果。第三步,把测得的规则实例化到人工神经元群并在难得多的大样本字符串上解码,再考察为文字识别训练的深度卷积网络是否自发涌现同样规则——形成生物、合成、机器三方的三角互证。
方法
实验对象为两只雄性帽猴(macaca radiata,Ka 与 Sa,7 岁),记录其左侧 IT 前腹侧部分的单单位活动:24 通道层状电极(Uprobes,100 µm 间隔)、40 kHz 采样、离线 spike sorting,得到 139 个视觉反应单位,记录位点沿前后轴约 4 mm、内外轴约 5 mm 展开。刺激共 432 个:8 个字符('a','d','g','s','T','y','7','K',Times New Roman,约 0.8° 视角)各呈现在 6 个(同侧 3/对侧 3、间隔 0.8°)视网膜位置;用这些字符构造 10 个 bigram 到 10 个 6-gram 共 50 个独特 n-gram;对全部 98 个单字母/n-gram 位置施加无变形+3 种取自商业 CAPTCHA 算法的变形(局部鱼眼透镜、逐字符 ±15° 随机旋转、沿样条曲线整体弯曲);另含一组 Google/Yahoo 式"困难 CAPTCHA"(字母互相接触、仅轮廓、背景网格、贯穿波浪线等,共 8 个 6 字符串)。行为任务仅为固视:每试验顺序呈现 8 张图各 200 ms(间隔 200 ms),每个刺激至少 4 次重复,从未训练动物辨别字母。
分析上,所有模型都做交叉验证(奇数重复训练、偶数重复预测,反之亦然),并以 split-half 相关作为单神经元反应可靠性的上限标尺:对 192 个"字母×位置×变形"刺激拟合加法/乘法模型(图 2);对 200 个变形 n-gram 拟合"位置加权单字母和"加法模型与对数线性化的广义乘积模型(图 3);字符串解码时在每个视网膜位置训练 9 类(8 字母+空白)线性分类器,机遇水平 1/9≈11%。合成神经元实验构造千余个具有锐/宽/混合调谐、乘/加组合、有无除法归一化(divisive normalization)的人工神经元,在 17,920 个独特 n-gram 上测试解码;深度网络分析对比 ImageNet 预训练的 VGG-16 与三个文本识别网络(charnet 逐字符、ngramnet 检测 n-gram、dictnet 整词识别,均取 fc7 层 4096 个单元),套用与真实神经元完全相同的分析。
主要结果
- 变形字母的编码是乘法可分离的。示例 IT 神经元对全部"字母×位置×变形"组合的反应,被乘法模型(形状×位置×变形调谐的乘积)显著预测(图2A示例细胞r=0.59,p<0.0005;图2B为另一示例细胞。);群体层面两模型都贴近 split-half 可靠性上限,但在最可靠的那档神经元中乘法略胜(r=0.48±0.13 vs 加法 0.47±0.13,符号秩检验 p<0.05,n=19;图 2C-D)。模型相关偶尔高于可靠性,用可靠性匹配的人工神经元验证后确认这是模型"去噪"效应(平均差 0.07±0.1,p<0.0001)。
- 微小的单细胞优势换来巨大的群体解码收益。把乘法模型预测与加法模型预测分别当作两组神经群训练线性分类器解码字母身份,乘法群的准确率高出约 25%(机遇 1/8=12.5%;图 2D 插图)——单细胞水平几乎看不到的差别在群体解码上被放大。
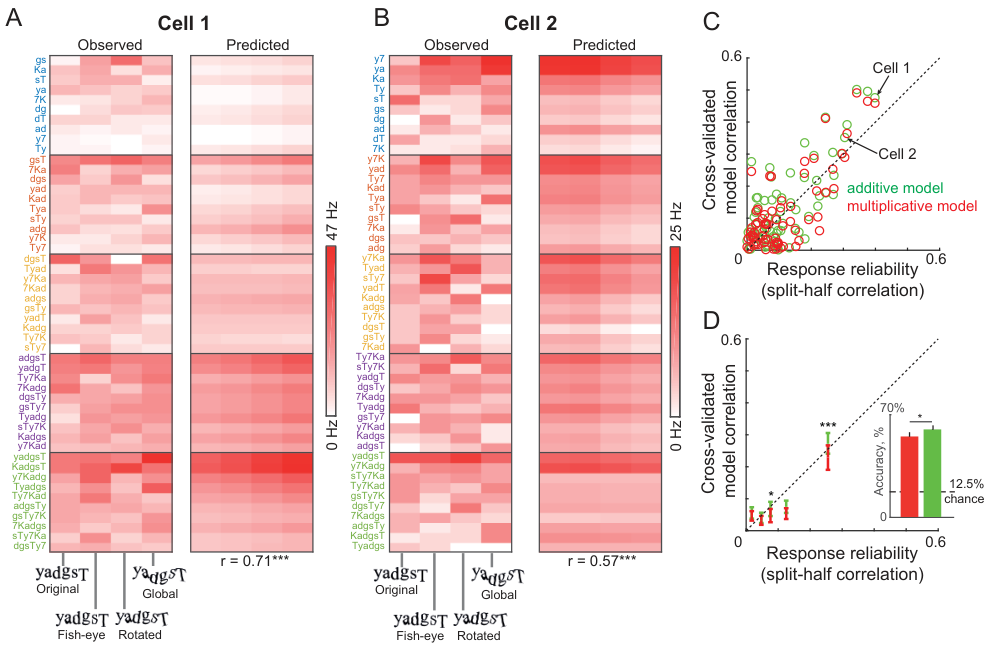
- 字母组合的编码是加法可分离的。字符串反应被"位置加权单字母之和"更好地解释:全部 89 个可靠性为正的神经元上,加法模型相关 0.11±0.13,显著高于乘法模型的 0.08±0.12(p<0.00005);最可靠组为 0.23±0.15 vs 0.20±0.16(p<0.005,n=21);示例细胞拟合达 r=0.71 与 0.57(图 3A-D)。加法编码群的字母解码也比乘法编码群高约 5%(图 3D 插图)。求和权重中部字母小于两端,n-gram 反应与单字母反应之和呈 1/n 递减,与 IT 已知的除法归一化相符。
- 未检出组合调谐,且方法足以检出。若神经元对某 bigram 有超出单字母预测的"偏常"反应,则含该 bigram 的长串应有系统性更大的模型误差——实测高低误差 bigram 的长串误差无系统差异(各长度 p>0.05,图 4);而将三类不可分离的人工神经元(纯组合、带基线组合、长串组合)投入同一分析,其偏差均能被检测(含误差分析,75%、15/20 的比较显著,图 5)。阴性结果因此可信:IT 群体主导趋势是可分离的。
- 这两条规则足以"完美"解 CAPTCHA,且在深度文字网络中自发涌现。记录到的 139 神经元群体做 9 类逐位置解码平均达 29%(机遇 11%);构造 1000 个可分离人工神经元在 17,920 个 n-gram 上测试,混合锐/宽调谐+乘法属性编码+加法字符串编码(宽调谐还需除法归一化)的组合达到近乎完美的解码(图 6)。四个深度卷积网络(VGG-16/ImageNet 基线、charnet、ngramnet、dictnet)的 fc7 单元同样呈"属性乘法、字符串加法"的双重规则,文字网络可分离性高于 ImageNet 网络、dictnet 最高,字符解码依次为 74%、92%、93%、95%(图 7)。困难 CAPTCHA 解码变弱但仍高于机遇(图 8A),其变形可分离性与简单版相当,核对Figure 8图注;若图注无p值则删去'(p<0.05)'或显著更低。——这解释了为什么IT神经元群体对它们解码更差。,或标注'人类更难'为常识性推测而非本文证据。(图 8)。
图注解读
图 3 · 字符串反应可由单字母预测:加胜于乘
原文图注:Figure 3C. For Figure 3C, we excluded 50 neurons with high response variability that 221
meta 中只保留了这一条图 3 相关的方法学注记(说明图 3C 分析排除了 50 个因高反应变异性而 split-half 相关为负的神经元,"221"为 PDF 行号残留),并非完整图注;据文中图例,图 3 共含四个面板。完整解读如下:A、B 面是两个示例细胞的"观测 vs 预测"热图——行按该细胞对 n-gram 反应由强到弱排序、列为四种变形(原始/鱼眼/旋转/整体弯曲),左图为真实发放率、右图为把每个 n-gram 反应建模为对应位置单字母反应加权和(组合模型)后的预测,拟合相关分别为 r=0.71 与 0.57(p 值标注在图内);C 面把群体中可靠性为正的神经元的交叉验证模型相关对 split-half 可靠性散点作图,绿色(加法)与红色(乘法)两组点大致贴着对角线,绿点系统略高;D 面按可靠性分箱展示加法模型一致占优,插图给出两类模型群解码字母的准确率差异(加法群约高 5%,p<0.05)。这张图支撑上文的第 3 条结论:字符串是"和"而非"积"——与图 2(变形字母是"积"而非"和")合起来构成全文核心的双重分离(double dissociation)。
讨论
作者把两条规则合称为一个"双重分离":变形字母反应是形状×位置×变形调谐的乘积(而非和),字符串反应是单字母反应之和(而非积)——而这两种组合方式并无先验理由非得如此配对,按解码模拟来看它们恰恰是编码变形字母串的最有效方式。这与既有文献的对接是双向的:一方面延续了"物体身份与不变属性在 IT 乘法混合"(Ratan Murty & Arun 2018)、"整物体反应等于离散部件之和"(Sripati & Olson 2010;Zoccolan et al 2005)的线性组合传统,并把它拓展到承受风格化变形的文字类刺激;另一方面与两支文献正面冲突——主张 IT 神经元选择性编码特征组合的经典研究(Brincat & Connor、Kobatake & Tanaka 等)没有系统地把整物反应与成分反应对齐(而把部件从物体上"切"下来又会引入新特征,需间接估计),以及 Rajalingham 等(2020)发现 n-gram 反应不能完全由单字母预测,作者推测差异源于记录位点(后者在 IT 后/中部,本文在前/腹侧)、信号类型(多单位 vs 单单位)与呈现时长(100 ms 无间隔 vs 200 ms 开关)。
关于阅读的启示,作者提出三项推测:既然完美可分离的群体足以完美解码而 IT 神经元并非完美可分离,阅读专业训练可能提升词汇表征的可分离性(正如在人类前枕外侧皮层——IT 同源区——刚被观察到的那样);熟悉度在 IT 与人类视觉皮层有广泛影响,字形熟练可能伴随辨别增强;外周阅读更难(拥挤效应,crowding),或源于外周刺激下可分离性下降,也可能是高级区感受野的中央凹偏置。对机器视觉的含义同样具体:dropout 带来稀疏性、mean-pool 对宽调谐相当于除法归一化、max-pool 近似稀疏神经元聚合,递归组合架构已被证明能破 CAPTCHA(George et al 2017);作者建议把可分离性显式编码进网络设计。局限方面作者承认可能存在携带其他信息的不可分离神经元(只是群体主导趋势可分离),且其结论仅对"字符解码"这一用途而言"可分离性充分"——把字母捆绑成音节的下游加工仍可能需要组合编码(Dehaene 等)。
一句话总结
我读下来最佩服的是这篇的"对称美":属性要乘、序列要和,一个负责不变性、一个负责多对象同时解码,规则本身就带着功能性解释,而且生物 IT、人工神经元、深度网络三方同框出证据,闭环干净。要说保留意见:最可靠那 19–21 个神经元上 r=0.48 对 0.47、0.23 对 0.20 的"显著差异"小得可怜,单细胞层面的结论其实依赖群体解码来放大——但作者自己也承认这一点并主动做了敏感性检查,这种诚实让结果更可信赖。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig3: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: 一句话定位中'机器视觉做不到'夸大了原文'so challenging'的表述(见ISSUE_001)。
- 审校纠偏: 结果第5条把困难CAPTCHA的难度外推到'人类也觉得更难',超出本文实验范围(见ISSUE_002)。
- 审校纠偏: 一句话定位与讨论中'完美解码'的归属处理正确(完美解码来自合成神经元群体,实测139神经元群体仅29%),此处在MD中未被夸大,予以确认。
- 补充要点: 未提及两个方法学排除标准:图2C-D分析排除了37个split-half相关为负的神经元(图3C排除50个,MD已提后者未提前者);两图入选神经元数不同(102 vs 89)这一点MD也未交代。
- 补充要点: 未提及加法+乘法组合模型(r = w1·ra + w2·rm + w3·ra·rm)并不优于纯乘法模型的负结果(p=0.37–0.77,图2D各可靠性分箱),这是支持'乘法已充分'的重要对照。
- 补充要点: 未提及n-gram反应的shuffle对照(打乱n-gram与单字母的对应关系后模型拟合与可靠性的对应消失,附图S2),这是排除过拟合的关键阴性对照。
- 补充要点: 未提及发放率分析窗口为刺激 onset 后50–200 ms,以及形状与位置是反应的主要贡献者、同侧/对侧位置贡献相当(附图S2)。
- 补充要点: 未提及'n-gram×变形'层面同样是乘法可分离(附图S3)以及两只猴子分别分析结果定性一致(附图S6),二者是主结论稳健性的支撑。
- 补充要点: 图2D插图的25%解码优势基于8类分类(机遇12.5%),而图3D插图及CAPTCHA解码基于9类(机遇11%),MD虽分别写对了机遇水平,但未点明两者分类器不同,读者易混淆。