这篇文章把视觉心理学与神经科学里十几个经典的知觉/神经现象逐一改写成"表示空间中图像间距离比较"的命题,然后检验物体识别训练出的前馈深度网络逐层是否出现这些现象。它的价值在于给出了一个干净的三分法:有些现象连随机初始化的网络都有(架构自带),有些要靠物体分类训练才出现,还有些训练了也没有——这为"大脑和网络差在哪里"提供了第一张定性清单。
研究背景
深度卷积网络在物体识别上达到人类级别的准确率,其各层表示与视觉皮层各级也粗略对应,但人类仍胜过它们,且在细尺度上与人类知觉有系统性偏差(如纹理偏置、对抗样本脆弱)。此前对这些差异的讨论多是定量的,似乎"多喂数据、加约束、加循环"就能修好;作者提出真正要紧的问题是:大脑表征中是否存在网络根本不具备的、定性的涌现性质?直接训练网络去完成某个任务再比较没有意义——只有网络学不会才算信息。更有价值的做法是:不专门训练网络去表现某个现象,只是把网络上跑一遍,看现象是否"冒出来"。幸运的是,视知觉文献里恰好有一批经典效应可以改写成距离陈述。以撒切尔效应(Thatcher effect)为例:面部部件各自旋转 180° 后,正立时看起来怪诞、倒立时却完全正常;这在知觉空间中等价于"正立的正常脸与怪脸距离大于倒立时的距离"——对任何计算模型,这条都可以直接验算,而且逐层测量还能揭示效应出现在哪一层,从而推断其计算复杂度和可能的神经对应层级。
研究思路
作者的总体策略可以概括为"现象→距离→逐层检验"。第一步是收集尽可能多能改写成距离比较的知觉与神经现象,按五组组织:(1) 物体/场景统计规律(撒切尔效应、镜像混淆、场景不协调);(2) 皮层神经元调谐性质(多物体归一化、相关稀疏性);(3) 特征间关系(韦伯定律、相对大小、表面不变性);(4) 三维形状与遮挡;(5) 部件与全局结构。第二步是设计"训练 vs 架构"的双对照:主网络为 ImageNet(120 万图、1000 类)上训练的 VGG-16,同时测试随机初始化的 VGG-16(区分性质来自架构还是训练)以及换用人脸识别训练的 VGG-face;补充材料还在不同随机种子的 VGG-16 和 AlexNet、GoogLeNet、ResNet-50、ResNet-152 等网络上复验,并验证结论对欧氏距离以外的距离度量稳健。第三步是逐层扫描:每张图输入网络后取各层激活向量(VGG-16 共 37 层),在每层计算图像间的欧氏距离和该现象专用的指数;判定标准是最后一个全连接层(分类真正用到的层)是否表现出该性质。多数实验复用原行为或神经研究的刺激,并把不同来源的行为、神经和网络测量转换为方向一致的效应指数;但撒切尔效应和多物体归一化等比较并非使用完全相同的刺激,原始测量量也不总相同。
方法
网络方面,主体是 MATLAB MatConvNet 实现的 VGG-16:输入 224×224×3 RGB 图像,减去全图像集的 RGB 均值,经五组卷积块(各卷积后接 ReLU,五个 2×2 最大池化)最后接全连接层,输出 1000 类置信度;VGG-face 与 VGG-16 架构相同但训练于人脸识别。特征提取即把每层激活存为列向量,图像 A、B 的距离为其激活向量的欧氏距离。各实验的刺激与指数分别针对现象定制:撒切尔实验用 20 张正立灰度正面印度人脸(借 Active Appearance Model 的 76 节点人脸配准,把眼、嘴区域逐行上下翻转实现"撒切尔化"),撒切尔指数 = (d正立 − d倒立)/(d正立 + d倒立);镜像混淆用 100 个物体(50 个原物加 50 个旋转 90° 的版本,避免横/竖拉长物体带来的伪差异),指数 = (d水平镜像 − d竖直镜像)/(d水平镜像 + d竖直镜像);场景不协调用 40 个物体(17 个取自 Davenport 研究、23 个取自 Munneke 研究)各自嵌入协调/不协调背景,比较分类 Top-1/Top-5 准确率;多物体归一化用 49 个灰度物体在 3 个位置的 147 张单物体图加随机组合的 200 个双物体、200 个三物体图,只分析在三个位置都有响应的单元(自第 23 层 conv4.3 起),把单元对多物体显示的响应对其单物体响应之和作回归,斜率 1/2(双物体)、1/3(三物体)即除法归一化;相关稀疏性沿用猴 IT 研究(Zhivago & Arun 2016)的刺激(8 个参考形状及其形变线、128 纹理、128 轮廓形状),以稀疏度 S = 1 − (1/n)(Σri)²/Σri² 度量每个单元在两类刺激集上稀疏度的跨单元相关;韦伯定律用不同长度的矩形棒,计算两两距离与长度绝对差、相对差的相关之差 rrel − rabs;相对大小与表面不变性各用 24 个四联组刺激,先按交互项 |r11+r22−r12−r21| 挑出交互最强的前 7% 或前 9% 四联组,再算 (d1−d2)/(d1+d2) 指数;三维加工用长方体/立方体/棱台线画图与其 Y 形结点对照的等特征差异配对;遮挡用重建的 Rensink & Enns 刺激(遮挡有无、遮挡顺序与等价二维特征差异对照);部件实验分两支(自然/非自然切口的断裂物体距离比较;以及用部件求和模型预测整物体不相似性的自然部件优势,1176 个方程对 64 个未知数的线性回归);全局优势用 49 个由 7 个全局形状与 7 个局部形状组合的层级刺激,指数 = (d全局 − d局部)/(d全局 + d局部)。人类参照值大多以视觉搜索时间的倒数作为知觉距离代入同一指数。
主要结果
-
三分格局(表 1):随机网络就有——相关稀疏性、相对大小、全局优势;训练后才出现——镜像混淆、场景不协调、多物体归一化、韦伯定律(相对大小也被训练加强);训练后仍缺——三维加工、表面不变性、遮挡、深度排序、物体部件,以及(训练引入的反向)全局优势。结论在多种网络架构和距离度量上稳健,但只适用于物体分类训练的前馈网络。
-
撒切尔效应基本缺席但训练相关(图 2b):VGG-16 在 conv4、conv5 和前几层全连接上出现正的撒切尔指数,但在最后两层全连接反而弱负;随机网络全程无效应;VGG-face(人脸识别训练)则逐层稳步上升并在全连接层保持高位。按"最后一层须为正"的判定标准,物体分类训练不足以让 VGG-16 保持该效应(补充网络中只有 GoogLeNet 判为"有")。
-
网络比人类更受语境拖累(图 2e–g):VGG-16 对不协调场景中物体的分类准确率显著下降——Top-5 下降 20%、Top-1 下降 27%——而人类命名准确率在同批场景上仅下降 14%(Davenport & Potter 2004)与 13%(Munneke et al. 2013);作者坦言人与网络的显著性检验方式不同(跨被试 vs 跨场景)。用场景到平均特征向量的距离度量时,不协调场景更远,且该效应只在较晚层出现。
-
多物体归一化在训练后出现、随机网络中的"完美斜率"是假象(图 3b、c):第 37 层 VGG-16 对双物体、三物体的响应相对单物体响应之和的斜率为 0.60 与 0.42,接近猴 IT 的除法归一化(理论值 0.5 与 0.33),且斜率随层近单调下降逼近 IT 水平;随机网络斜率恰为 0.5,但其对任意两张自然图的激活高度相关(第 37 层 r = 0.98±0.01),即缺乏图像选择性,故这种"归一化"是无选择性的平凡结果。相关稀疏性则相反:参考集与形变线的稀疏度相关在各层都高,纹理与形状稀疏度的相关在 conv5 和 fc 层转正,且随机网络中甚至更强——纯架构性质。
-
关系性性质一半有一半没有(图 4、图 5):韦伯定律在 VGG-16 早期层为负(对绝对变化更敏感)、晚期层转正,随机网络无此趋势,说明物体识别训练足以产生韦伯定律(对图像强度的韦伯定律则不稳定,仅低亮度水平成立);相对大小指数在晚期层小幅转正、弱于猴 IT 但方向一致,且随机网络中已微弱存在;表面不变性指数在 VGG-16 与随机网络中各层均为负——缺席。三维加工指数在所有层都近零或为负(图 5b);遮挡与深度排序指数持续为负但随层趋零、训练使其改善却远未达到人类水平(图 5d),而随机网络无此上升趋势。
-
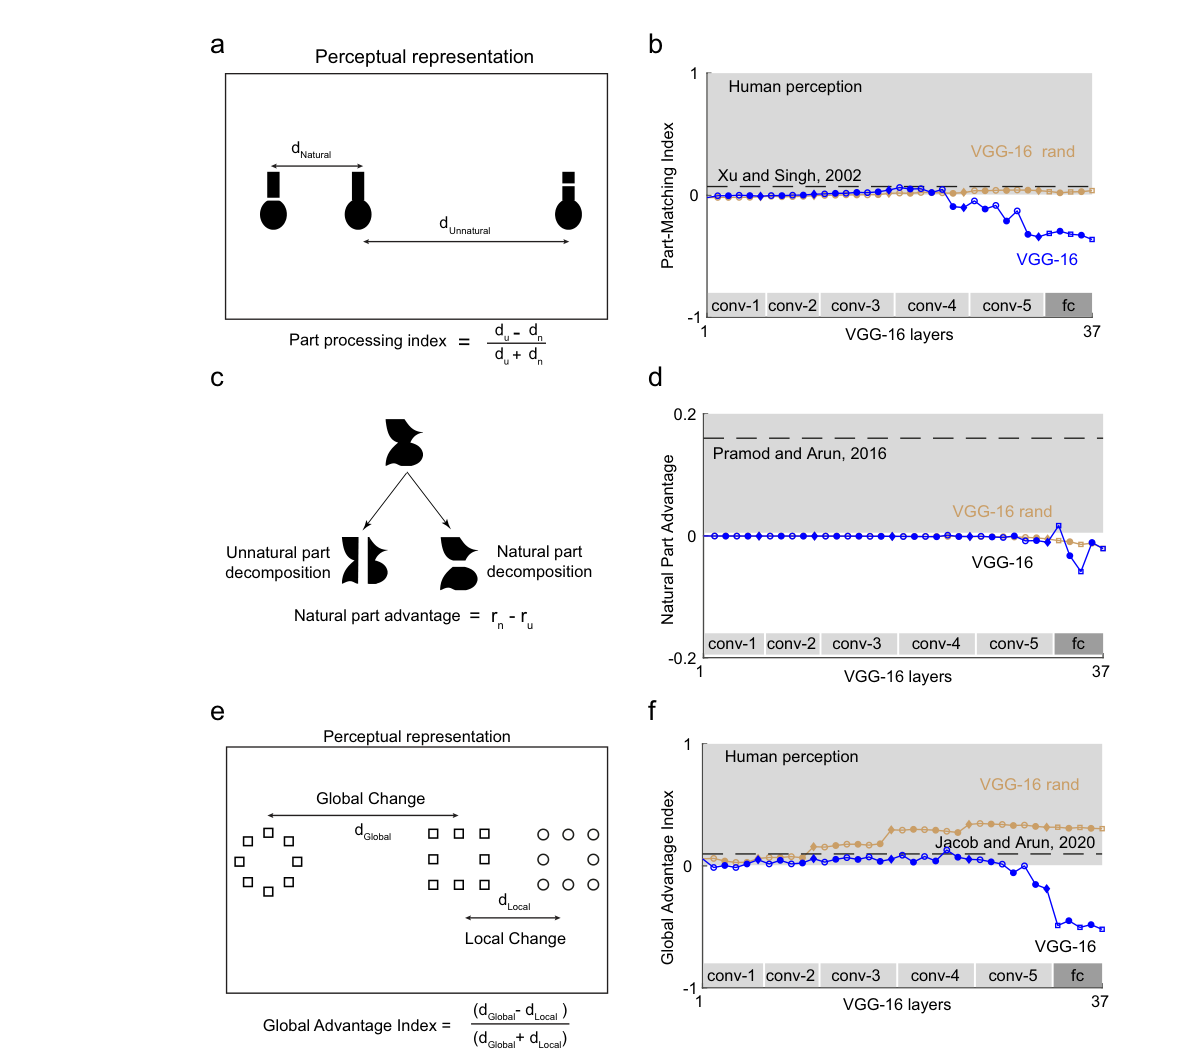
部件与全局结构缺席甚至反转(图 6):自然切口加工指数在中间层转正、但从 conv4/conv5 起变负(训练使然);自然部件优势除 conv5/fc 层短暂出现外几乎为零,随机网络类似;全局优势指数在 VGG-16 早期层略正、晚期层摆向负端(局部优势),随机网络却有清晰的全局优势。作者猜测局部优势源于 ImageNet 内含 1000 类中约 90 类狗这类"细分类"压力。
图注解读
图 1 · 把知觉现象改写成距离命题的范式
原文图注:Fig. 1 Evaluating whether deep networks see the way we do. a In the classic Thatcher effect, when the parts of a face are individually inverted, the face appears grotesque when upright (top row) but not when inverted (bottom row). Figure credit: Reproduced with permission from Peter Thompson. b When the brain views these images, it presumably extracts specific features from each face so as to give rise to this effect. We can use this idea to recast the Thatcher effect as a statement about the underlying perceptual space. The distance between the normal and Thatcherized face is larger when they are upright compared to when the faces are inverted. This property can easily be checked for any computational model. Brain Image credit: Wikimedia Commons. c Architecture of a common deep neural network (VGG-16). Symbols used here and in all subsequent figures indicate the underlying mathematical operations perfomed in that layer: unfilled circle for convolution, filled circle for ReLu, diamond for maxpooling and unfilled square for fully connected layers.
(a) 撒切尔效应的经典演示:部件各自倒置的脸正立时怪诞、整体倒置时正常。(b) 把该现象翻译成知觉空间中的距离命题:正立时正常脸与撒切尔化脸的距离 dUpright 大于倒立时的 dInverted——任何模型都能验算。(c) VGG-16 架构图,并规定了后续所有图例:空心圆=卷积、实心圆=ReLU、菱形=最大池化、空心方块=全连接(空心为线性操作、实心为非线性)。(d) 提出逐层提问方式:某一层是否"看见"撒切尔效应。这张图是全篇方法论的模板,后面每个实验都是同一套"刺激→逐层距离→指数"的变奏。
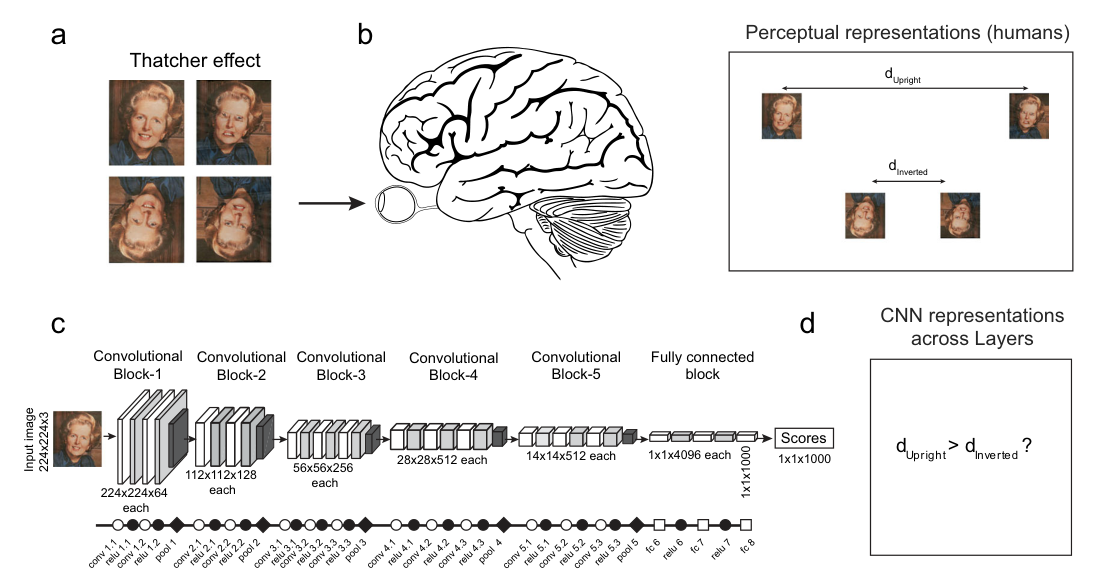
图 2 · 物体与场景统计规律:撒切尔效应、镜像混淆与场景不协调
原文图注:Fig. 2 Object and scene regularities in deep networks. a Perceptual representation of normal and Thatcherized faces in the upright and inverted orientations. b Thatcher index across layers of deep networks. For deep networks, we calculated the Thatcher index using Thatcherized faces from a recently published Indian face dataset (see the "Methods" section) across layers for the VGG-16 (blue), VGG-face (red), and a randomly initialized VGG-16 (brown). Error bars indicate s.e.m. across face pairs (n = 20). The grey region indicates human-like performance. Dashed lines represent the Thatcher index from a previous study14, measured on a different set of faces (see the "Methods" section). c Neural representation of vertical and horizontal mirror images. Vertical mirror image pairs are closer tha
(a) 知觉空间示意:正立时两类脸分得开、倒立时靠近。(b) 三条逐层曲线——蓝(VGG-16)、红(VGG-face)、棕(随机 VGG-16),灰色带为人类水平,虚线为前人研究的指数值;读图关键在末层:VGG-face 保持高位、VGG-16 转弱负、随机网络贴零。(c)(d) 镜像混淆:竖直镜像对在神经表征中更近(正指数),VGG-16 指数逐层上升、随机网络无此趋势,虚线为猴 IT 神经元参照(Rollenhagen & Olson 2000)。(e)–(g) 场景不协调:以斧头(hatchet)为例,协调背景(森林)中正确类别概率为0.6;不协调背景(超市)中斧头概率降至0.0005。可附注原论文Fig. 2图注疑似误置了两种背景标签。(top 猜测变成鞋店、杂货店等);(f) VGG-16 的 Top-5/Top-1 准确率在协调与不协调场景间的下降(星号显著性按二项分布计算),(g) 两项人类研究在同批场景上的降幅更小。此图支撑"主要结果"第 2、3 条。图注在 "Vertical mirror image pairs are closer tha" 处截断。
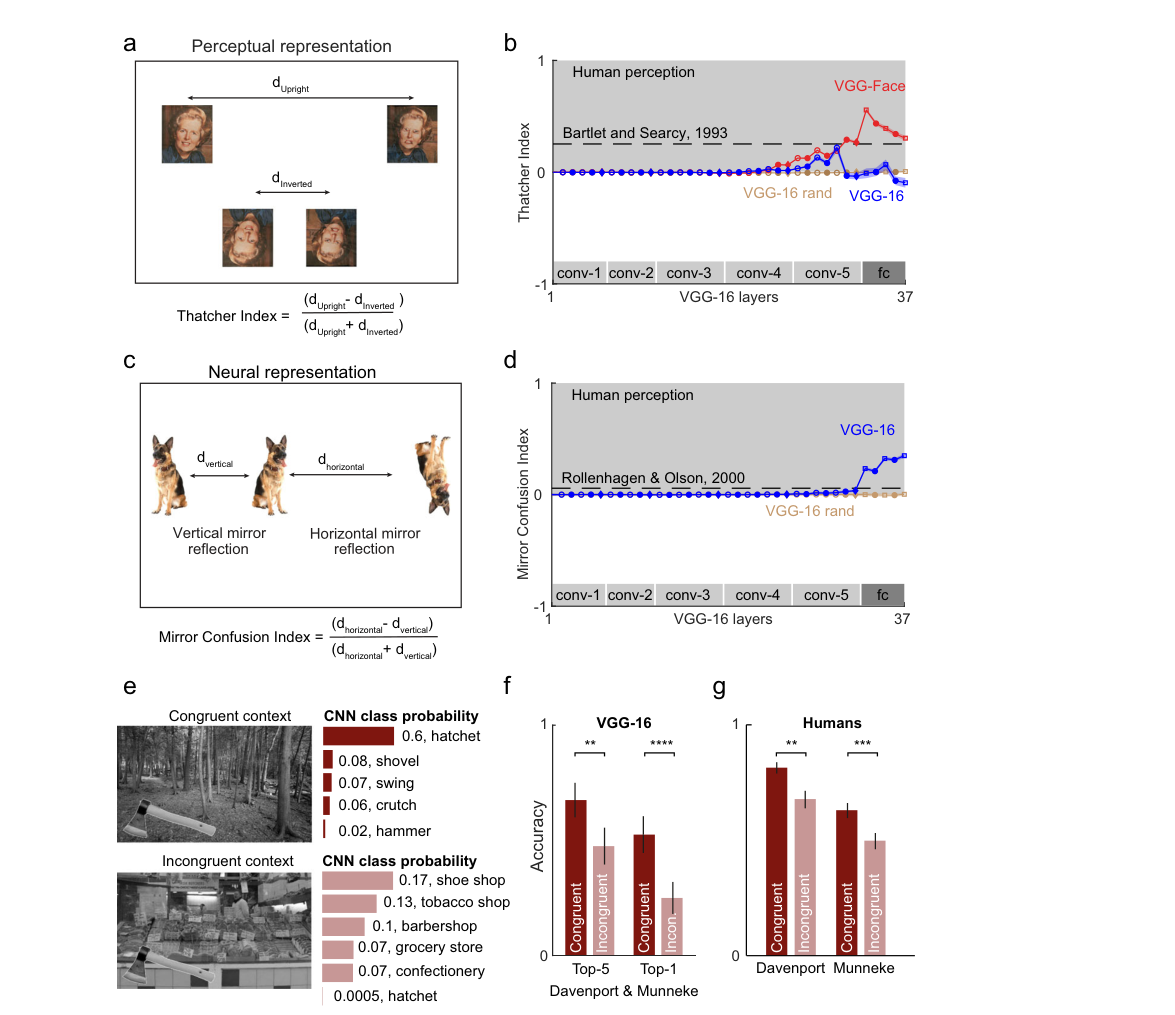
图 3 · 单元性质:多物体归一化与相关稀疏性
原文图注:Fig. 3 Single unit properties of deep networks. a Schematic illustrating the general principle observed in neurons in high-level visual areas of the brain. The response of a neuron to multiple objects is typically the average of its responses to the individual objects at those locations. b Response to multiple-object displays plotted against the sum of the individual object responses for two-object displays (black) and three-object displays (red), across 10,000 units randomly selected from Layer 37 of the VGG-16 network. c Normalization slope plotted across layers for two object displays (blue) and three-object displays (brown) for the VGG-16 network and a randomly initialized VGG-16 (brown). The dashed lines depict the slopes observed in monkey IT neurons using a different stimulus set21.
(a) 高级视觉区的一般原则:神经元对多物体的响应约为各位置单物体响应的平均。(b) 第 37 层 1 万个单元的散点图:横轴为单物体响应之和,纵轴为多物体显示的实际响应,双物体(黑)拟合斜率 0.60、三物体(红)0.42——斜率小于 1 即归一化,接近 1/2 与 1/3 即除法归一化。(c) 斜率逐层变化:VGG-16 随层下降逼近猴 IT 的虚线水平;随机网络的"完美 0.5"需结合正文解读——其激活跨图像高度相关、无选择性,属于平凡斜率。(d)–(f) 相关稀疏性:参考形状集与形变线(如骆驼—猫的渐变形)上的稀疏度跨单元相关(e)在所有层都高;纹理稀疏度与形状稀疏度的相关(f)在 conv5/fc 转正;两图中随机网络甚至更强,虚线为猴 IT 参照。此图支撑"主要结果"第 4 条。
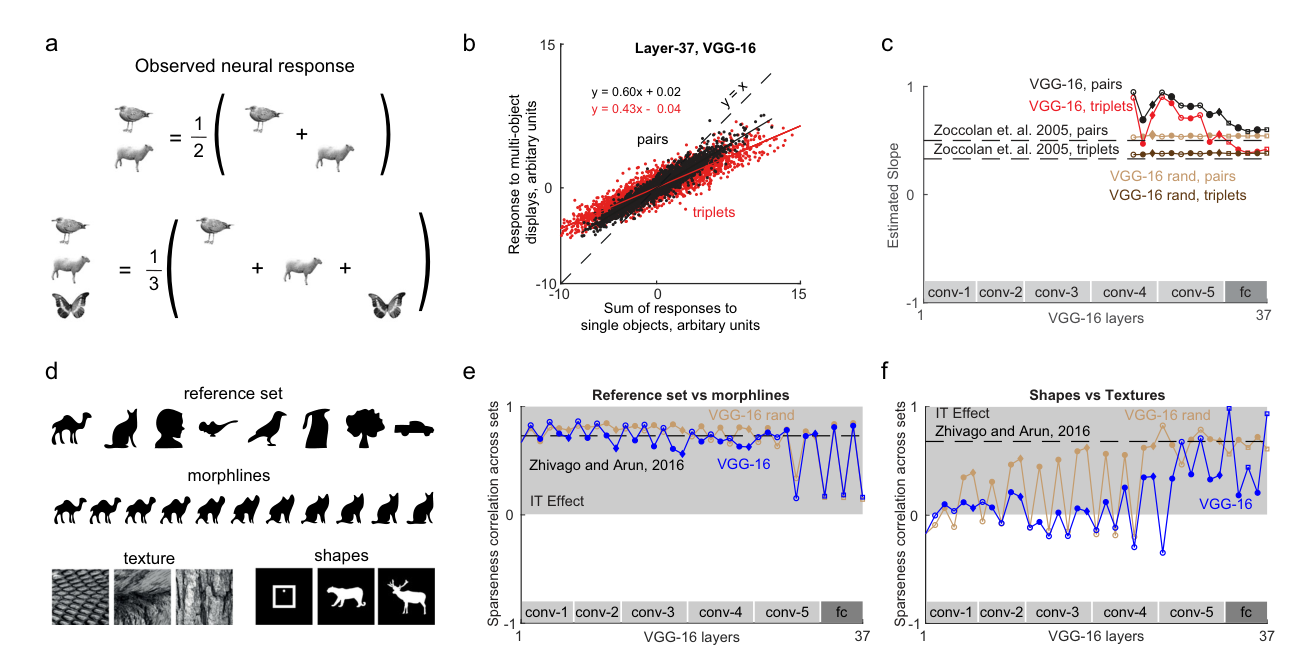
图 4 · 关系性性质:韦伯定律、相对大小与表面不变性
原文图注:Fig. 4 Relational properties in deep networks. a Example illustrating the Weber's law for line length. Although the original statement of Weber's law is that the just-noticeable difference in length will depend on the baseline length, previous studies have shown that it also applies to perceptual distances23. In this formulation, the perceptual distance across pairs of lines differing in length will be more correlated with relative changes in length rather than absolute changes in length. b To calculate a single quantity that measures adherence to Weber's law, we calculated the correlation between distances and relative changes in length and subtracted the correlation between distances with absolute changes in length (see the "Methods" section). A positive difference indicates adherence to Weber's law (grey region). This difference in correlation is plotted across layers for line length in VGG-16 (blue) and a VGG-16 with random weights (brown). The dashed line indicates the value observed during human performing visual search on the same stimuli.
(a) 线段长度的韦伯定律:知觉距离更跟随相对变化(ΔL/L)而非绝对变化(ΔL),示例用 L 与 2L 的对比说明同一绝对差对应不同相对差。(b) 逐层的"相对相关减绝对相关"曲线:VGG-16 早期层为负、后期层转正,随机网络无此趋势,虚线为人类视觉搜索参照。(c) 猴 IT 中相对大小编码示意:两部分物体协同缩放时神经距离小于不一致缩放时(指数 = (d1−d2)/(d1+d2))。(d) 相对大小指数逐层为:VGG-16 晚期层小幅为正、弱于 IT 虚线,随机网络已微弱为正。(e)(f) 表面不变性(图案与表面曲率同向变化时更相似)指数在 VGG-16 与随机网络中均持续为负——缺席。此图支撑"主要结果"第 5 条。图注在 (a)(b) 部分截断。
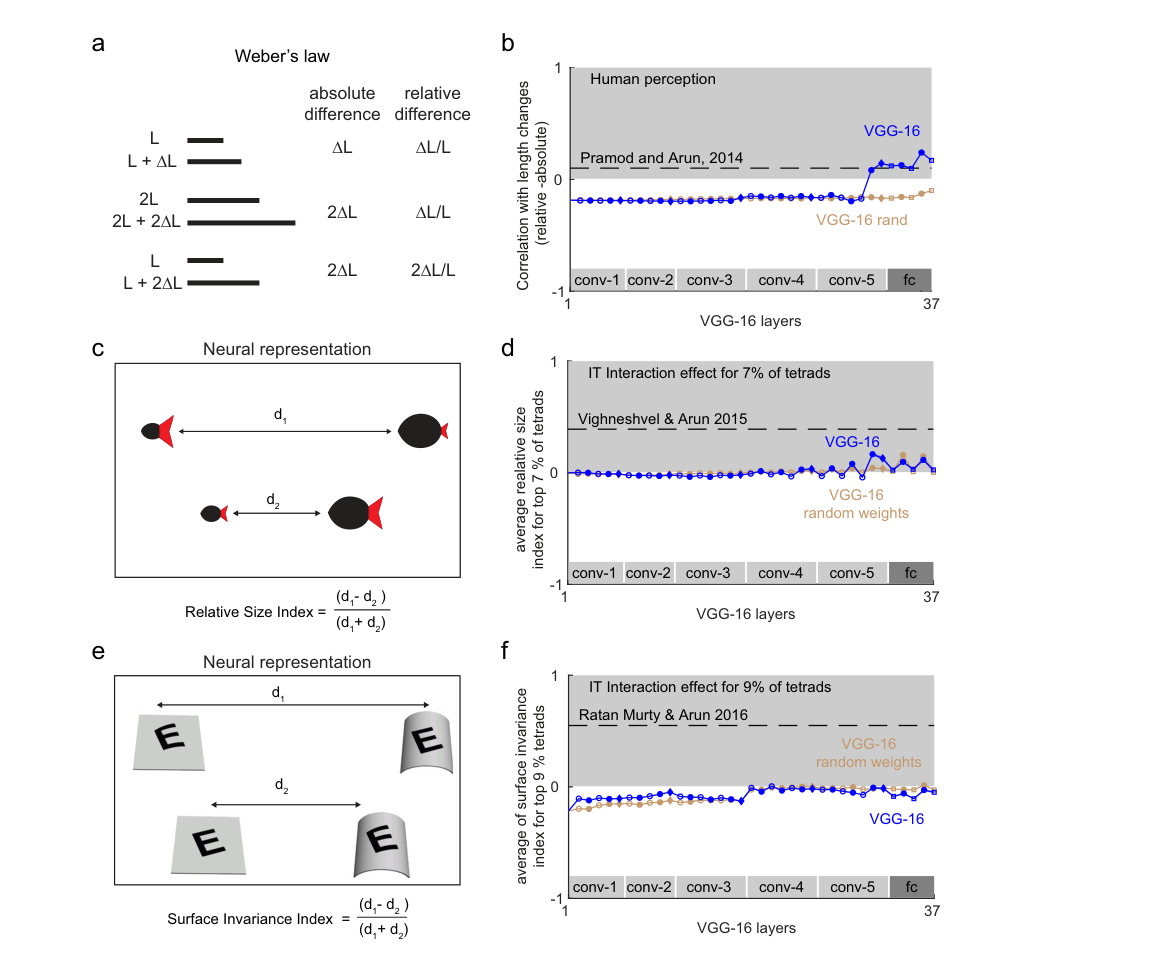
图 5 · 三维加工与遮挡:网络不具备人类的理解方式
原文图注:Fig. 5 3D processing in deep networks. a Perceptual representation of sensitivity to 3D shape27. Three equivalent image pairs are shown in perceptual space. The first image pair (with distance marked d1) consists of two cuboids at different orientations, and represents an easy visual search, i.e. the two objects are dissimilar. The second pair (marked with distance d2) contains the same feature difference as in the first pair, but represents a hard search, i.e. is perceived as more similar. Likewise, the third pair (also marked with distance d2), with the same feature difference as the first image pair, is a hard search, i.e. perceived as similar. b 3D processing index for the VGG-16 network across layers, for condition 1 (blue) and condition 2 (red), and for the VGG-16 with random weights (dark brown and light brown). Dashed lines represent the estimated human effect measured using visual search on the same stimuli.
(a) 知觉空间示意:三个图像对携带相同的二维特征差(Y 形结点差异),但含三维形状差的长方体对(d1)在人类知觉中最"远"(易搜索),两个等价二维对照对(d2)却"近"(难搜索)。(b) 3D 加工指数 = (d1−d2)/(d1+d2) 逐层曲线:VGG-16 两种条件(蓝、红)与随机网络(深、浅棕)都贴零或为负,人类虚线在正区——网络不敏感于三维形状。(c)(d) 遮挡与深度排序:方形遮挡圆盘的显示与未遮挡显示在人类知觉中相似,而与等特征差异的二维对照不同;遮挡指数 = (d2−d1)/(d2+d1) 逐层为:VGG-16 两种效应(遮挡蓝、深度排序红)持续为负但随层趋零,随机网络无上升趋势,人类虚线在正区。此图支撑"主要结果"第 5 条的"缺席"一半。
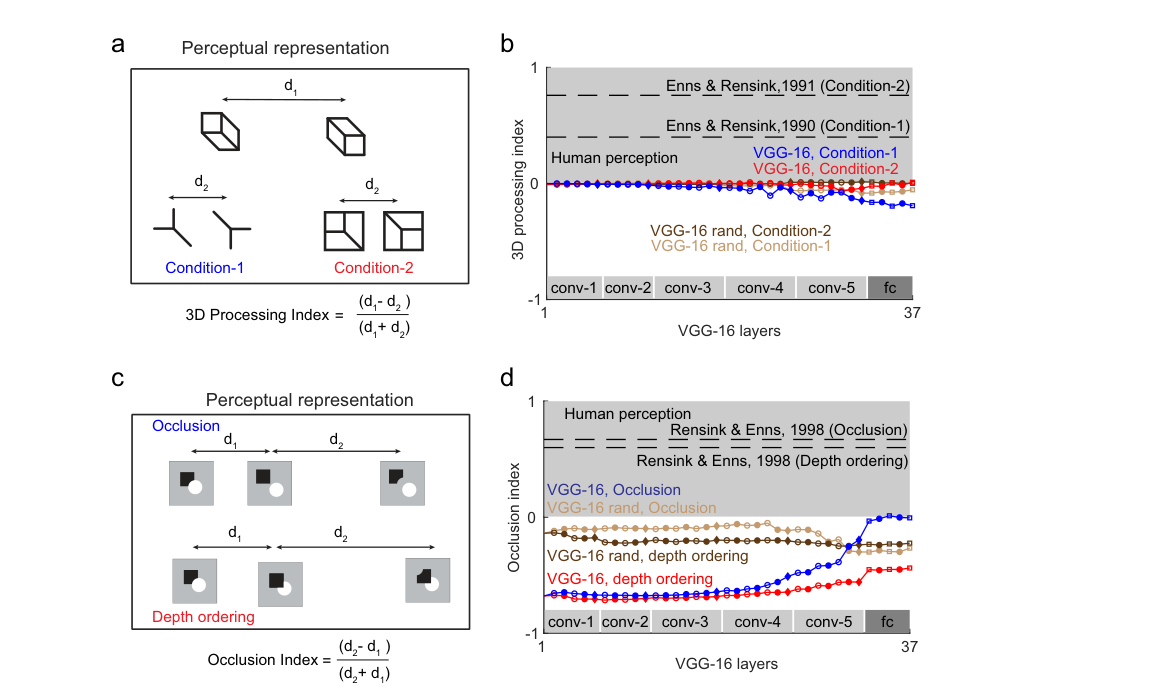
图 6 · 部件—整体关系与全局优势:训练反而抹掉全局优势
原文图注:Fig. 6 Part-whole relations in deep networks. a Schematic showing the perceptual representation of objects with a break introduced either at natural or unnatural part cuts. b Part processing index across layers of the VGG-16 network (blue) and VGG-16 with random weights (brown). The dashed line represents the effect size estimated from human visual search on the same stimuli30. c Schematic showing how the same object can be broken into either natural or unnatural parts. The natural part advantage is calculated as the difference in correlation between part-sum models trained to predict whole-object dissimilarities using the parts (see he "Methods" section). d Natural part advantage across layers of the VGG-16 network (blue) and VGG-16 with random weights (brown). The dashed line represents
(a) 断裂物体的知觉表征示意:在自然切口断开的物体与原物距离小(难搜索)、非自然切口距离大。(b) 部件加工指数逐层:VGG-16 中间层转正、conv4/conv5 之后变负,随机网络无此起伏。(c) 自然部件优势:同一物体可按自然或非自然方式分解,用部件求和模型预测整物体不相似性,r_natural − r_unnatural 即优势值。(d) 自然部件优势逐层:除 conv5/fc 短暂为正外基本贴零,随机网络类似。(e) 层级刺激示意:左、中两图只差全局形状,中、右两图只差局部形状;全局优势指全局变化比局部变化更显著。(f) 全局优势指数逐层:VGG-16 初层略正、晚期层转为负端(局部优势),随机网络反而有清晰的全局优势;虚线为人类视觉搜索参照(正区)。此图支撑"主要结果"第 6 条。图注在虚线说明处截断。
讨论
作者把发现归入三类并分别给出解释。随机网络就具备的性质(相关稀疏性、相对大小、全局优势)说明架构本身即可产生有用的特征,这与"随机权重网络也能生成有效特征"以及"随机初始化网络即可预测人类早期 MEG 响应"的报道一致。训练后出现的性质中,韦伯定律最令人意外——识别物体为何需要对相对变化敏感?作者猜测这是尺寸、位置、视角、光照不变性的副产品:所有特征都要相对周围特征来处理。场景不协调比人类更重则提示网络过度依赖语境、对局部特征失配敏感,这与 ImageNet 训练的网络有纹理偏置(Geirhos et al.)、场景中新增物体会造成分类大扰动、人类期望可以提升网络识别等证据串成一条线:网络的"局部性"是它scene不协调过重、全局优势反转、甚至易受对抗攻击的共同根源。缺席的性质(3D 形状、表面不变性、遮挡、部件、全局优势)则暗示这些能力可能需要额外的任务需求(评价三维形状、部件识别、全局形状识别)才能涌现。作者正面回应了两个质疑:用人工刺激测试是合理的,因为人类对同样的人工图形也表现出这些效应;专门训练网络去表现某性质再测它则陷入循环。改进方向上,作者列了多任务训练、无监督学习、把人类知觉表示注入网络、以及训练导航或物体交互等任务几条路,并大胆猜测"让网络展现本清单所有性质"或许还能缓解对抗样本的脆弱性。局限方面,作者明确结论只适用于物体分类训练的前馈网络,且对若干现象"中间层出现、末层消失"尚无充分解释(类比脑中 V4 可能保留不在输出端呈现的中间性质),这一点作者坦言需要后续研究。
一句话总结
这份"现象有无清单"的巧妙之处在于把"网络像不像大脑"从整体拟合分数拆成了一张可逐项核对的表——我的读后判断是:随机网络自带全局优势和稀疏性约束、训练又给了它镜像混淆和韦伯定律,唯独三维与部件这类需要"理解"的性质完全缺席,说明当前监督分类任务本身不足以长出这些结构,这与 Kar/DiCarlo 那类"加循环"的路线是互补的两种改进方向。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[A] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'md_section': '讨论', 'current_text': '网络的“局部性”是它scene不协调过重、全局优势反转、甚至易受对抗攻击的共同根源。', 'problem': '论文仅将局部特征依赖视为场景不协调和对抗脆弱性的可能解释,并未通过干预或中介分析证明共同因果机制。场景结果也是相关性和跨研究比较,不能建立因果。', 'classification': 'OVERCLAIM', 'recommended_fix': '改为“这些现象与网络对局部特征的偏重相一致;作者推测这种偏重可能同时参与场景不协调、局部优势和部分对抗脆弱性,但本文没有直接检验其因果关系。”'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'md_section': '一句话总结', 'current_text': '唯独三维与部件这类需要“理解”的性质完全缺席,说明当前监督分类任务本身不足以长出这些结构。', 'problem': '“需要理解”是拟人化解释;实验只表明所测前馈网络、训练条件和末层判据未产生人类样效应,不能推出所有监督分类任务本身都不足。', 'classification': 'OVERCLAIM', 'recommended_fix': '改为“在所测ImageNet监督训练的前馈网络及作者采用的末层判据下,三维加工和系统性部件分解未呈现人类样效应,提示仅靠这些训练条件尚不充分。”'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'md_section': '研究背景', 'current_text': '直接训练网络去完成某个任务再比较没有意义——只有网络学不会才算信息。', 'problem': '原文的意思是,若网络被直接训练产生目标性质,那么成功出现该性质具有循环性、解释力有限;并非训练后比较完全没有意义,也并非只有失败才提供信息。', 'classification': 'OVERCLAIM', 'recommended_fix': '改为“若直接以某性质作为训练目标,训练后成功复现该性质的解释力有限;相较之下,未经针对性训练而自发出现或持续缺失更能约束其充分条件。”'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_004', 'md_section': '一句话总结', 'current_text': '这与 Kar/DiCarlo 那类“加循环”的路线是互补的两种改进方向。', 'problem': '这是解读者提出的外部综合判断,不是本文直接检验的结果。本文只引用循环网络工作作为可能的架构改进背景,没有比较循环与任务约束两条路线的互补性。', 'classification': 'INTERPRETATION', 'recommended_fix': '若保留,应明确标为“解读者推测”,并说明本文没有测试循环网络。'} -> 评注:
- 补充要点: : (第 页)
- 补充要点: : (第 页)
- 补充要点: : (第 页)
- 补充要点: : (第 页)