这是一篇立场鲜明的领域综述(Perspective):作者把"视觉客体识别"问题收窄为核心客体识别(core object recognition)——在 200 毫秒以内、无任何预提示的条件下,跨越位置、尺寸、视角等保持身份的外观变化认出物体——并主张灵长类脑以一串大体前馈(feedforward)、反射式的计算级联解决这个问题,其终点是下颞叶(inferior temporal cortex,IT)中一个强大的群体表征。文章的价值不在于给出答案,而在于把"未知"精确化:作者提出,理解这套算法需要用神经与心理物理数据在大量可实例化的计算模型中做系统筛选,而每个模型都应由具有共同功能目标的小型规范子网络搭建。
研究背景
识别一张脸、一个杯子看起来毫不费力,但这种轻松掩盖了计算上的浩大:我们要在数万个可能的物体中检出并分类,且在远小于一秒内完成——行为反应时在猴约 250 ms、人约 350 ms,图像可以快到每张不足 100 ms 连续呈现,人的诱发电位在 150 ms 内已携带类别信息。问题之所以难,在于不变性问题(invariance problem):同一物体几乎每次相遇都在视网膜上产生完全不同的激活模式,位置、尺度、姿态、光照、背景杂波乃至类内形状变化都会改变输入,而视觉系统必须把这些"身份保持变换"下的响应模式判为等价,同时不把它们与其他物体的图像混淆。对工程师而言,如果没有不变性需求,问题会退化成模板匹配——那样的机器早已远超人类视觉;正因为存在不变性,识别才成为难题,而且它是计算机视觉系统的主要绊脚石。
当时已知的是:腹侧视觉流(ventral visual stream,V1→V2→V4→IT 的皮层层级)承载着核心识别的关键回路——前部区域尤其是 IT 的损伤或失活造成复杂物体分辨的选择性缺陷,IT 神经元的电刺激可预测地偏置知觉报告,人侧的同源区域(可能在外侧枕叶皮层 LOC 周围)损毁亦然。但两个深层缺口悬而未决:其一,IT 表征的"算法"是什么——究竟是逐级串行添加处理能力的流水线,还是需要区间反馈的层级贝叶斯推断机构?其二,IT 单个神经元的响应高度异质、难以建模,研究者长期停留在为各种"看起来像探测器"的神经元讲故事的水平,缺少一个能把单神经元、群体表征与行为连起来的中间抽象层。此外,基准测试没有共识,人机成绩差距无法客观度量——这些正是本文要梳理并给出路线图的地方。
研究思路
作者的论证骨架是一个"现象—机制"的层级链条:行为现象(核心识别的成功)由下一层的机制解释(IT 群体尖峰编码),而该机制本身又是在更下层(神经元连接、胞内事件)需要解释的现象。由此综述分四步走:先定义行为现象(第 1 节),再综述 IT 群体表征与单神经元性质这两层已知现象(第 2 节),然后推测腹侧流如何用结构与可塑性产生这个表征(第 3 节),最后列出缺失环节与研究路线(第 4 节)。
贯穿全文的核心概念工具是几何化的"流形"语言:把群体对一张图像的响应视为以神经元数为维度的响应空间中的一个点,同一物体在所有身份保持变换下的响应点构成一个低维曲面——物体身份流形(object identity manifold);早期视觉区的流形高度弯曲、彼此缠绕(像揉成一团的纸),识别的解就是沿腹侧流逐级"再表征",把各物体流形展平、分开(untangling,解缠),使得一个简单超平面——即对各神经元响应的加权和加阈值——就能把目标流形与其余分开。作者强调这个视角的关键推论:信息在传播中不是被"创造"(那不可能),而是被"重排格式",使物体身份信息对简单的加和解码变得显式;它还把研究重心从异质单神经元的"仅仅如此"故事,转向回答"每个视觉区把表征解缠到什么程度"。作者用一个类比点明方法论:要理解飞行应研究空气动力学,而不是研究羽毛。
方法
作为综述,本文不报告新实验,但其"方法"在于对各层证据的遴选标准与概念框架。行为层面,作者把核心识别操作性地定义为:对中央视野单图快速呈现(<200 ms 有效观看)、无物体或位置预提示的两选一或命名任务,且需在位置、尺寸、姿态、背景等身份保持变换下保持成绩——既可操作化,又保留了计算难点。神经层面,证据来自四类:长期损伤研究、临时激活/失活(如 TMS、微刺激)、电生理群体解码实验(关键参照是 Hung et al., 2005 与 Rust and DiCarlo, 2010:从数百个 IT 神经元的 50 ms 时间窗放电计数出发,用简单线性分类器做交叉验证识别)、以及高分辨率 fMRI 的模式信息研究;人与猴 IT 的跨物种比较则引用了 Kriegeskorte et al. (2008) 的表征相似性结果。建模层面,作者梳理了从 Hubel & Wiesel 的简单/复杂细胞概念模型出发、经线性-非线性(linear-nonlinear,LN)模型、到带除法归一化的 NLN 模型类的编码模型谱系,以及 Fukushima 新感知机以降、以 AND 型(建选择性)与 OR 型(建容忍)交替层级堆叠的串行链判别模型;并检视这些模型在基准任务与人IT 神经数据上的表现差距。
主要结果
-
IT 群体表征足以支撑核心识别,且是"显式"的(图 4E)。约几百个 IT 神经元的放电计数做简单加权和,交叉验证识别成绩即接近天花板;同一解码在中等程度的位置平移(1.5°、3°)、尺度变化与有限背景杂波下几乎完美泛化,被动观看、未经训练的物体亦然。IT 群体的解码能力显著强于腹侧流更早阶段(V1、V4),也强于同级背侧流区域对物体形状的编码;在文中所引研究测试的任务、刺激和变换范围内,IT群体解码成绩超过了所比较的人工视觉系统,并且似乎足以解释一系列人类不变物体识别行为。
-
时间尺度上,IT 用约 50 ms 的速率码工作(图 4A)。光子入眼约 100 ms 后,IT 已出现第一波图像选择性活动;取刺激呈现后约 100–150 ms 的第一个 50 ms 时间窗的放电率,其携带的物体身份信息不亚于更长的窗,将主要结果第2条相关表述改为:IT在刺激出现后约100–150 ms的首个约50 ms响应窗内,已提供可靠的物体身份信息。已有研究发现,将发放模式细分为多个小于50 ms的时间窗进行解码,相比单个约200 ms时间窗未获得显著更多的身份信息;但毫秒级群体同步是否携带额外有用信息仍未解决,需要大规模同步记录检验。这些结果支持作者采用约50 ms群体速率码作为工作假说。这构成作者"零假设"的实证基座:核心识别由大体前馈的级联、以约 50 ms 速率码表达。
-
单神经元层面,正确的关键词是"容忍"(tolerance)而非"不变性"(图 4B–D)。IT 神经元普遍宽调谐:典型神经元对许多不同图像有响应(约对 10% 的图像强响应、被其他图像抑制到自发活动以下),并不是窄选择的"探测器"或"祖母细胞";形态选择性最高的神经元恰恰对位置、尺度、对比与杂波变化最不容忍。但 IT 神经元普遍具备"容忍"这一可分离调谐性质——在位置等无关变量变化时保持对物体的相对偏好次序(图 4C);一个按"形状×位置"可分离调谐铺满参数空间的神经元群体,即可同时显式传递身份与位置、尺寸等信息,免去后续"捆绑"。
-
算法层面,串行链式的级联解缠是更简约的工作假说(图 3、图 6)。腹侧流各区首响应逐级滞后约 10 ms,V1 输出维度较视网膜扩增约 30 倍形成过完备表征;尽管存在"层级组织+反馈推断"(军队比喻)这一对立框架,但核心识别在约 150–200 ms 内即可完成、几乎不需要区间再入通信——不过空间上局部的快速再入(<10 ms,如归一化回路)很可能是 IT 快速响应的组成部分。作者进一步提出规范"元工作描述":皮层局部子空间解缠(cortically local subspace untangling)——每个直径约 500 μm、约 4 万神经元的局部子群体,用归一化结构、自然图像统计调参与无监督时间连续性学习三条机制,在自身小输入孔径内尽力解缠,无数局部努力的叠加即产生整个腹侧流的解缠输出(图 2C、图 5)。
-
现有模型的差距被明确量化定位(第 4 节)。Fukushima—Riesenhuber & Poggio—Serre 谱系的层级模型虽能在 20 ms 反向掩蔽条件下逼近人类,但在 100 ms 及以上呈现时远低于人类成绩,仅略优于 V1 样基线模型,混淆模式也与猴 IT 表征不符;级联 NLN 编码模型所需数据量随深度指数增长,实际上无法延伸到 V1 以外。作者由此提出四项待办:巩固"子空间解缠器"这一中间抽象层、承认算法的真解栖身于巨大的细节空间、建立可操作的基准任务、促成心理物理学—系统神经科学—计算机视觉三方协同。
图注解读
图 1 · 核心客体识别的定义
原文图注:Figure 1. Core Object Recognition. Core object recognition is the ability to rapidly (<200 ms viewing duration) discriminate a given visual object (e.g., a car, top row) from all other possible visual objects (e.g., bottom row) without any object-specific or location-specific pre-cuing (e.g., DiCarlo and Cox, 2007). Primates perform this task remarkably well, even in the face of identity-preserving transformations (e.g., changes in object position, size, viewpoint, and visual context).
这张图把全文的研究对象画成一张"考题":上行是目标车辆在不同位置、尺寸、视角与背景下的图像,下行是必须与之区分的其他可能物体。读图要点在于三个约束同时成立——快速(<200 ms 观看)、无预提示、跨越身份保持变换——正是这三个约束把"识别"剥到只剩计算内核,排除了靠注意引导、眼动搜索或特定线索取巧的策略。它支撑主要结果第 1 条所界定的行为现象本身。
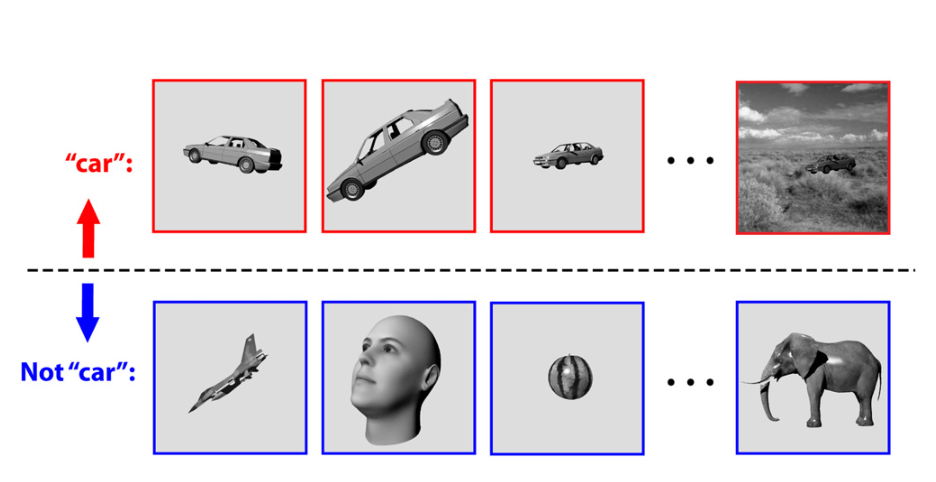
图 2 · 流形解缠的几何直觉
原文图注:Figure 2. Untangling Object Representations. (A) The response pattern of a population of visual neurons (e.g., retinal ganglion cells) to each image (three images shown) is a point in a very high-dimensional space where each axis is the response level of each neuron. (B) All possible identity-preserving transformations of an object will form a low-dimensional manifold of points in the population vector space, i.e., a continuous surface (represented here, for simplicity, as a one-dimensional trajectory; see red and blue lines). Neuronal populations in early visual areas (retinal ganglion cells, LGN, V1) contain object identity manifolds that are highly curved and tangled together (see red and blue manifolds in left panel). The solution to the recognition problem is conceptualized as a series of successive re-representations along the ventral stream (black arrow) to a new population representation (IT) that allows easy separation of one namable object's manifold (e.g., a car; see red manifold) from all other object identity manifolds (of which the blue manifold is just one example).
这张图是全文的概念心脏。A 面板说明群体响应是高维空间中的点,每根轴是一个神经元的响应量;B 面板左半:同一物体(如红色流形)在所有身份保持变换下的响应点连成一条低维曲面,早期视觉(视网膜节细胞、LGN、V1)的各物体流形弯曲且互相缠绕,任何简单超平面都切不开;右半:沿腹侧流逐级再表征(黑箭头)后,IT 中的流形被展平、彼此分离,一条虚线(超平面)即可把红色流形与其他流形分开。C 面板补上学习的来源:绝大多数自然经验图像没有标签(黑点),但同源图像在时间上相邻(灰箭头)——腹侧流利用这种隐式的时间连续性指引来构建 IT 容忍,作者将其猜想为"皮层局部子空间解缠"策略,并指出"形状编码"并非显式目标,形状信息只是时间连续性线索未规定的残余自然图像变化。此图支撑主要结果第 3、4 条的概念框架。
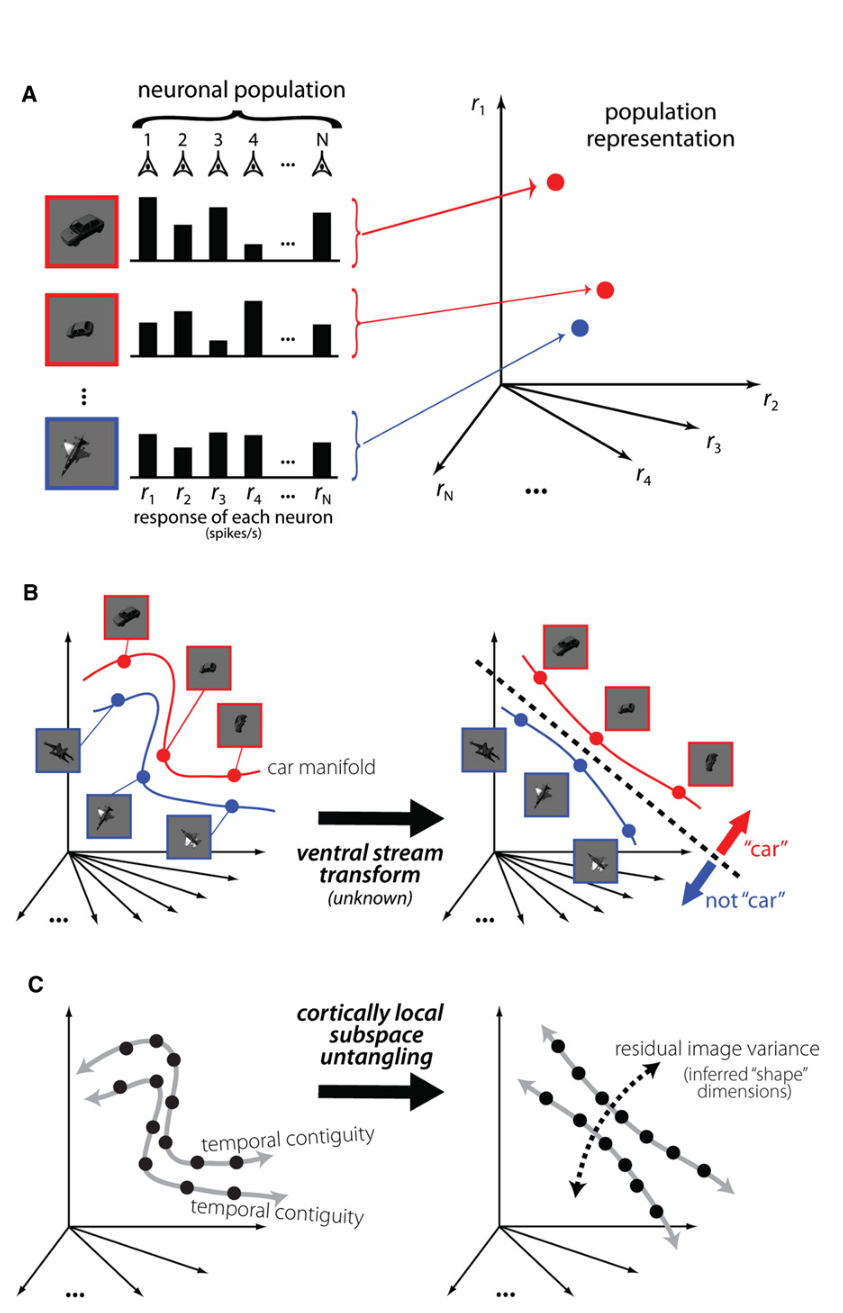
图 3 · 腹侧视觉通路的解剖账本
原文图注:Figure 3. The Ventral Visual Pathway. (A) Ventral stream cortical area locations in the macaque monkey brain, and flow of visual information from the retina. (B) Each area is plotted so that its size is proportional to its cortical surface area (Felleman and Van Essen, 1991). Approximate total number of neurons (both hemispheres) is shown in the corner of each area (M = million). The approximate dimensionality of each representation (number of projection neurons) is shown above each area, based on neuronal densities (Collins et al., 2010), layer 2/3 neuronal fraction (O'Kusky and Colonnier, 1982), and portion (color) dedicated to processing the central 10 deg of the visual field (Brewer et al., 2002). Approximate median response latency is listed on the right (Nowak and Bullier, 1997; Schmolesky et al., 1998).
A 面板标出猕猴脑上腹侧流各区的位置与信息流向(视网膜→LGN→V1→V2→V4→IT);B 面板把各区画成面积正比于皮层表面积的方块,角落标注神经元总数(百万计),上方标注表征维度(投射神经元数,按神经元密度、2/3 层占比与中央 10° 视野分配推算),右侧列出各区近似中位响应潜伏期。读图重点是三个数量事实:视网膜到 LGN 维度收缩、V1 输出维度扩增约 30 倍形成过完备表征、各区潜伏期逐级滞后约 10 ms——这些数字把"层级串行架构"从定性叙述变成可检验的定量约束,支撑主要结果第 4 条。
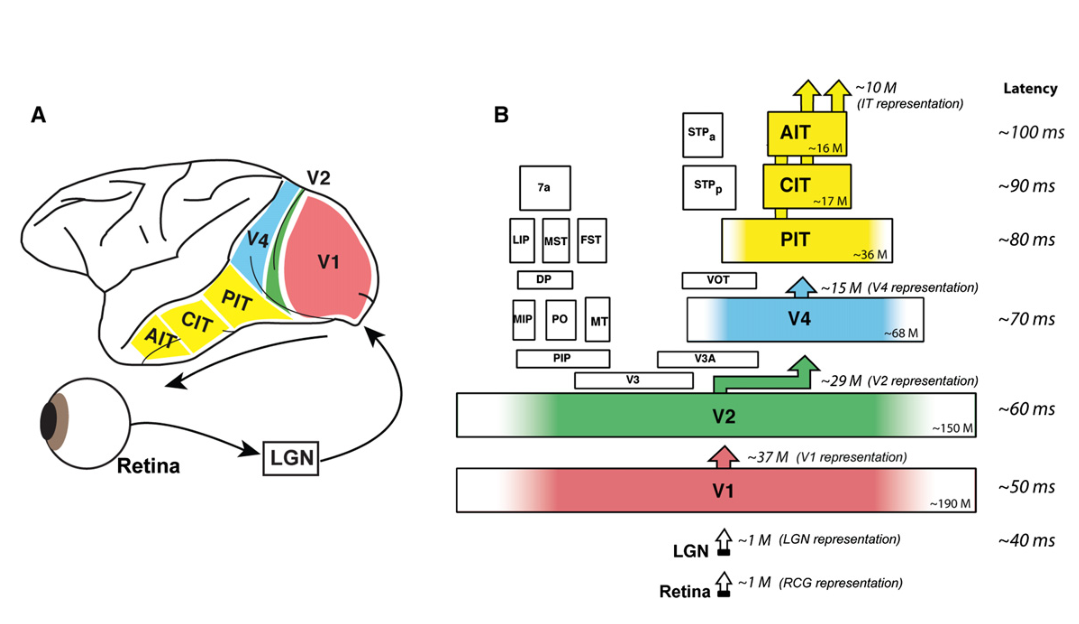
图 4 · IT 单神经元性质及其与群体成绩的关系
原文图注:Figure 4. IT Single-Unit Properties and Their Relationship to Population Performance. (A) Poststimulus spike histogram from an example IT neuron to one object image (a chair) that was the most effective among 213 tested object images (Zoccolan et al., 2007). (B) Left: the mean responses of the same IT neuron to each of 213 object images (based on spike rate in the gray time window in A). Object images are ranked according to their effectiveness in driving the neuron. As is typical, the neuron responded strongly to ~10% of objects images (four example images of nearly equal effectiveness are shown) and was suppressed below background rate by other objects (two example images shown), with no obvious indication of what critical features triggered or suppressed its firing.
A 面板是一个 IT 神经元对 213 张物体图像中最有效的椅子图像的刺激后直方图,灰色时间窗即解码窗;B 面板把同一神经元对 213 张图的平均响应按驱动效力排序——典型地,只对约 10% 的图像强响应(红色),对另一些图像抑制到背景以下(绿色),且看不出是什么关键特征触发或抑制了发放,直观展示"宽调谐、难以自下而上建模"的困境。C 面板改变物体在视野中的位置(纵坐标),三个效力不同的物体的响应幅度在变,但偏好排序在整个测试范围内保持——这正是"容忍"的直接展示;D 面板给出概念解释:每个 IT 神经元对"形状(身份)× 无关变量(如位置)"具有联合可分离的调谐面,群体铺满该空间后即同时传递身份与位置信息;E 面板用线性分类器直接检验:群体识别成绩随神经元数增加迅速逼近天花板(左),且对位置平移与尺度变化泛化近乎完美(右),与 Hung et al. (2005) 的实测一致。此图支撑主要结果第 1、2、3 条。
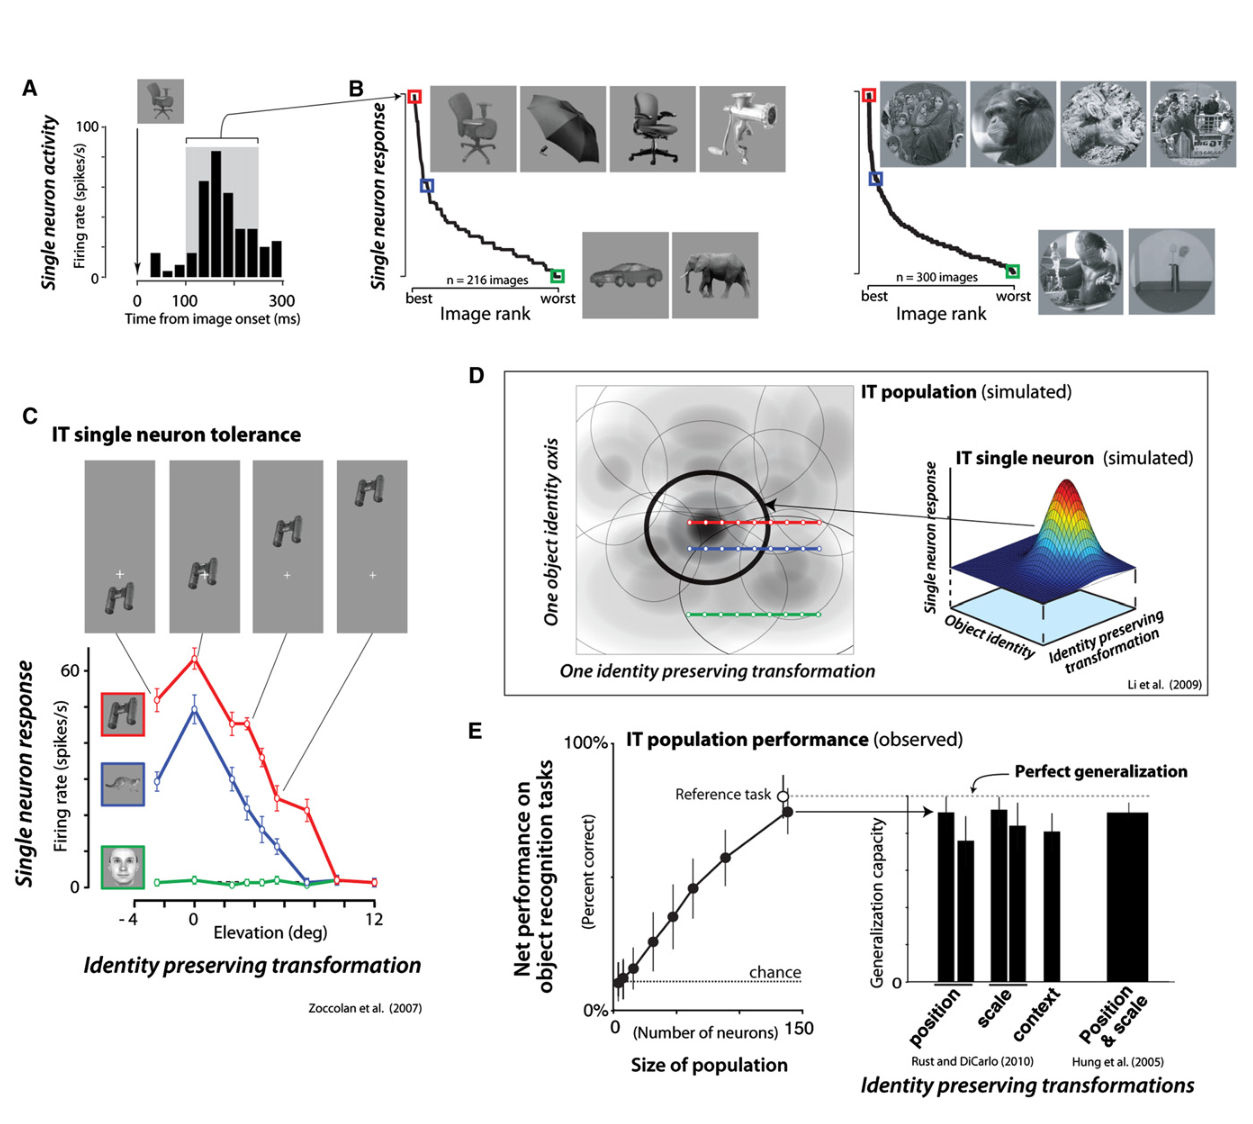
图 5 · 抽象层级及其可能的连接
原文图注:Figure 5. Abstraction Layers and Their Potential Links. Here we highlight four potential abstraction layers (organized by anatomical spatial scale) and the approximate number of inputs, outputs, and elemental subunits at each level of abstraction (M = million, K = thousand). We suggest possible computational goals (what is the 'job' of each level of abstraction?), algorithmic strategies (how might it carry out that job?), and transfer function elements (mathematical forms to implement the algorithm). We raise the possibility (gray arrow) that local cortical networks termed 'subspace untanglers' are a useful level of abstraction to connect math that captures the transfer functions emulated by cortical circuits (right most panel), to the most elemental type of population transformation needed to build good object representation (see Figure 2C), and ultimately to full untangling of object identity manifolds (as hypothesized here).
这张表格式示意图自左向右按解剖尺度排列四个抽象层(全皮层级、脑区级、局部子网络级、单神经元级),每层标注输入/输出/基本亚单元数量级,并给出三行内容:计算目标(这一层"的工作是什么")、算法策略、传递函数要素(实现算法的数学形式)。读图的焦点是灰色箭头所指的中间层——"子空间解缠器"(subspace untanglers):它一端连接刻画皮层传递函数的 NLN 数学,另一端连接构建良好物体表征所需的群体变换(图 2C),最终通向完整的身份流形解缠。此图是作者"必须巩固中间抽象层"这一主张(主要结果第 5 条)的图解,也是全文最有方法论意味的一张图。
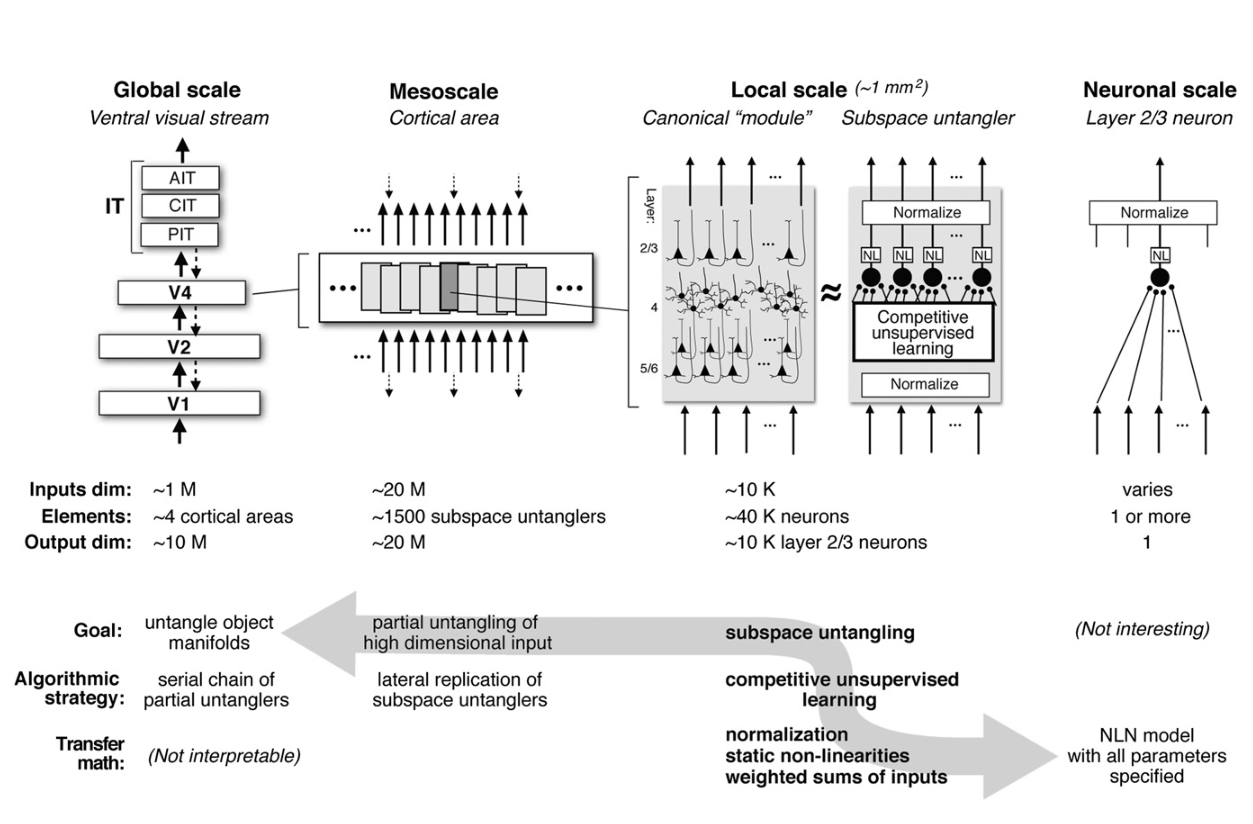
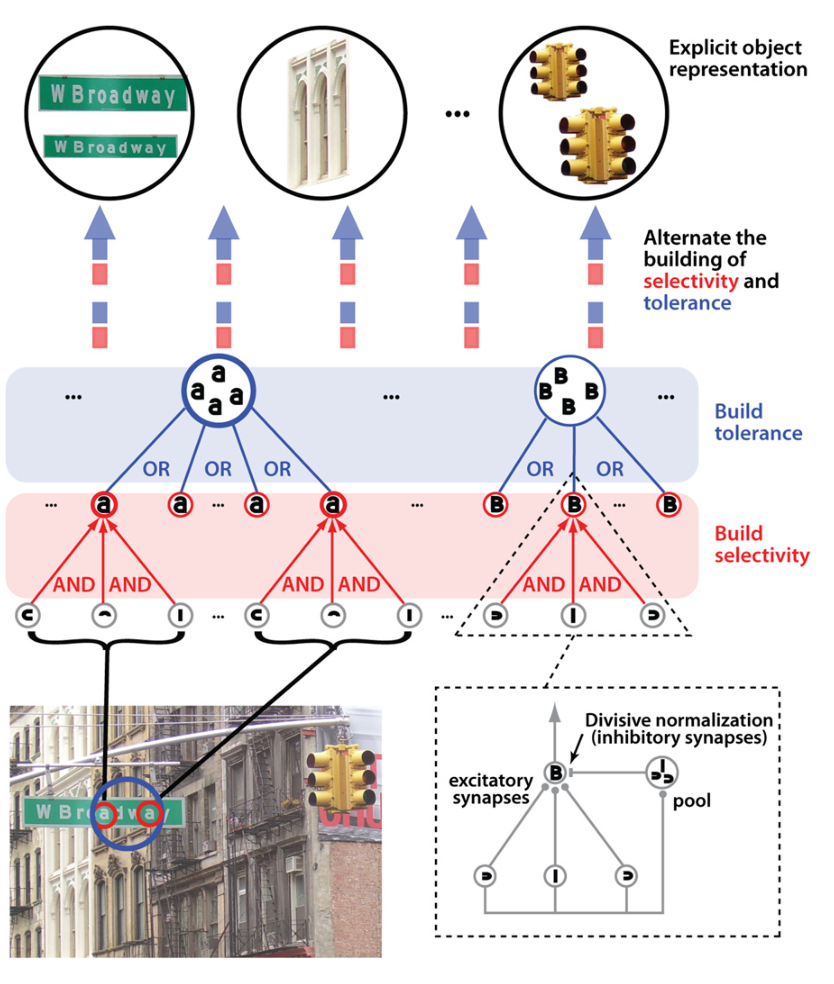
图 6 · 串行链判别模型:AND 与 OR 的交替层级
原文图注:Figure 6. Serial-Chain Discriminative Models of Object Recognition. A class of biologically inspired models of object recognition aims to achieve a gradual untangling of object manifolds by stacking layers of neuronal units in a largely feedforward hierarchy. In this example, units in each layer process their inputs using either AND-like (see red units) and OR-like (e.g., 'MAX,' see blue units) operations, and those operations are applied in parallel in alternating layers. The AND-like operation constructs some tuning for combinations of visual features (e.g., simple cells in V1), and the OR-like operation constructs some tolerance to changes in, e.g., position and size by pooling over AND-like units with identical feature tuning, but having receptive fields with slightly different retinal locations and sizes.
这张图把"递归应用同一规范计算"的模型家族画了出来:大体前馈的层级中,红色单元执行 AND 型运算——对视觉特征组合建立调谐(如 V1 简单细胞);蓝色单元执行 OR 型(如 MAX)运算——对调谐相同但感受野位置与尺寸略有差异的 AND 单元做池化,从而建立对位置、尺寸变化的容忍;两种运算逐层交替,容忍性沿层级渐增。关键的一笔是虚线框:AND 与 OR 都可表述为带非线性增益控制的 NLN 神经元模型变体(Kouh and Poggio, 2008),把 Fukushina 新感知机—Riesenhuber & Poggio—Serre 谱系与规范皮层模型连接起来。读图时应把它与图 5 的中间抽象层对照:这张图展示的正是"同一元工作描述被逐层实例化"的具体方案,也承载着主要结果第 5 条所检讨的成绩差距(这类模型在 20 ms 反向掩蔽下可比肩人类,但在 100 ms 以上呈现时远不及)。
讨论
作者在结尾处刻意不宣告胜利。他们承认已经理解的东西不少:计算难点(不变性)、群体编码问题(流形解缠)、解决的部位(腹侧流)、以及可能足以支撑核心识别的神经码(容忍的 IT 神经元群体上的约 50 ms 速率码);且"一大类大体前馈的功能单元(配置为 AND/OR 交替的 NLN 模型)的迭代可以近似 IT 响应、取得像样的识别成绩"也已清楚。但四道坎仍未迈过:NLN 式机制模型与群体数据重排之间缺少一个清晰的中间抽象层与连接假说;算法的成败藏在巨大的"细节"空间里——实施 AND/OR 级联的方式有成千上万种,而"这些细节不是问题的细节,理解它们就是问题本身";领域缺少公认的成绩基准,以致最先进的计算机视觉算法与"粗糙 V1 模型"在所谓真实世界测试上难分高下;三个研究共同体的激励结构各自为政。作者给出的路线图是双向并进:一条线用高通量仿真系统探索巨大的子网络算法空间并在精心设计的基准上量成绩,另一条线用迅速膨胀的神经数据与心理物理测量去筛选最能解释实验数据的算法——即用数据"筛"模型,而非用新数据"讲"新故事。
与文献的对话贯穿全文:对"IT 只是特征检测器"的传统单神经元叙事,作者以宽调谐与选择性-容忍度负相关(Zoccolan et al., 2007)反驳"祖母细胞";对层级贝叶斯反馈框架(Lee and Mumford, 2003;Friston, 2010),作者承认其在噪声、歧义与长时程任务中的地盘,但主张核心识别的时间尺度不需要区间再入;对时间连续性无监督学习,作者把它安放进"规范元工作描述"的第三条机制,并引用人工操纵时间相邻经验可快速重塑 IT 位置与尺寸容忍的证据(Li and DiCarlo, 2008, 2010;Cox et al., 2005)。文末亦不讳言:即便"局部子空间解缠"框架最终正确,也只有在把海量交互细节做对之后才能证明。
一句话总结
以我的理解,这篇综述最重要的动作是把"理解视觉识别"从描述神经元奇迹改写为一个工程问题:给出一套定义明确的基准、一个中间抽象层(子空间解缠器)和"数据筛模型"的方法论纲领。十年后回看,深度卷积网络恰好沿着这条路长成了 IT 的最好近似——这未必是作者预言的验证,但至少说明他们当时指认的搜索空间没有找错;文中"核心识别无需区间再入"的强版本零假设,则是这篇温和综述里最大胆、也最值得继续拷问的一句。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[A, B] - Fig3: 提取质量
good,对齐度full,识别面板[A, B] - Fig4: 提取质量
good,对齐度full,识别面板[A, B] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[A]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'current_text': 'IT 用约 50 ms 的速率码工作。', 'classification': 'OVERCLAIM', 'reason': '约50 ms速率码是现有证据支持的充分、简约描述,不是排除了其他编码形式后的确定机制。', 'calibrated_version': '现有结果支持约50 ms群体速率码足以承担所测试条件下的快速核心识别。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'current_text': '核心识别在约 150–200 ms 内即可完成、几乎不需要区间再入通信。', 'classification': 'INTERPRETATION', 'reason': '快速行为与首波IT活动只与少量或无区间再入相容,并未直接操纵反馈通路来证明其不必要。', 'calibrated_version': '核心识别的时间尺度与少量或无区间再入通信相容,因此作者将大体前馈级联作为简约零假设。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'current_text': '排除了靠注意引导、眼动搜索或特定线索取巧的策略。', 'classification': 'OVERCLAIM', 'reason': '快速中央呈现和无预提示大幅限制这些策略,但不能严格排除所有注意、内部状态或诊断性图像线索的贡献。', 'calibrated_version': '这些约束减少了预先注意分配、眼动搜索和位置特异策略的可用空间。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_004', 'current_text': '深度卷积网络恰好沿着这条路长成了 IT 的最好近似。', 'classification': 'OVERCLAIM', 'reason': '这是来源之外且缺少比较基准的绝对性后见判断。', 'calibrated_version': '后来的深度前馈模型与本文倡导的层级级联思路存在概念连续性;其与IT的对应程度需要后续比较研究单独论证。'} -> 评注:
- 补充要点: : (第 5 页)
- 补充要点: : (第 5 页)
- 补充要点: : (第 8 页)
- 补充要点: : (第 3 页)
- 补充要点: : (第 10 页)