这篇文章要回答一个横亘在"神经可塑性"与"人类行为学习"之间的定量问题:猴子下颞叶(inferior temporal cortex,IT)单个神经元在无监督视觉经验下发生的变化,能否解释人类看到的客体分辨行为改变?作者构建了一个完全由既有神经数据约束的端到端模型,"开箱即用"地预测了三组人类无监督暴露实验中学习效应的方向、幅度与时间进程。它值得精读,因为它把"时间连续性塑造不变性表征"这一经典假说,第一次推进到跨物种、跨测量层面(单神经元→行为)的定量检验。
研究背景
核心物体识别要求视觉系统在尺寸、位置和姿态改变时保持身份判断。IT 群体活动可以支持这类行为读出,但成年系统能够做到什么,并不直接说明它如何通过经验形成。以大量类别标签训练的人工网络提供了有效模型,却留下生物学习信号从何而来的问题。自然视觉中的时间连续性因此成为一个长期候选:相邻时刻的图像虽然外观不同,常来自同一物体,系统可能利用这种关系缩小无关变化引起的响应差异,而不必为每张图像获得明确的身份反馈。
此前的人类与猕猴研究分别支持了这条思路。心理物理实验表明,改变连续出现图像之间的身份对应,可以影响位置或姿态容忍;猴 IT 记录也发现,无监督暴露能改变细胞的位置和尺寸容忍。然而,两条证据并行并不等于已经解释了学习行为。不同研究所用任务与测量尺度不一致,单细胞选择性变化的幅度也不能直接换算成识别成绩变化。缺口在于定量连接:以既有神经数据约束的群体表征和可塑性规则,能否在不依赖学习曲线反复调参的情况下,预测新的行为效应,包括改善、破坏及其随暴露量发展的过程。
本文将生成式 IT 响应模型、时间相邻响应靠拢的可塑性规则及神经活动到识别表现的读出结合,并以相应的人类尺寸暴露实验检验预测。同身份与跨身份配对分别用来构建和破坏容忍,未暴露尺寸及对照物体则帮助区分特异学习与一般练习。这样,研究从“神经和行为都可塑”推进到“测得的神经变化是否足以预测行为变化”。但模型连接跨越物种与实验,依赖人猴表征和可塑性近似、短时程内读出相对稳定等假设;预测吻合也可能受假设误差相互抵消影响。高初始表现下的行为天花板与猜测率进一步限制检验,因此这项工作支持时间连续性对容忍学习的部分贡献,不能证明它是唯一机制或替代直接的神经因果实验。
研究思路
作者的总体策略是"用数据约束模型、用模型跨越尺度":与其在新实验里同时记录神经与行为,不如把两个尺度各自积累的数据用一个三组件模型串起来——(1) 一个生成式 IT 模型(generative IT model),从已有猴 IT 群体响应数据出发模拟任意图像下的 IT 群体活动;(2) 一个无监督可塑性规则(plasticity rule),其唯一自由参数照猴 IT 电生理数据标定,描述每次时间相邻图像暴露如何改变单个位点的放电率;(3) 一个 IT-to-behavior 链接模型(线性解码器,沿用 Majaj et al., 2015),把 IT 群体状态映射为 predicted 行为成绩。三个组件分别被既有数据锁死后一次性拼装,之后不再调参,直接预测新的人类行为实验结果。
这种设计的逻辑在于:模型各部分的参数并非来自对学习效应本身的拟合,而是分别锚定在"IT 群体响应统计"(Majaj et al., 2015)和"猴 IT 单位点可塑性"(Li and DiCarlo, 2010)两块独立数据上。这样一来,若模型能预测人类学习效应,说明这些既有的神经测量确实承载了解释行为改变的足够信息;若预测失败,则整个"IT 可塑性→核心识别行为"工作假说都需重新审视——两种结局都有信息量。为了让预测有可检验的靶子,作者还设计了与猴电生理暴露范式同名同构的人类版本实验,专门覆盖"构建"(build)与"破坏"(break)尺寸容忍两种操作及其可逆性检验。
方法
人类实验通过 Amazon Mechanical Turk 招募被试(主实验 174 人:u1=102、u2=36、u3=37;难度实验另 331 人)。实验采用"测试—暴露—测试"纵向设计:每个测试相(test phase)含 200 个试次,试次中央注视点后呈现 100 ms 测试图像(单个前景面孔叠加随机自然背景,位置/尺寸/姿态有变化),被试用鼠标二选一(2AFC)判断是哪张选择图;尺寸特异性子任务被随机混入遮挡(cover)试次中以掩饰分析意图。每个暴露相(exposure phase)含 400 个暴露事件,每个事件为两张各 100 ms、紧密相邻的图像。暴露分两种"口味":swapped(两图来自不同目标物体,预期破坏尺寸容忍)与 non-swapped(两图来自同一物体,预期构建尺寸容忍),三种实验 u1/u2/u3 分别为全程 swapped、全程 non-swapped、先 non-swapped 后 swapped。目标面孔在 big 尺寸(约 4°,基准值 2° 的两倍)暴露,同时测量未暴露的 small 尺寸与对照面孔以剔除一般学习效应;成绩用信号检测论的 d'(判断灵敏度)汇总,置信度由全试次自助法(bootstrap)给出。
建模端:生成式 IT 模型用多维高斯(multi-dimensional Gaussian,MDG)刻画 64 个物体在大群体中的偏好分布,每个模拟位点再乘以一张从 168 个真实 IT 位点拟合而来的尺寸调谐核(size-tuning kernel),并加入背景杂波方差(clutter)与试次间噪声;可塑性规则为 ΔFR_leading = α·(FR_lagging − FR_leading),即让相邻呈现图像的响应互相靠拢,α 标定为 0.0016 nru/暴露事件(约 0.035 spk/s/事件,30 个事件约变化 1 spk/s);链接模型用测试图像引发的 IT 群体响应与每类物体训练样本均值响应的相关性做最近邻判别,超参数锁定为 20 张训练图、260 个模型位点——这一组合在 24 个识别任务上与真实人初始成绩的相关达 0.83 ± 0.05。
主要结果
-
人类无监督暴露确实选择性地改变尺寸容忍行为(图 2)。u1 中目标面孔对的 big 尺寸分辨 d' 随暴露事件数下降(破坏容忍),未暴露的 small 尺寸与对照面孔几乎不变;u2 中 non-swapped 暴露使 big 尺寸 d' 上升(构建容忍);u3 先构建后破坏,效应可逆。约 800 个暴露事件后行为效应趋于饱和。三组实验的效应都只在被操纵的"物体×尺寸"组合上出现,验证了时间连续性学习在成年人身上依然强烈而特异。
-
生成式 IT 模型在二阶统计上逼真复现真实 IT(图 3)。模拟群体与真实 168 位点数据的响应距离矩阵相关达 r = 0.93 ± 0.01;用模拟群体驱动的解码器选择 260 位点/20 训练图时,24 个任务上与人初始成绩一致性 0.83 ± 0.05,与此前真实 IT 数据的拟合水平(0.868)相当,说明模型锁定的初始状态可信。
-
可塑性规则以唯一参数复现猴 IT 单位点效应(图 4)。α=0.0016 时模型预测的选择性变化轨迹与 Li and DiCarlo (2010) 的 42 个 MUA 位点均值(虚线)在 swapped、non-swapped 与 medium 尺寸三种测量上均吻合;规则还自然复现了此前报告的细微效应——swapped 暴露会反转初始选择性较低的位点(N 反超 P),non-swapped 暴露能把 medium 尺寸上的选择"搬运"到 big 尺寸形成容忍。
-
端到端模型未经调参即预测人类学习的方向、幅度与时间进程(图 5)。三个实验 u1/u2/u3 的预测线(黑)与实测线(红)都基本重合;当可塑性率改为实测值的 1/4 或 4 倍、或解码器超参数偏离"匹配人初始成绩"的流形时,预测明显偏掉——超人类的起点会高估学习效应,亚人类的起点会低估。这说明预测成功依赖真正生物学正确的参数设定,而非模型形式本身的巧合。
-
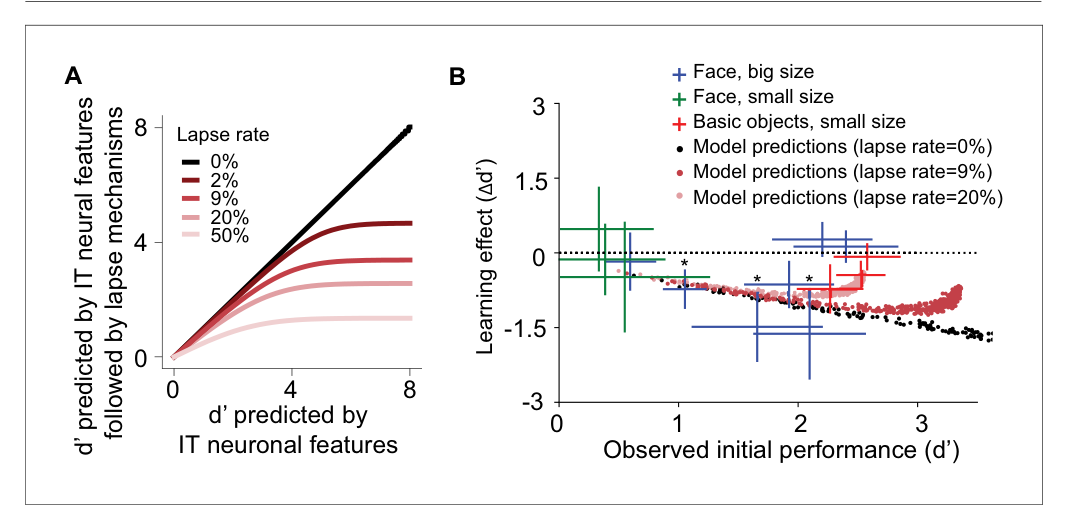
学习效应大小依赖初始任务难度,且需引入猜测率(lapse rate)才能完整解释(图 6)。把 13 个"物体×尺寸"子任务(初始 d' 覆盖 0.4–2.6,包括基本水平物体)交给 331 名新被试做 800 事件 swapped 暴露,结果显示中等初始难度(约 0.5–2.5 之间)的任务学习效应最大,过易(d'>2.5)与过难(d'<0.5)的任务效应显著缩小。模型天然预测了"过难侧"的缩小(响应差小则更新动力小),但"过易侧"需要假设模型也带约 9% 的随机猜测率——由 lapses 造成的成绩天花板(被试群体实测约 90–95% 上限)把高水平区间的表征变化掩盖在行为测量之外。
图注解读
图 1 · 实验设计与期望中的 IT 流形变化
原文图注:Figure 1. Experimental design and conceptual hypothesis. (A) Illustration of human behavioral experimental design and an example trial from the Test phase and from the Exposure phase. (B) Top: example confusion matrix for a two-way alternative forced choice (2AFC) size-specific sub-task run during each Test phase to monitor object-specific, size-specific changes in discrimination performance (see Materials and methods). Bottom: the two
这张图给出全文的骨架。A 面板画出流程:先测初始成绩,随后穿插四个暴露相再测;测试试次是看 100 ms 图选两张图之一,暴露试次是两张相邻图像连续闪现。B 面板用混淆矩阵示意每个 2AFC 子任务如何算出 d',底部展示 swapped 与 non-swapped 两种暴露事件里图像的排列(带星号的图像是暴露过的物体×尺寸组合,d' 括号标记哪些子任务进入分析:目标物在暴露尺寸=实线彩色、对照物=黑线、目标物在未暴露尺寸=虚线)。C 面板是概念假说的示意图:把同一物体在三个尺寸上的 IT 表征收束成一条"流形",natural 风格的 non-swapped 暴露会把流形拉直(构建容忍),swapped 暴露会把两条流形在交换尺寸处捏向一起(破坏容忍)。读这张图时要抓住"流形弯曲程度=可分离度"的直觉,这正是后续所有定量预测的出发点。
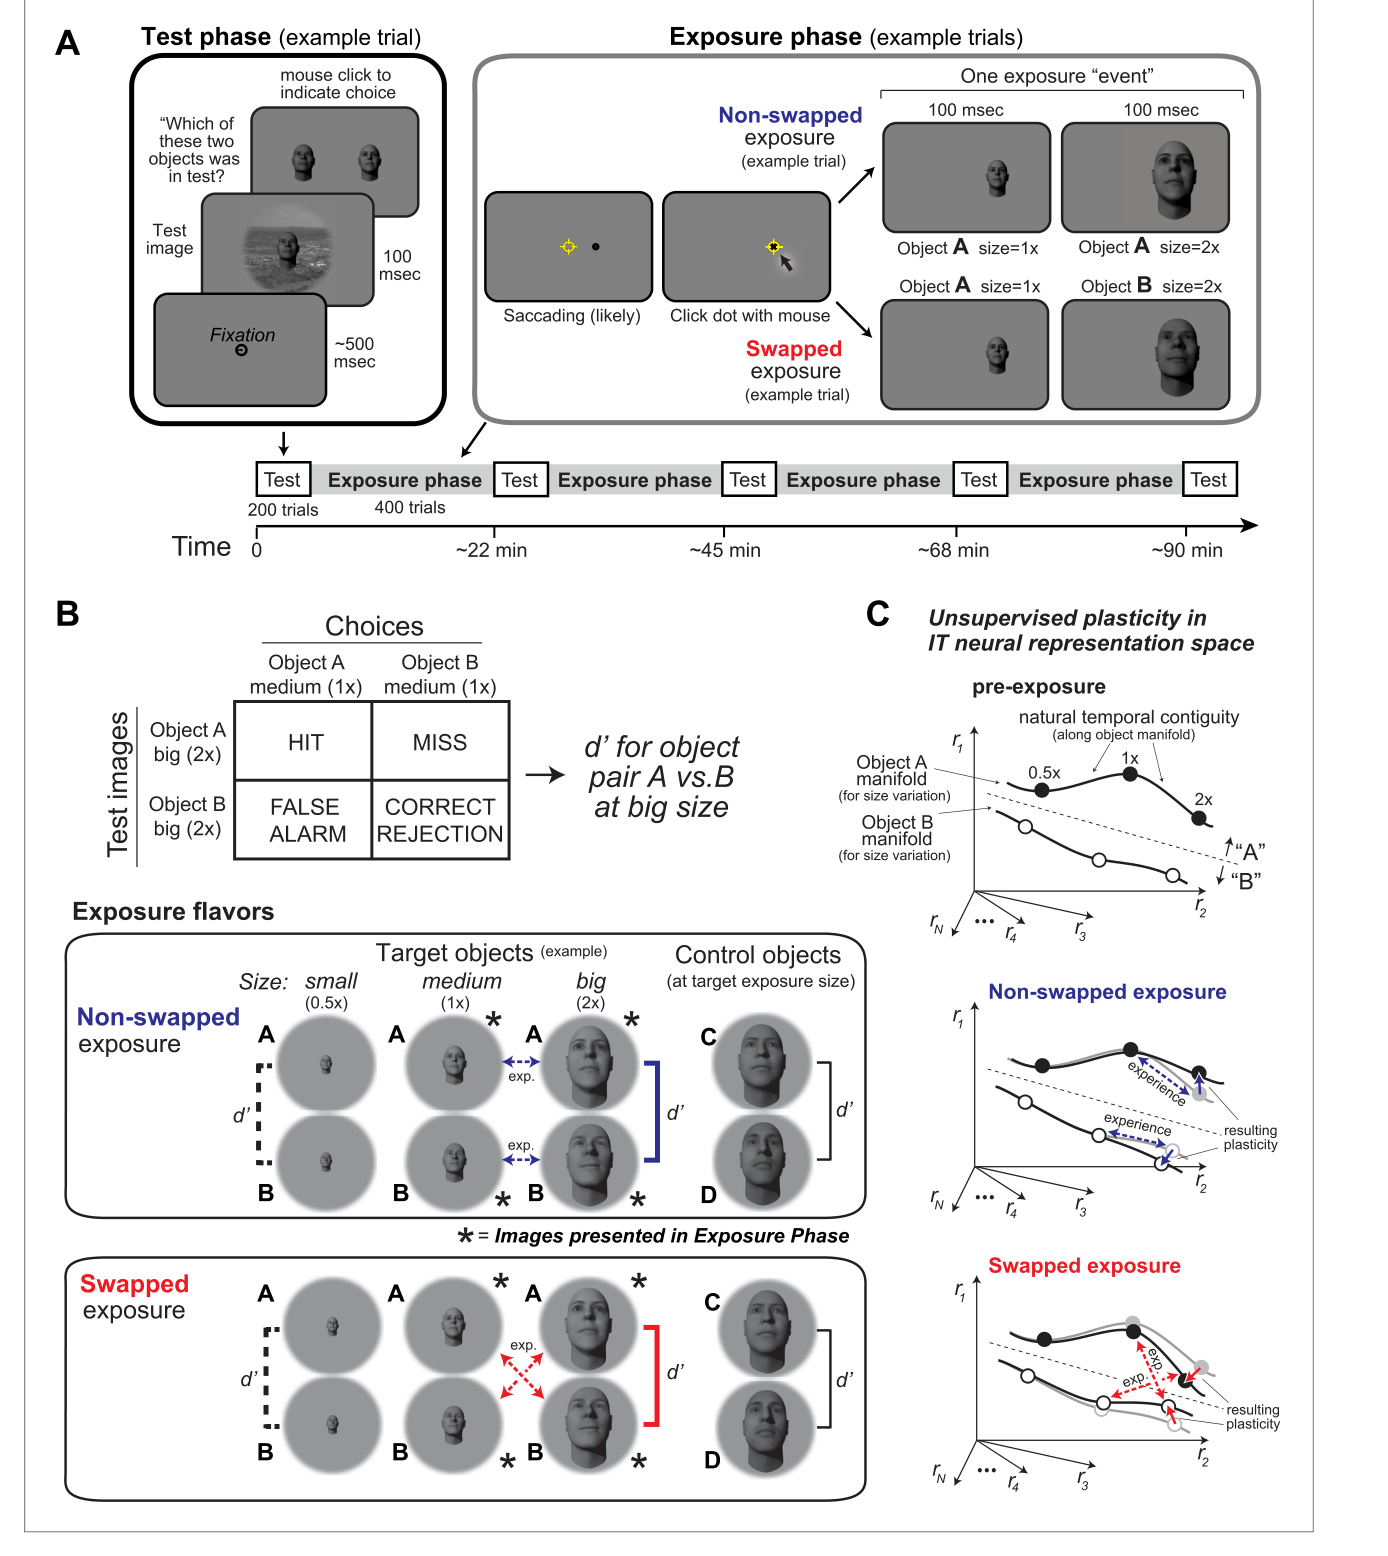
图 2 · 三种暴露范式下实测的人类学习曲线
原文图注:Figure 2. Measured human unsupervised learning effects as a function of amount of exposure. Each 'exposure event' is the presentation of two, temporally adjacent images (see Figure 1A, right). We conducted three longitudinal unsupervised exposure experiments (referred to as u1, u2, and u3). (A) Swapped exposure experiment intended to 'break' size tolerance (n = 102 subjects; u1). Upper panels are the changes in d' relative to initial d' for targeted objects (faces) at exposed size (big) (red line), control objects (other faces) at the same size (big) (black line), and targeted faces at non-exposed size (small) (dashed black line) as a function of number of exposure events prior to testing. Lower panel is the to-be-predicted learning effect determined by subtracting change of d' for control objects from the change of d' for target objects.
三列分别对应 u1(破坏)、u2(构建)、u3(先构建后破坏),被试数分别为 102、36、37。每列上排是相对初始 d' 的变化:红线是目标面孔在被暴露的 big 尺寸、黑线是对照面孔同尺寸、黑虚线是目标面孔未被暴露的 small 尺寸;下排是"要被模型预测的学习效应",即红线减黑线以剔除一般学习成分。u1 中红线随暴露事件数下探(负向 Δd'),u2 中上扬,u3 中先升后降——三列下排曲线就是后续图 5 里红线的来源。误差棒来自跨全试次的 bootstrap 标准误,星号是把测得变化与"零变化"比较的自助法 p 值(<0.05,<0.01,**<0.001)。值得注意的是三条曲线在约 800 事件后趋于平台,这为模型在长时程上的偏差埋下伏笔。
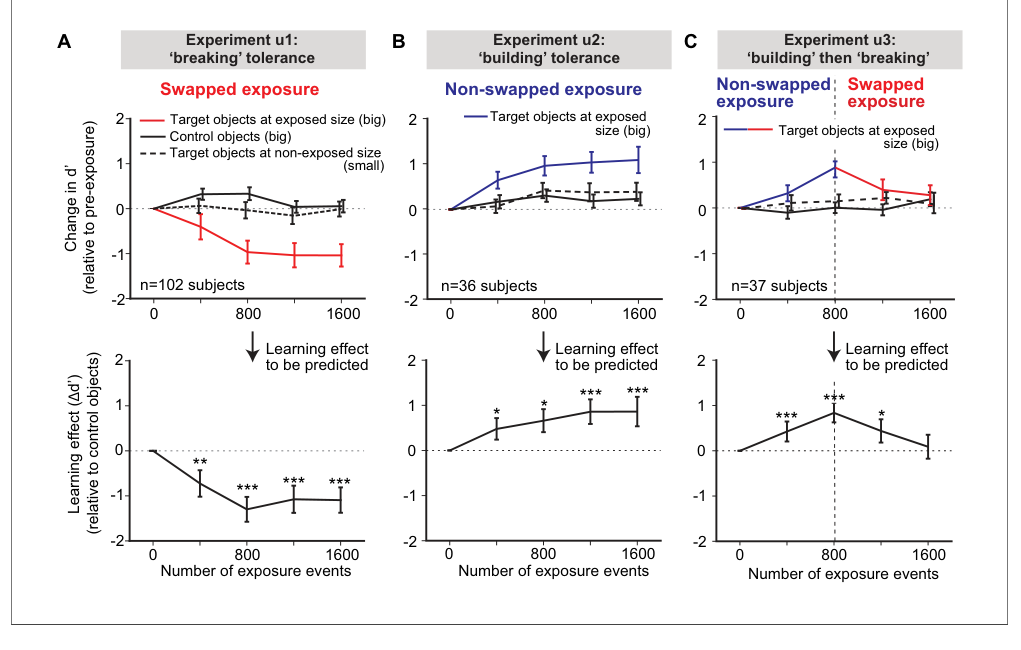
图 3 · 生成式 IT 模型及其与真实数据的校准
原文图注:Figure 3. Generative IT model and validation of the IT-to-core object recognition (COR)-behavior-linking model. (A) Generative IT model based on real IT population responses. Top left box: schematic illustration of the neuronal representation space of IT population with a multi-dimensional Gaussian (MDG) model. Each point of the Gaussian cloud is one IT neural site. Middle box: an example of simulated IT neural site. The distribution of object preference for all 64 objects is created by a sample randomly drawn from the MDG (highlighted as a red dot; each color indicates a different object). Then, a size-tuning kernel is randomly drawn from a pool of size-tuning curves (upper right box; kernels fit to real IT data) and multiplied by the object response distribution (outer product), resulting
A 面板展示模型的三层构造:从 MDG 云中抽一个点是某模拟位点的 64 物体偏好向量,再随机配一张实测拟合的尺寸调谐核做外积,得到 64 物体×3 尺寸的可分离响应矩阵,最后叠加背景杂波方差与试次噪声。B、C 面板是校验:真实与模拟群体各画一张响应距离矩阵(64 物体两两 2016 对),两者逐元素相关达 r=0.93±0.01,说明模型至少在二阶统计层面抓住了真实 IT 的表征布局。D 面板用两个任务(易任务初始 d' 约 3.5,难任务约 0.8)演示"成绩-位点数"曲线与人初始成绩的交点约在 260 个位点(m=20 训练图时),且 24 个任务交点高度一致(E 面板 r=0.83±0.05)。F 面板则把(位点数×训练图数)平面上所有能匹配人初始成绩的组合连成虚线流形——这是理解图 5C 稳健性检验的关键。
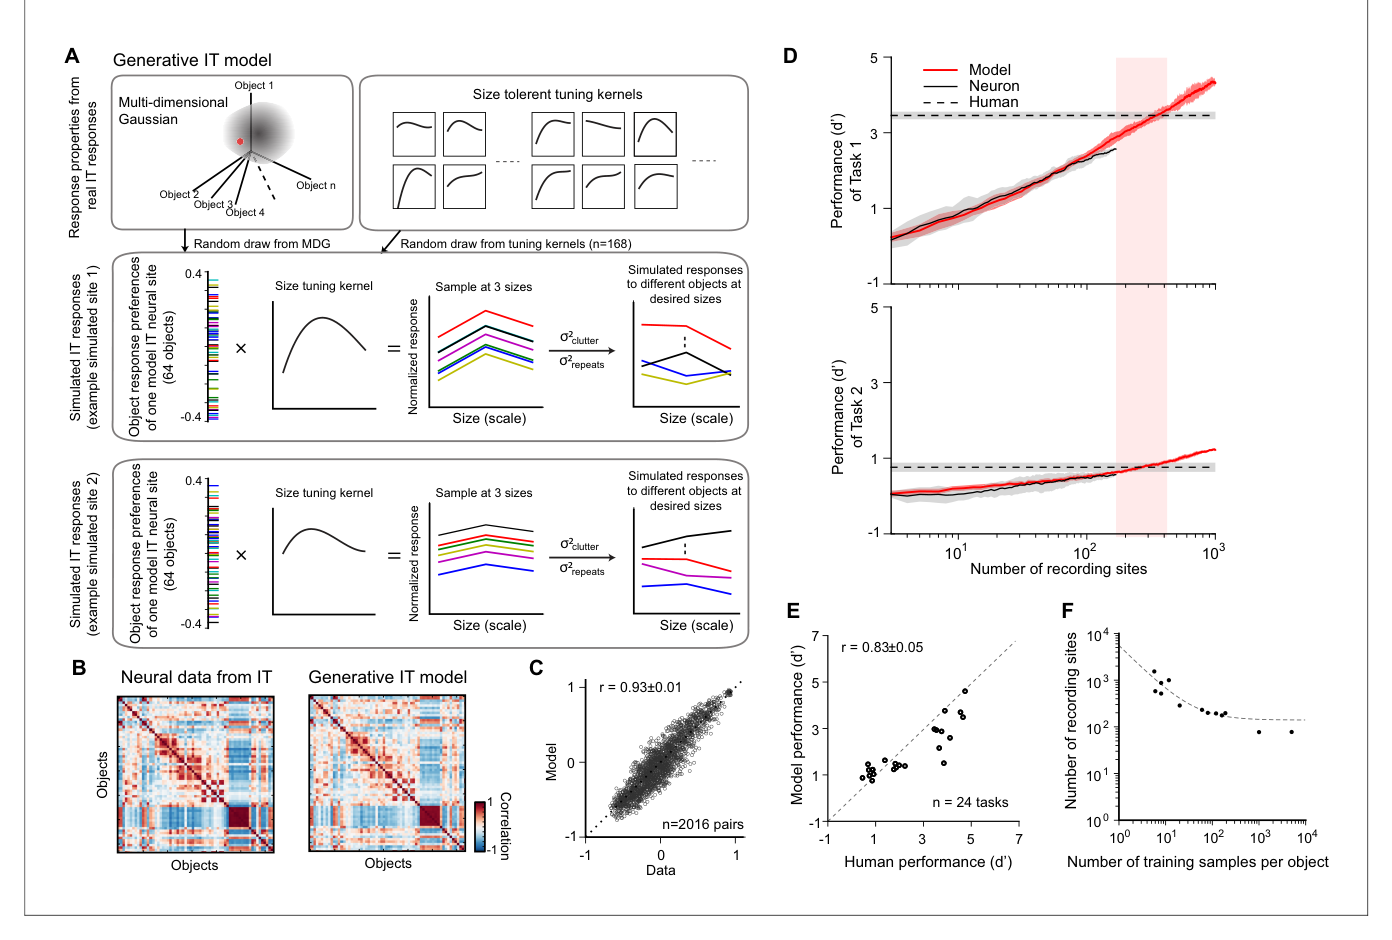
图 4 · 时间连续性驱动的 IT 可塑性规则与参数标定
原文图注:Figure 4. Temporal continuity-based inferior temporal (IT) neuronal plasticity rule. (A) Illustration of exposure design for IT neuronal plasticity (adapted directly from Li and DiCarlo, 2010) measured with single electrodes. P refers to preferred object of the IT unit, and N refers to non-preferred object of that unit. (B) We developed an IT plasticity rule that modifies the model neuronal response to each image in individual neural sites according to the difference in neuronal response between lagging and leading images for each exposure event (see Materials and methods). The figure shows the
A 面板直接照搬 Li and DiCarlo (2010) 的单电极暴露设计:每个位点先选偏好的 P(preferred)与非偏好 N(non-preferred)两个物体,再在交换尺寸(swapped size)与非交换尺寸(non-swapped size)上施加不同组合的暴露。B 面板给一个模拟"尺寸容忍"位点的演化:1600 个事件后,P 与 N 在两尺寸上的响应差按规则互相靠拢直至饱和。C 面板是参数标定的核心:三种可塑性率(α=0.0004、0.0016、0.0064)给出不同的选择性变化速率(纵轴为归一化选择性变化 Δ(P−N)/(P−N)),虚线是 Li 和 DiCarlo 报告的猴 IT 实测均值(n=42 位点),红线(交换尺寸)、蓝线(非交换尺寸)、绿线(medium 尺寸)中只有 α=0.0016 与三组虚线同时吻合,故锁定该值。D 面板按初始选择性强弱把模拟位点分组(n=5 到 n=461),显示 swapped 暴露能毁灭乃至反转低选择性位点,而 non-swapped 暴露能从零处"建造"新选择性——复现了猴数据中等效应,也解释了"让响应靠拢的规则何以能拉开 P-N 差距"这一看似矛盾的直觉。
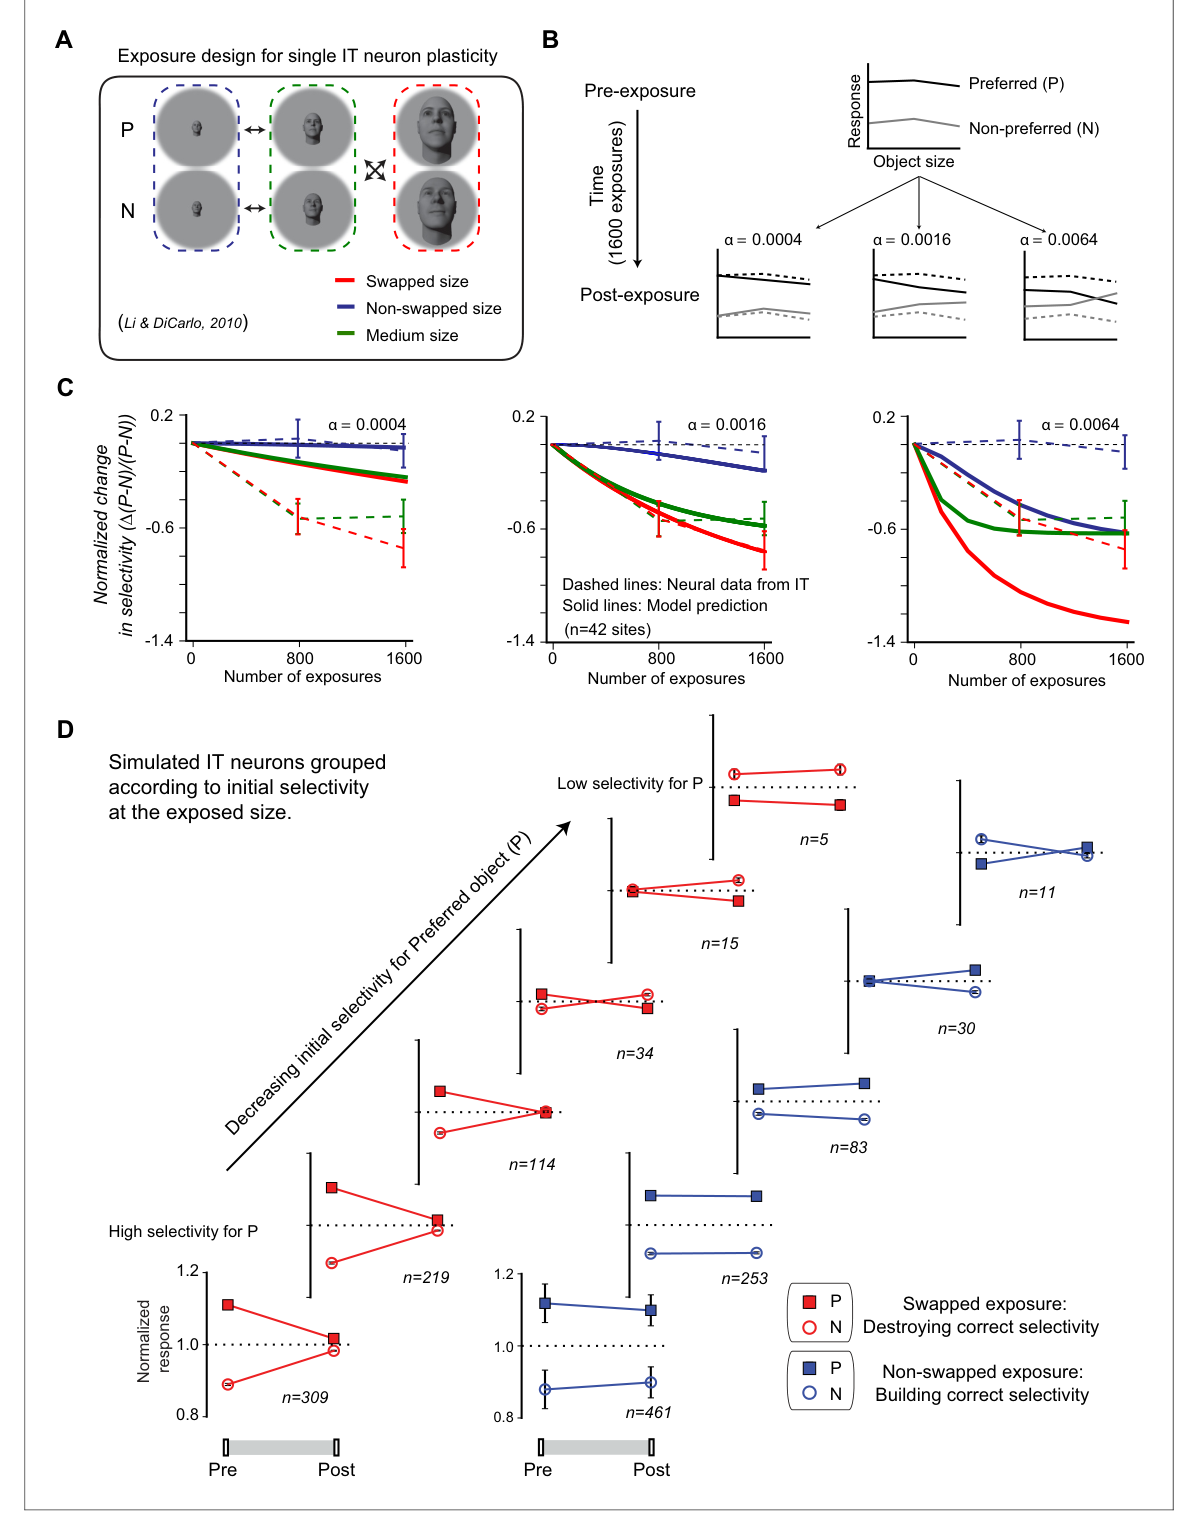
图 5 · 模型预测 vs 实测人类学习效应
原文图注:Figure 5. Overall model-predicted learning effects vs. actual learning effects. (A) Overall model-predicted learning effect (solid black line) for experiment u1 (swapped exposure) with the IT-to-behavior-linking model matched to initial human performance (hyperparameters: number of training images m = 20, number of model neural sites n = 260; see Figure 3) and the IT plasticity rate matched to prior IT plasticity data (0.0016; see Figure 4). Red line indicates measured human learning effect (reproduced from Figure 2A, lower). Gray lines indicate model predictions for four times smaller plasticity rate and four times larger plasticity rate. Error bars are standard error over 100 runs of the overall model; see text. (B) Decoder hyperparameter space: number of training
这是全文的"对决"图。A 面板把 u1 的预测(黑)与实测(红,取自图 2A 下排)叠在一起,两者方向、幅度、时间进程基本一致;两条灰线分别是可塑性率缩小/放大 4 倍的模型变体,与实测明显脱节——这是"单单位 IT 可塑性恰好足以解释、而非过度解释行为学习"的最有力证据。B 面板画出解码器超参数平面(训练图数×位点数),虚线是能匹配人初始成绩的所有组合构成的流形;C 面板显示流形上的两个不同组合给出的预测几乎重合(两条黑线叠成一条),而偏离流形的"超人"或"亚人"模型会系统性高/低估学习效应。D、E 面板分别对 u2(构建)与 u3(先构建后破坏)重复同样的对照,结论一致。唯一可见的偏差出现在 1600 暴露事件处:模型预测的变化略强于实测,成为讨论部分反思规则简化问题的入口。
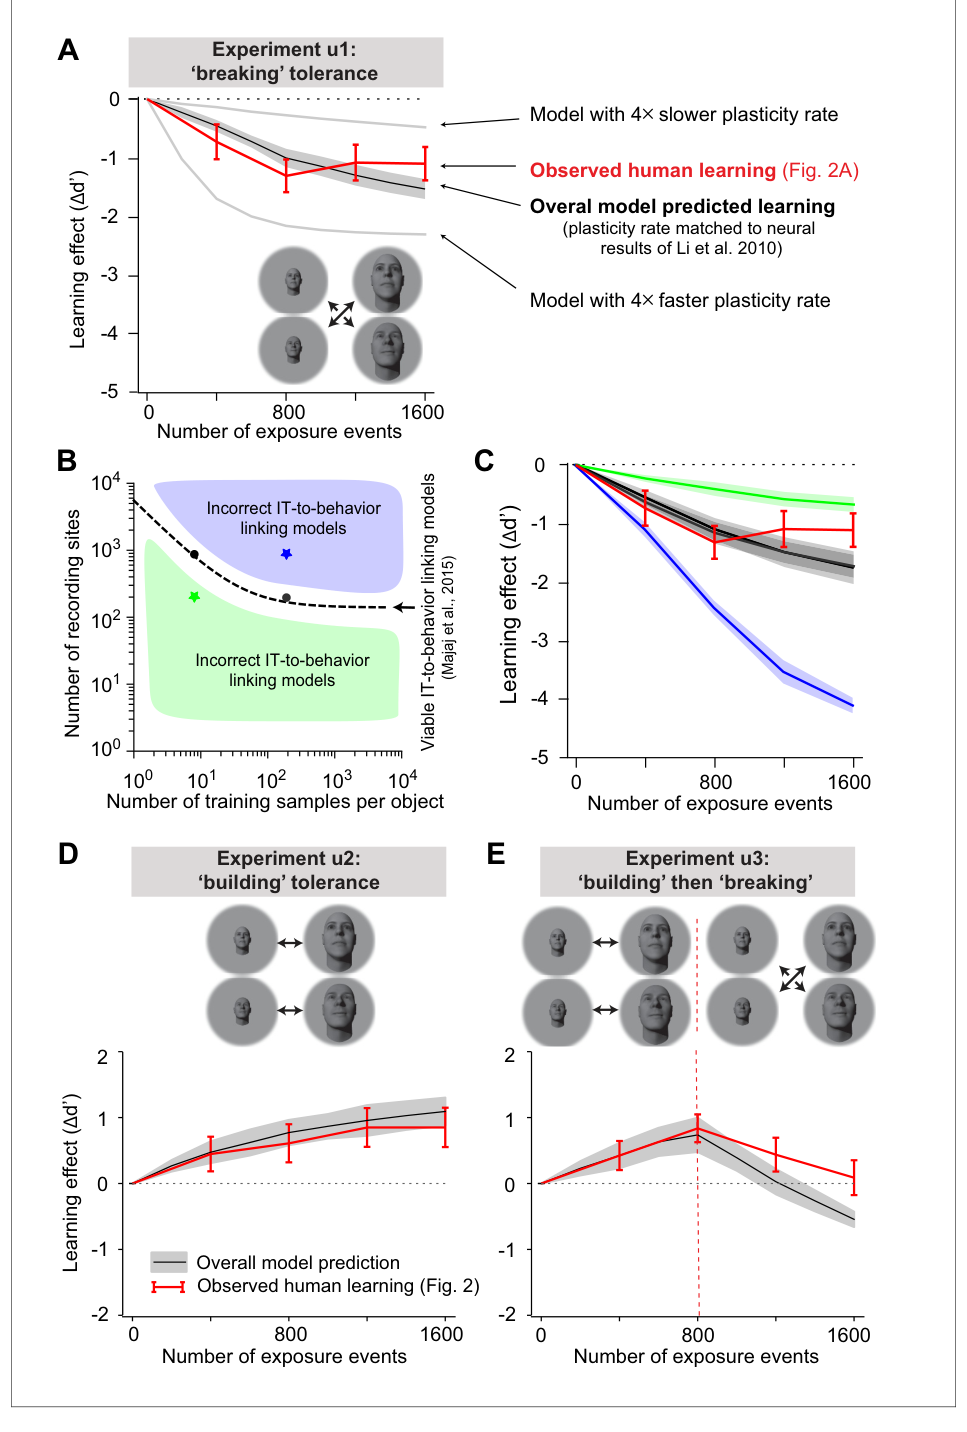
图 6 · 学习效应与初始任务难度的依赖
原文图注:Figure 6B shows that unsupervised learning effect plotted against pre-exposure task difficulty for all 13 object discrimination tasks. This result not only confirms that this unsupervised learning effect is observed for a range of object discriminations (e.g., not just face objects), but it also showed a relationship between task difficulty (d') and the magnitude of that learning effect. In particular, for initially easy tasks (d' > ~2.5) and initially difficult tasks (d' < ~0.5), we observed a smaller learning effect than tasks with intermediate initial performance.
A 面板是"猜测率如何压低可测 d'"的示意图:横轴是 IT 群体实际携带的感官证据强度 d',纵轴是实测 d';一旦假设被试在固定比例试次上随机作答,实测 d' 便会饱和封顶。B 面板把 13 个子任务的实测学习效应(彩色十字,绿色为 small 尺寸面孔、蓝色为 big 尺寸面孔、红色为基本水平物体,分别对应 n=100/161/70 名被试)按初始 d' 排开,并与不同猜测率假设下的模型预测点(黑点,0%/2%/9%/20%)对比。零猜测率模型在易任务端系统性高估效应,而 9% 猜测率(与被试群体实测上限约 90–95% 一致)的点与十字基本贴合。此图支撑主要结果第 5 条,也提示:高 d' 区间的 IT-行为链条在本范式中实际不可测,而非被证伪。
讨论
作者把结果解读为:三条此前彼此独立的研究线索——人类无监督学习、猴 IT 无监督可塑性、IT-to-COR 行为检验——第一次在定量上互相咬合,从而为" tolerant 核心识别至少部分由自然发生的时间连续性经验所教导"这一工作假说提供了迄今最完整的支持。他们也坦率讨论了模型为何"意外准确"背后的隐含假设:猴与人 IT 近似相同、IT-行为链接 птих人猴一致、人 IT 可塑性与猴相同、1.5–2 小时内链接机制本身不再改变;并承认另一种解释是这些假设的错误恰好相互抵消。对长时程上的小偏差,作者猜测可能涉及可塑性率随疲劳减慢、响应的重整化(renormalization)以及稳态调节(homeostatic adjustment)等未建模机制;对高初始 d' 区间,作者明确指出本范式无法检验链条成立与否,需要更精确的个体猜测率测量或更大剂量暴露作为后续工作。
这篇文章还主动与反面证据对话:Okamura et al. (2014) 显示随机顺序的足够视角暴露也能形成视角容忍,提示时间连续性之外或多了一条通路;Van Meel and Op de Beeck (2020) 在人类 LOC 用 fMRI 找不到时间连续性效应,但该研究既无行为学习效应报告、fMRI 分辨率又有限,作者认为未必与本结果矛盾;大鼠 V1 的发展期工作(Matteucci and Zoccolan, 2020)则提供了跨物种的一致信号。关于面孔智能区(face patch)的问题,作者给出的立场是"零假设平等":本研究与所有 IT 神经元等可塑潜力的假设相容,聚簇与否只是尚待靶向实验检验的替代假说。
一句话总结
该研究建立了无监督视觉经验诱发的 IT 皮质单神经元可塑性、群体流形几何变化与行为混淆模式改变之间的定量预测模型,在参数无自由拟合的条件下验证了腹侧流神经可塑性对核心物体识别行为变化的充分性与直接联系。