本文探讨利用深度神经网络(DNN)建模腹侧通路时的关键归因问题:网络模型与人下颞叶(human inferior temporal cortex, hIT)表征的相似性,到底源于网络架构本身的归纳偏置、基于 ImageNet 的物体分类任务训练,还是事后针对脑数据的线性特征重加权(拟合)?作者选取九种差异显著的卷积架构,基于同一套 62 图 fMRI 数据展开系统的“训练 × 拟合”因素分解。结果显示:任务训练贡献了中等程度的相似性(约 +57% 可解释方差),而事后特征拟合的贡献更大(约 +124%);一旦经过训练并线性拟合,九种架构的表现均达到统计上彼此无显著差异的水平,表明单纯增加架构深度并不等同于更贴近人脑表征。
研究背景
在 ImageNet 物体分类任务上训练的深度卷积神经网络常用于预测人及非人灵长类高级腹侧视觉区的神经表征。但文献中不同 DNN 对脑表征的预测精度存在变异(Xu & Vaziri-Pashkam, 2021;Zeman 等, 2020;Schrimpf 等, 2018),且差异来源尚未完全厘清。作者提出至少存在三个混杂来源:其一是网络架构固有的归纳偏置(如各层可表征的空间尺度与滤波特性),可通过随机初始化的未训练网络进行评估;其二是任务训练获得的结构化视觉特征,可通过对比同一架构训练与未训练版本的差异来测定;其三是特征成分的相对权重差异——两个提取相似特征的模型若特征占比不同,对脑数据的表观预测力可能产生显著分歧,这需要通过特征线性重加权(fitting)进行检验(Khaligh-Razavi 等, 2017)。由于以往研究在分析时未统一是否允许特征重加权,跨研究结论难以直接比较。本文旨在系统评估架构深度(8–201 层、25–825 个处理步骤)、任务训练与脑数据拟合三者对预测人下颞叶表征的具体贡献。
研究思路
研究采用控制变量设计进行逐因素分解:选取九种具有代表性的卷积神经网络(从 AlexNet 的 25 个处理步骤到 Inception-ResNet-v2 的 825 个,参数量 124 万至 1.38 亿,ILSVRC Top-5 错误率 20.9% 至 4.9%,人类参考值约 5.1%)。每个模型均测试两种状态(ImageNet 训练版与同均值方差随机初始化的未训练版),每个关键层均提取两种表征(原始全维特征,以及经“生态驱动”PCA 降至 100 维后再对主成分进行线性重加权的拟合表征),最终通过表征相似性分析(representational similarity analysis, RSA)将模型表征相异性矩阵(representational dissimilarity matrix, RDM)与 24 名被试 hIT 的 RDM 进行对齐比较。
分析包含两项关键设计:第一,拟合过程采用严格的双重留出交叉验证——在自举样本内随机划分测试图像(12 张)与测试被试(5 名),所有加权参数在训练子集上拟合,并在双重留出的测试集上评估泛化表现,以防过拟合;第二,噪声天花板(noise ceiling,即单个被试预测其余被试数据的相关水平,代表数据信噪比限制下的期望上限)在与模型拟合相同的交叉验证折内计算,提供统一的基准。作者同时指出,特征重加权与不加权回答的是不同的科学问题:前者检验该架构与特征空间所能支持的表征几何上限,后者则检验哪种网络架构与训练目标能够自发形成贴近大脑的特征分布。
方法
fMRI 数据基于已有的 62 张彩色图像(涵盖人脸、物体与自然场景,灰底 427×427 像素,动/静物与人造/自然均衡;其中 20 张人脸里有 14 张在低级图像统计上严格匹配,30° 半侧面、光照与颜色直方图对齐),在快速事件相关设计下采集:24 名健康成人(15 女),图像居中呈现 7° 视角、500 ms、试次起始间隔 3 s,扫描时执行 1-back 重复检测任务;每 run 呈现 56 张各一次加 6 张重复,两日各完成 12 个 run;扫描前在扫描仪外完成 5 遍熟悉化,事后回忆测试平均正确率 92%(d′=3.58±0.26),确认被试保持稳定注意。成像采用 Siemens TIM-Trio 3T、32 通道线圈、2 mm 各向同性体素;SPM8 预处理、不做空间平滑。ROI 方面,V1–V3 依据皮层表面解剖模板(Benson 等, 2014)定义;hIT 由独立功能定位(432 张面孔/地点/物体/打乱图像 vs 基线)结合解剖掩模选出,并剔除 V1–V3 重叠体素。响应模式由一般线性模型(GLM)估计并作多变量噪声归一化,RDM 由交叉验证马氏距离(crossnobis)计算,左右半球分别计算后取平均,获得每位被试的 62×62 矩阵(1891 个独立距离对)。
模型侧:九个网络(Alexnet、VGG-16、Squeezenet、Googlenet、Mobilenet-v2、Resnet-18、Resnet-50、Densenet-201、Inception-Resnet-v2)在 MATLAB Deep Learning Toolbox 中调用原开发者的 ImageNet 预训练权重,刺激缩放到各自输入尺寸;未训练版本将各层权重替换为同均值方差的高斯随机数。每个架构选出 8–103 个关键层(卷积/全连接输出或模块级联输出)。拟合分两级展开:首先使用 3020 张 Ecoset 图像(英语中最常见具体名词类别的生态代表性图像集,Mehrer 等, 2021)对各层激活进行主成分分析(PCA),提取前 100 个主成分并计算 PC-RDM,随后利用非负最小二乘法将 100 个 PC-RDM 线性组合以拟合 hIT 数据(第一级、层内拟合);之后将各层的拟合 RDM 再次进行线性组合(第二级、跨层拟合)。统计层面:采用 1000 次自举(被试与图像同步重采样)× 每次自举内 200 折交叉验证;模型性能以预测 RDM 与测试被试 RDM 的平均 Spearman 秩相关衡量;差异检验基于自举差值分布的单侧检验(α=.05,未做多重比较校正),模型间等价性采用 Lakens(2017)的等价性检验(以噪声天花板下界的变异为参照),架构深度的连续分析采用稳健相关(skipped correlation)。
主要结果
- 任务训练对 hIT 相似性的提升相对有限:逐层对比训练与未训练版本(图 3),在单侧 α=.05(未校正)检验标准下,九个模型中仅五个存在训练版本显著优于未训练版本的层,且仅 Mobilenet 在多数层表现出显著优势。然而任务训练显著改变了层级表征轮廓:未训练模型各层的 hIT 相关系数相对平缓;训练后模型在网络约 1/2 至 3/4 深度处达到相似性峰值,并在末端分类层回落(推测 1000 类稀疏 one-hot 训练目标降低了末层对图像间相似几何的保留)。在未经拟合重加权时,所有模型的所有层表征均显著低于噪声天花板下界,表明仅凭任务训练自发形成的特征分布尚未完全对应 hIT。
- 拟合(PCA 降维与主成分线性重加权)显著改善各层匹配度(图 4):九个模型的层表征在降至 100 维并线性加权后,几乎所有层的 hIT 相关性均显著提升;其中五个模型在至少一个层上达到了与噪声天花板下界无统计显著差异的水平。与此同时,网络深度并未单调决定表征相似度(图 5):将各层拟合表现按归一化深度对齐后,不同深度架构所能达到的峰值表现相近,且架构深度与整网 hIT 匹配度无显著相关(训练+拟合 r=.20, p=.61;训练不拟合 r=−.07, p=.86)。
- 训练与拟合各自及联合的定量贡献(图 6):以九个架构为观测单位的 2×2(训练×拟合)ANOVA 显示训练主效应 F(1,35)=33.82、拟合主效应 F(1,35)=43.69(均 p<.0001),且交互作用显著(F(1,35)=6.51, p=.016)——拟合对训练后模型的增益更大,说明 ImageNet 任务让模型学到了“hIT 表征会用到的真实世界特征”,却没有学到这些特征在脑中的相对占比。以噪声天花板归一化后:训练带来 +57.5% 增益(归一化 r² 从 .12 升至 .19),未训练模型的拟合带来 +73.4%,而训练+拟合相对训练不拟合的增益达到 +124%(.21 升至 .48)——呈现超可加的组合效应。训练+拟合后九个架构平均解释 48.0% 的可解释秩方差;Googlenet、Densenet 与 Mobilenet 三个模型已与噪声天花板下界无法区分。等价性检验显示训练+拟合后全部 36 对模型间差异均与人类被试间的自然变异统计等价(Bonferroni 校正),而不拟合时有 8/36 对超出该变异;逐对差异的置换检验(Cohen's d=1.49, p=.001)同样表明拟合抹平了架构差异。
- 解释 hIT 的关键维度来源于自然图像统计变异,且少量维度即可满足(图 7):仅对各层前 100 个 PC-RDM 进行等权平均(不做针对 hIT 的参数拟合),就已能显著提升与 hIT 的匹配(训练网络配对 t(8)=15.33, p<.0001;未训练 t(8)=3.23, p=.0121;训练网络平均提升 25.5%)——即使某些层特征从上百万维被大幅压缩至 100 维。以 Mobilenet 为例测试主成分数量(1–3000),模型性能在 1 维至 10 维间快速上升,约 50 维处即达到平稳平台,100 维已足够保留核心表征方差。
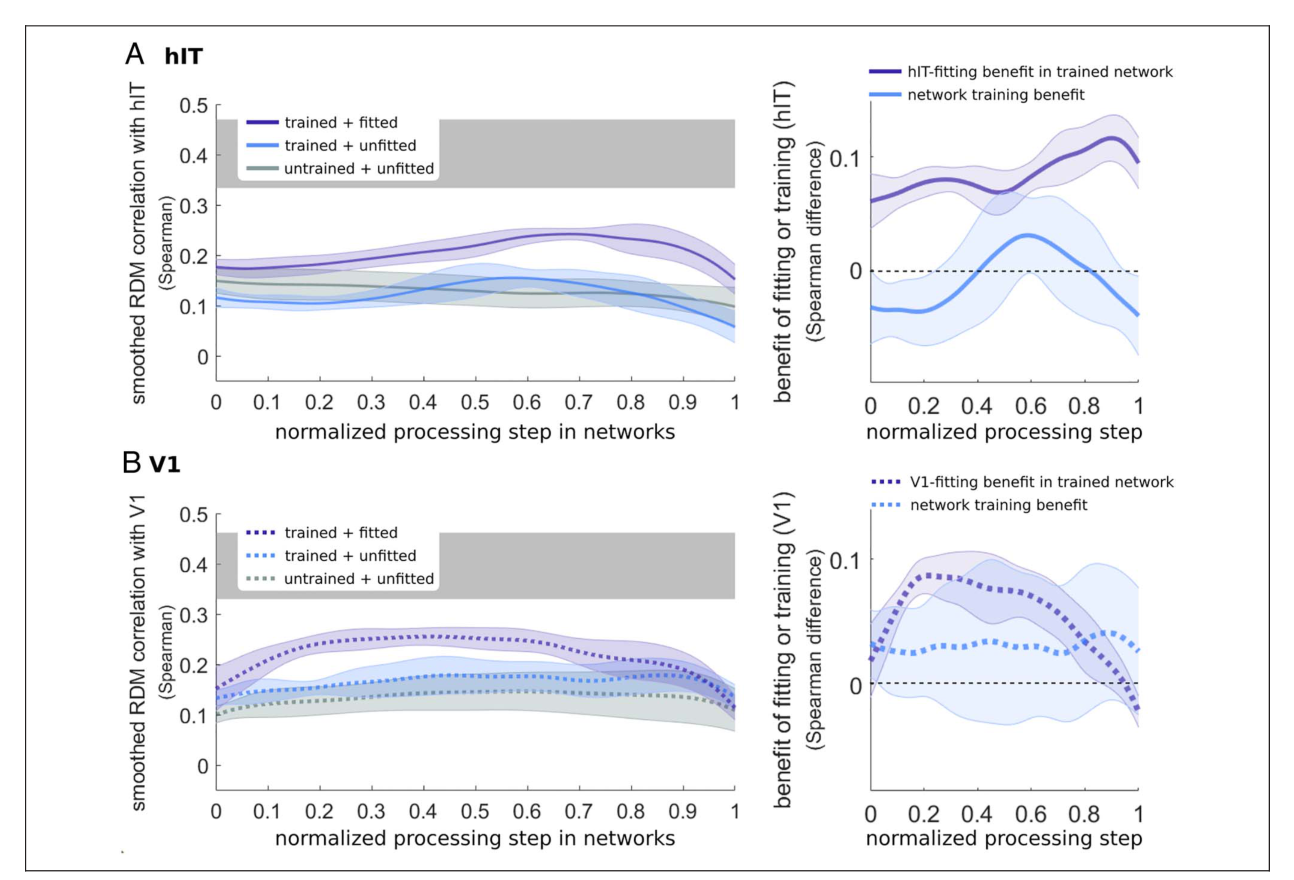
- 相同网络模型亦能有效解释初级视皮层 V1——关键在于将权重分配转移至浅层(图 8、图 9):同一批 62 张刺激在 V1 与 hIT 呈现出截然不同的表征几何(区域内部的被试间一致性相近:V1 r=.381、hIT r=.383;但两区域跨区互预测相关仅 r=.163),然而经过训练并拟合 V1 后,九个模型同样表现优异(训练主效应 F(1,35)=15.40, p=.0004;拟合主效应 F(1,35)=20.46, p=.0001;交互作用不显著 p=.09),其中五个架构(Resnet-18/50、Densenet、InceptionResnet、Mobilenet)与噪声天花板下界无统计显著差异,且模型间差异同样被拟合所抹平(Cohen's d=1.05, p=.002)。层级与皮层区域的对应关系主要在拟合后显现:拟合前最佳预测层位置在 hIT(0.56)与 V1(0.59)间无显著差异,拟合后 hIT 峰值显著移向深层(0.70 vs 0.48,t(8)=3.20, p=.013),拟合带来的增益峰值也分别落在深层(hIT 0.76)与浅层(V1 0.35)(t(8)=3.73, p=.006)。
图注解读
图 1 · 62 图 fMRI 数据集与平均 hIT RDM
原文图注:Figure 1. Human fMRI data set. Sixty-two stimulus images (A) were shown to 24 human participants in a rapid event-related fMRI experiment. An RDM was constructed for each participant from the cross-validated Mahalanobis distances between the multivoxel activation patterns elicited by each image in inferior temporal cortex (hIT). The average of all individual RDMs is shown in B, with dissimilarity between the hIT representation of each pair of images expressed as a percentile for visualization purposes.
A 面板展示全部 62 张视觉刺激(包含人脸、人像、动物、物体与场景,均为灰底孤立图像)。B 面板展示 24 名被试 hIT RDM 的平均矩阵,每个单元格以百分位数表示图像对之间的相异度。矩阵呈现明显的模块化结构:同类别内部(如匹配人脸)表现为低相异性,类别交界处呈现高相异性条带。该图明确了模型拟合的目标表征,并给出了较高的被试间一致性基准(hIT 内部相关 r=.383),为后续检验模型间差异是否超出被试间自然变异提供了统计参照。
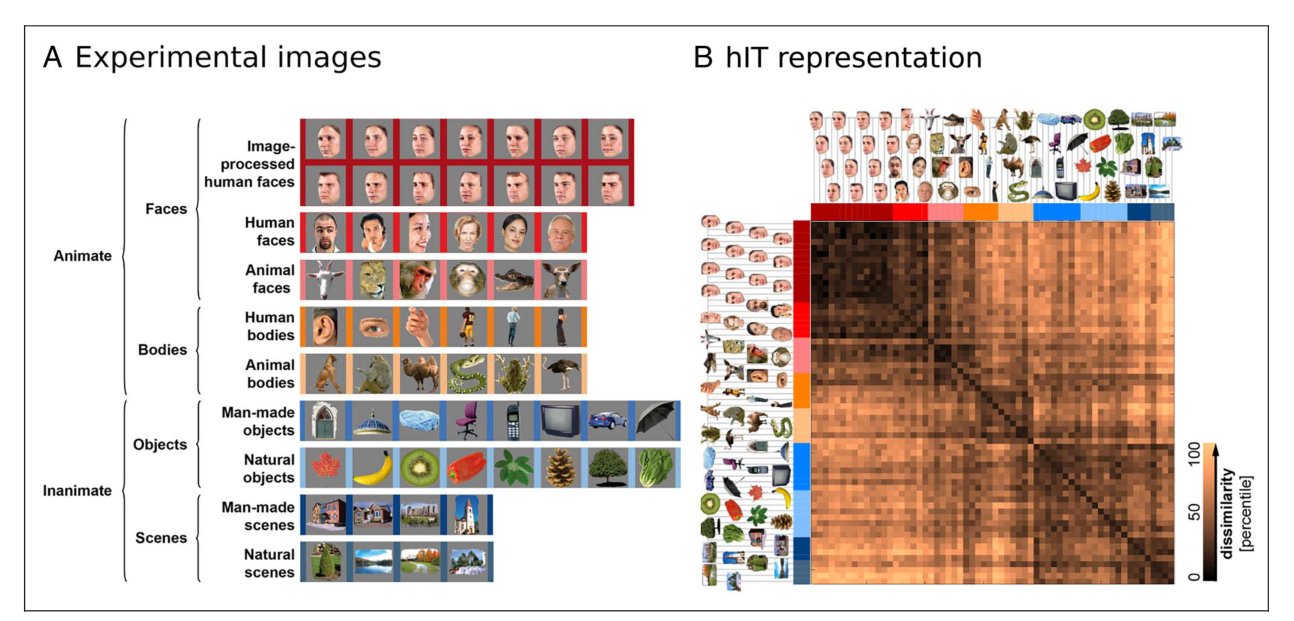
图 2 · 生态驱动降维与两级重加权流程
原文图注:Figure 2. Ecologically driven dimensionality reduction and component reweighting. An independent data set (A) of 3020 images derived from object categories that are important to humans was constructed by sampling uniformly from the ecoset data set (Mehrer et al., 2021). We recorded the activations elicited by these images in each unit of each layer of each network. On the basis of the data obtained from all units of a given layer, we then ran a PCA to identify the first 100 orthogonal components that explained the most variance in the layer's response to these ecologically representative images. By projecting activation vectors onto each of the 100 principal components in turn, we constructed 100 PC-RDMs for the 62 experimental stimulus images, within each network layer, using Euclidean distance. (B) The 100 PC-RDMs in each layer were linearly combined using a cross-validated reweighting procedure to best predict the hIT fMRI representation ("first-level fitting"). ……
图示为生态驱动降维与两级拟合流程。A:首先输入 3020 张 Ecoset 图像(与实验测试集无重叠的自然场景照片),对网络各层激活模式进行 PCA,提取解释方差前 100 的正交主成分;随后将 62 张实验刺激的激活向量投影到这 100 个主成分上,分别计算欧氏距离得到 100 个 PC-RDM。B:在层内通过交叉验证的非负最小二乘法为 100 个 PC-RDM 线性赋权以拟合 hIT 数据(第一级拟合);之后再跨层组合各层的拟合 RDM(第二级拟合,图中未详示)。所有加权系数均在留出的被试与图像子集上进行无偏评估。“生态驱动”表明主成分的选取完全独立于神经数据,仅基于自然图像统计分布;第二级重加权才是针对脑数据的参数拟合。这一解耦设计直接支持了结果中“自然主成分降维独立于拟合亦能带来增益”的发现。
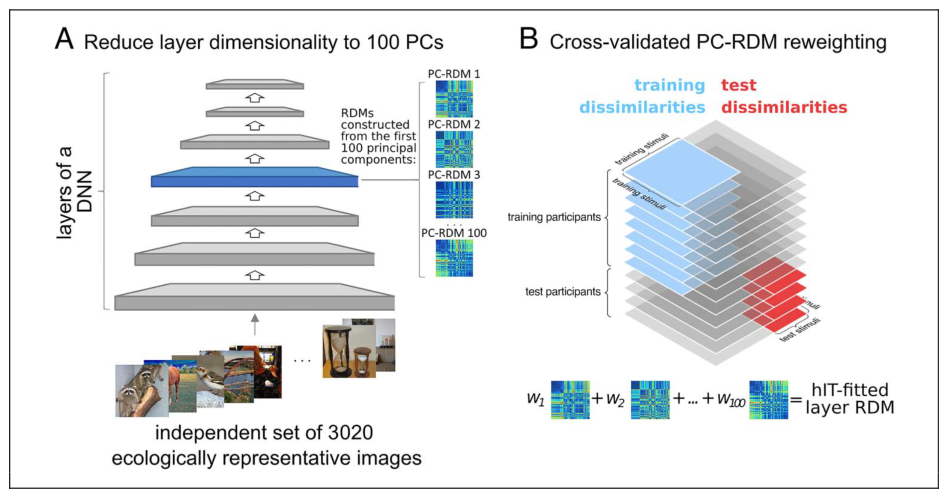
图 3 · 训练带来的改善:有、但小且不普遍
原文图注:Figure 3. Object recognition training improves hIT correspondence in some layers of some models. Panels show the hIT correlation of the full representation in each layer of each architecture, with no dimensionality reduction or feature reweighting, for an object-recognition trained instance of each network (blue) and for a corresponding untrained instance with randomly initialized weights (gray). Each dot corresponds to one of the key layers selected for analysis (see Table 1) and indicates the mean of a distribution of 1000 bootstrap estimates of cross-validated layer performance, bootstrapped over both subjects and stimuli. ……
九个子面板分别对应九种网络架构。横轴表示各层对应的处理步数,纵轴为与 hIT 的 Spearman 秩相关系数;蓝线表示任务训练网络,灰线表示随机初始化网络,阴影代表自举标准差,水平灰带代表噪声天花板的上下界范围;蓝色星号标出训练版本显著优于未训练版本的网络层(单侧 α=.05,未校正)。图表反映出三点规律:首先,未训练网络的各层表现整体平缓,表明随机初始化的网络结构先验所提供的相关性相对有限;其次,训练网络在中后层(约 1/2 至 3/4 深度)呈现相关性峰值并在末端下降,说明任务训练重塑了层级表征模式;最后,所有未经重加权的网络层表现均低于噪声天花板下界,表明未经拟合的特征分布与实际脑区表征仍存在系统性差距。
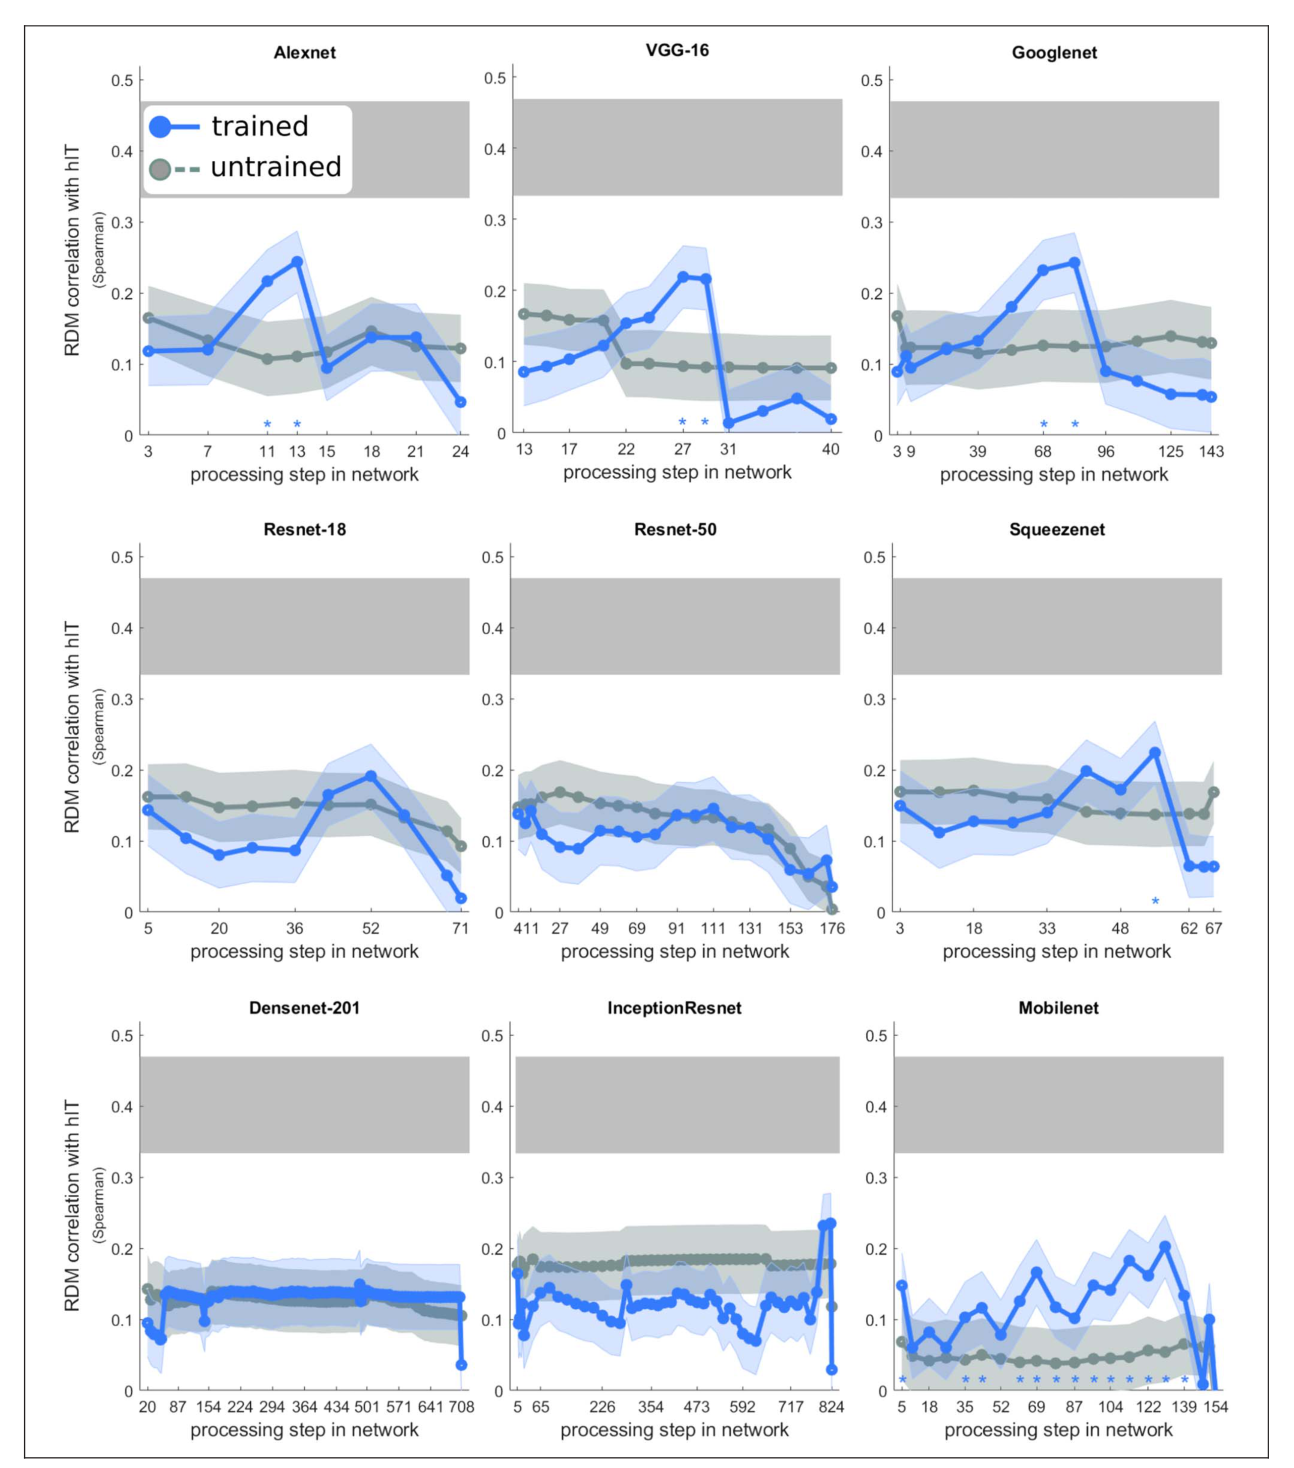
图 4 · 拟合后的跃升:多数层接近噪声天花板
原文图注:Figure 4. Reducing and reweighting the feature space dramatically improves hIT correlation across most layers in all network architectures. Each panel shows, for one model, the hIT correlation of the unfitted representation in the full original feature space (pale blue lines, same data as shown in Figure 3) and of the same feature space after reducing to 100 dimensions via ecologically driven dimensionality reduction (see Figure 2) and linearly reweighting those dimensions to fit hIT representations (cross-validated over both subjects and images). Blue asterisks indicate that the fitted layer performs significantly better than the original unfitted feature space. ……
每个子面板对应一种架构。浅蓝线表示原始全维特征空间的表现(同图 3 训练数据),深蓝线表示该特征空间经生态 PCA 降至 100 维并进行层内线性拟合后的表现。星号表示拟合后性能显著高于原始特征,标注“ns”则表示拟合后表现与噪声天花板下界无统计显著差异。结果显示,经过主成分降维与线性重加权后,各网络层的预测力普遍提升,部分模型的中后层表征进入了噪声天花板范围。由于所有重加权均在独立被试与刺激集上进行交叉验证,性能提升并非过拟合所致,表明任务训练已提取出与皮层表征相关的视觉特征,但其在原始网络中的激活方差分配与生物脑区存在偏差。
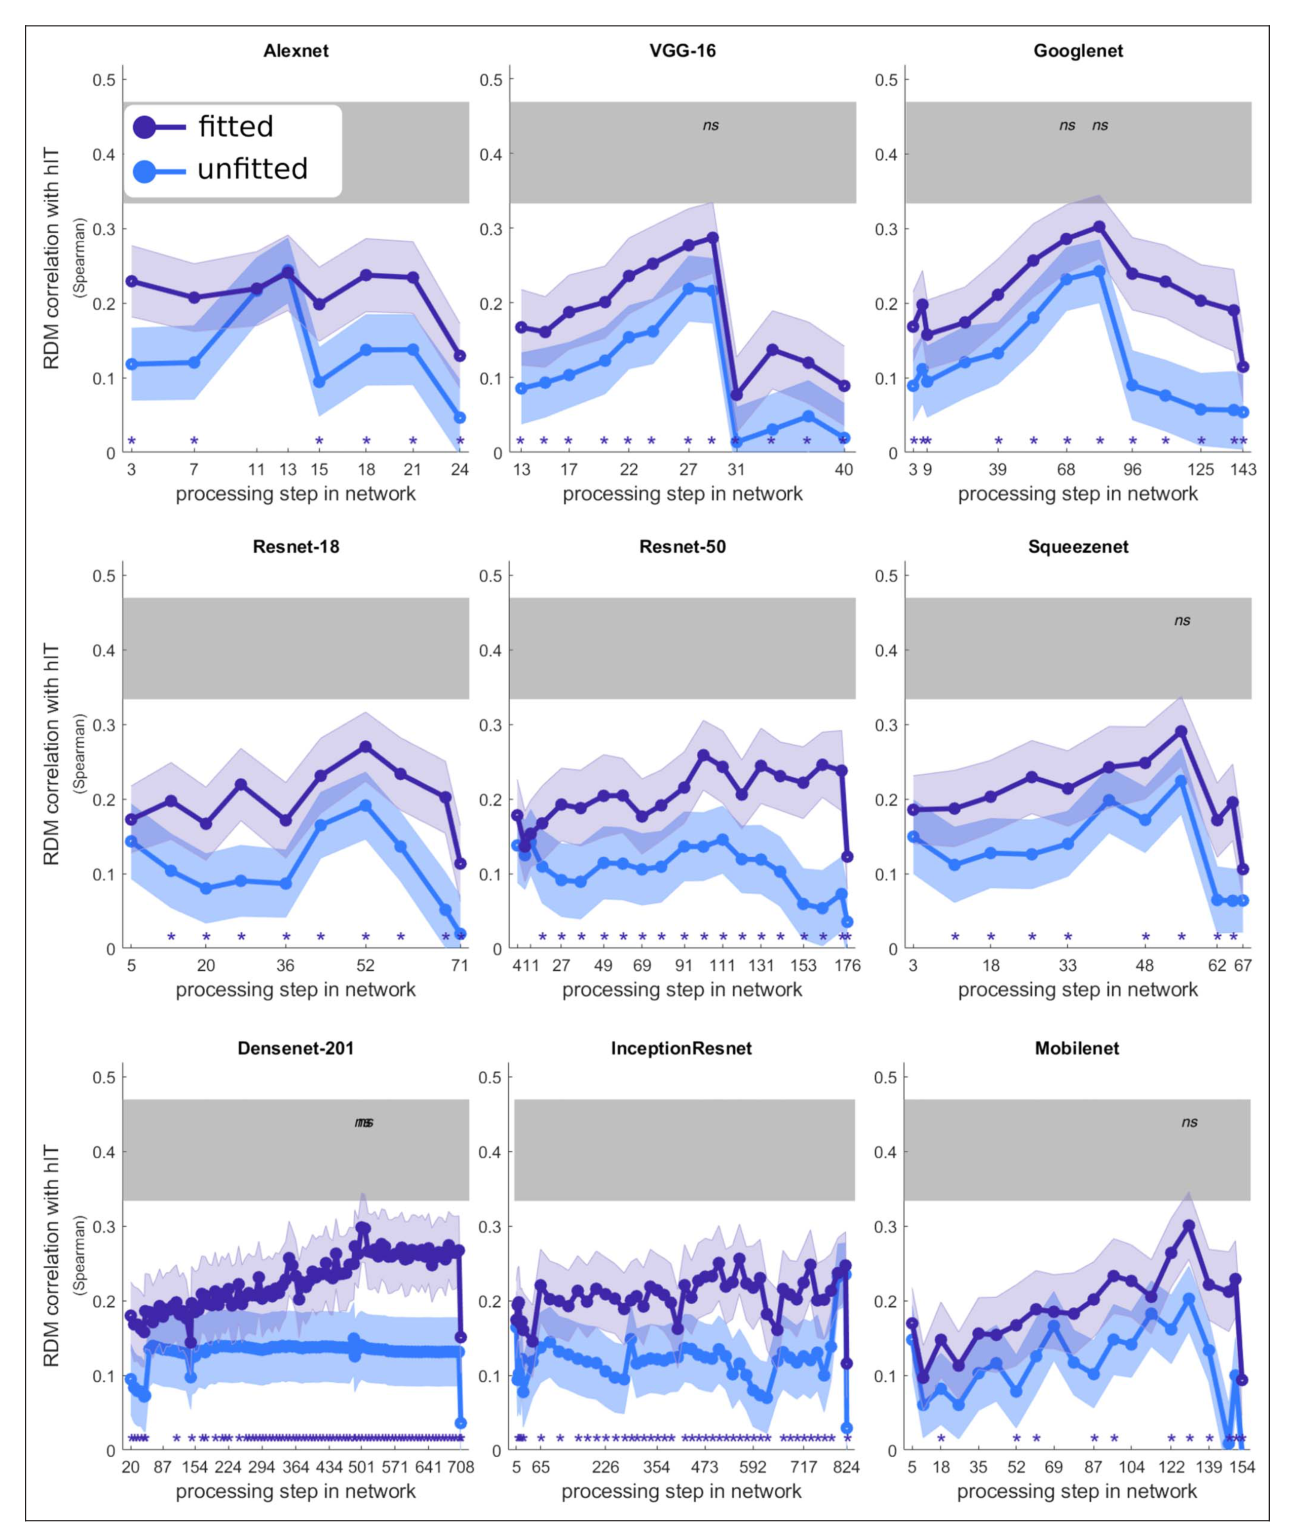
图 5 · 深度不是答案
原文图注:Figure 5. Depth is not the answer. Correlation with hIT representation for all layers of all networks, after "ecologically driven" PCA reduction and reweighting. Although many models reach representations in their late intermediate layers that well match hIT, increasing depth does not equate to increased hIT match, either within or between architectures, within this range of highly successful object-recognition computer vision models.
将九种网络拟合后的逐层 hIT 相关系数汇总于同一坐标系中,横轴统一归一化为处理步数占全网总深度的比例。曲线显示,不同深度模型的峰值表现高度接近,且峰值出现的位置(多集中于 1/2 至 3/4 相对深度)并不随网络实际层数的增加而发生系统性后移;包含 25 个处理步的 AlexNet 与包含 825 步的 Inception-ResNet-v2 达到相似的峰值匹配水平。结合整网分析中深度与匹配度无显著相关的结果(训练+拟合 r=.20;训练不拟合 r=−.07),数据表明在成功训练的物体识别模型范围内,增加网络层数并不必然带来对 hIT 表征预测力的单调提升。
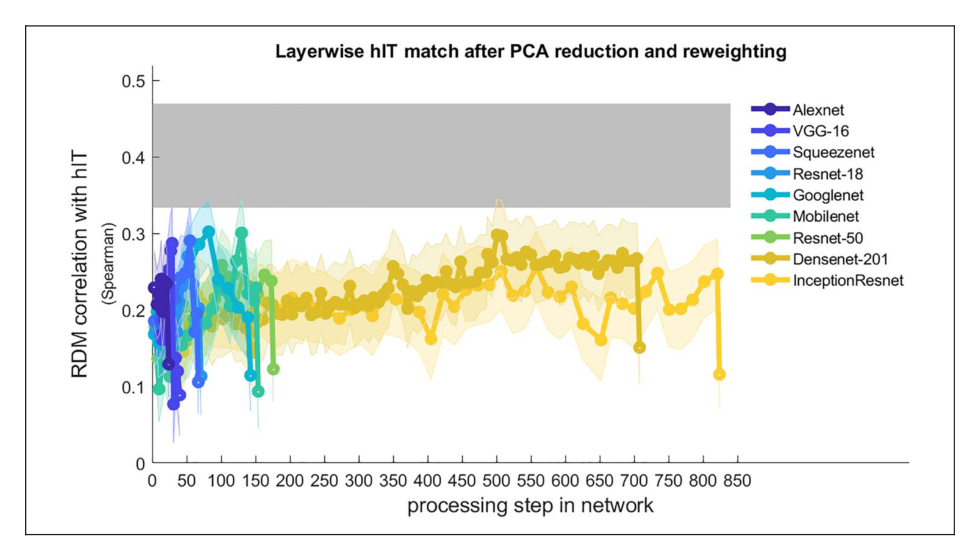
图 6 · 整网汇总:训练与拟合的主效应及超可加交互
原文图注:Figure 6. Training and within-layer fitting both improve correlation with hIT. (A) Bars show an estimate of the combined performance of all layers within each of the networks, obtained by second-level (across-layer) fitting in all cases. The fitting procedure is identical to that used to reweight principal components within each layer, except that it takes as input per-layer RDMs rather than PC-RDMs. Pale gray bars show the hIT match for the raw (unfitted) feature space of a randomly weighted instance of the network, dark gray bars show hIT match for the same random feature space after PCA reduction and within-layer reweighting, pale blue bars show hIT match for the unfitted feature space of the object-recognition-trained network, and dark blue bars show hIT match for the trained network ……
A 图展示九种网络架构在四种实验条件下的整网预测表现:浅灰表示未训练且未拟合,深灰表示未训练经层内拟合,浅蓝表示训练未拟合,深蓝表示训练且拟合;水平灰带为噪声天花板。柱状图反映出训练效应(浅灰对比浅蓝)与拟合效应(浅色对比深色):训练带来适度提升,特征拟合带来更大增幅,深蓝柱整体逼近噪声天花板,其中 Googlenet、Densenet 与 Mobilenet 与天花板下界无统计显著差异(标示 ns)。B 图展示跨架构平均效应,量化了训练(+57.5%)与拟合(+124%)带来的可解释方差增益,以及两者显著的超可加交互效应(F(1,35)=6.51)。
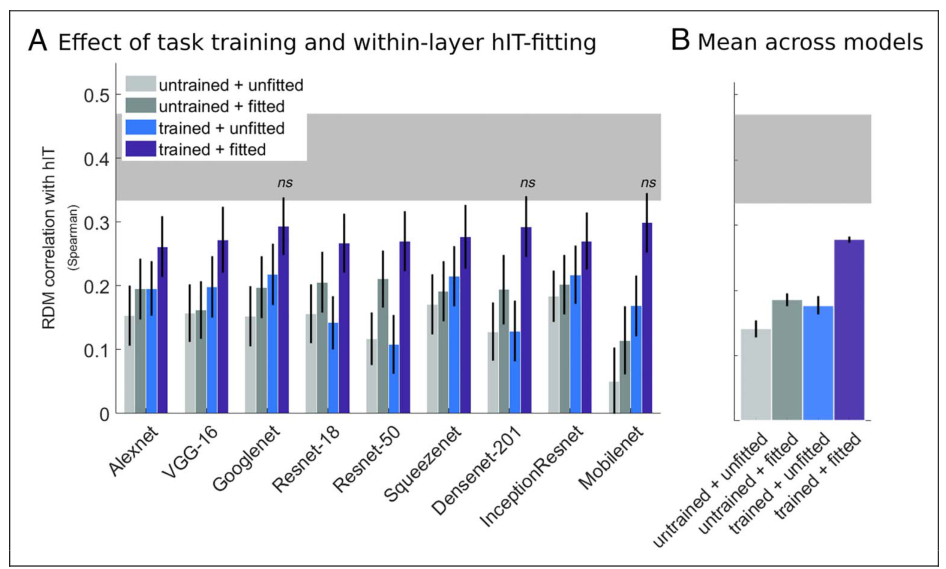
图 7 · 自然图像维度的独立贡献与维度数量的稳健性
原文图注:Figure 7. Finding dimensions of natural-image variation within each layer's feature space improve hIT match, and a small number of dimensions are sufficient. (A) Estimates of the whole-network hIT correlation for trained (blue) and random (gray) networks, derived by reweighting layer RDMs obtained from either (left) the full original feature space; (center) the first 100 components of that feature space, derived via PCA on an independent natural image set; and (right) after reweighting the principal components within each layer to predict hIT representations. (B) Estimates of the whole-network hIT correlation for one example network, Mobilenet, in its trained (top) and untrained (bottom) states, after reducing the feature space within each layer to various numbers of principal components …
A 图将特征降维与特征重加权进行独立拆解:左侧为原始特征空间,中间为仅进行无加权的 PCA-100 降维,右侧为降维后进行线性重加权。中间柱显著高于左侧柱(训练网络配对 t(8)=15.33),表明仅通过自然图像统计筛选主要变异维度,在未经任何脑数据拟合前即可改善与 hIT 的匹配(平均提升 25.5%)。B 图以 Mobilenet 为例测试保留主成分数量(1 至 3000,对数坐标)对模型性能的影响:在训练与未训练状态下,相关性在 1 至 10 维间快速上升,在约 50 维处达到平稳平台,表明 100 个主成分已能充分保留支持脑区预测的核心表征方差。
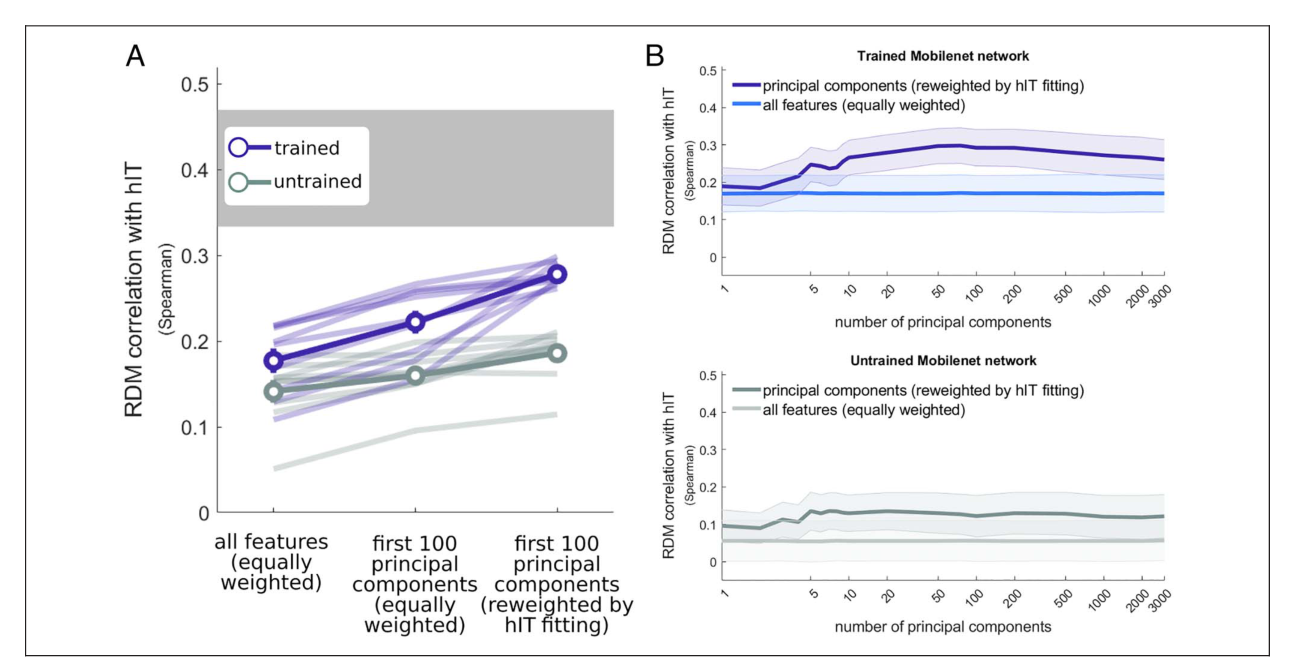
图 8 · 同一批模型也能解释 V1
原文图注:Figure 8. The same models are able to well explain the very different representations in V1. (A) Representational dissimilarity of the same 62 experimental images in V1 (top) and hIT (bottom; as in Figure 1B) averaged over participants. There was good interindividual consistency within each region, but there were substantial differences in representational geometry between regions. (B) Bars show an estimate of the combined performance of all layers within each of the networks, obtained by second-level (across-layer) fitting in all cases. Pale gray bars show the V1 match for the raw (unfitted) feature space of a randomly weighted instance of the network, dark gray bars show V1 match for the same random feature space after PCA reduction and within-layer reweighting on V1 data, pale blue bars ……
A 图并列呈现 62 张刺激在 V1(上)与 hIT(下)的群体平均 RDM。两区域的表征结构存在显著分歧(跨区域互预测相关仅 r=.163),证实二者具有截然不同的表征几何。B 图展示模型对 V1 表征的预测表现:训练主效应(F(1,35)=15.40)与拟合主效应(F(1,35)=20.46)均达显著水平,交互效应未达显著(p=.09);训练且拟合后,五个模型(Resnet-18/50、Densenet、InceptionResnet、Mobilenet)达到与噪声天花板下界无显著差异的水平。结果表明,同一批卷积网络特征在重加权后能够分别有效解释表征几何差异巨大的早期视觉区(V1)与高级视觉区(hIT)。
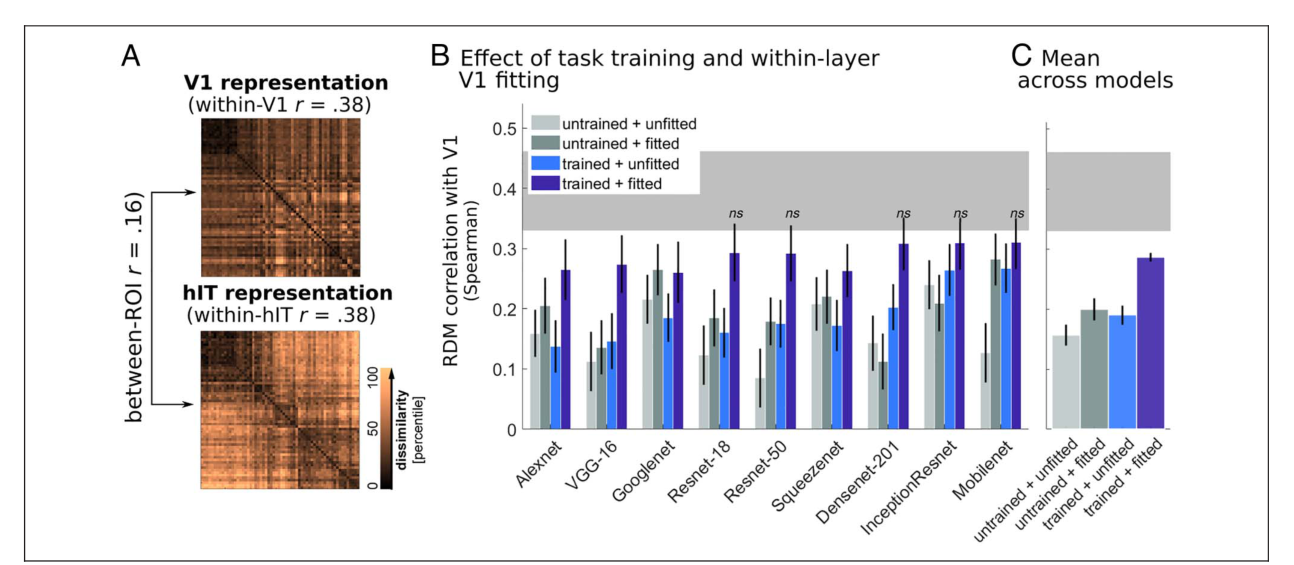
图 9 · 层-区域对应:拟合之前看不见,拟合之后浮现
原文图注:Figure 9. Fitting most improves the performance of deeper layers when predicting hIT and earlier layers when predicting V1. (A, Left) Mean and 95% confidence interval across nine DNNs of smooth splines fit to layerwise hIT correlation, normalized by network depth (raw values are shown in Figures 3 and 4), for (gray) untrained and unfitted models, (pale blue) trained but unfitted models, and (dark blue) trained and within-layer hIT-fitted models. (A, Right) Mean and 95% confidence interval of smooth splines fit to the difference in hIT correlation between either (pale blue) trained unfitted minus untrained unfitted networks or (dark blue) trained and fitted minus trained but unfitted networks. ……
A 行对应 hIT,B 行对应 V1。左列展示九种网络在逐层相关分析中的平滑样条曲线(均值与 95% 置信区间):在仅训练未拟合的状态下,hIT 与 V1 的最佳预测层归一化深度位置无统计显著差异(0.56 对比 0.59,t(8)=−0.10,不显著)。右列展示“训练减未训练”与“拟合减未拟合”的性能差值样条曲线:拟合带来的增益峰值在 hIT 显著集中于深层(0.76),在 V1 则显著集中于浅层(0.35,t(8)=3.73, p=.006)。这表明“浅层对应早期视觉区、深层对应高级视觉区”的层级对齐关系,在该数据集上需要借助特征重加权才能清晰显现。
讨论
作者将发现梳理为三层理论意涵。首先,关于机制来源:任务训练带来的适度收益表明具备空间结构的视觉特征(图像统计与冗余)是解释 hIT 表征的基础,支持了“生态相关任务塑造类脑表征”的规范取向(normative approach);但线性拟合带来的显著更大收益(+124%)揭示出 ImageNet 的目标分类函数——其类别分布并不完全契合人类日常视觉体验,且缺少人或面孔等类别——难以自发建立与人脑一致的特征相对权重。此外,神经测量技术本身会扭曲皮层特征的抽样权重(Kriegeskorte & Diedrichsen, 2016),为重加权拟合提供了方法学合理性。其次,关于模型比较:在训练且拟合后,九种网络架构两两之间的差异在统计上与人类被试间的自然变异等价,且架构在不拟合时的性能差异与网络深度、分类精度、训练前相关性或 V1 预测力均无显著关联(如 ImageNet 分类准确率与 hIT 相关的关联未达统计显著)——说明各网络所共有的深层前馈层级、感受野逐层扩展以及受限空间滤波特性,比各架构间的具体设计细节发挥着更决定性的作用。该发现与 Geirhos 等(2020)基于行为数据得出的收敛结论相互印证,提示未来的理论突破更有赖于循环网络架构、生物学学习规则及训练目标体系的探索。最后,研究阐明了自身局限:每种架构仅测试单一训练实例,无法完全剥离架构差异与训练初始化的偶然方差;模型平均解释了 48% 的可解释方差,虽与猕猴电生理数据相当,但距离理论上限仍有提升空间;此外卷积神经网络在对抗噪声鲁棒性及对纹理的过度依赖等已知缺陷,提示在解释模型等价性时仍须保持审慎。
一句话总结
本研究将深度神经网络对腹侧通路的预测能力严格解耦为架构偏置、任务训练和事后线性特征拟合三个部分:证实未训练的网络架构先验贡献微弱,ImageNet 任务训练贡献了约五成的表征对齐增益,而线性特征重加权则带来成倍的匹配提升并抹平了不同网络架构间的性能差异。这表明在评估人工神经网络的“类脑性”时,必须严格区分特征表示本身的丰富度与特征维度的重加权拟合效应。