一句话定位:这篇文章用作者自家的四层无监督模型 VisNet(腹侧视觉流物体识别模型)回答两个互补的问题:其一,视不变物体识别所需要的"非意外属性"(non-accidental properties, NAPs,如边缘是凸是凹)能否由生物上合理的无监督学习自动编码出来、而对"度量属性"(metric properties, MPs,如曲率大小)保持不变;其二,层级网络的高容量从何而来——顶层神经元各管一个物体时,中间层神经元是否被多个物体复用。两个问题的答案都是肯定的,而且作者给出了 NAP 学习的一个新机制理论。
研究背景
按 Biederman 的识别理论,物体在深度旋转中保持不变的图像性质——如轮廓的直线性、两条轮廓的共终止(cotermination)——即非意外属性(NAPs),是视不变识别的有用线索;而长宽比、曲率程度这类随视角连续变化的度量属性(MPs)则用处不大。这一区分有心理物理学与功能成像证据支持,且已知猕猴外侧枕皮层与下颞叶皮层(inferior temporal cortex, IT)的神经元对 NAP 的调谐强于对 MP 的调谐(Vogels 等 2001;Kim & Biederman 2012)。但在模型层面,NAP 如何在腹侧流的不变识别机制中形成,几乎没人研究过。
缺口有二。一是机制层面:此前唯一相关的工作(Parker & Serre 2015,在 HMAX 中加入时间痕迹规则)虽然表现出偏向 NAP 的性能,但概念未讲清楚,也没有证明模型能泛化到度量值不同的其他物体;深度网络节点虽也偏好 NAP(Kubilius 等 2016),但那可能只是因为 NAP 更能区分视角,无法说明脑内机制(反向传播、监督学习与神经元计算相去甚远)。二是容量层面:若 IT 神经元是物体选择性的,那么"物体由部件组合而成"所需的大量中间特征组合细胞从哪来?若每层都要表达高阶组合,神经元数量在生物学上不可行。作者提出的替代假设是:每层只学低阶特征组合,逐层重复后在顶层自然涌现物体选择性,而中间层神经元应被多个物体共享——这一性质此前同样几乎没有被检验过。
研究思路
全文围绕两条假设展开。第一条针对 NAP:VisNet 的架构(无监督竞争学习+时间痕迹学习规则 temporal trace learning rule)应当既能形成 NAP 表征、对 MP 相对不敏感,还能在没有任何显式训练告诉它"这两个物体有共同属性"的情况下,泛化到具有相同 NAP、不同度量值的物体。为此作者设计了 7 个薄板状物体(3 个凹边、1 个直边圆柱、3 个凸边),每个给出 8 个前后倾角视角,训练后用群体相关矩阵与单神经元"物体×视角"响应矩阵检查层 4 表征。作者还顺势提出一个文中标注为"文献中未有过"的新理论:同一物体在不同视角下呈现一系列不同的曲率值,痕迹规则把它们关联学习;由于另一物体的某些视角恰好共享其中一些曲率值,泛化便自然发生——NAP 的不变性是从 MP 的重叠里"长"出来的。
第二条针对层级编码:把一个正方形的四条边及其一切相邻组合共 13 个"物体"全部训练给 VisNet,若层 4 对 13 个物体的表征相互正交、而中间层(2、3 层)神经元对多个物体都有响应,就证明中间层细胞可被多个物体复用,这正是高容量的来源。选择如此简单而定义清晰的刺激集,正是为了让组合编码的结论一目了然。
方法
VisNet 是四层层级化收敛竞争网络:输入层为 256×256×16 的 V1 简单细胞模拟——二维 Gabor 滤波器组(空间频率 0.0625–0.5 周期/像素跨四个八度、朝向 0°–135° 每 45° 一档、正负相位各半,参照简单细胞四分相位对的实验证据);层 1 至层 4 各 32×32 神经元,分别对应 V2、V4、后 IT(TEO)与前 IT(TE)。前馈连接取自前一层一个拓扑局部区域,连接概率按高斯径向衰减,各层感受野逐层增大(模拟 V1 的 1.3° 到 TE 的 50° 收敛)。层内用局部侧抑制(半径与收敛范围相当)+sigmoid 对比增强实现竞争,各层发放稀疏度设为 0.02/0.01/0.01/0.02。
学习规则是关键:采用修改版 Hebb 痕迹规则 δw=α·y(τ−1)·xj,即用前一时刻的突触后活动痕迹(而非当前时刻)更新权重——因为按视觉世界的时空统计,前一时刻的图像很可能来自同一物体的另一变换。痕迹参数 η 第 2 层 0.6、第 3、4 层 0.8;第 1 层用纯联想学习(不带痕迹),以便在不变性学习开始前先以高空间精度形成特征组合。学习率极慢(第 2 层 0.4,第 3、4 层 0.1),权重显式归一化,共训练 10 个 epoch;痕迹的生物学基础包括 NMDA 通道谷氨酸结合约 100 ms、以及 16 ms 闪光后神经元持续发放 100–400 ms 的时间窗(时间上相差约 1 s 以内的视觉事件才可能来自同一物体)。性能用与真实神经元分析同构的 Shannon 信息量(单细胞信息与多细胞信息)度量,另用全层神经元对每个物体(含全部变换)响应的物体间相关矩阵、以及单神经元的物体×视角发放率矩阵来刻画表征结构。
主要结果
- 层 4 神经元按 NAP 分组编码、对 MP 不变。在 7 物体×8 倾角(±6°、±19°、±32°、±45°)刺激集上训练 10 个 epoch 后,层 4 一部分神经元对全部凹边物体(1–3)的任何视角响应、对其他物体不响应;另一些分别调谐于直边圆柱(物体 4)或凸边物体(5–7)。群体相关矩阵显示:同一 NAP 组内 8 个变换彼此高相关,圆柱与凹边组不相关、与凸边组仅微弱相关;如需保留图 5 处的表述,注明那是 3.1 节后段关于神经元群体响应的补充说法。
- 单神经元层面成立。选出的层 4 例神经元(编号 883)对全部凹边物体的所有 8 个视角均有响应、对其余物体为零(图 5)——即单细胞既学会了 NAP(凹 vs 直 vs 凸),又对曲率这一度量属性完全不变;尽管凹边群体整体对圆柱有小响应,部分神经元仍能完美区分二者。
- MP 不变性与跨物体泛化的新机制。痕迹规则把同一物体各视角的一系列曲率值关联起来学习;不同物体(如物体 1 与 2)的部分视角共享相似曲率值,于是无需显式关联训练即发生跨物体泛化——凸边物体 5–7 之间从未被"告知"彼此相关,单个神经元与群体却都响应全部凸边物体(图 3、4)。
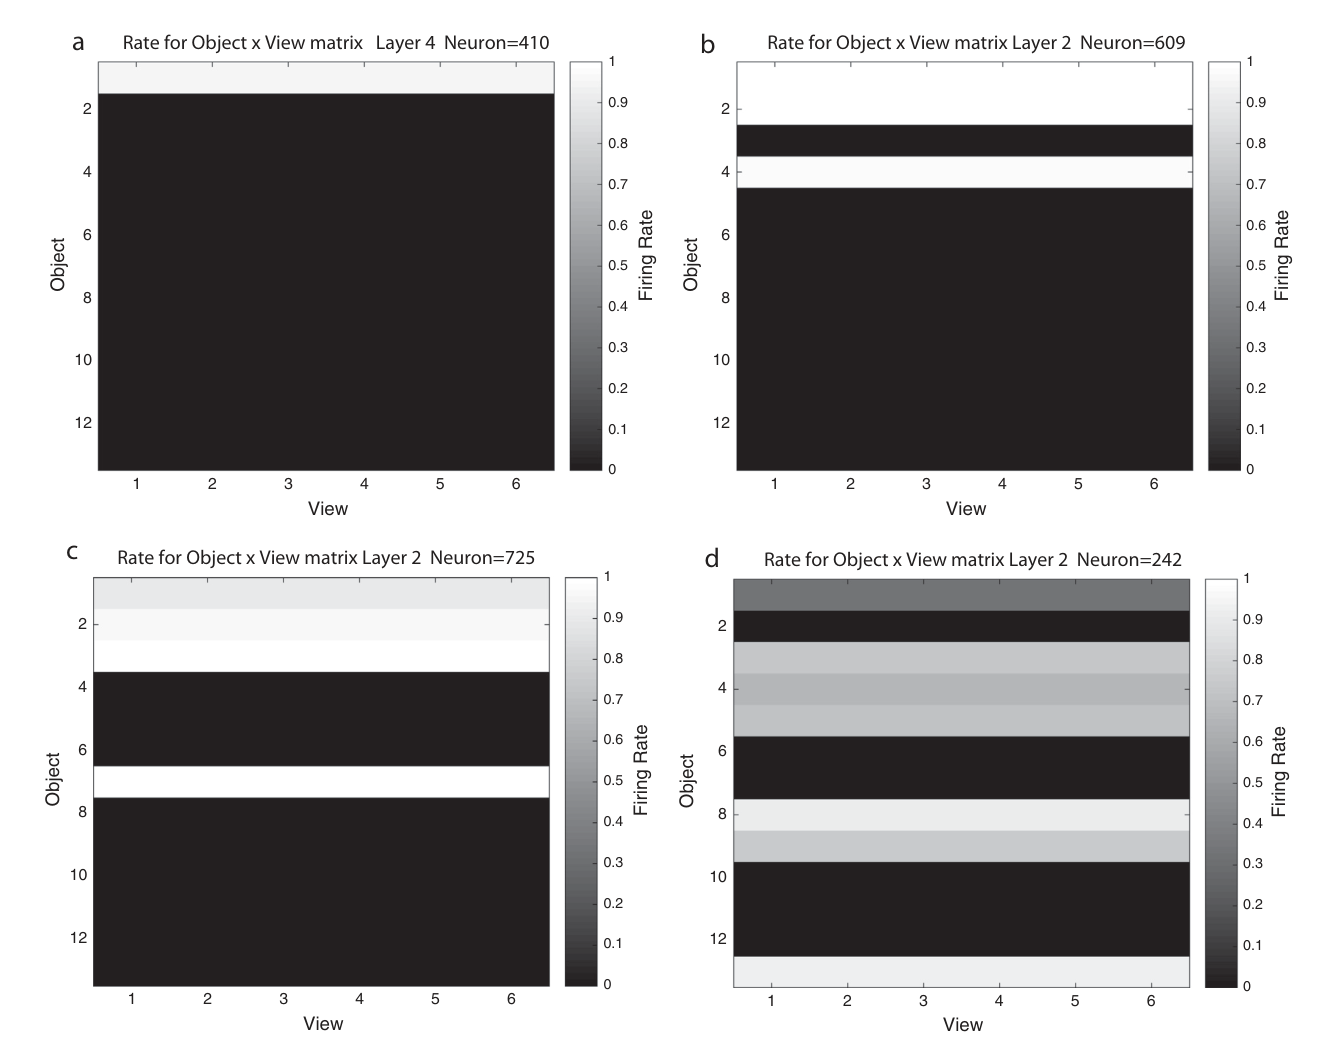
- 中间层复用、顶层正交。方形实验中,层 4 对 13 个物体的表征相互正交(相关矩阵呈块对角;例神经元 410 只响应整正方形、不响应任何部件组合,图 7、8a);层 3 表征已部分不正交,层 2、1 则高度不正交——层 2 例神经元 609 在响应物体 1 的同时也响应物体 2 与 4,神经元 725 响应物体 1、2、3、7,而调谐于顶边(物体 13)的神经元 242 对同样含顶边的物体 8、9、3、4、5、1 呈梯度响应(图 8b–d)。
- 容量的解释。中间层神经元作为低阶特征/特征组合的"公共部件"被多个物体复用,整流到顶层才显式化为正交的物体表征,这是四层腹流通路能表达大量物体的关键;这一编码方式与 IT 皮层"信息随神经元数量近似线性增长"的独立编码特征相吻合。
图注解读
图 1 · 特征层级式物体识别的架构思想
原文图注:Fig. 1. The feature hierarchy approach to object recognition. The inputs may be neurons tuned to oriented straight line segments. In early intermediate levels neurons respond to a combination of these inputs in the correct spatial position with respect to each other. In further intermediate levels, of which there may be several, neurons respond with some invariance to the feature combinations represented early, and form higher order feature combinations. ……
这是理论框架图:自下而上从朝向调谐的线段输入,到早期中间层在正确空间排布下组合特征,再到更高级中间层形成带部分不变性的高阶组合,最后顶层以位置(及尺度、甚至视角)不变的方式给出物体证据;网络收敛设计使顶层能收到来自整个"视网膜"的信息。读图抓两点:每层只做低阶组合、不变性逐层累积。它支撑"研究思路"中关于层级编码的总体假设。
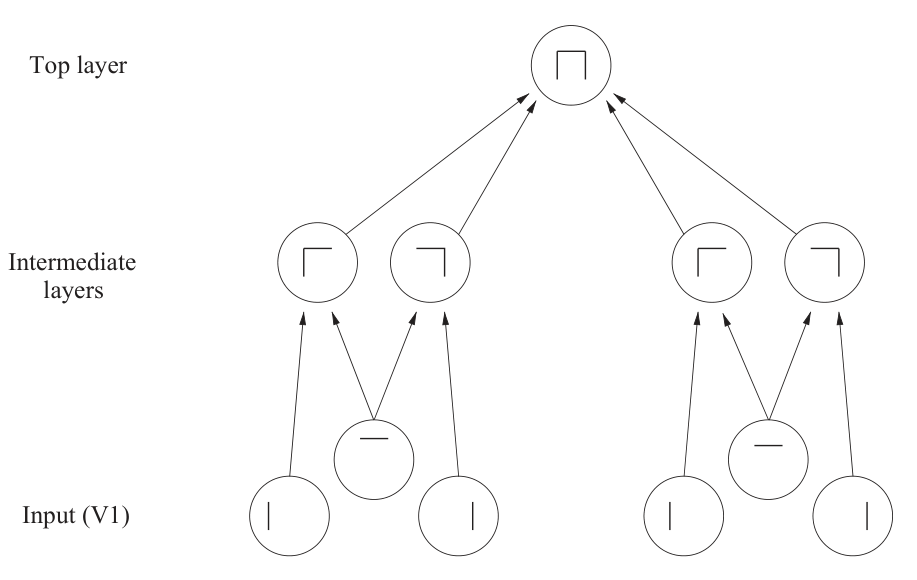
图 2 · 收敛架构:脑与 VisNet 的对应
原文图注:Fig. 2. Convergence in the visual system. Right – as it occurs in the brain. V1, visual cortex area V1; TEO, posterior inferior temporal cortex; TE, inferior temporal cortex (IT). Left – as implemented in VisNet. Convergence through the network is designed to provide fourth layer neurons with information from across the entire input retina.
图的右半是灵长类视觉系统(V1→V2→V4→TEO→TE)各级感受野从小到大的收敛示意,左半是 VisNet 的实现(层 1–4 对应 V2、V4、TEO、TE);横轴为视网膜偏心距、纵轴为感受野尺寸(度),从 V1/LGN 的 1.3° 一路放大到 TE 的 50°。它支撑"方法"中关于连接几何的设计描述——层 4 神经元因此原则上能整合全视野信息,这是平移不变性的解决方案。
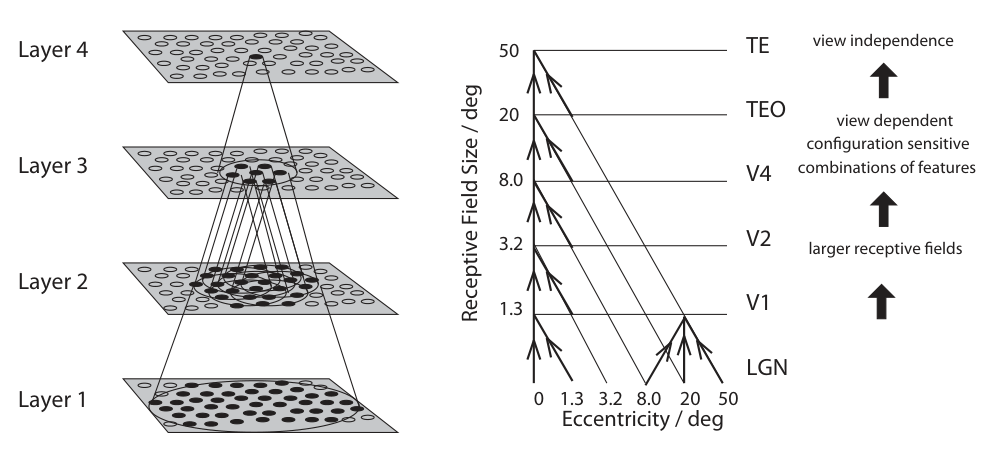
图 3 · NAP 与 MP 刺激集
原文图注:Fig. 3. Encoding of non-accidental properties. Stimuli used to investigate non-accidental properties (NAP) vs metric properties (MP). Each object is shown as white on a grey background. Objects 1–3 have the non-accidental property of concave edges. Object 4 has the non-accidental property of parallel edges. Objects 5–7 have the non-accidental property of convex edges. ……
7 个物体各占一行、8 个倾角(−45° 到 +45°)各占一列。关键读法是沿行看变换:凹边物体倾斜时曲率程度不断变化(这是 MP,不该被编码),但"凹"这一性质始终在场(这是 NAP,应被编码);直边圆柱的直线性同样跨视角不变。物体上下面被裁掉以排除其他线索。它支撑主要结果第 1、3 条的刺激设计逻辑,也直观呈现"MP 重叠→NAP 泛化"的新机制:物体 1 与 2 在某些视角下的曲率值彼此重合。
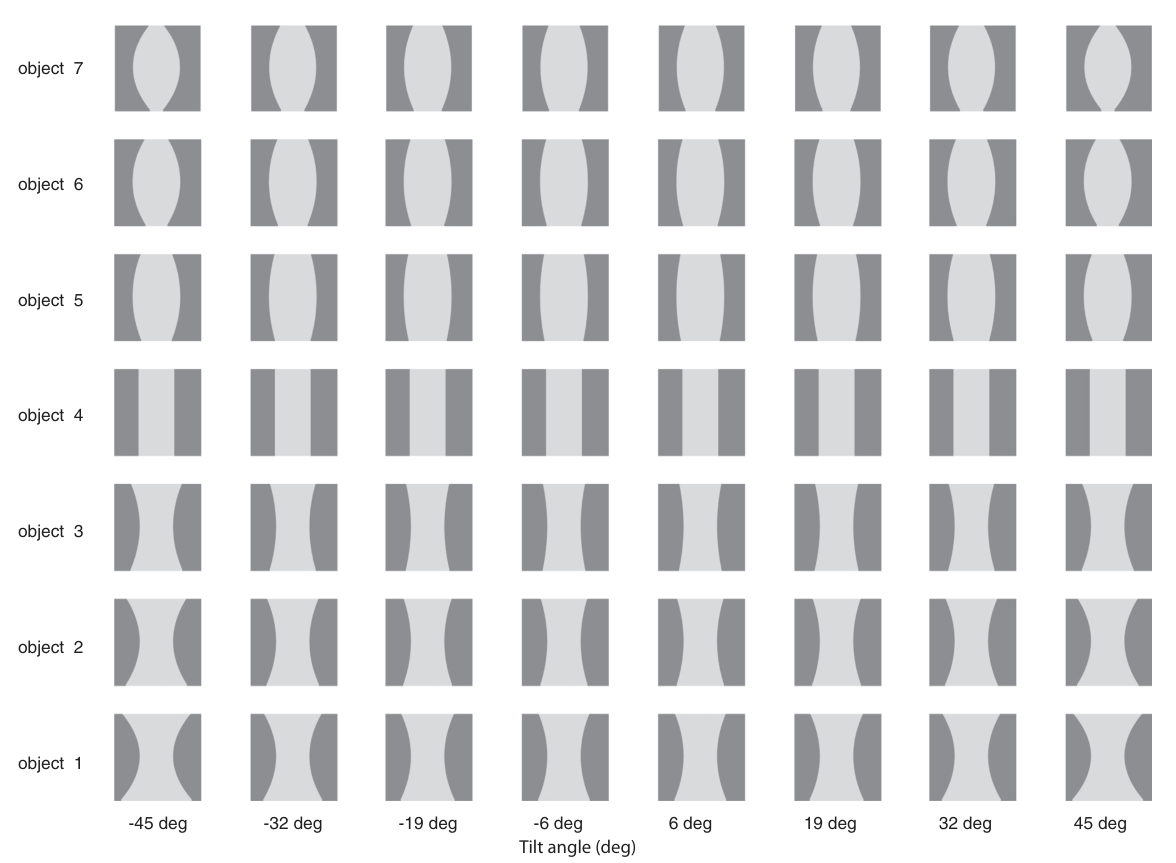
图 4 · 层 4 群体相关矩阵:按 NAP 聚块
原文图注:Fig. 4. Encoding of non-accidental properties. Correlations between the neuronal representations of the 7 objects used in the non-accidental property (NAP) investigation provided in VisNet layer 4. Each NAP object had 8 transforms, as illustrated in Fig. 3, and so each object in the correlation matrix is represented by each of its 8 transforms (with transform 1 of each object corresponding to a tilt of −40 deg). ……
56×56 的相关矩阵(7 物体×8 变换),行列都按物体分组。读法:沿对角线的三个大亮块分别对应凹边组(1–3)、圆柱(4)、凸边组(5–7)内部各变换之间的强相关;块与块之间接近零相关,凹边组与圆柱间仅剩微弱相关。这说明层 4 的群体表征按 NAP 归类、对倾角变换不变,直接支撑主要结果第 1 条与第 3 条(凸边 5–7 从未被显式关联训练,却聚为一类)。
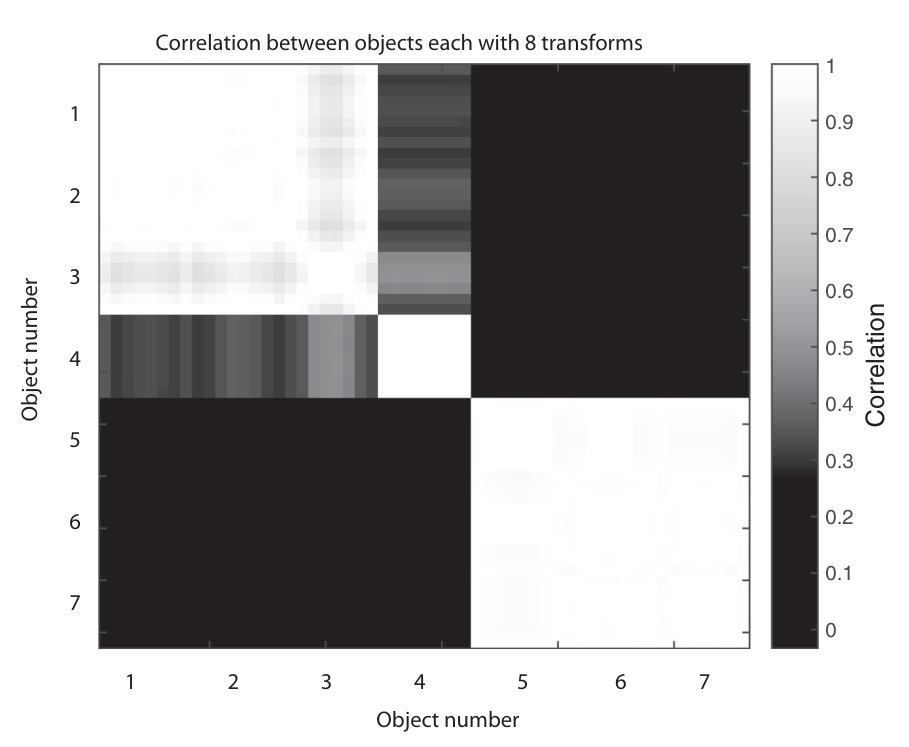
图 5 · 单神经元对 NAP 的选择性与对 MP 的不变性
原文图注:Fig. 5. Encoding of non-accidental properties. Responses of a single neuron in layer 4 of VisNet to the set of 7 objects each shown with eight views. View 1 corresponds to a tilt of −40 deg as shown in Fig. 3, and view 8 to +30 deg. Objects 1–3 have the non-accidental property of concave edges. Object 4 has the non-accidental property of parallel edges. Objects 5–7 have the non-accidental property of convex edges.
这是例神经元 883 的"物体×视角"发放率矩阵:行是 7 个物体、列是 8 个视角,纵轴为发放率。读法:前三行的整行都高(对全部凹边物体、全部视角响应),后四行全为零——单细胞水平同时实现了 NAP 选择性与跨视角、跨曲率程度的不变性。它支撑主要结果第 2 条,并回应一个潜在质疑:群体层面的小相关(图 4 中凹边与圆柱)不代表每个细胞都混淆二者。
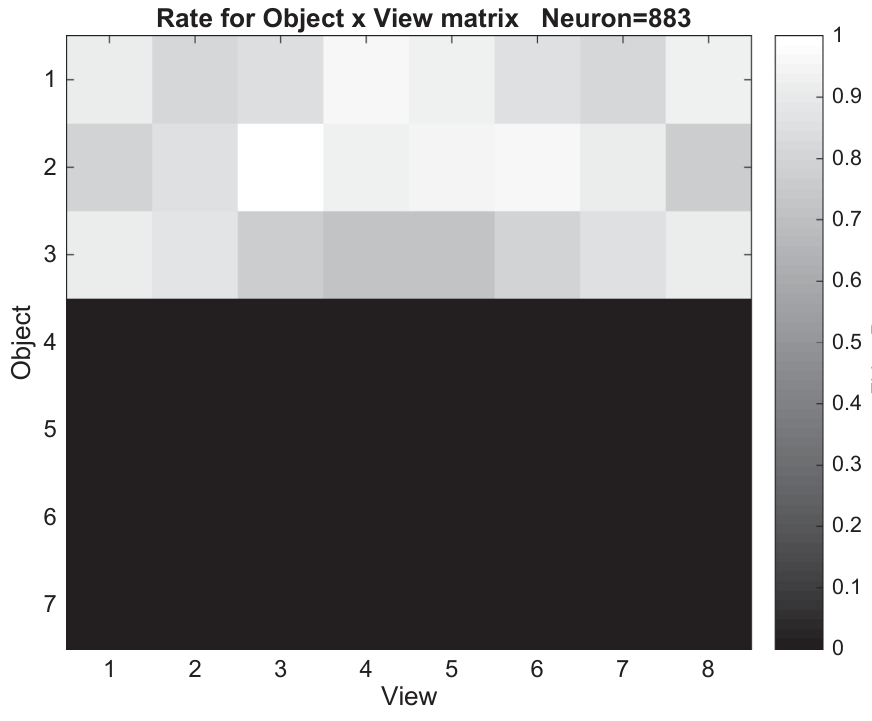
图 6 · 方形实验的 13 个刺激
原文图注:Fig. 6. Encoding of information in intermediate layers of VisNet. Stimuli used to investigate coding of feature combinations in intermediate layers of VisNet. Every feature or feature combination with adjacent features was a different object to be learned as a different object by VisNet.
物体 1 是完整正方形,其余 12 个是其四条边(线段)的各种相邻组合——单边、两边角、三边 U 形等。每个特征或相邻特征组合都被当作一个独立"物体"训练。这个刺激集的价值在于:部件之间的包含关系完全已知,正交性与复用性可以被干净地判定。它支撑主要结果第 4 条的刺激逻辑,也是解读图 7、8 的钥匙。
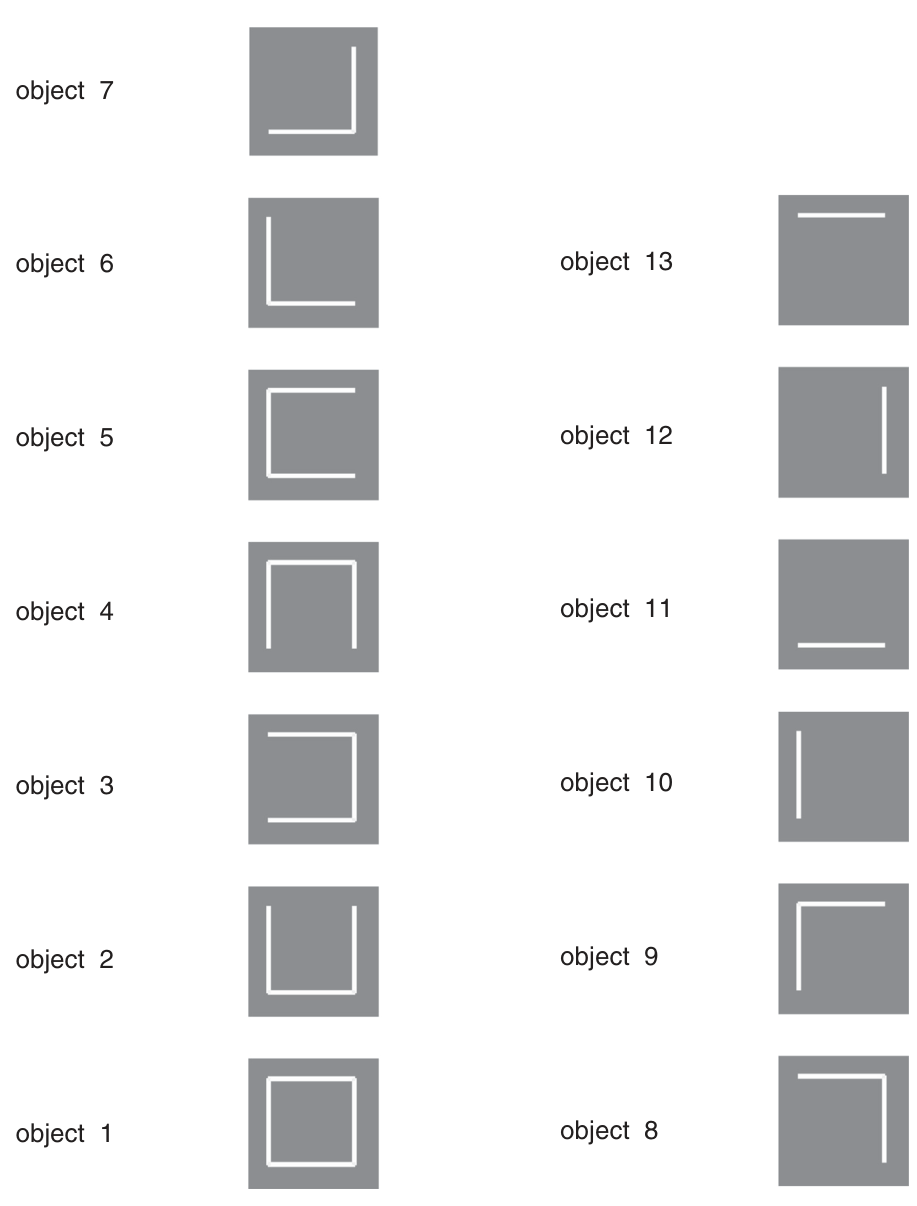
图 7 · 四层的物体相关矩阵对比:从弥散到正交
原文图注:Fig. 7. Encoding of information in intermediate layers of VisNet. Correlations between the firing of neurons that represent each of the 13 objects in the Square experiment in different layers of VisNet. Layer 4 is the top layer, and layer 1 is the layer that receives from V1.
四个 13×13 相关矩阵分别对应层 4、3、2、1。读法:层 4 呈清晰块对角结构——每个物体只与自身相关,表征正交;层 3 已出现跨物体的次级相关;层 2 与层 1 的矩阵大面积不正交,含大量部件共享导致的跨物体相关。从下往上看是"弥散部件 → 正交物体"的逐层显式化过程,支撑主要结果第 4 条。
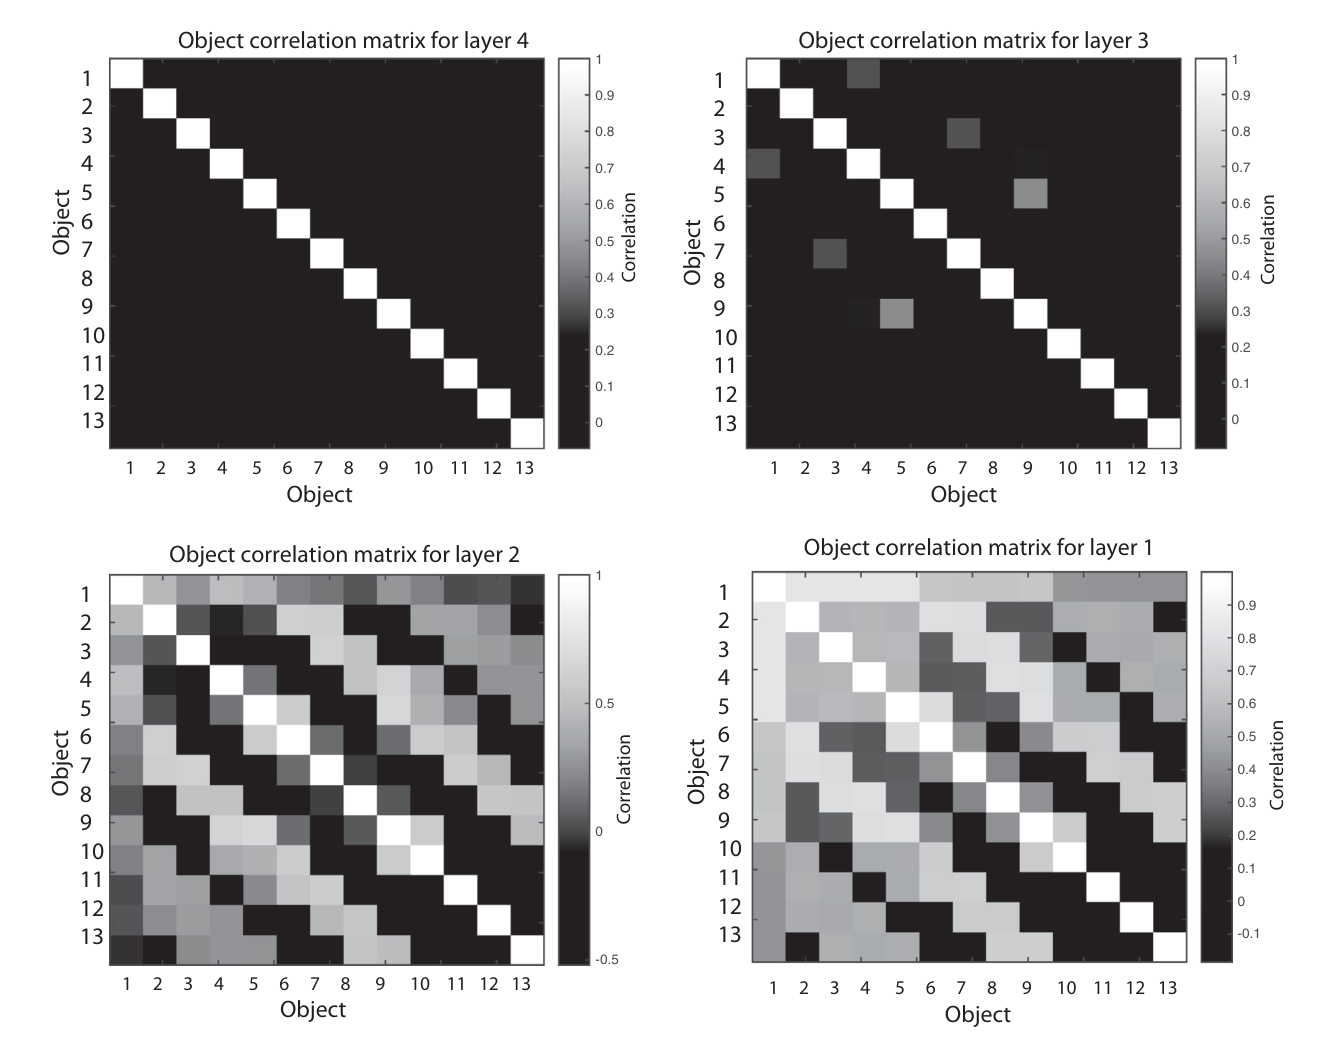
图 8 · 单神经元调谐:顶层专一、中间层复用
原文图注:Fig. 8. Encoding of information in intermediate layers of VisNet. Examples of the tuning of single neurons in different layers to the set of stimuli. (a). A neuron in layer 4 selected to have responses to object 1, the whole square, responded only to that object, and not to any of the components (objects 2–13). This exemplifies the orthogonal object selectivity of single neurons in layer 4. (b). A layer 2 neuron selected to have responses to object 1 also in fact responded to objects 2 and 4 (with the objects illustrated in Fig. 6). ……
四个"物体×视角"发放率矩阵(为便于解读,此实验中各物体的视角相同):删去'的 6 个视角'或对物体 1 的全部视角;若能核对 figures/023/fig-8.png 原图确认视角数再写具体数字;(b)(c) 两个层 2 神经元都以物体 1 为最佳,但同时响应多个含共享部件的其他物体;(d) 调谐于顶边的层 2 神经元 242 对所有含顶边的物体呈不同梯度的响应。读图要点是对比 (a) 与 (b)–(d):同一套刺激下,顶层正交、中间层分布式复用。它支撑主要结果第 4、5 条——这正是高容量的微观基础。
讨论
作者对机制的表述很直接:物体在短时间内的连续视角变换,经慢学习(痕迹规则)把不断变化的度量属性值(如曲率程度)彼此关联起来;这种对 MP 的不变性学习进而使神经元泛化到具有相同 NAP 但不同度量值的其他物体——因为后者的部分视角与已学习的度量值重叠。由此,NAP 选择性与 MP 不变性在无监督学习中一并出现,为 Biederman 的识别理论提供了可实现的学习机制。在编码效率方面,作者援引自己实验室在 IT 皮层的一系列发现:单神经元对刺激集的响应谱接近不相关、信息随取样神经元数近似线性增长,是独立编码的标志;本文显示 VisNet 中间层神经元具有同样的性质,从而加强了 VisNet 作为腹流模型的合法性。与文献的对话集中于两点:一是与 Parker & Serre(2015)的带痕迹规则 HMAX 相比,本文把 NAP 编码的概念讲清楚了,且首次证明了向度量值不同的新物体的泛化;二是对深度学习的批评——监督学习与数百层处理在生物学上不可信,脑的处理速度把层级加工限制在 4–5 个皮层区(引 Marcus 2018 与其本人 2016 年专著),而 Kubilius 等(2016)观察到深度网络偏好 NAP 可能只是 NAP 区分度更高的副产品。作者亦坦承这些只是模型层面的演示,其结论的价值在于凸显腹流计算的基本原则,而非对真实皮层的定量复现;至于容量数值本身有多大,文中未详述。
一句话总结
(我的理解)这篇论文里我最喜欢的是第 2.7.2 节那个"副产品变机制"的推理:NAP 不变性不需要专门为它设计的模块,它就是痕迹学习把一组连续变化的曲率值捆在一起后,不同物体恰好共享其中部分值的自然结果——这把 Biederman 理论从"描述性假设"推进到了"可生长的机制"。方形实验则用最笨办法(枚举全部部件组合)回答了层级网络的老问题:中间层不必各管一个物体,复用即容量。当然,VisNet 的无监督、慢学习路线与深度学习路线谁更接近脑,2018 年那场论战在这篇文章里只是单方面陈词;我认为把它当作对"无监督层次竞争学习够不够用"的一个有力例证来读,比当作对 DNN 的反驳来读更公允。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[] - Fig7: 提取质量
good,对齐度full,识别面板[] - Fig8: 提取质量
good,对齐度full,识别面板[A]
关键事实与局限性声明
- 审校纠偏: {'md_section': '讨论', 'current_text': '作者亦坦承这些只是模型层面的演示,其结论的价值在于凸显腹流计算的基本原则,而非对真实皮层的定量复现', 'problem': "原文并未'坦承只是模型演示';相反,讨论明确主张该机制'we propose in the ventral cortical visual stream'也同样成立,并以'adds further strength to Rolls' theory'收尾。MD 此句把作者立场写得比原文更谦逊,属轻度反向过度解读(方向无害但与原文不符)。", 'severity': 'minor'} -> 评注:
- 补充要点: 方法 2.6 节宣称用 Shannon 单细胞/多细胞信息量度量性能,但结果部分实际只报告了相关矩阵与单神经元响应矩阵,未给出任何信息量数值;MD 在方法段照写了信息论度量,却未指出结果中并未呈现,读者无从判断该度量的实际角色。
- 补充要点: 方形实验的关键限定'本仿真中各物体视角相同(for this simulation the views for each object were the same)'虽在图 8 解读中提及,但在主要结果第 4 条中未出现;该限定意味着方形实验检验的是组合编码而非变换不变性,值得在结果层面点明。
- 补充要点: 原文内部存在学习率表述不一致(第 3 页称四层学习率为 20/0.4/0.1/0.1,第 4 页称 0.4/0.4/0.1/0.1);MD 只引用了后者且略去层 1,虽未出错,但可注明原文两处不一致。