一句话定位:这篇文章问了一个看似简单、实则根本的问题——下颞叶(inferior temporal cortex, IT)皮层的单个神经元,是如何把"这是什么物体"与"这个物体此刻的大小、位置、视角"这两类信号组合在一起的?作者在五组猴 IT 电生理实验中证明:需要各自独立解码的信号(身份与图像属性)以乘法混合,而需要整合的信号(物体的两个部件)以加法混合。这篇值得精读,因为它把"不变性表征"这个老话题落到了单个神经元的响应方程上,并展示了加性/乘性这一细微差别如何造成群体解码的巨大差异。
研究背景
物体识别之所以难,是因为同一物体在视网膜上产生的图像随大小、位置、朝向和深度旋转而千变万化,身份信号与图像属性(image attributes)信号混在一起。IT 皮层是猴物体识别的关键脑区。早期流行的"祖母细胞"假说设想那里存在高度不变、只编码身份而丢弃一切属性的细胞;这一想法基本已被否定——大多数 IT 神经元同时受物体身份与位置、大小等属性调制,群体水平上既能跨属性变化解码物体身份,也能解码属性本身。近期工作进一步表明,同一批细胞被两种信号强烈调制,且其物体偏好能跨大小、位置与朝向保持。
但这些研究只说明了两种信号"都被编码、且彼此独立",并没有回答它们如何组合、以及什么样的组合方式才是高效的。作者的切入点是一个常被忽略的数学细节:相加与相乘看似只差一点点,功能后果却大不相同。两个信号相加时,小信号对总和的调制远弱于大信号,容易被淹没;相乘时,小信号对乘积的调制幅度与大信号相当,两类信号都能被下游轻易读出。因此"加法还是乘法"直接关系到表征效率,而这正是当时文献的空白。
研究思路
作者先用模拟神经元做一个概念演示:给同一组物体调谐和属性调谐,分别按乘法与加法组合,看哪种让线性分类器解码更好(图 1A–C)。随后提出核心假设——IT 神经元在信号需要独立解码时相乘、在需要整合时相加——并把它拆成五组实验(图 1D):实验 1–4 操纵各种身份保持属性(大小、位置、平面内旋转、深度旋转、面孔视角),检验身份×属性是否乘性可分离;实验 5 用左右部件组合成的双部件物体作为对照,预测部件信号应加性整合。
整套设计的逻辑链是:单神经元上比较五个响应模型(乘性、加性、仅物体、仅属性、混合)→ 用模型预测仿真群体做解码,检验"单细胞层面的细微差异是否在群体层面放大"→ 跨四组属性实验汇总,并与 V1 模型、深度卷积网络对比,判断乘性可分离性是低层继承的还是高层涌现的。另一个容易被忽视的关键设计是:所有物体在每种属性上被"对齐"(equated)——比如统一大小、统一位置——因为若属性在各物体间不对齐,乘性可分离性在数学上无从谈起(正文用打乱响应的对照验证了这一点)。
方法
两只 7 岁冠毛猕猴(Macaca radiata,bonnet macaque;Ka 与 Sa)。,在左侧 IT 皮层(MRI 验证位于前腹侧 IT)用 24 通道层状电极(Uprobe,Plexon)以 40 kHz 采样记录,离线做 spike sorting,只保留分离良好且有视觉反应的单元。行为任务是中央注视任务:每试程呈现 8 个刺激,每个 200 ms、间隔 200 ms,同一物体的图像不相邻以避免适应,每张图约重复 8–11 次。
五组刺激集分别是:实验 1,10 个物体(5 动物、5 非动物)×4 种属性(大小、位置、平面内旋转、深度视角)各 3 个水平(含参考图),共 90 个刺激,记录 127 个神经元、取 111 个发放可靠者;实验 2,10 个物体 ×7 个绕 y 轴视角(±60°、±30°、±15°、0°,以"贫瘠视角" impoverished view 为基准),113 录 83 用;实验 3,4 个物体绕 x/y/z 三个主轴各转 60°–300°,50 录 34 用;实验 4,16 张人脸 ×5 个视角(±90°、±45°、0°),117 录 78 用;实验 5,水平茎两端各 7 种部件组合成 7×7=49 个物体,180 录 144 用。可靠性以奇偶试次发放率相关的显著性筛选。
分析的核心是给每个神经元构建"物体×属性"响应矩阵,拟合五个模型:加性模型 r(i,j)=aᵢ+oⱼ(行均值+列均值)、乘性模型 r(i,j)=aᵢ·oⱼ(用 SVD 取第一奇异向量外积;也用行均值×列均值复核)、仅物体、仅属性模型,以及混合模型 R=a·Rₐ+m·Rₘ。模型在奇数试次上拟合、偶数试次上检验,并以 split-half 相关归一化——归一化相关接近 1 即解释了全部可解释方差。计算模型(V1 模型与深度卷积网络)因无试次变异改用留一交叉验证;另定义乘性可分离性指数 SI(第一奇异值占奇异值总和的比例)。群体解码用线性分类器,并跨属性泛化(在一个大小上训练、在另一个大小上测试)。
主要结果
- 单神经元层面,乘性模型稳定胜出。模拟显示乘法组合产生更尖锐的调谐与更高的单细胞解码(图 1C)。实验 1 中,例神经元的乘性模型拟合 r=0.86(其 split-half 可靠性为 0.80±0.03);群体平均相关 0.55±0.19,归一化相关达 1.10±0.26(112 个有显著 split-half 相关的神经元中 108 个模型拟合显著),且对每个属性单独检验、对刺激后 0–100 ms 与 100–200 ms 两个时窗分别检验都接近 1。乘性模型显著优于加性、仅物体、仅属性模型(图 2E, F)。
- 完全不变的细胞既少又低效。ANOVA 显示 65%(83/127)的细胞同时受身份与属性调制,仅 18%(23/127)只受身份调制;后者对物体的调谐反而更宽(稀疏度 0.06 对 0.12,P<0.005),身份解码也更差(22% 对 43%,机会水平 10%)。也就是说,携带属性调制的乘性细胞才是 IT 的主体,也是身份信息的主体。
- 单细胞的细微差别在群体层面被放大。用乘性与加性模型预测分别仿真泊松发放群体做线性解码:物体解码 96% 对 87%(1000 次 bootstrap 中加性从未更高,P<0.001),属性解码 65% 对 52%(P=0.006)(图 3B)。
- 结论跨属性、跨物体类型泛化,且为高层涌现性质。实验 2(y 轴旋转,例神经元 r=0.90,群体归一化相关 0.97±0.25)、实验 3(三主轴旋转)、实验 4(面孔视角)均复现乘性可分离(图 4;实验 3、4 结果见 SI Text);跨实验汇总的 307 个神经元上乘性模型在归一化相关与大小/小响应残差上全面最优(图 5A, B),但仅 46/307 个单细胞能显著区分两模型,其中 82% 偏向乘性(P<0.00005,χ² 检验)。V1 模型单元最佳用加性解释(图 5C),深度网络单元也偏加性(图 5D),但两类模型的加性与乘性拟合都随层加深而变好,且可分离性指数 SI 呈 IT > 深度网络 > V1 的次序(图 5E)。
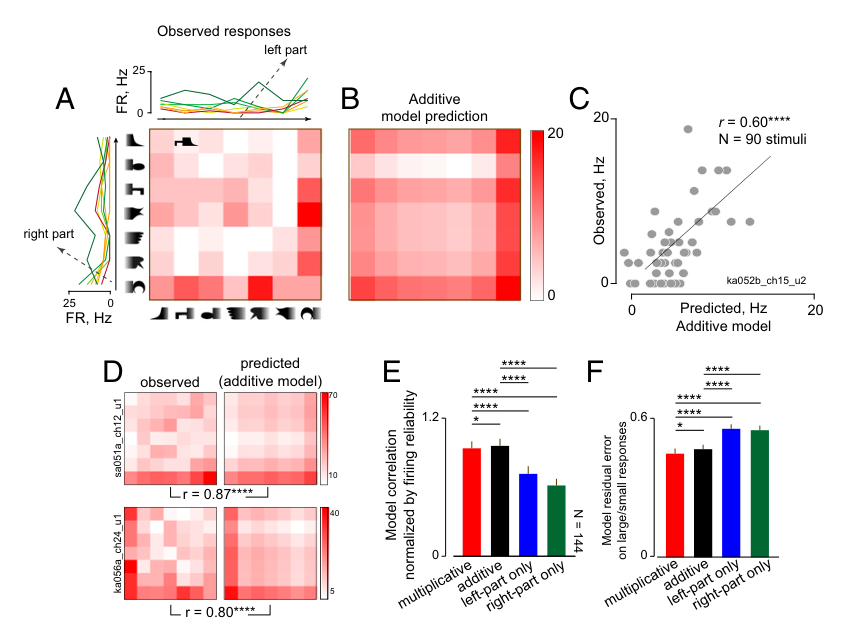
- 反例成立:部件信号加性整合。实验 5 中,加性模型对部件组合物体的拟合(例神经元 r=0.60,接近 split-half 可靠性 0.57±0.06)优于其他所有模型,包括乘性模型(图 6E, F)——需要整合的信号走加法。
图注解读
图 1 · 相乘与相加混合的概念演示与实验总览
原文图注:Fig. 1. Multiplicative vs. additive mixing. (A) Response of a simulated neuron with identical tuning for objects and attributes (10 levels each) that is combined multiplicatively. It can be seen that multiplying the two signals results in sharply tuned responses. (B) Response of a simulated neuron with the same tuning as in A but combined additively. It can be seen that adding the signals produces broadly tuned responses. ……
这张图是全文的"议程设置":A、B 两块热图展示同一套调谐(10 个物体 ×10 个属性水平)经乘法或加法组合后的响应——乘法下热图出现鲜明的行列结构(锐调谐),加法下则一片平缓(宽调谐);C 给出模拟单细胞的物体/属性解码精度对比,乘性显著高于加性,虚线为 10% 机会水平;D 是五个实验的示意图,标注了各组刺激构成与记录神经元数(实验 1:10 物体×4 属性×3 水平,111 个神经元;实验 2:8 物体×7 视角,83 个;图注中写「34 个(图 1D 标注 35)」或按图面写 35 并注明正文分析用 34;实验 4:16 面孔×5 视角,78 个;实验 5:7×7 部件,144 个)。它支撑上文的"研究思路"与主要结果第 1 条的前提。
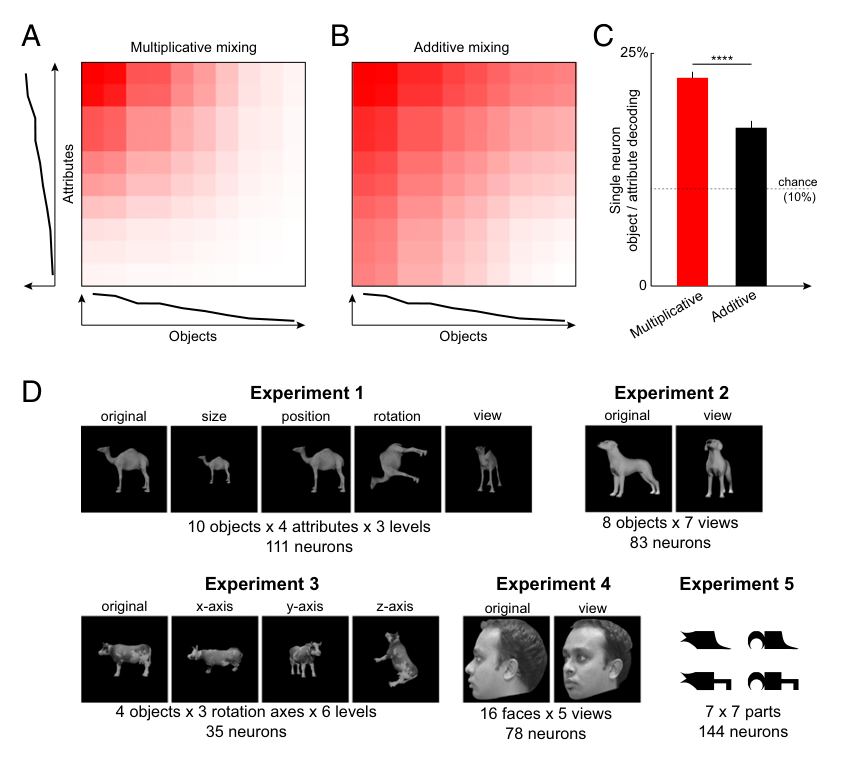
图 2 · 实验 1:身份×属性响应矩阵的乘性拟合
原文图注:Fig. 2. Objects across many attributes (experiment 1). (A, Lower Right) Observed responses for an example IT neuron across objects (along rows) and various attributes (along columns). (A, Upper) Responses to objects for various attributes and (A, Left) responses to attributes across objects. FR, firing rate. (B) Predicted responses for the multiplicative model for this neuron. ……
这张图怎么读:A 是核心数据——实测"物体×属性"发放率矩阵(行为物体、列为属性水平),若某列整体亮说明该神经元对某物体跨属性保持偏好,某行整体亮说明对某属性跨物体有偏好,两种结构并存即可分离调谐的直观证据;B 是乘性模型对同一矩阵的预测;C 是 90 个刺激上实测对预测的散点(例神经元 r=0.86,****P<0.00005);E 汇总各模型的归一化相关(以发放可靠性归一,1 即解释全部可解释方差),乘性(红)显著高于加性(黑)与仅物体、仅属性模型;F 在大/小响应刺激(|z|>2,两模型预测分歧最大处)上比较残差,乘性残差更小。它支撑主要结果第 1 条。
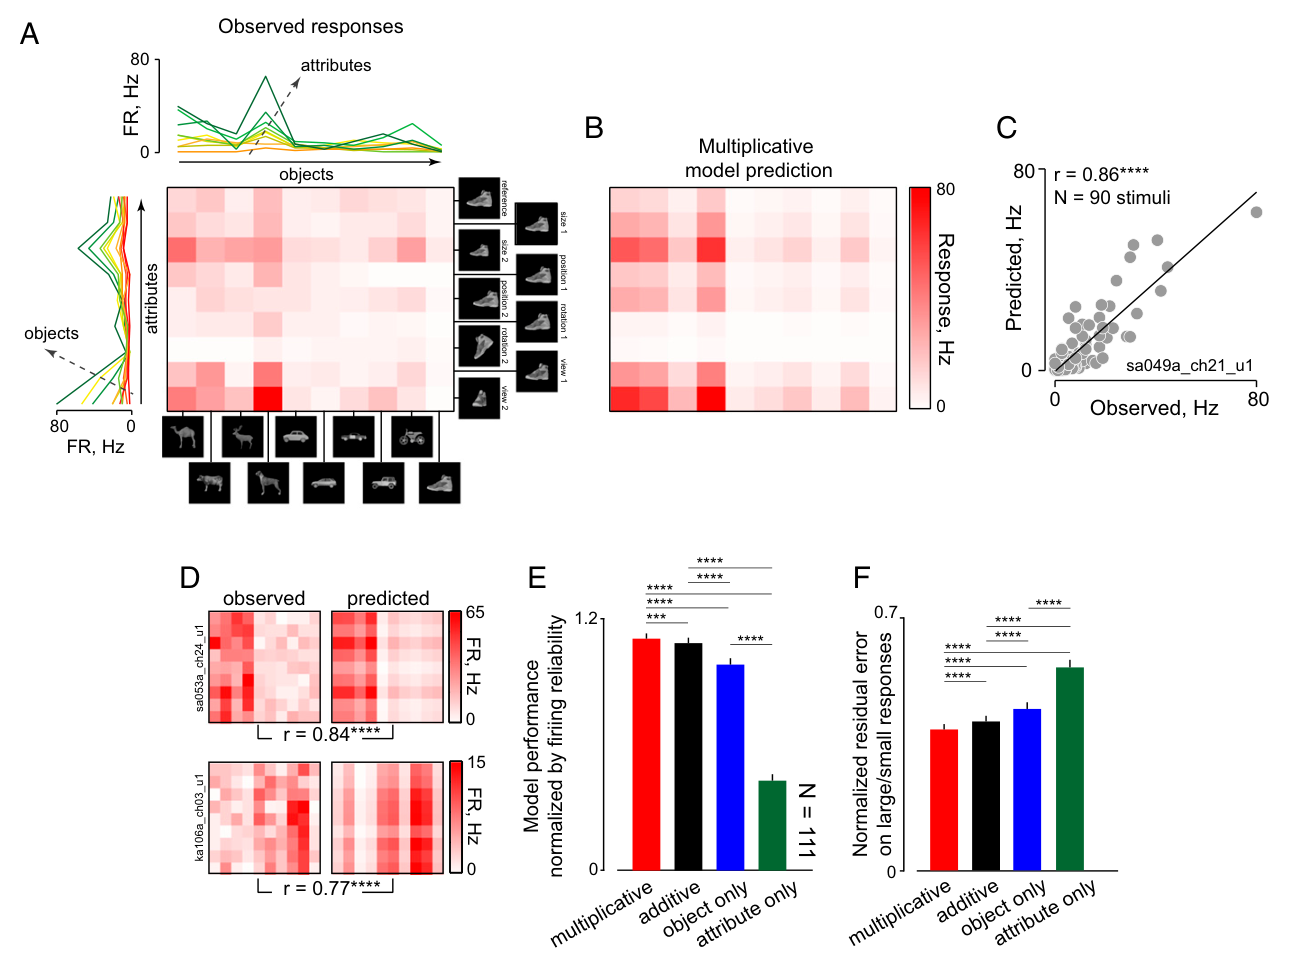
图 3 · 乘性混合带来群体解码优势
原文图注:Fig. 3. Decoding with multiplicative and additive neurons. (A) Although multiplicative and additive model performance was only subtly different, it could have significant implications for population decoding. To investigate this issue, we created two populations of neurons from the observed neural data in experiment 1. In the first group of neurons, we took additive model predictions, simulated Poisson firing for the same number of trials as in the original experiment, and trained linear classifiers to decode object identity. In the second group, we performed the same analysis using multiplicative model predictions. ……
这张图的关键在 A 的流程:把实验 1 实测数据分别替换为加性/乘性模型预测,再按原始试次数仿真泊松噪声发放,构成两个"除了混合方式外一切相同"的模拟群体,各自训练线性分类器解码物体身份。B 显示乘性群体解码 96%、加性群体 87%(机会水平 10%),星号表示 1000 次 bootstrap(每次抽 50 个神经元)的显著性,****P<0.0005。它把"单细胞上只是略微更好"转化成"群体上大幅更好",支撑主要结果第 3 条。
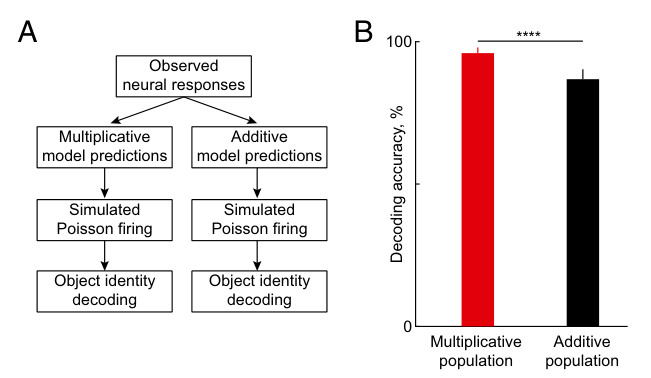
图 4 · 实验 2:深度旋转视角下的乘性可分离性
原文图注:Fig. 4. Objects across rotations in depth (experiment 2). (A) Observed responses for an example IT neuron for a set of objects (along columns) presented at many views (along rows). FR, firing rate. (B) Predicted responses for the multiplicative model for this neuron. (C) Observed response plotted against the multiplicative model prediction across all 56 stimuli, with conventions as before. ****P < 0.00005. ……
读法与图 2 同构,但这里的行列分别是物体与 7 个深度视角。A 中例神经元对所有物体的侧影视角反应最强、对特征稀少的"贫瘠视角"反应最弱——视角偏好跨物体一致,正是可分离调谐的表现;C 中 56 个刺激的实测—预测散点达 r=0.90;E、F 显示乘性模型在归一化相关(N=83 个神经元)与残差上优于加性、仅物体、仅视角模型。这张图回应了一个疑虑:视角变化会改变图像特征本身(特征出现/消失/压缩),不像大小位置那样容易"对齐",但只要物体间视角关系一致,乘性可分离性依然成立——支撑主要结果第 4 条。
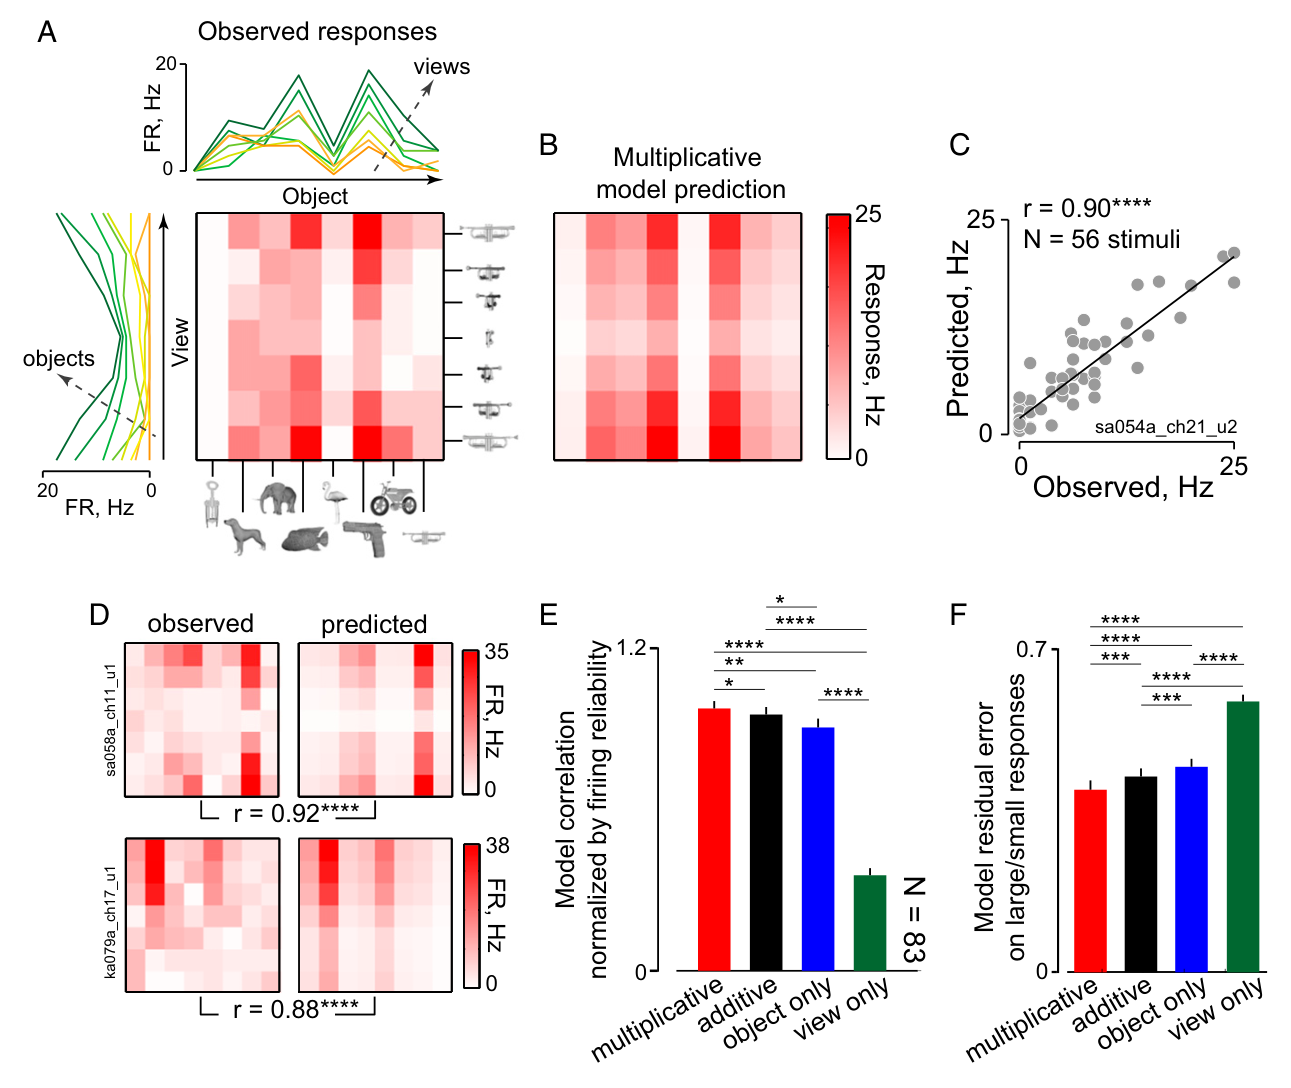
图 5 · 跨实验汇总与计算模型对比
原文图注:Fig. 5. Separability in IT neurons and computational models (experiments 1–4). (A) Normalized model correlation for the multiplicative (red), additive (black), object-only (blue), and attribute-only (green) models across all recorded neurons across all experiments. Error bars indicate the SEM across neurons. Asterisks indicate statistical significance as before based on a Wilcoxon sign rank test comparing performance across neurons for each pair of models. ……
这张图把 1–4 组实验的全部 IT 神经元(N=307)与两个计算模型放在同一把尺子上。A、B 分别以归一化相关和大小/小响应残差汇总 IT 数据,乘性模型全面占优;C、D 把同样的模型比较搬到 V1 模型单元与深度网络单元上,两者都以加性拟合更佳;E 是可分离性指数 SI(第一奇异值占比,最大为 1):IT 神经元最高,深度网络次之,V1 模型最低。纵轴方向上注意 E 与 A/B 不同——SI 越高代表乘性可分离性越强。它支撑主要结果第 4 条关于"乘性可分离性是高层涌现性质、IT 表征最有效率"的结论。
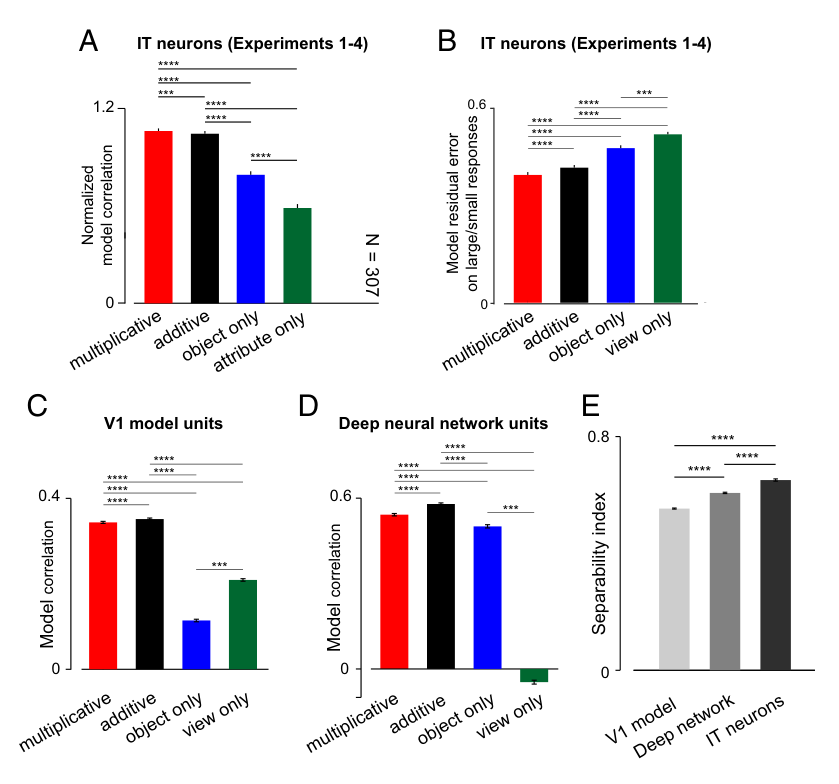
图 6 · 实验 5:部件信号反而加性整合
原文图注:Fig. 6. Objects with varying parts (experiment 5). (A) Observed responses for an example IT neuron for a set of objects with varying right parts (along columns) and left parts (along rows). Individual parts corresponding to each row and column are depicted but were never shown in the experiment. An example object is depicted in the first row, second column. FR, firing rate. (B) Predicted responses for the additive model for this neuron. ……
读法仍是"物体×属性"矩阵,但行列换成了左右部件(注意:部件本身从未单独呈现,图中画的只是行列对应的部件示意)。A 中例神经元对共享某一部件的所有物体反应都强;B 是加性模型预测;C 的 49 个刺激散点 r=0.60,几乎达到该神经元自身的 split-half 可靠性(0.57±0.06),说明加性模型解释了全部可解释方差;E、F 中加性(黑)在模型相关与残差上优于乘性(红)等所有模型。与图 2 恰好相反的结果构成全文最有说服力的对照:乘性不是 IT 的通用编码方式,而是专门留给"需要分别解码"的信号——支撑主要结果第 5 条。
讨论
作者的解释收拢为一个编码原则:需要分别解码的信号(物体身份与图像属性)在 IT 中相乘,需要整合的信号(物体的部件)相加。这与既有文献相容:IT 神经元跨大小、位置与视角保持物体偏好的大量观察,正是乘性可分离的表现形式;部件加性也与"复合物体等于部件之和"(Sripati & Olson)及形状/颜色线性相加(McMahon & Olson)的报道一致。唯一的冲突是与 Freiwald 等人在面孔细胞中发现的乘性特征组合——作者坦承这究竟是面孔/面孔区特有的还是普遍规律,是开放问题。作者还承认方法上的固有困难:两组数的和与积天然高度相关(文中举例 r=0.98),因此加性与乘性模型只有在数值悬殊处才能区分,这也解释了为什么 307 个细胞中只有 46 个能被单细胞水平显著判别。机制层面,作者提出贯穿视皮层的除法归一化(divisive normalization)既能产生加性也能产生乘性调制,可作候补机制。乘性可分离性本身在脑内并不新鲜——顶叶的增益场(gain fields)、听觉皮层的空间感受野、MT 的运动/视差联合调谐都有报道,但本文第一次把它确立为 IT 中身份与属性的组合方式,并用深度网络各层可分离性递增的证据,主张这是面向不变识别优化的网络的涌现性质。
一句话总结
(我的理解)这篇文章最聪明的地方在于把"不变性"从一个定性描述变成了一个可检验的代数命题:同一张响应矩阵,按行乘列还是行加列,预测的差别微妙但方向确定,而群体解码把这点微妙放大成了 9 个百分点的差距。部件实验的加性反例尤其关键——它说明乘法不是 IT 的"默认运算",而是一种按功能需求(分开读出 vs. 合并成整体)分配的计算角色。至于单细胞层面 82% 的偏向比例与深层网络递增的 SI 是否足以断言"涌现",我认为证据是倾向性的而非决定性的,但作为对 IT 表征效率的刻画,这组实验设计得相当干净。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig2: 提取质量
good,对齐度full,识别面板[A, B, C, D, E] - Fig3: 提取质量
good,对齐度full,识别面板[A, B] - Fig4: 提取质量
good,对齐度full,识别面板[A, B, C, D, E] - Fig5: 提取质量
good,对齐度full,识别面板[A, B] - Fig6: 提取质量
good,对齐度full,识别面板[A, B, C, D, E]
关键事实与局限性声明
- 审校纠偏: 作者在五组猴 IT 电生理实验中证明:需要各自独立解码的信号(身份与图像属性)以乘法混合,而需要整合的信号(物体的两个部件)以加法混合 -> 评注:
- 补充要点: 实验 2 中的重要负结果/边界条件:对视角关系不一致的物体(含两个贫瘠视角的 2 个物体),乘性可分离性如预测般瓦解(SI Text)。MD 仅在图 4 解读中以「只要物体间视角关系一致……依然成立」间接带过,建议正面写明这是作者主动检验并确认的乘性可分离性失效条件。
- 补充要点: 混合模型(R = a·Ra + m·Rm)结果:实验 1–4 中乘性项显著大于加性项,且混合模型不优于纯乘性模型——这是支持「群体总体偏向乘性、单细胞存在异质性」的关键证据,MD 方法中介绍了混合模型但结果部分未报告其拟合结论。
- 补充要点: 实验 2 对不变细胞的重复验证:同时受身份与视角调制的细胞最多(52/113,46%)、调谐更锐(稀疏度 0.16 对 0.07)、身份解码更好(54% 对 49%,机会 12.5%,P=0.01),与实验 1 结论互证,MD 未提及。
- 补充要点: 实验 4 刺激集中另有 80 个面孔/物体/身体分类刺激用于测定神经元类别选择性(相关分析在 SI Text),可在方法中一句话带过以求完整。